 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
LLM(18):LLM 的推理优化技术纵览
首发于从NLP到LLM
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
LLM(18):LLM 的推理优化技术纵览
首发于从NLP到LLM
切换模式
 紫气东来
 上海交通大学 工学硕士
收录于 · 从NLP到LLM
998 人赞同了该文章
目录
推理是 LLM 应用的重要一环,在部署服务环节影响重大,本文将讨论主流的 LLM 的推理优化技术。
图融合技术即通过将多个 OP(算子)合并成一个 OP(算子),来减少Kernel[](https://zhida.zhihu.com/search?content_id=230889336&content_type=Article&match_order=1&q=Kernel&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzk1NDcsInEiOiJLZXJuZWwiLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMzA4ODkzMzYsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.CeEIZwLemlS27eyi6Qvv0GSn_ivuaMS62lmvLfIKHj0&zhida_source=entity)的调用。因为每一个基本 OP 都会对应一次 GPU kernel 的调用,和多次显存读写,这些都会增加大量额外的开销。
FasterTransformer(FT) 是一个用于实现基于Transformer的神经网络推理的加速引擎。FT框架是用C++/CUDA编写的,依赖于高度优化的 cuBLAS、cuBLASLt 和 cuSPARSELt 库,与 NVIDIA TensorRT 等其他编译器相比,FT 的特点是它支持以分布式方式推理 Transformer 大模型。
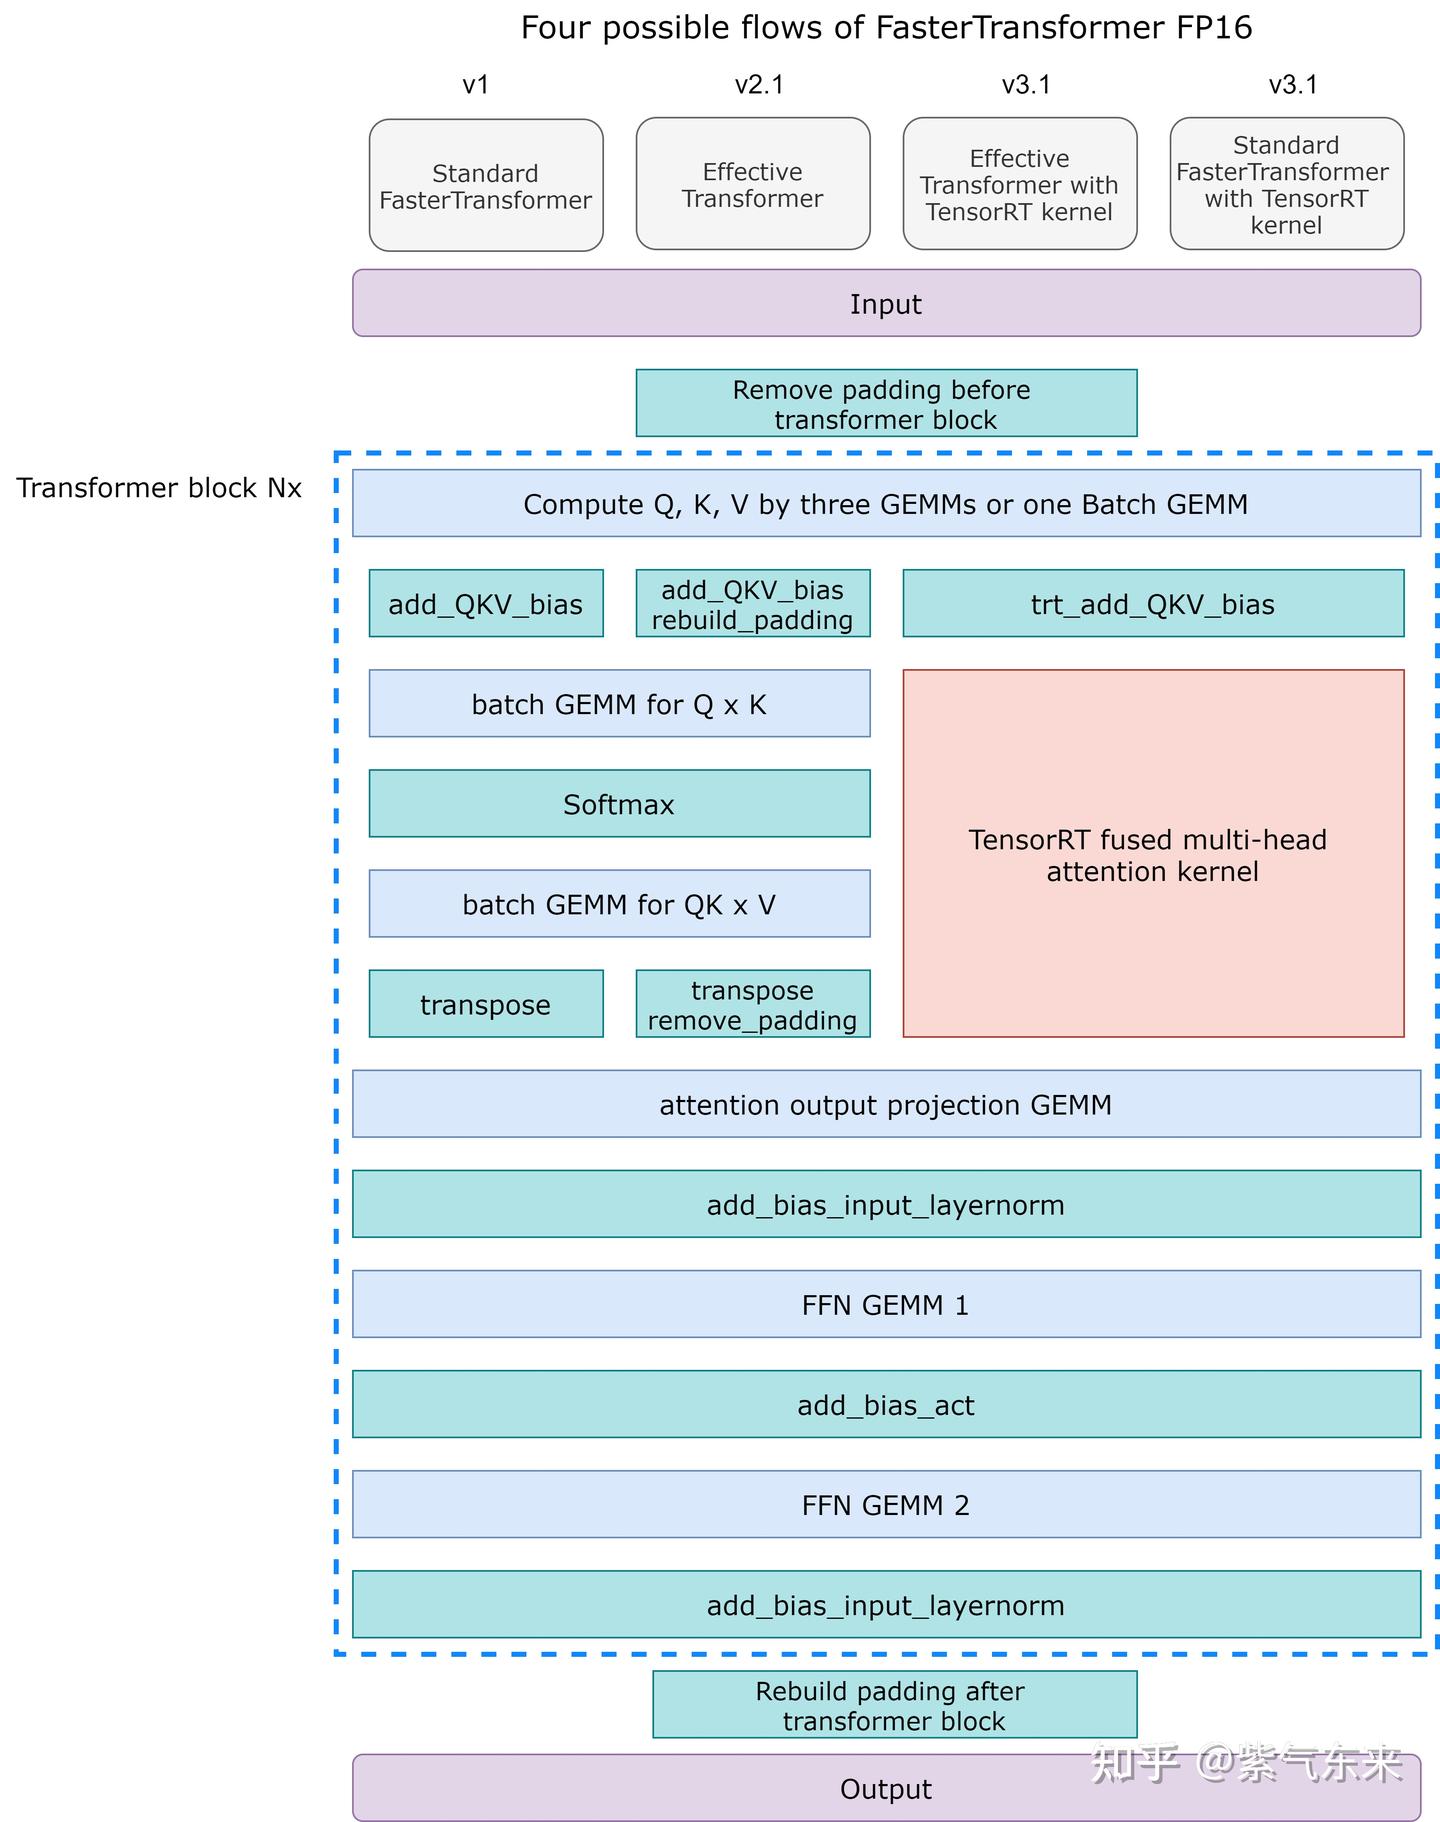
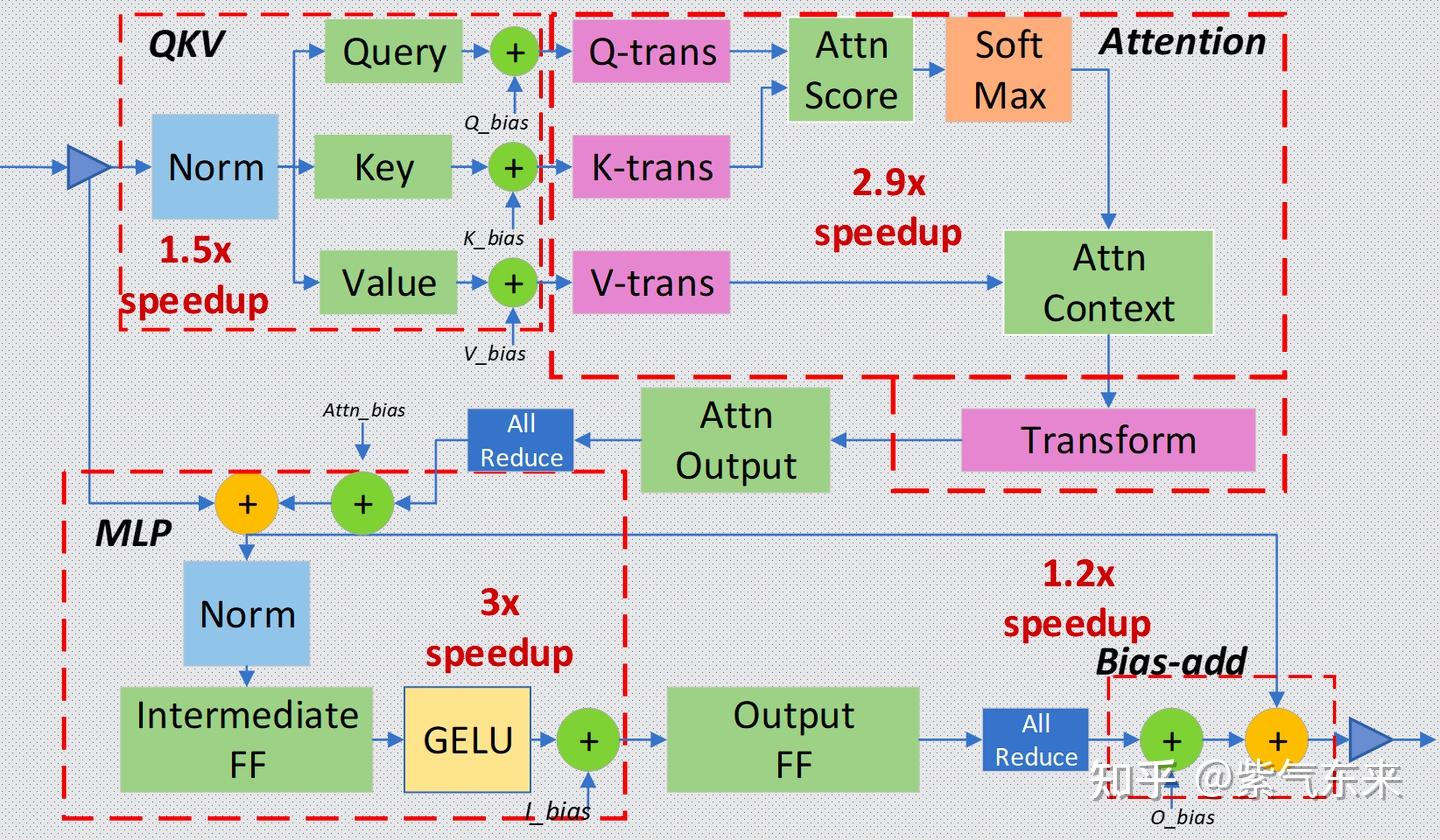
图融合是FT 的一个重要特征,将多层神经网络组合成一个单一的神经网络,将使用一个单一的内核进行计算。 这种技术减少了数据传输并增加了数学密度,从而加速了推理阶段的计算。 例如, multi-head attention 块中的所有操作都可以合并到一个内核中。
 除此之外,
FT还对部分大模型分别支持:
对于 Transformer layer,可分为以下4个主要部分:
如图所示,每一部分可分别进行融合,与未融合相比,以上几个部分的加速比可分别达到 1.5x, 2.9x, 3x, 1.2x 。
 除此之外,DeepSpeed Inference 的优化点还有以下几点:
之前介绍的推理方案主要是基于GPU的优化,而 MLC LLM 提供了可应用于移动端(例如 iPhone)、消费级电脑端(例如 Mac)和 Web 浏览器的轻设备解决方案。
MLC LLM 的主要工作流基于 Apache TVM Unity,通过扩展 TVM 后端使模型编译更加透明和高效。其中以编译代码转换、融合、内存规划和库卸载(library offloading)为代表的可组合的 ML 编译优化是其中重要的优化特性。
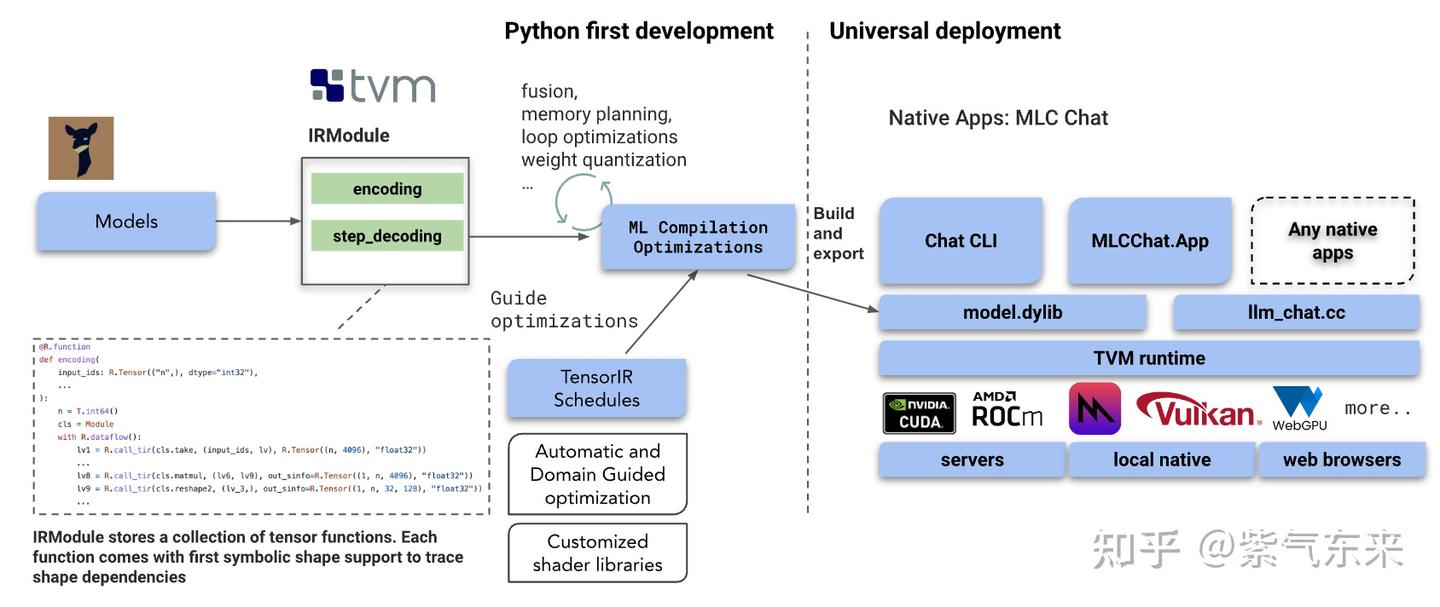 除此之外,MLC LLM 还具有以下特性:
除了上述3种方案外,其他也支持图融合的方案还包括 NVIDIA TensorRT, Tencent TurboTransformers 等。
模型压缩的基本动机在于当前的模型是冗余的,可以在精度损失很小的情况下实现模型小型化,主要包括3类方法:稀疏(Sparsity)、量化(Quantization)、蒸馏(Distillation)。
实现稀疏(Sparsity)的一个重要方法是剪枝(Pruning)。剪枝是在保留模型容量的情况下,通过修剪不重要的模型权重或连接来减小模型大小。 它可能需要也可能不需要重新培训。 修剪可以是非结构化的或结构化的。
关于剪枝稀疏的基本原理,可参考笔者之前的文章: 除了上文介绍的稀疏方法外,还有其他的稀疏化方法,包括但不限于:
以上主要实现了稀疏的方法,那么对于稀疏后的模型如何加速呢?NVIDIA Ampere 架构对与结构化稀疏做了专门的稀疏加速单元,下图展示了结构化稀疏的物理表示:
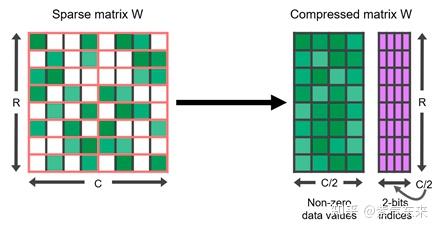 2:4 结构化稀疏表示
下图展示了稀疏单元GEMM计算与标准GEMM计算的区别(详细解释参见https://arxiv.org/pdf/2104.08378.pdf)
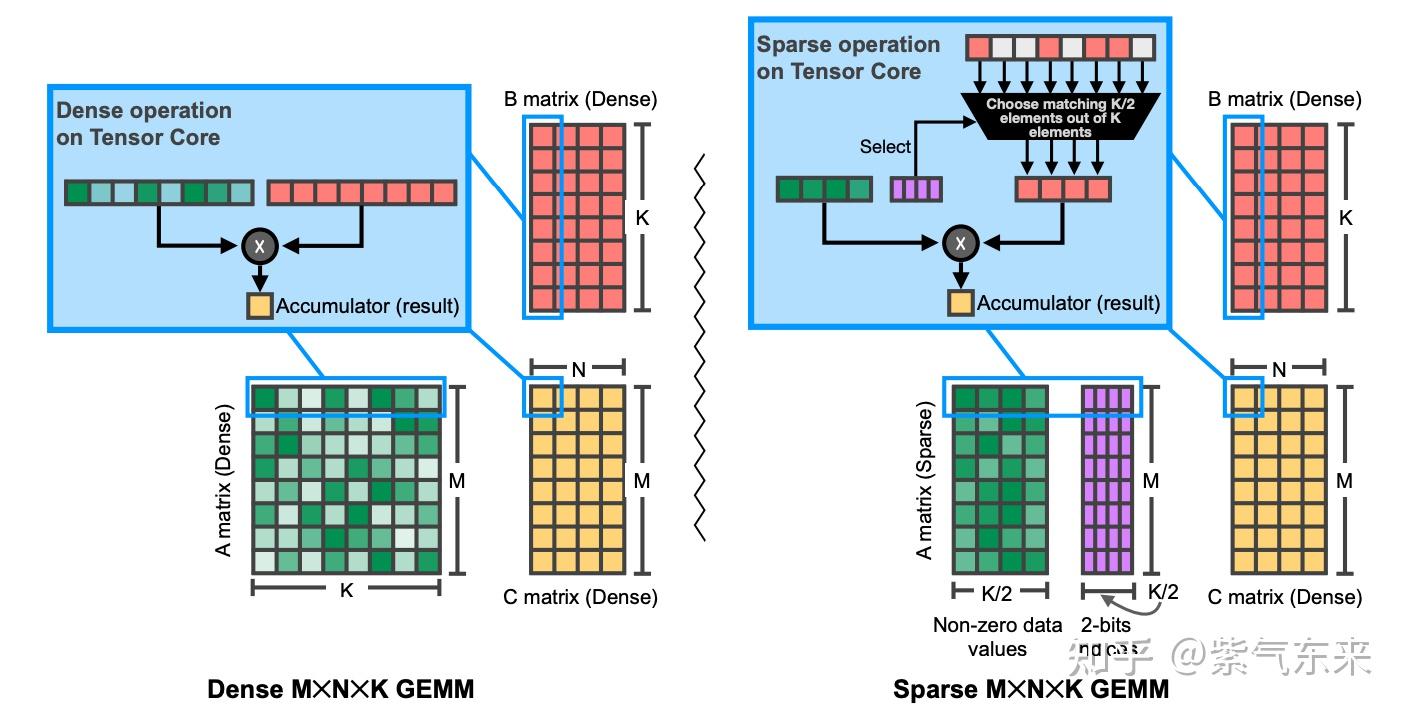 Sparse VS Dense GEMM
常见量化有两种常见方法:
实际上,由于 GPU 内核缺乏对某些类型的矩阵乘法(例如 INT4 x FP16)的支持,理论最优量化策略与硬件内核支持之间的差距,并非以下所有方法都能加速实际推理。
关于量化的基本原理和实现细节,可参考笔者之前的文章:
许多关于 Transformer 模型量化的研究都有相同的观察结果:简单的低精度(例如 8 bit)训练后量化会导致性能显着下降,这主要是由于动态的 activation 和静态的 weight 量化策略无法保持一致。
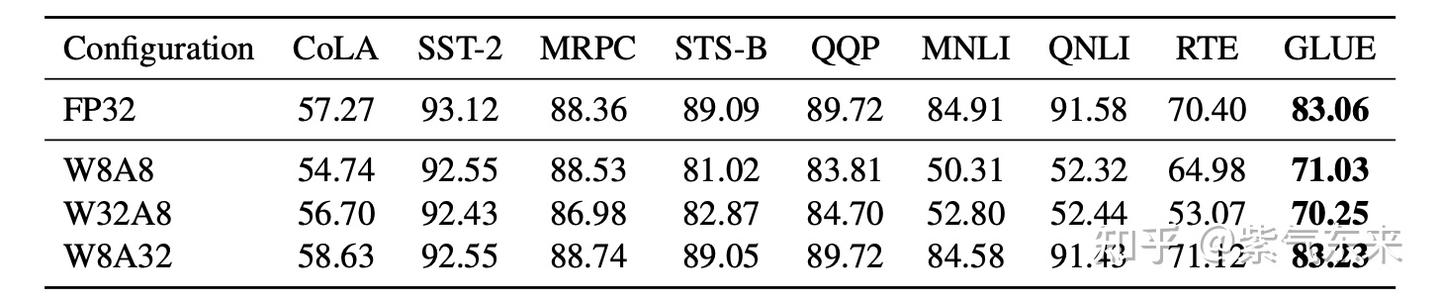 为了不损失精度而提高性能,可以考虑 WeightOnly 量化技术,即只把 Weight 量化成 int8 格式,以降低访存压力。到实际 Kernel 内部再 Dequantize 回 fp16,进行矩阵乘计算。这种方法在 BS 较小是比较有效(因为此时的瓶颈在IO),BS 较大时(因为此时的瓶颈在计算)效果变差。
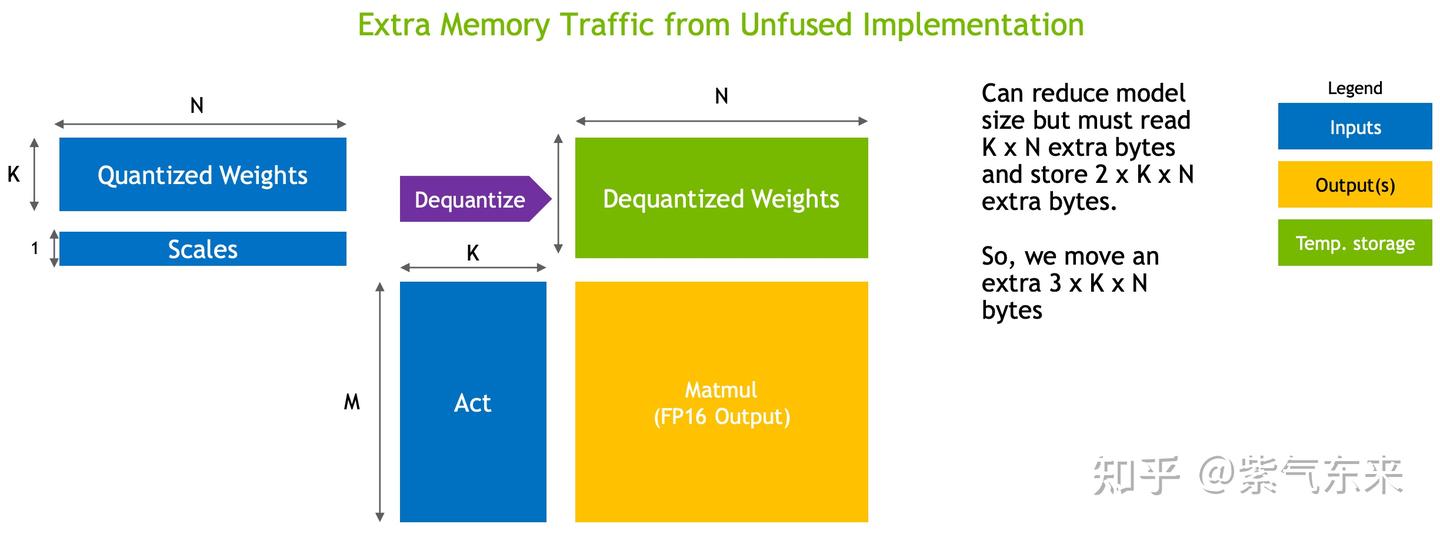 WeightOnly 量化的典型案例是 AWQ: Activation-aware Weight Quantization,即只对 weight 进行量化以实现压缩和加速的效果。
知识蒸馏是一种构建更小、更便宜的模型(“student 模型”)的直接方法,通过从预先训练的昂贵模型中转移技能来加速推理(“ teacher 模型”)融入 student。 除了与 teacher 匹配的输出空间以构建适当的学习目标之外,对于如何构建 student 架构没有太多限制。
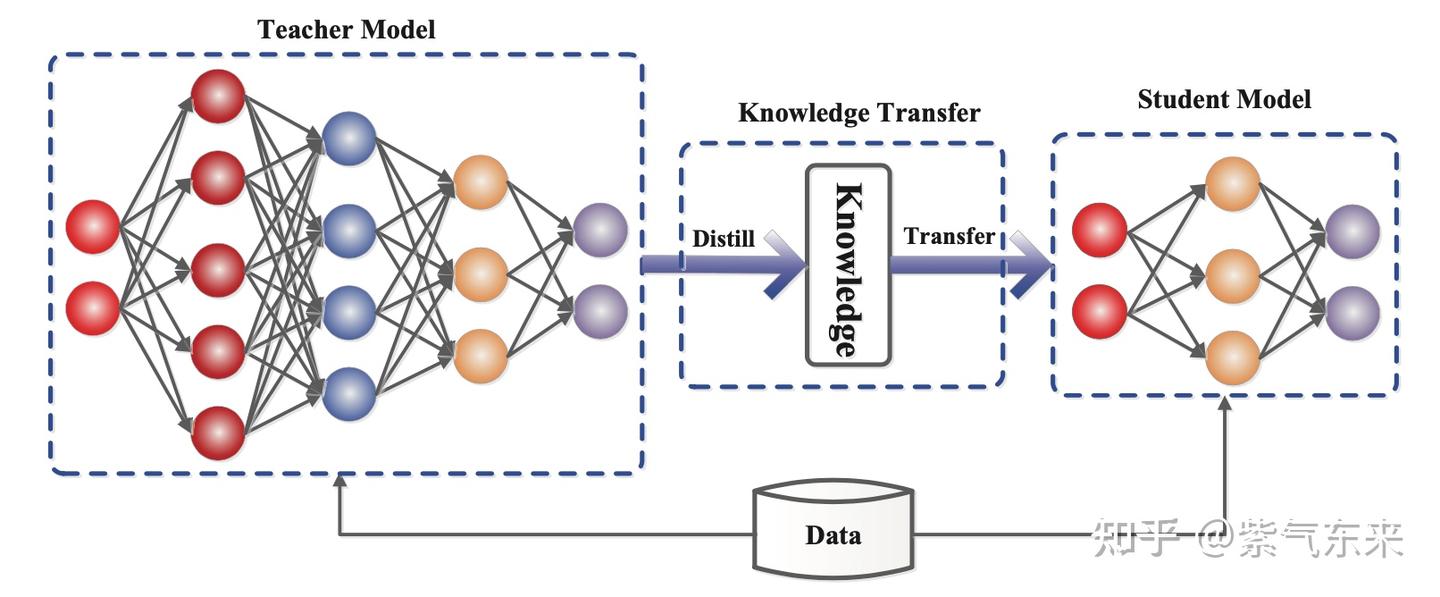 知识蒸馏基本框架
给定数据集,训练 student 模型通过蒸馏损失来模仿 teacher 的输出。 通常神经网络有一个softmax层; 例如,LLM 输出 token 的概率分布。 将 softmax 之前的 logits 层表示为 \mathbf{z}t 和 \mathbf{z}s , 分别表示 teacher 和 student 模型。 蒸馏损失最小化两个 softmax 输出之间的差异(温度 T )。 当标签 y 已知,可以将其与student 的 logits 之间计算交叉熵,最后将两个损失相加,如下:
\mathcal{L}{\mathrm{KD}}=\mathcal{L}{\text {distll }}\left(\operatorname{softmax}\left(\mathbf{z}_t, T\right), \operatorname{softmax}\left(\mathbf{z}s, T\right)\right)+\lambda \mathcal{L}{\mathrm{CE}}\left(\mathbf{y}, \mathbf{z}_s\right)
在 Transformer 中一个典型案例是DistilBERT,模型参数减少 40%,速度提升71%。在大模型时代,蒸馏可以与量化、剪枝或稀疏化技术相结合,其中 teacher 模型是原始的全精度密集模型,而 student 模型则经过量化、剪枝或修剪以具有更高的稀疏级别,以实现模型的小型化。
随着模型越来越大,训练和推理成本会平方级增长,为了平衡成本和规模,即希望在较小成本下实现超大模型的效果,通常会采用 MOE(Mixture-of-Experts)技术。
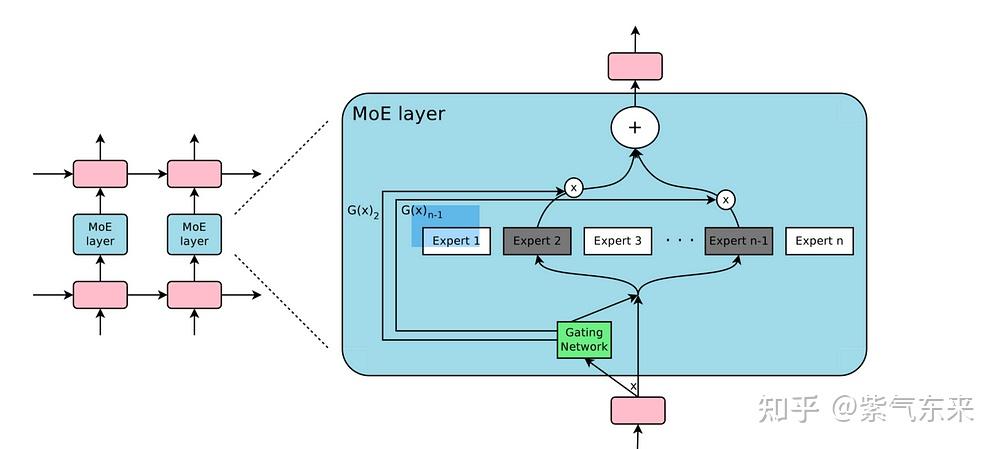
MoE 层即将大模型拆分成多个小模型(专家,expert), 每轮迭代根据样本决定激活一部分专家用于计算,达到了节省计算资源的效果;并引入可训练并确保稀疏性的门( gate )机制,以保证计算能力的优化。
与密集模型不同,MoE 将模型的某一层扩展为多个具有相同结构的专家网络( expert ),并由门( gate )网络决定激活哪些 expert 用于计算,从而实现超大规模稀疏模型的训练。MoE 细节如下图所示,中间层具有 n 个 expert 的 MoE 结构,并引入 Gating network 和 Top_k 机制。计算过程如下公式:
\begin{gathered} M o E(x)=\sum_{i=1}^n\left(G(x)_i E_i(x)\right) \\ G(x)=\operatorname{TopK}\left(\operatorname{softmax}\left(W_g(x)+\epsilon\right)\right) \end{gathered} \
上述第 1 个公式表示了包含 n 个专家的 MoE 层的计算过程。具体来讲,首先对样本 x 进行门控计算, W 表示权重矩阵;然后,由 Softmax 处理后获得样本 x 被分配到各个 expert 的权重;然后,只取前 k (通常取 1 或者 2)个最大权重;最终,整个 MoE Layer 的计算结果就是选中的 k 个专家网络输出的加权和。
 典型的 MoE 的方案包括 GShard, Switch-Transformer, GLaM, FastMoE, DeepSpeed-MoE 等方案。
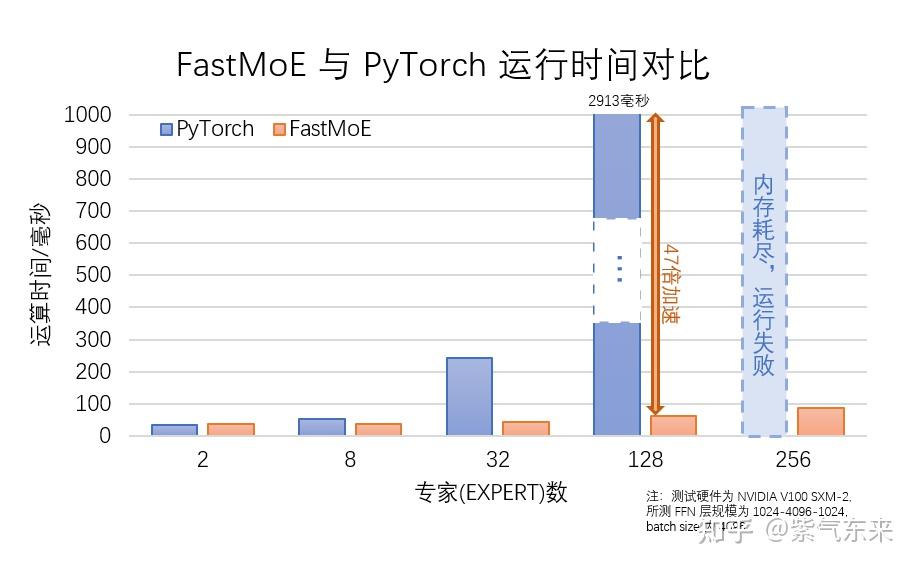
FastMoE 支持在同一个 worker 上运行多个 experts,从而减少模型研究者在探索更多 experts 数量时所需的硬件资源。当 experts 数量较多时,FastMoE 针对传统的两层 MLP 全连接网络(即 Transformer 中的 FFN 网络)使用了更精细的并行策略,从而使得 Transformer 模型中 MLP 部分的运算速度相比朴素的实现较大的加速。
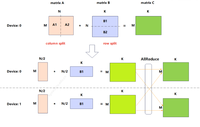
当前的推理的并行化技术主要体现在3个维度上,即 3D Parallelism:
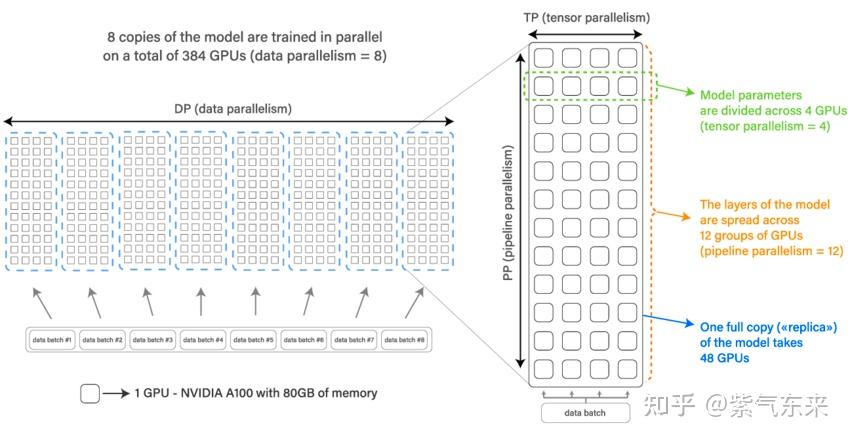 3D Parallelism 的3个维度
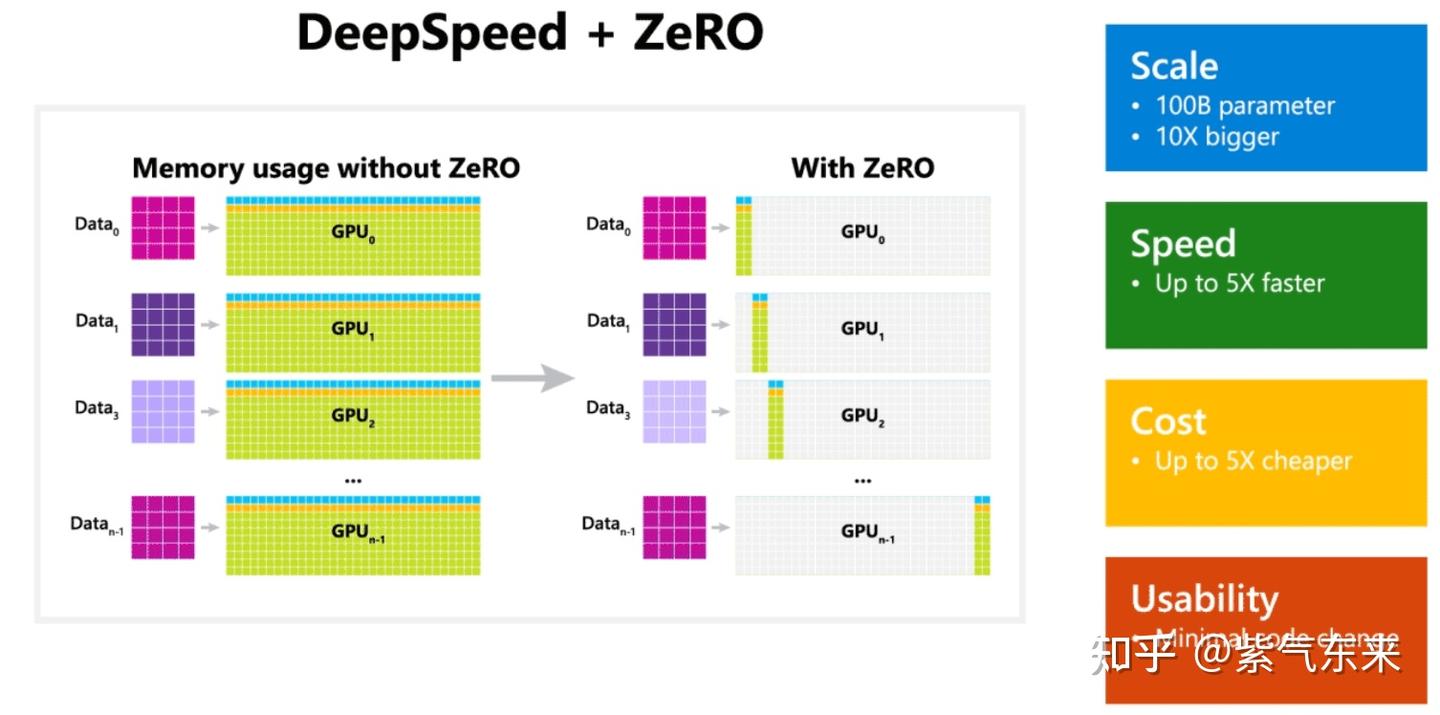
在推理中,DP 主要是增加设备数来增加系统整体 Throughput,其中最经典的即DeepSpeed的Zero系列
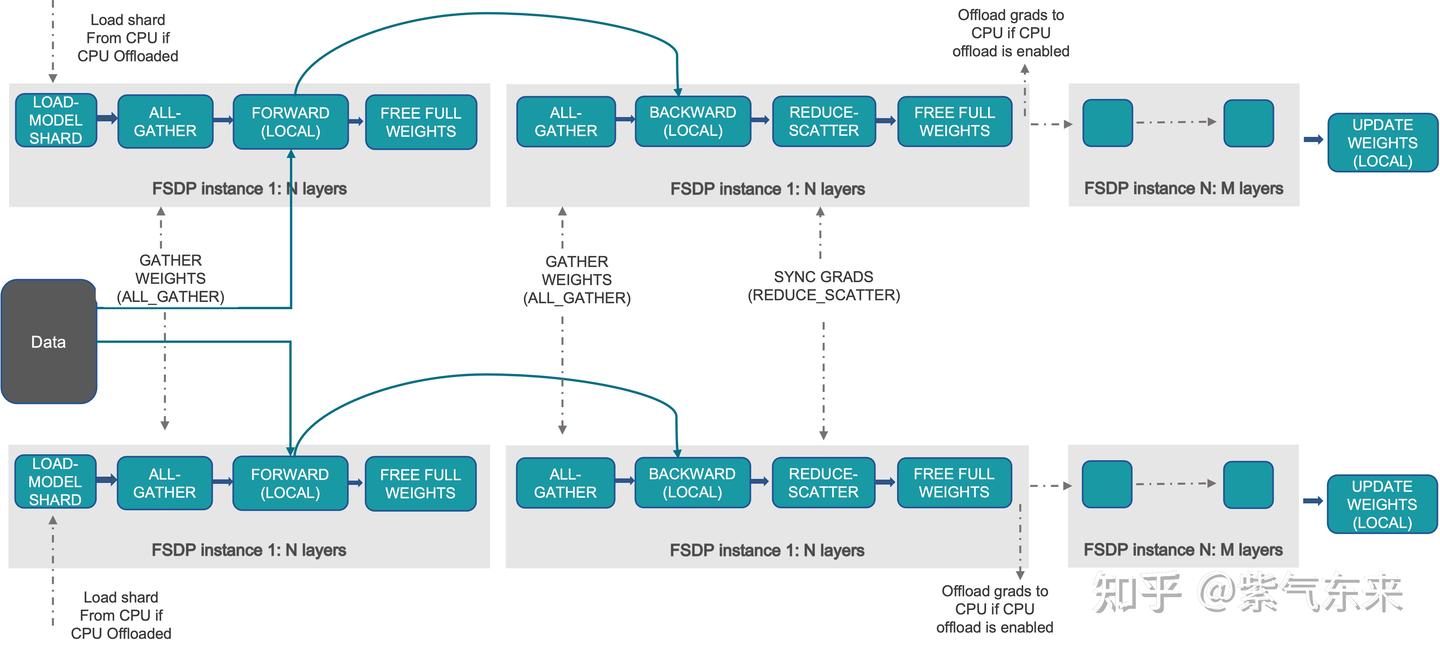
 另外 FSDP 也比较高效和易用
在推理中,TP 主要是横向增加设备数通过并行计算来减少 latency,其实现原理及细节可参考笔者之前的文章 当前也有一些方便易用的 TP 方案,如 BlackSamorez/tensor_parallel ,使用起来非常简单:
import transformers
import tensor_parallel as tp
tokenizer = transformers.AutoTokenizer.from_pretrained("facebook/opt-13b")
model = transformers.AutoModelForCausalLM.from_pretrained("facebook/opt-13b")  # use opt-125m for testing

model = tp.tensor_parallel(model, ["cuda:0", "cuda:1"])  # <- each GPU has half the weights

inputs = tokenizer("A cat sat", return_tensors[](https://zhida.zhihu.com/search?content_id=230889336&content_type=Article&match_order=1&q=tensors&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzk1NDcsInEiOiJ0ZW5zb3JzIiwiemhpZGFfc291cmNlIjoiZW50aXR5IiwiY29udGVudF9pZCI6MjMwODg5MzM2LCJjb250ZW50X3R5cGUiOiJBcnRpY2xlIiwibWF0Y2hfb3JkZXIiOjEsInpkX3Rva2VuIjpudWxsfQ.UJDPr4Bq6cFxAQ_RfoKsSI0cGWSzNzYmbuqiLMG4iss&zhida_source=entity)="pt")["input_ids"].to("cuda:0")
outputs = model.generate(inputs, num_beams=5)
print(tokenizer.decode(outputs[0])) # A cat sat on my lap for a few minutes ...

model(input_ids=inputs, labels=inputs).loss.backward()  # training works as usual
当前主流的推理框架都支持 TP 的方式,包括但不限于:
在推理中,PP 主要是纵向增加设备数通过并行计算来支持更大模型,同时提高设备利用率。
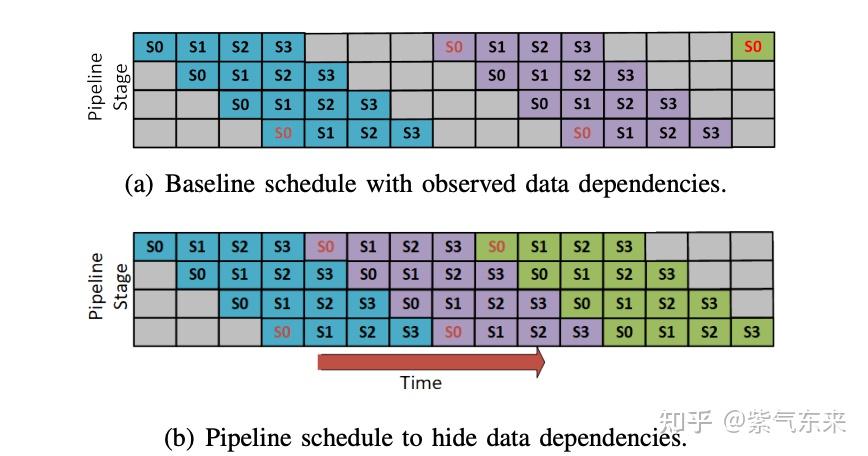 通常来说,PP 需要与 TP 结合以支持更大模型,并实现最佳效果
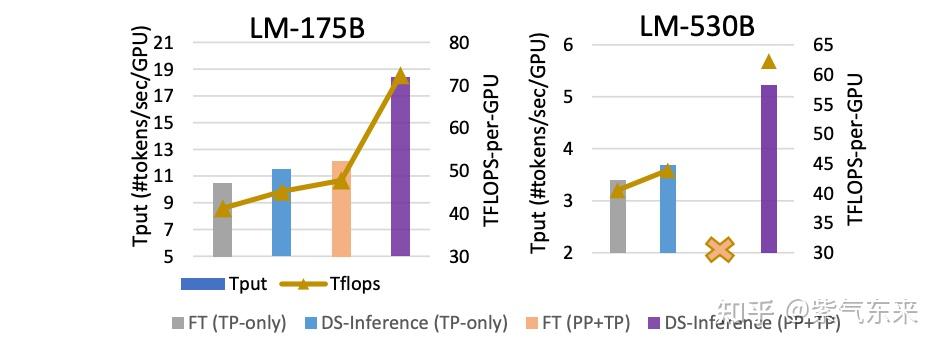
该类方法主要通过优化 Transformer 的结构以实现推理性能的提升。
该部分的实现细节可参考笔者之前的文章,在此不予赘述
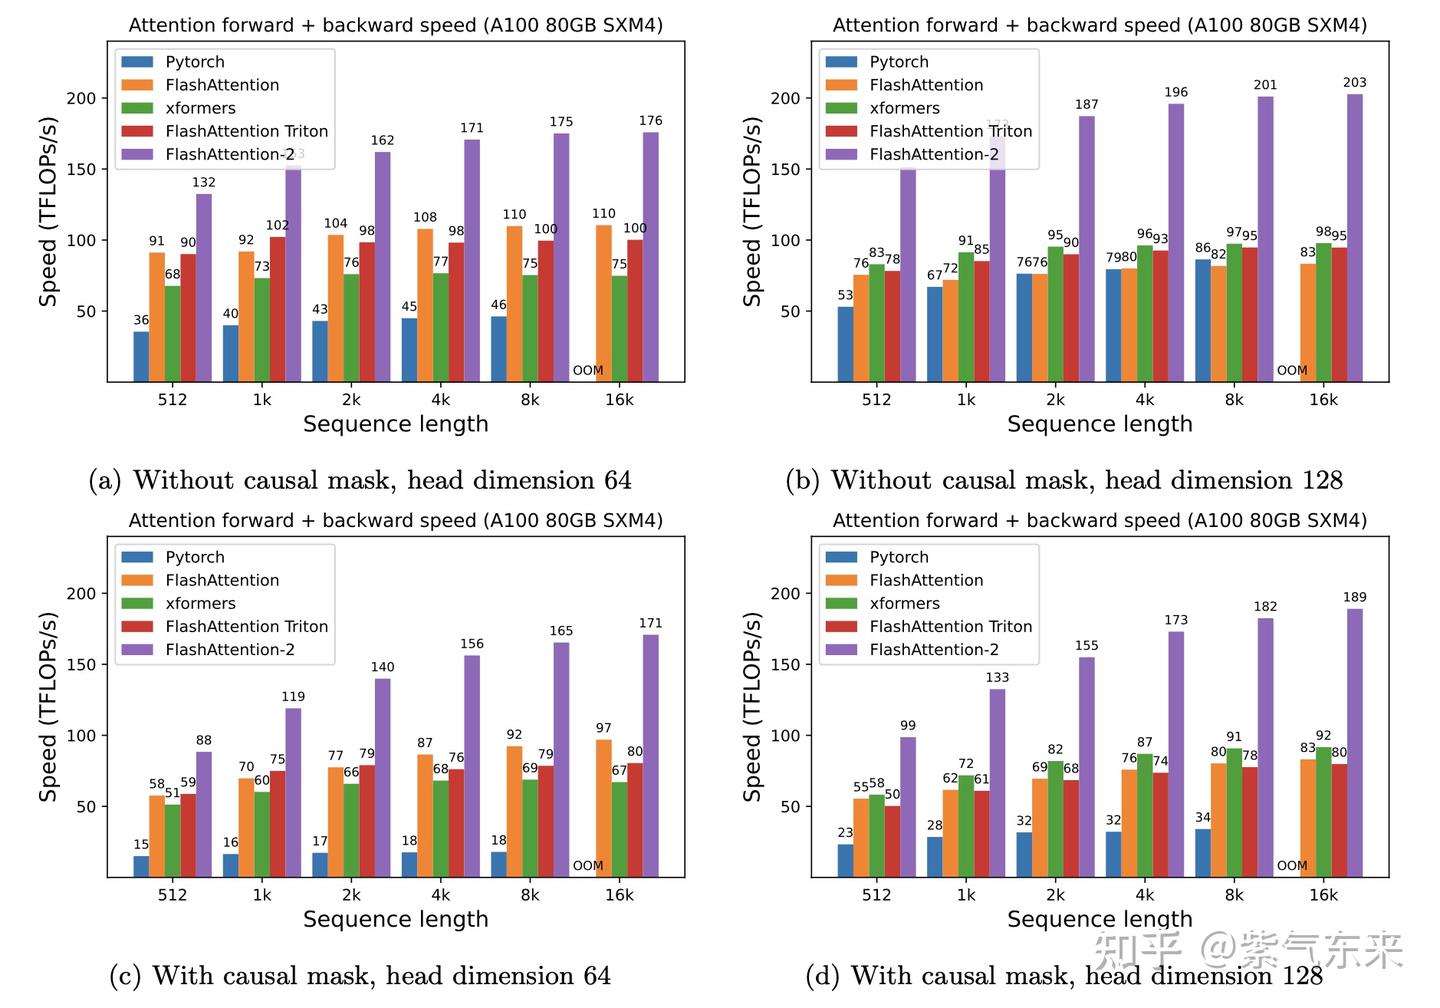
FlashAttention-v2 在原基础上做了改进,使其在算法、并行化和工作分区等方面都有了显著改进,对大模型的适用性也更强。在A100 上性能数据如下:
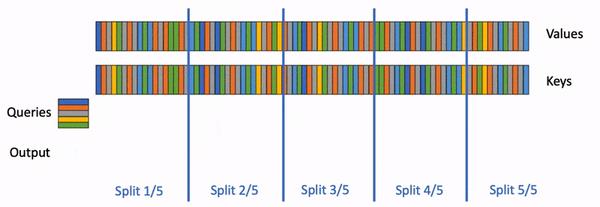
 FlashDecoding 是在 FlashAttention 的基础上针对 inference 的优化主要分为三步:
FLAT-Attention 与 FlashAttention 采取不同的路线来解决同一问题。 提出的解决方案有所不同,但关键思想是相同的(tiling 和 scheudling)。下面主要讨论二者不同之处:
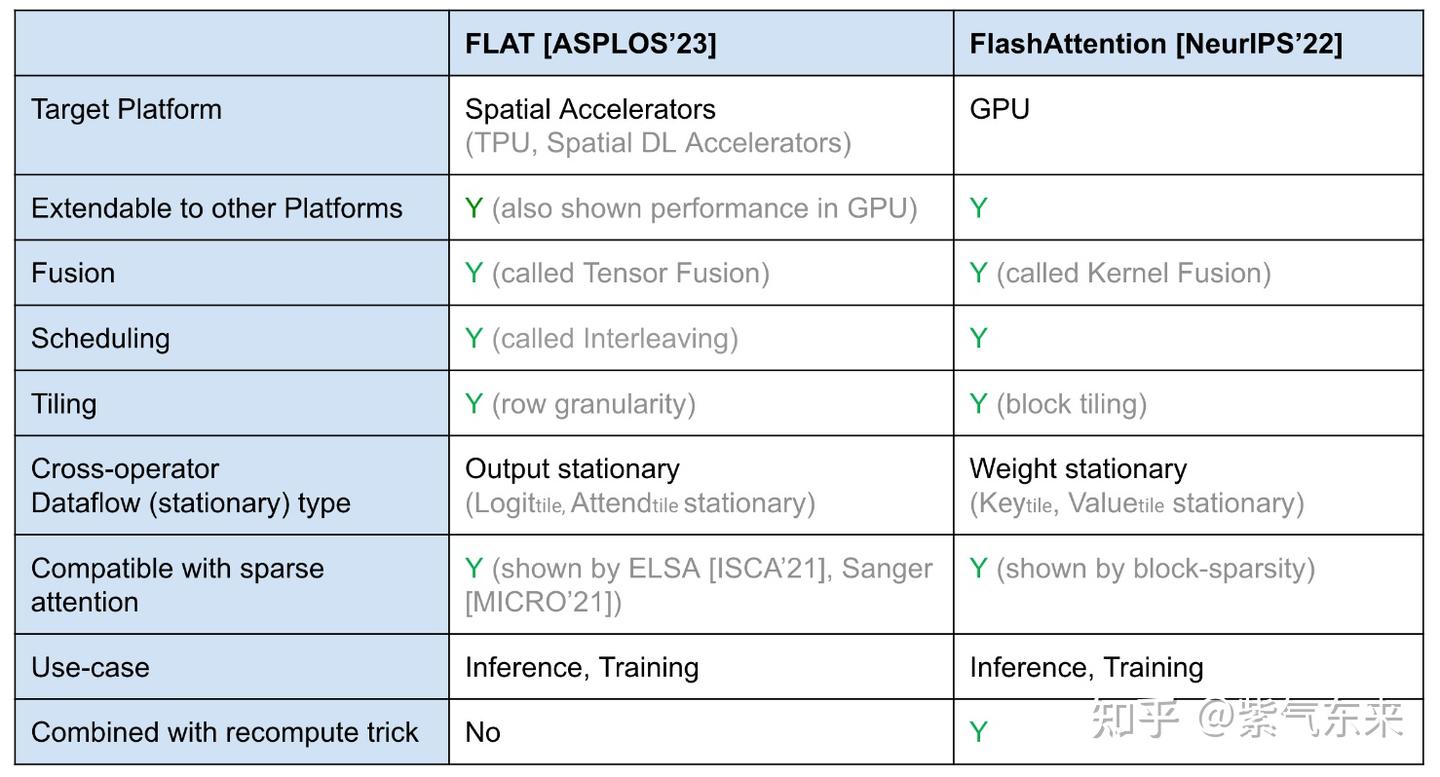 4.3.1 Tiling 策略比较
FlashAttention 使用块平铺和权重固定。 FLAT-Attention 使用行平铺(行粒度)和输出固定。
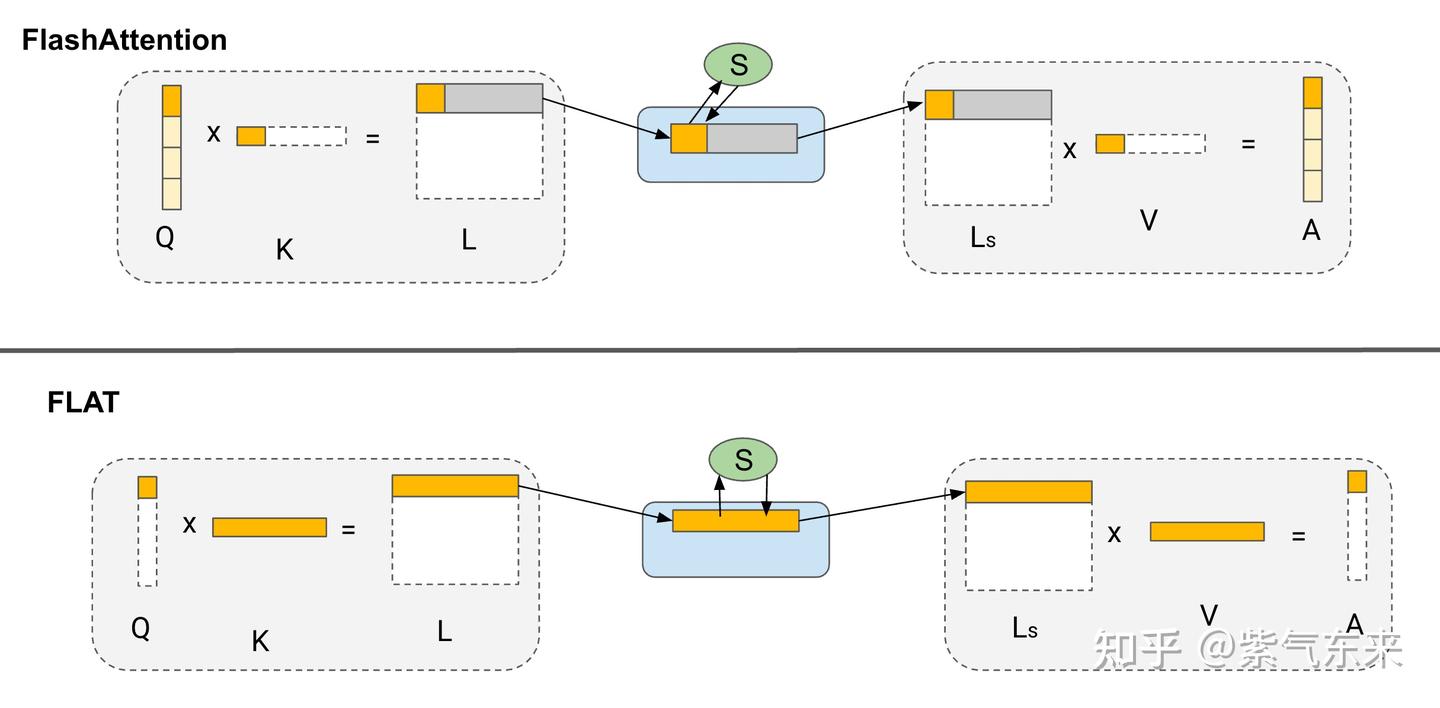 4.3.2 Scheduling 策略(数据流)比较
FlashAttention 的 Scheduling 过程
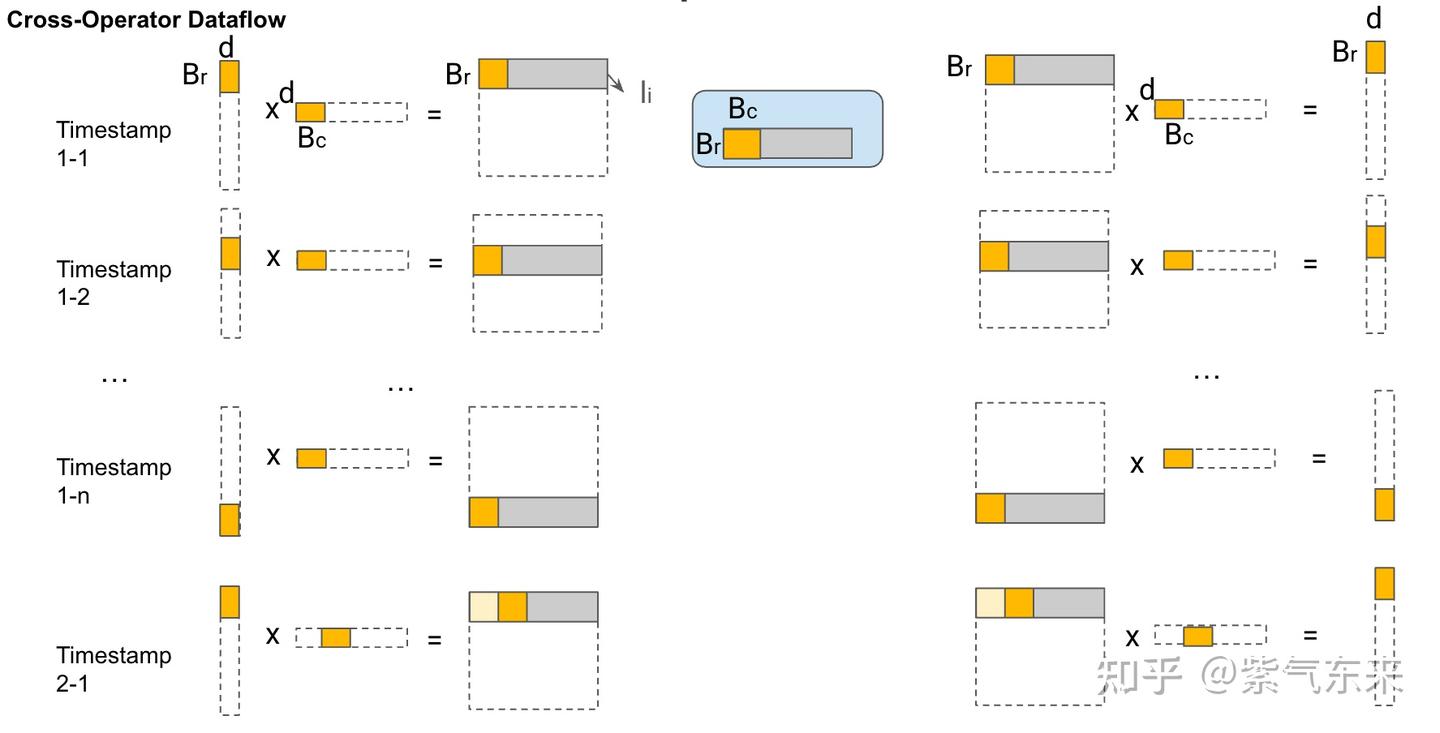
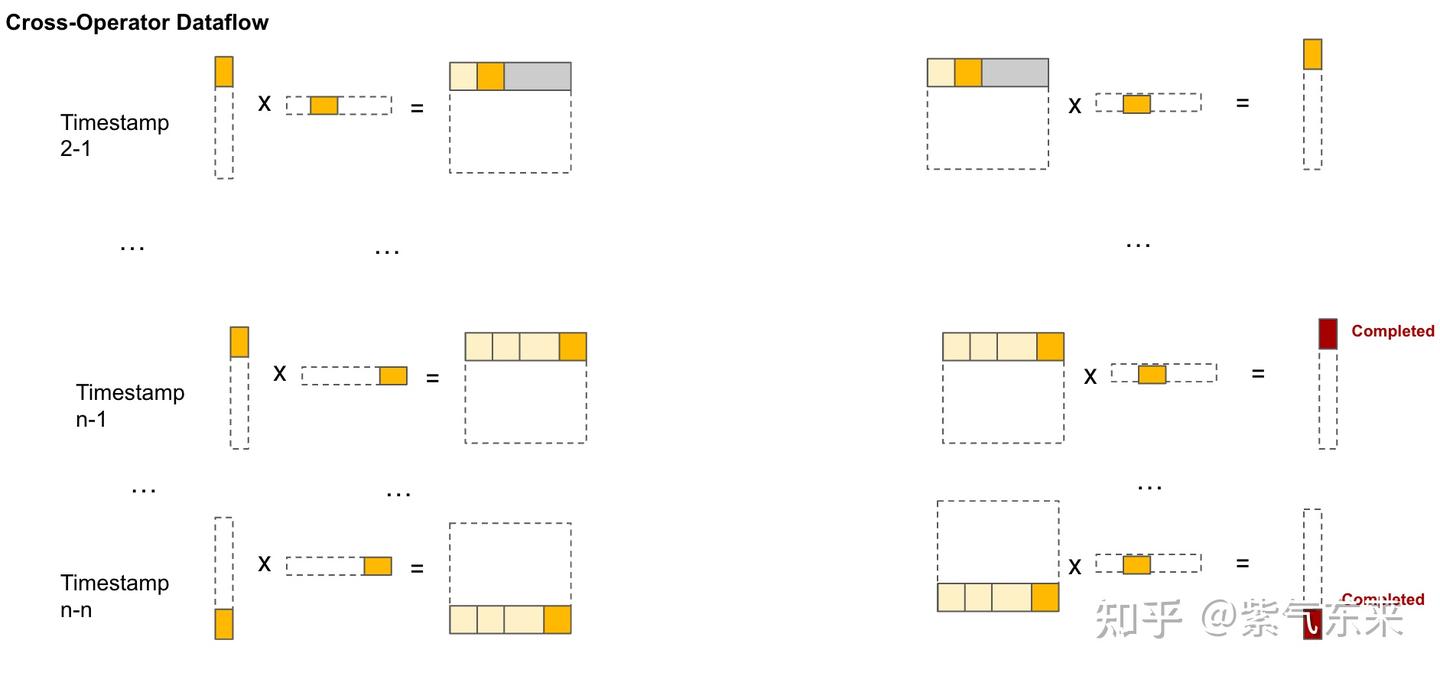 FLAT-Attention 的 Scheduling 过程
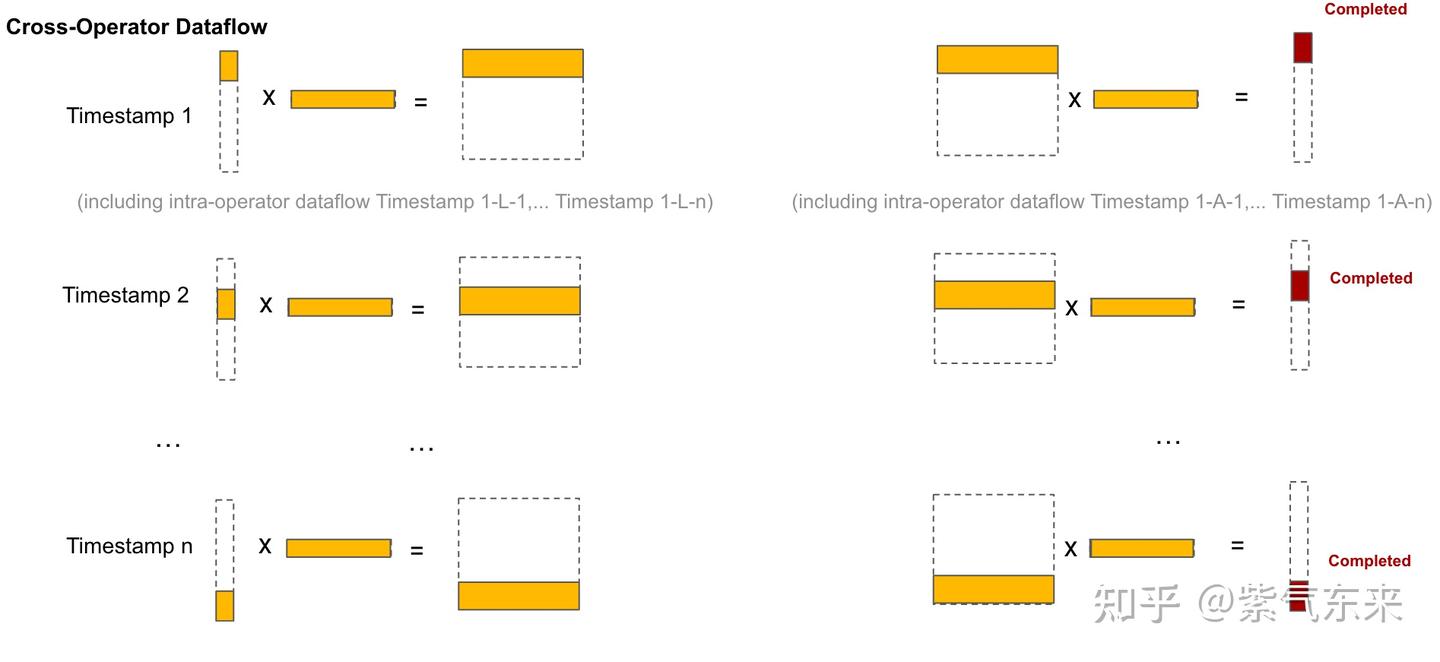
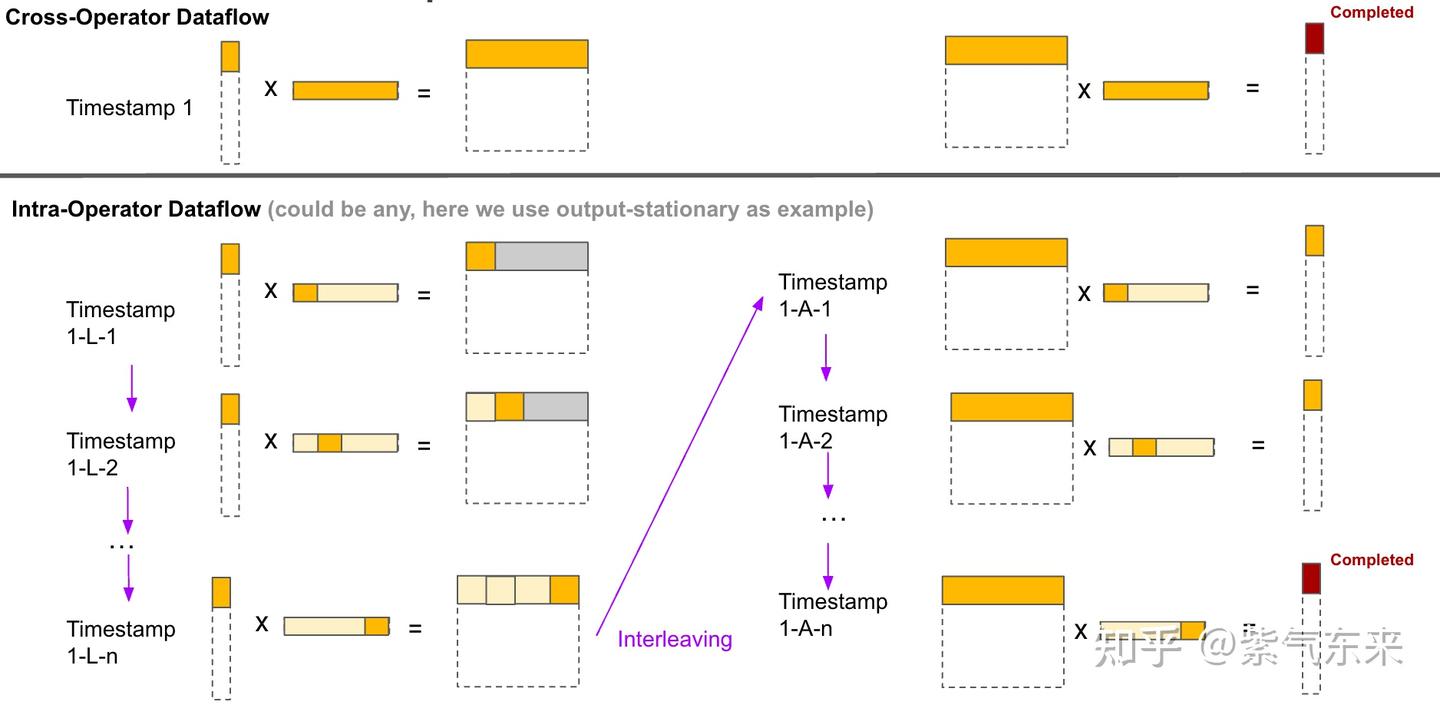
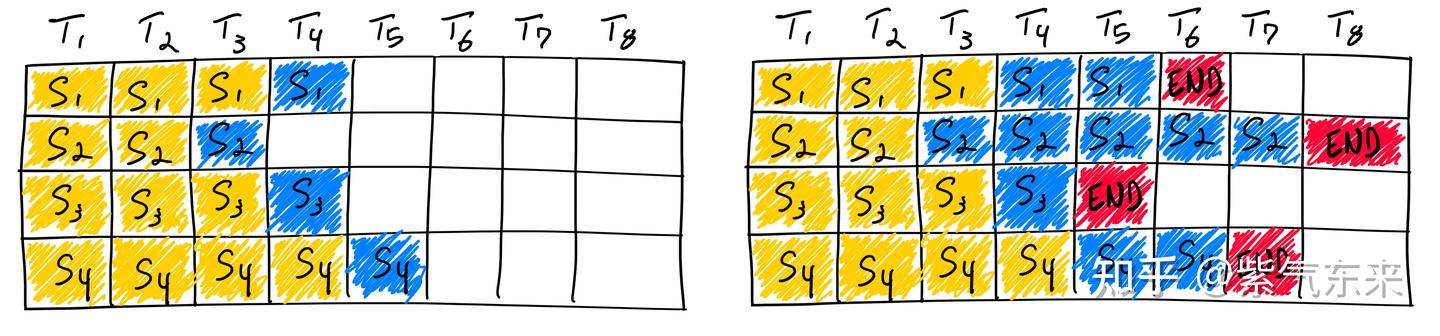
该类方法主要是针对多 Batch 的场景,通过对 Batch 的时序优化,以达到去除 padding、提高吞吐和设备利用率。传统的 Batch 处理方法是静态的,因为Batch size 的大小在推理完成之前保持不变。
如下图所示,使用静态 Batch 完成四个序列。 在第一次迭代(左)中,每个序列从prompt(黄色)生成一个token(蓝色)。 经过几次迭代(右)后,每个完成的序列都有不同的大小,因为每个序列在不同的迭代中发出其序列结束标记(红色)。 可见序列 3 在两次迭代后就已经结束,但仍然需要等待 Batch 中的最后一个序列完成生成(在本例中,序列 2 在六次迭代后)才能统一输出,这意味着 GPU 未被充分利用。
 静态 Batch 的推理情况
下面我们来研究 Dynamic Batch 是如何优化这一过程的。
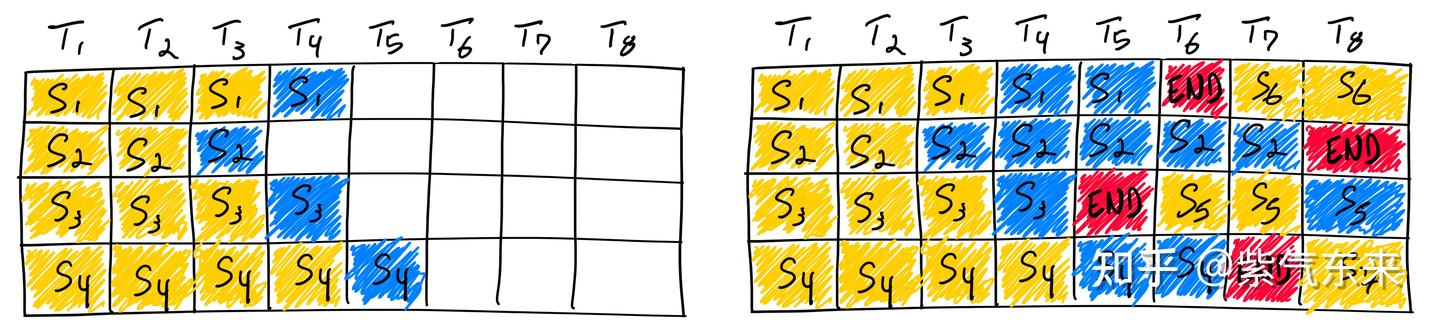
Orca 不是等到 Batch 中的所有序列完成生成,而是实现 iteration 级调度,其中Batch size由每次迭代确定。 结果是,一旦 Batch 中的序列完成生成,就可以在其位置插入新序列,从而比静态 Batch 产生更高的 GPU 利用率。
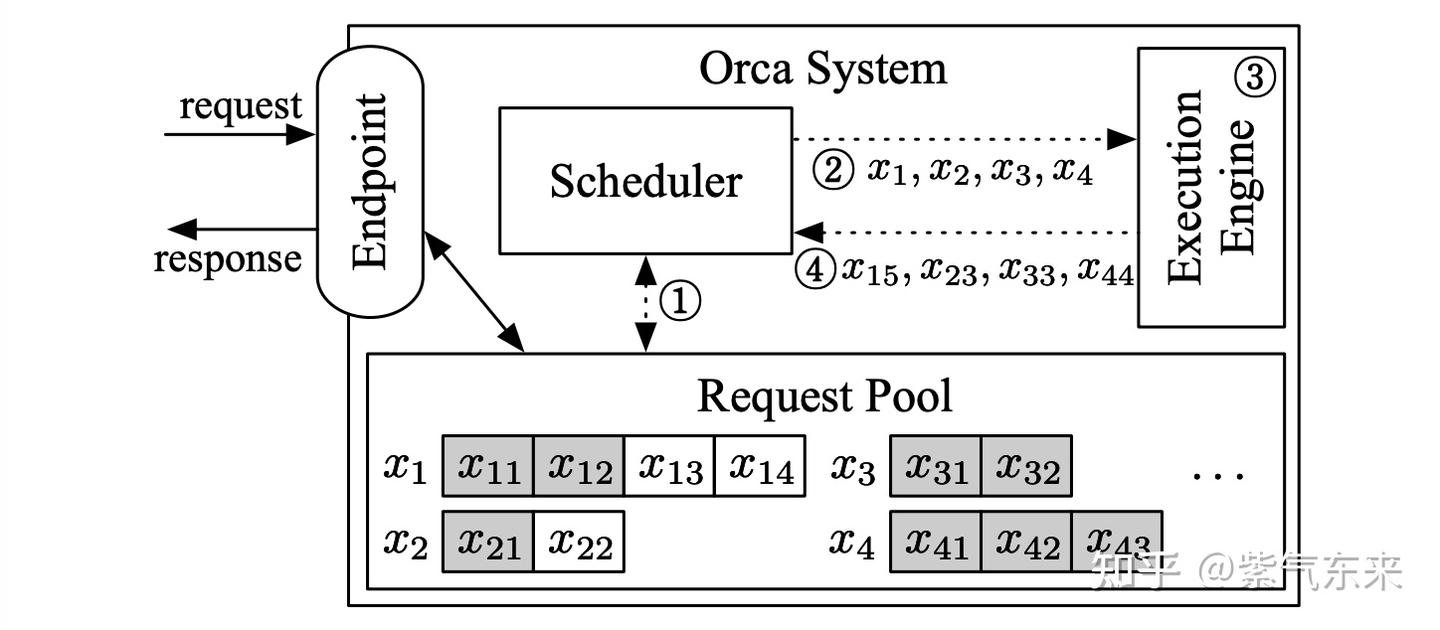 下图展示了使用 Dynamic Batch 完成七个序列的过程。 左侧显示单次迭代后的批次,右侧显示多次迭代后的 Batch 。 一旦序列发出序列结束标记,就在其位置插入一个新序列(即序列 S5、S6 和 S7)。 这样可以实现更高的 GPU 利用率,因为 GPU 不会等待所有序列完成才开始新的序列。
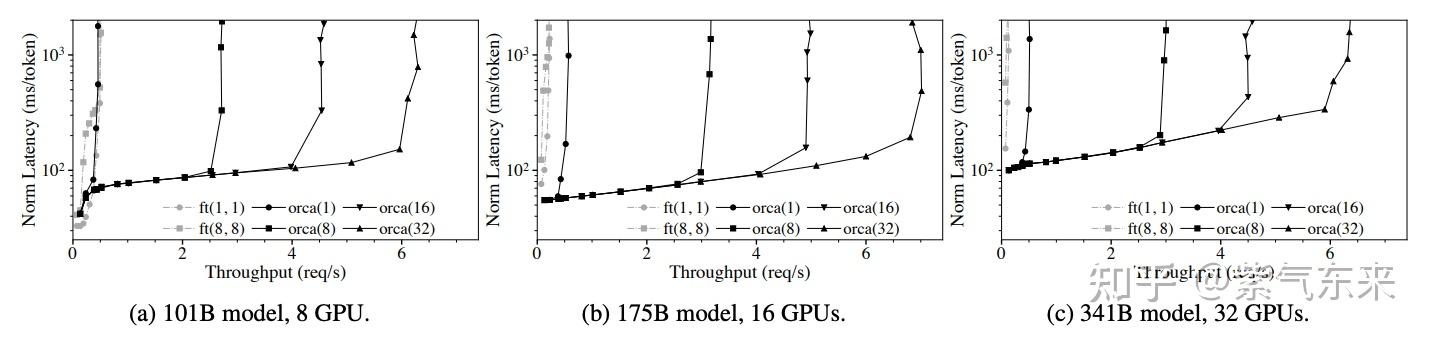
 结果显示在延时不变的情况下,其相对于FasterTransformer 可获得 36.9 倍的吞吐提升。
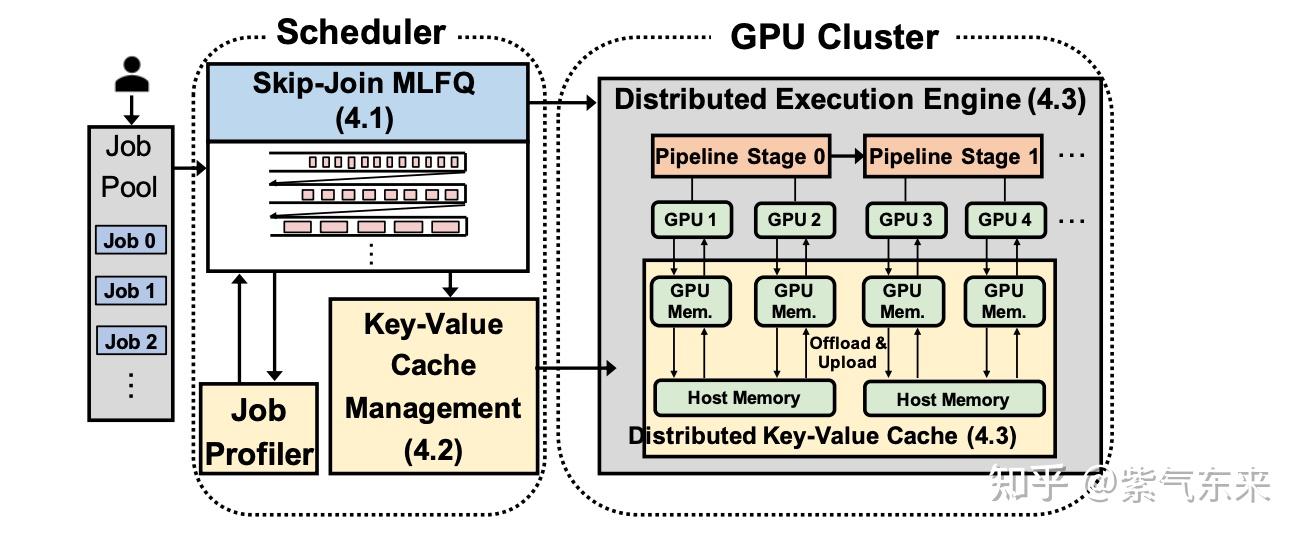
ORCA 使用first-come-first-served (FCFS) 处理推理作业, 计划任务持续运行直至完成。 由于 GPU 内存容量有限以及推理对延时敏感,无法通过任意数量的传入函数来增加处理,由此可能会导致队列阻塞。
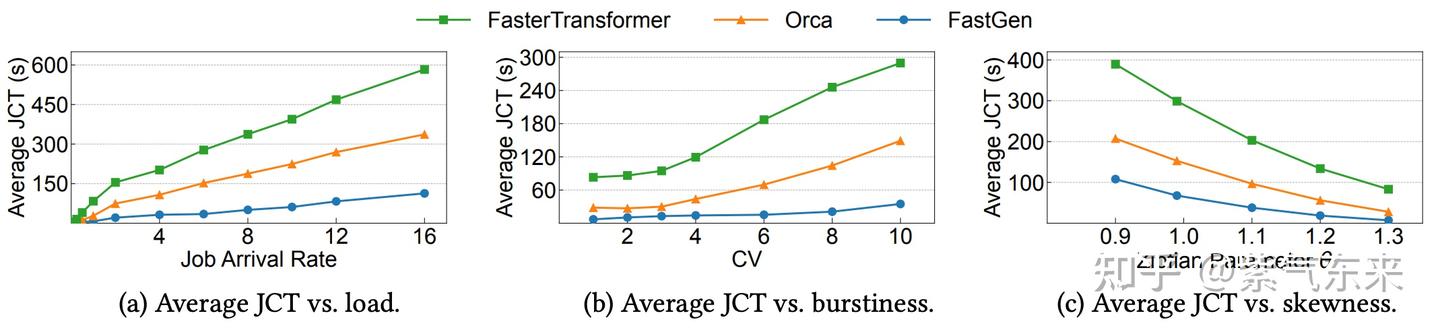
FastServe 使用 preemptive scheduling,通过新颖的跳跃连接 Multi-Level Feedback Queue 程序来最小化延时。 基于 LLM 推理的长度无法确定,调度程序利用输入长度信息来分配适当的初始值每个到达作业要加入的队列。 较高优先级队列跳过加入的队列以减少降级。 设计高效的GPU内存管理机制主动下载和上传 GPU 内存和主机内存之间的中间状态,以进行 LLM 推理。
 实验表明,该方法比ORCA有明显的性能提升
vLLM 的核心是 PagedAttention,其灵感来自传统操作系统概念,例如分页和虚拟内存。 它们通过在固定大小的“页面”或块中分配内存,允许 KV 缓存变得不连续。 然后可以重写 attention 机制以对块对齐的输入进行操作,从而允许在非连续的内存范围上执行 attention 。
这意味着 cache 分配可以 just-in-time,而不是 ahead-of-time:当启动一个新的生成任务时,框架不需要分配大小为 Maximum_context_length 的连续 cache。 每次迭代,调度程序都可以决定特定生成任务是否需要更多空间,并动态分配,而不会降低 PagedAttention 的性能。 这并不能保证内存的完美利用(浪费现在限制在 4% 以下,仅在最后一个块中),但它明显改善了当今业界广泛使用的提前分配方案的浪费 。
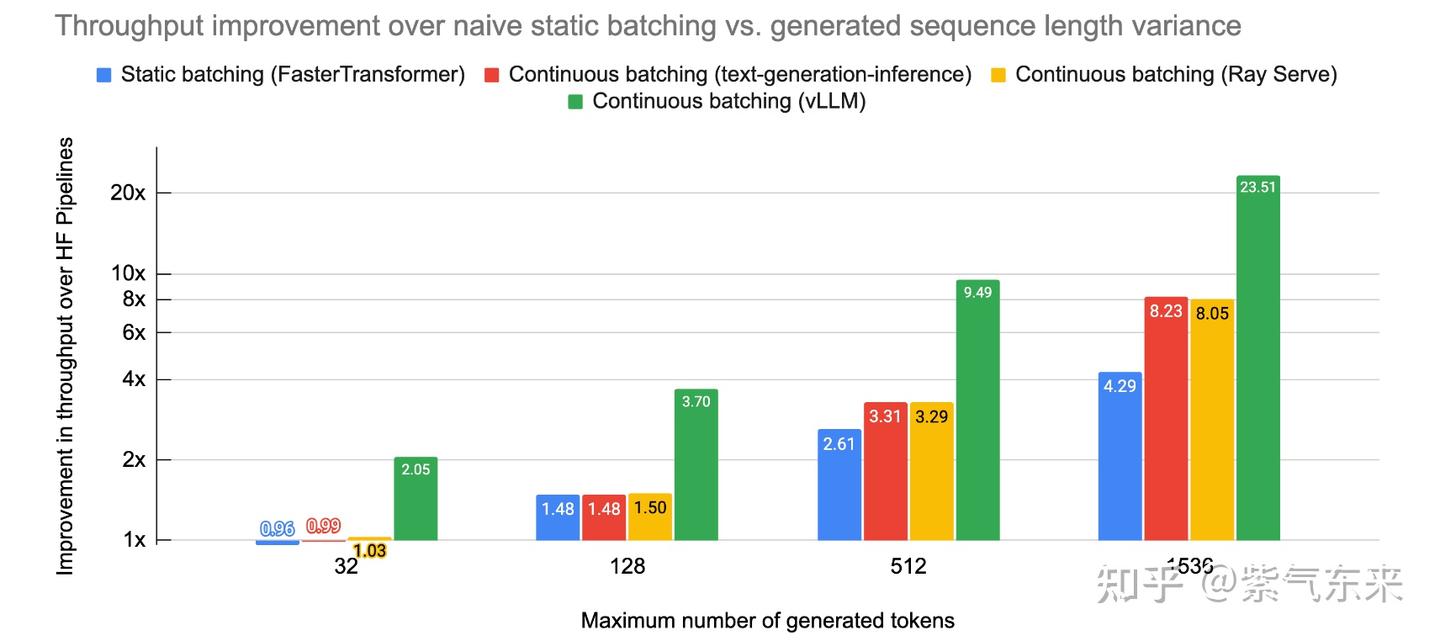
总而言之,PagedAttention + vLLM 可节省大量内存,因为大多数序列不会消耗整个上下文窗口。 这些内存节省直接转化为更高的 Batch 大小,这意味着更高的吞吐量和更便宜的服务。
实验表明,该方法相比于静态 Batch 与其他动态 Batch 的方法吞吐性能提升明显。
TGI 是 HuggingFace 开发的基于 Rust, Python 和 gRPC 的推理服务工具,其基本框架如下:
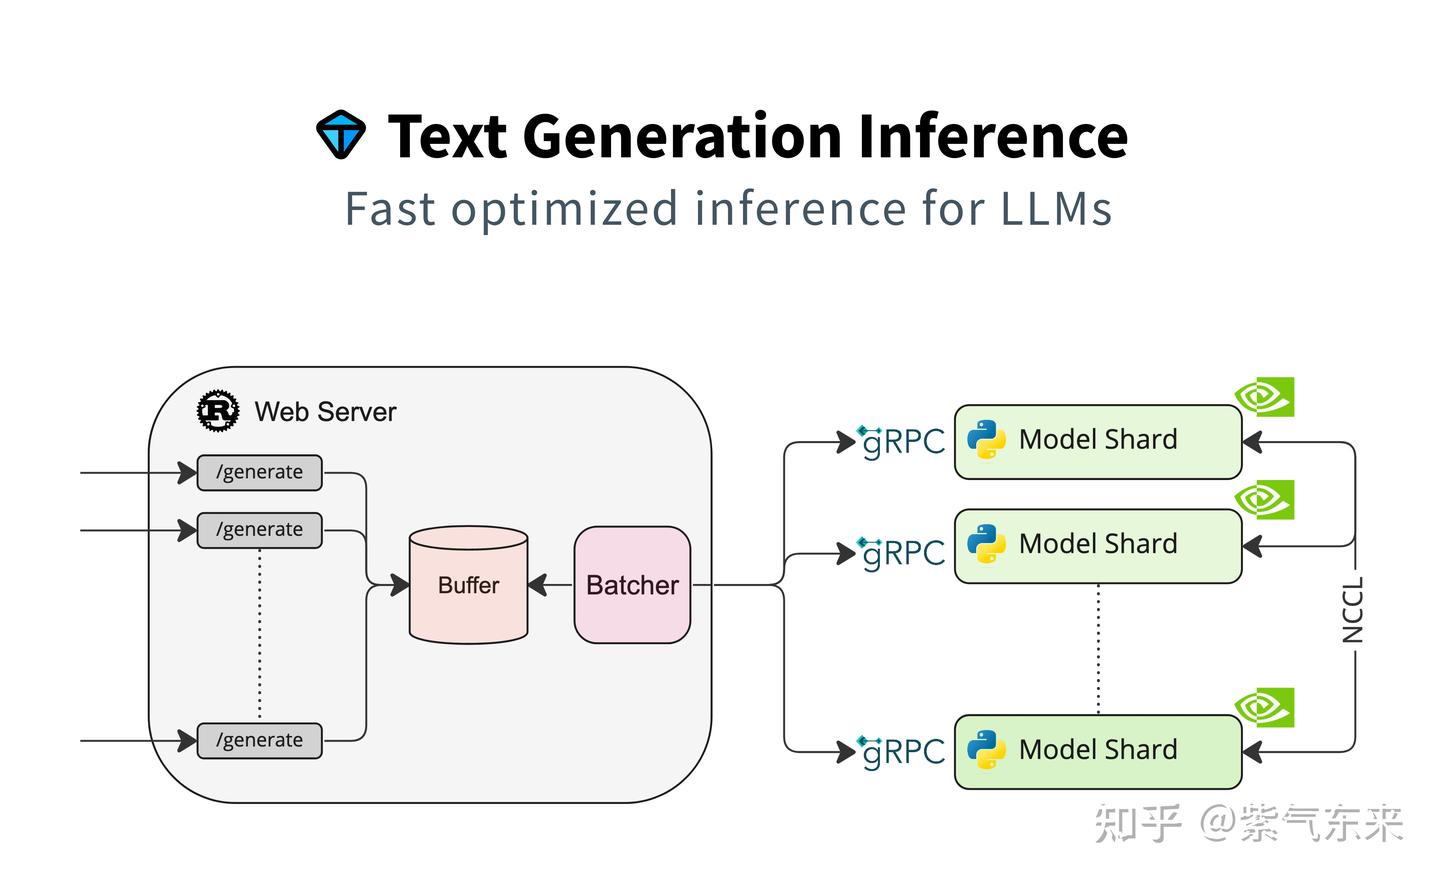 关于 TGI 的用法,可参考笔者的文章,同时对比了和 vLLM 和 FasterTransformer 的性能。
LMDeploy 是由 MMRazor 和 MMDeploy 团队开发的用于压缩、部署 LLM 服务的工具包。 它具有以下核心特点:
关于 KV cache 的典型优化方法及原理,可参考笔者的文章
LLM推理主要是受内存带宽限制的(memory-bandwidth bound)即 LLM 每个解码步所用的推理时间大部分并不是用于模型的前向计算,而是消耗在了将LLM巨量的参数从GPU显存(High-Bandwidth Memory,HBM)迁移到高速缓存(cache)上(以进行运算操作)。这个问题随着LLM规模的增大愈发严重。 推测解码方法的关键是使用了一大一小两个模型(分别记作Mp和Mq),推测解码方法的核心思想是:输入一个prefix,在用LLM(目标模型)做推理的同时,并行的让一个小得多的近似模型(approximation model)基于输入prefix以自回归的方式(autoregressively)来运行\gamma次,生成得到\gamma个token(被称作guesses或draft tokens),然后并行的(parallel run)让LLM对这些推测出来的token做评估,通过随机阈值r_{i}与概率分布比p_{i}(x)/q_{i}(x)的对比,从中挑选出n个token(都是由近似模型生成),随后让目标模型在n的基础上生成第n+1个token,最后把这n+1个token添加到原prefix之后作为新的prefix,然后重复整个过程直到满足停止条件(达到max length或生成了<EOS>等)。
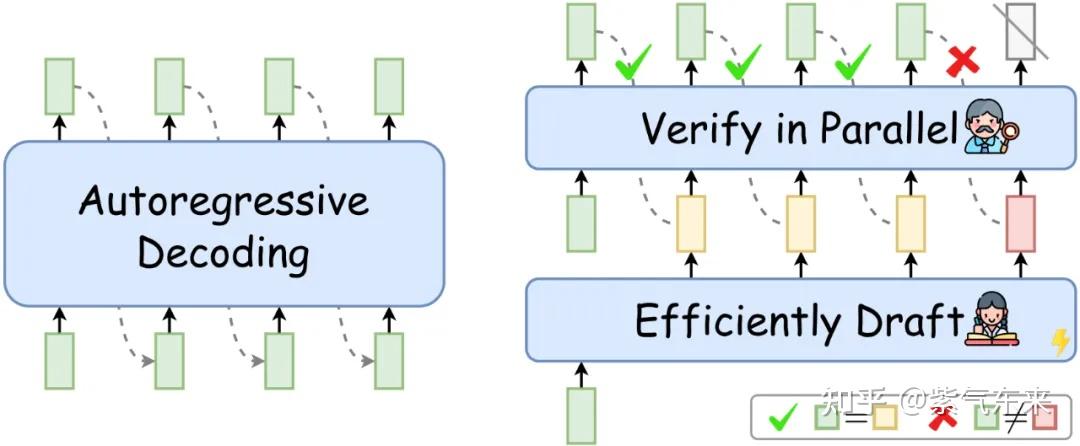 自回归解码 vs 推测解码
Medusa 主要思想是在正常的LLM的基础上,增加几个解码头,并且每个头预测的偏移量是不同的,比如原始的头预测第i个token,而新增的medusa heads分别为预测第i+1,i+2...个token。如上图,并且每个头可以指定topk个结果,这样可以将所有的topk组装成一个一个的候选结果,最后选择最优的结果。
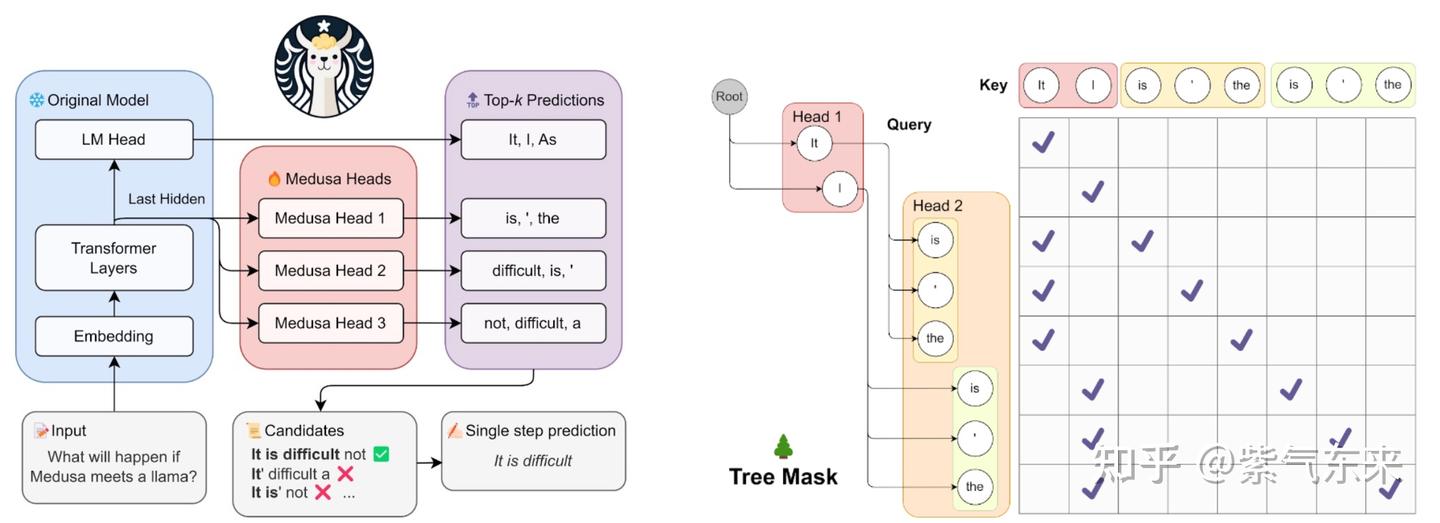 计算每个头组装之后的候选的最优解,其实这时候完全可以每个候选都走一次模型,算出概率,但是很显然不可能这样做,因为本来方案是为了加速,作者设计了一种tree attention的机制,可以做到只走一次模型来达到目的,如示例所示,第一个medusa heads的 top-2 预测和第二个medusa heads的 top-3 预测产生 2*3=6 个候选。假设原始的LLM输出是[0],第一个头是[1,2],第二个头是[3,4,5]。期望直接能把[0,1,2,3,4,5],输入模型就能得到一些概率的信息,但是不同的头对应的token的父节点是不同的,所以需要冗余一些token,方便添加mask变成[0,1,2,3,4,5,3,4,5],对应到右上的mask矩阵,每个节点只有父节点以及当前节点是1,这样其实就能得到一个树的路径关系。
第一次用美杜莎头解码的时候,是看不到前面i个token的,而再次输入模型可以看到完整的上文,得到完整的概率之后,可以通过头计算得到树的路径信息,比如示例对应的路径index是[0,1,3] , [0,1,4], [0,1,5], [0,2,6],然后基于后验概率得到最优的候选片段。
以上主要介绍了在算法和模型层面的优化方法,除此之外,升级硬件系统可以进一步提升整体性能,下面将介绍几种可用于(和潜在的)推理加速的硬件产品。
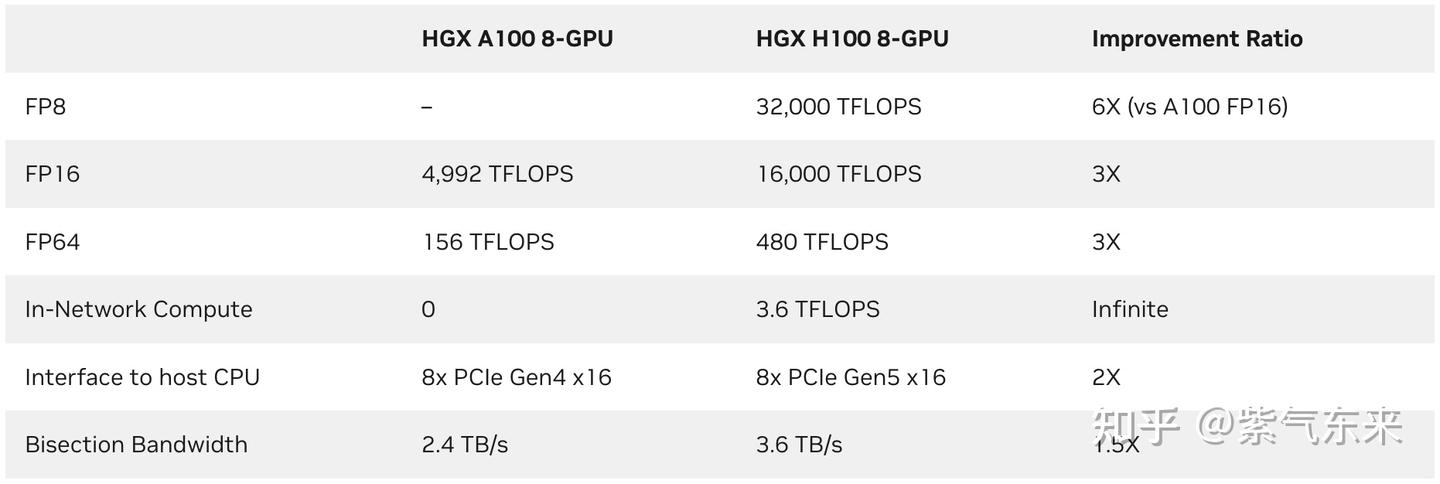
NVIDIA H100 核心架构与 Ampere 相似,数学运算部分布置在144组CUDA上,最高可拥有18432个FP32(单精度)、9216个FP64(双精度)CUDA核心,辅以576个第四代Tensor核心。H100核心采用台积电的N4工艺制造,内建800亿个晶体管,核心面积仅有814m㎡。其与A100 主要参数对比如下:
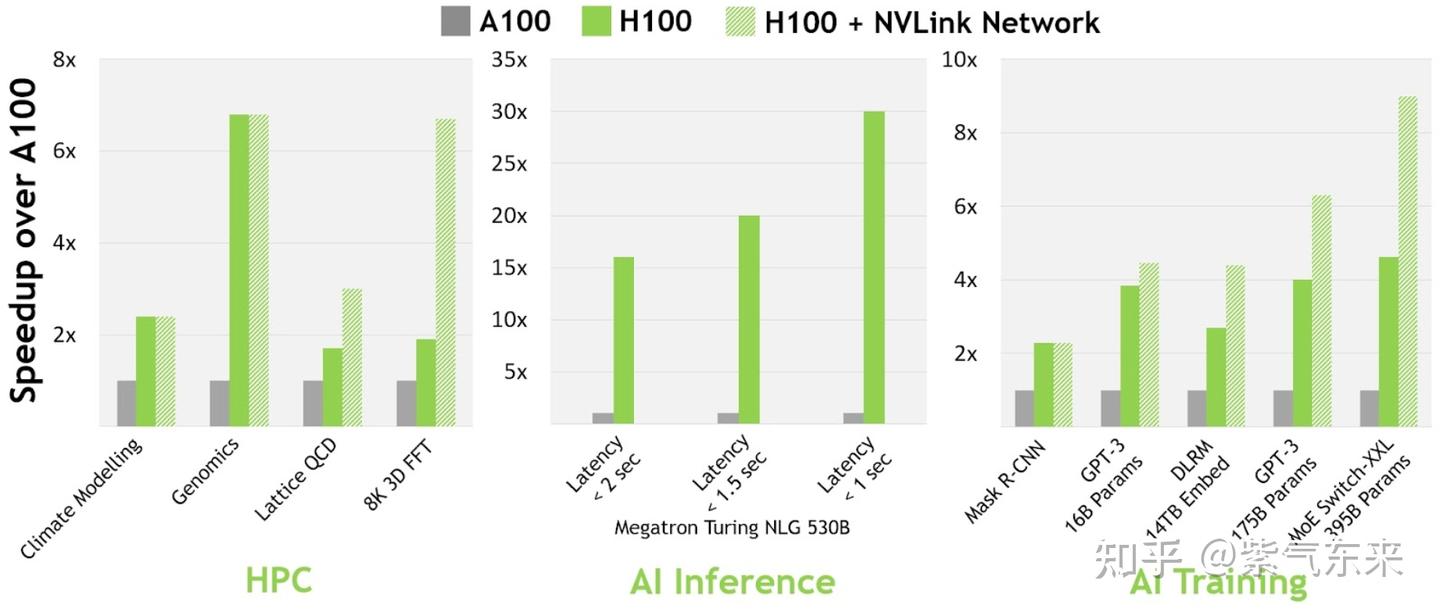
 在性能方面,H100 较 A100 也有明显提升,其部分数据如下所示。
AMD MI300 处理器集成了24个Zen 4架构CPU核心,以及CDNA 3架构GPU核心,周围还有着8颗HBM3高速缓存,容量高达128GB,总计拥有1460亿个晶体管。与上一代 MI250相比,MI300进行AI运算的速度将提高至8倍,能效方面也将提升5倍。 目前未找到公开的在 LLM 方面的推理性能数据。
M2 Ultra 采用第二代 5 纳米工艺制造,并使用 Apple 突破性的 UltraFusion 技术连接两个 M2 Max 芯片的芯片,使性能提高一倍。 M2 Ultra 由 1340 亿个晶体管组成,比 M1 Ultra 多了 200 亿个。 其统一内存架构支持突破性的192GB内存容量,比M1 Ultra多出50%,并具有800GB/s的内存带宽,是M2 Max的两倍。 M2 Ultra 配备更强大的 CPU(比 M1 Ultra 快 20%)、更大的 GPU(快 30%)以及神经引擎(快 40%)。 目前未找到公开的在 LLM 方面的推理性能数据。
[1] Large Transformer Model Inference Optimization [2] Efficient Inference on a Single GPU [3] How continuous batching enables 23x throughput in LLM inference while reducing p50 latency | Anyscale [4] https://www.coreweave.com/blog/serving-inference-for-llms-nvidia-triton-inference-server-eleuther-ai [5] https://medium.com/mobius-labs/accelerating-large-language-models-strategies-for-enhancing-your-ai-inference-speed [6] LLM-Pruner: On the Structural Pruning of Large Language Models [7] https://jonathan-hui.medium.com/ai-chips-a100-gpu-with-nvidia-ampere-architecture-3034ed685e6e [8] arxiv.org/pdf/2302.14017.pdf [9] 7 ways to speed up inference of your hosted LLMs. «In the future, every 1% speedup on LLM… | by Sergei Savvov | Jun, 2023 | Medium | Medium [10] https://arxiv.org/pdf/2104.08378.pdf [11] Introduction to Weight Quantization | Towards Data Science [12] Accelerating Large Language Models via Low-Bit Quantization | NVIDIA On-Demand [13] 认真读读WeightOnly - 知乎 (zhihu.com) [14] https://hackmd.io/@felixkao/HkZaooPD3 [15] SpecInfer: Accelerating Generative Large Language Model Serving with Speculative Inference and Token Tree Verification [16] Fast Inference from Transformers via Speculative Decoding [17] Accelerating large language model decoding with speculative sampling
钟鼎山林都是梦,人间宠辱休惊。 —— 辛弃疾 《临江仙》 编辑于 2025-03-14 10:50・上海 LLM 自然语言处理 ChatGPT 赞同 99836 条评论2700 226 分享 申请转载
未登录用户
36 条评论
默认
最新
 maja
 很赞。这一期不算是NLP独有了,关于第一部分,Fastertransformer其实我发现如果第三方直接使用,QKV比较容易出现匹配失败,原因就是第三方在做 QK 会加入 Mul mask等操作,再送入soft Max。所以这块其实需要针对不同需求不断扩展状态机匹配模式。Layernorm 存在类似问题,因为layernorm 算子有不同的形态,数学等价,需要格外注意⚠️。
 2023-07-15 · 北京
回复5
展开其他 4 条回复
 Merce Pan
目前未找到公开的在 LLM 方面的推理性能数据。


 2023-07-27 · 上海
回复2
 maja
Sparsity 我一直在关注 但是感觉Nv的动力不足,最优秀的Sparsity实现需要和tensor core等矩阵乘加DSA加速模块配套。我这里还是推荐可以关注下 GC发布的Block sparsity 已经 墨芯的 sparsity tensor core. 按理说人的大脑🧠在幼年,青春期有两次大的剪枝和sparsity对认知进行重大革新。但是sparsity 无论是工业界 和 学术界)学术界可能没法提出和tensor core 使用方式一致的sparsity) 进展还是太慢了
 ,需要有一个领军人物出来扛起大梁。
2023-07-15 · 北京
回复2
 正经人
谢谢作者的总结,感觉能写一篇综述了,目前还没有人总结。看到的唯一一篇还是总结的量化技术: A Comprehensive Survey on Model Quantization for Deep Neural Networks in Image Classification 。 另外有个问题,微软23年提出的LLMA属于这里面的方法中的任意一种吗?文章链接: http://arxiv.org/abs/2304.04487。
2023-08-30 · 荷兰
回复1
 紫气东来
作者
LLMA 并不是一个通用的推理优化的方法,主要是是针对有 reference 的情况,另外在推理时也使用了 accelerate
2023-08-30 · 上海
回复喜欢
展开其他 1 条回复
 Hehehe
每篇的诗句,随机的,还是和本篇相关
2024-04-10 · 上海
回复喜欢
 紫气东来
作者
和写作时候的心情、环境、状态相关
2024-04-10 · 上海
回复1
 Grizz
谢谢分享,很棒的总结,期待作者继续输出
 2024-03-16 · 浙江
回复喜欢
 张伟
谢谢分享
2024-01-11 · 浙江
回复喜欢
 BlueDog
作者你好,首先感谢你的精彩分享!我想请教一个问题,既然想把batch中请求的起始时间分开而不需等待,那为什么非要这么麻烦地使用dynamic batching的技术呢?为何不直接启动多个进程,每个进程每次就执行一个请求呢?(共享context或runtime很容易做到)
2023-09-27 · 北京
回复喜欢
紫气东来
作者
是这样,如果每次只跑BS=1,你说的没有问题,但是BS1通常卡的算力得不到充分利用
2023-09-27 · 上海
回复1
查看全部 6 条回复
 冰镇小牛奶
你咋这么卷
 2023-09-19 · 浙江
回复喜欢
 炼金术士
看文章意思,TP, PP 目的还不一样??
不应该都是为了加载更大 的模型么?为何TP 说是用来减少时延呢
2023-09-13 · 广东
回复喜欢
 紫气东来
作者
从整体上来说是为了放更大模型,但是二者还是有很多不一样的地方,在训练和推理上也不太一样
2023-09-13 · 上海
回复喜欢
点击查看全部评论
未登录用户
关于作者
紫气东来
吾生也有涯,而知也无涯~
上海交通大学 工学硕士
回答 32 文章 114 关注者 24,445
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 Xinference:本地部署需要的LLM,embedding,rerank大模型 Nicole
 LLM推理并行优化的必备知识 kaiyuan
 全景解读高效推理:LLM 也会「想太多」? tomsh...发表于硅基进化
 LLM推理加速调研 akaih...发表于LLM(大...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码