 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
【RLHF】怎样让 PPO 训练更稳定?早期人类征服 RLHF 的驯化经验
首发于何小枝与NLP的快乐日常
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
【RLHF】怎样让 PPO 训练更稳定?早期人类征服 RLHF 的驯化经验
首发于何小枝与NLP的快乐日常
切换模式
 何枝
如果人人都做有意义的事,那有趣的事该由谁去做呢。
收录于 · 何小枝与NLP的快乐日常
374 人赞同了该文章
目录
作为 Reinforcement Learning 中的顶流算法,PPO 已经统领这个领域多年。直到 [InstructGPT] 的爆火,PPO 开始进军 LLM 领域,凭借其 label-free 的特性不断拔高基座的性能,在 [Llama2]、[Baichuan] 的工作中都能看到 RLHF 的身影。
于是你开始摩拳擦掌,跃跃欲试,准备利用这项强大的技术来进化自己的基座,
但当你信心满满地跑通训练任务时,你看到的情况很有可能是这样的:
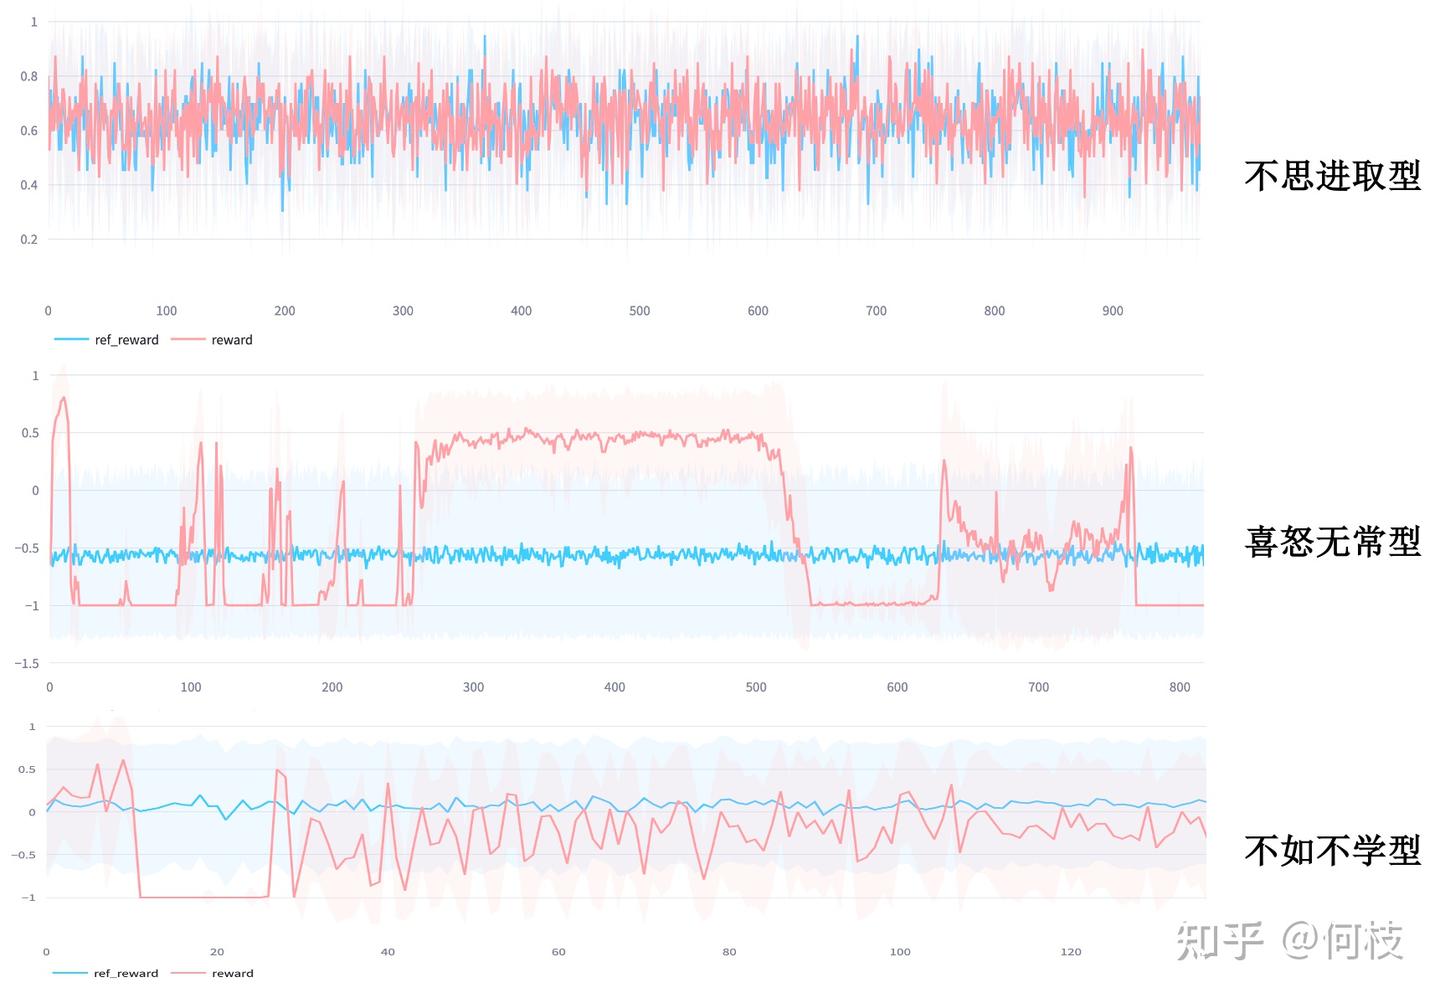 各种形形色色的失败案例
尽管鲁迅先生曾言:真的强化敢于直面惨淡的结果,敢于正视崩坏的曲线。
但日复一复地开盲盒难免会让人心脏承受不了,好在前人们留下了宝贵的驯化经验。
我们今天一起来看一篇「如何稳定且有效地训练 PPO」的论文,
在这篇文章中我们将学习:哪些技巧能够稳定训练过程、哪些指标能够代表着训练的顺利进行等内容。
Paper 传送门:Secrets of RLHF in Large Language Models Part I: PPO
Code 地址:https://github.com/OpenLMLab/MOSS-RLHF/tree/main
RL 的整个训练目标都是围绕着 reward 来进行,传统 RM 的训练公式为拉开好/坏样本之间的得分差:
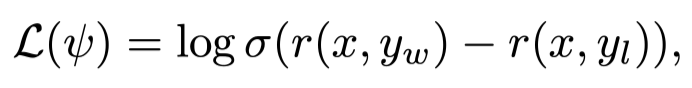 y_w 为 selected 样本,y_l 为 rejecte 样本
但是,仅仅是「拉开得分差」这一个目标很有可能让 RM 陷入到「钻牛角尖」的困境中,
为了保持住 RM 的本质还是一个「语言模型」,** 文章在原本的 loss 中加入了对「好样本」的 LM loss** :
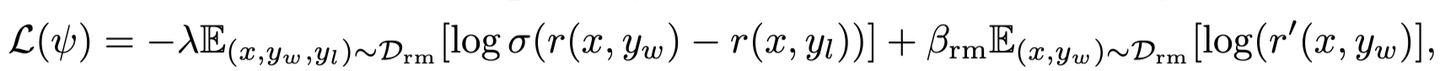 在原来的 loss 基础上顺便学习写出「优秀样本」,保持住模型能写句子的能力
值得一提的是:文章中的 r' 是用了另外一个 RM' 来算 loss 的,RM' 的结构和 RM 一样,只不过输出的维度不是 1,而是 vocab_size。但其实我认为也可以使用一个带有 ValueHead 的模型来既训练打分又训练写句子,毕竟这 2 个任务都需要模型知道什么的句子是「好句子」—— 还能省显存。 以下是论文训练 RM 的详细参数:
| 参数 | 值 |
| --- | --- |
| model | LLama 7B |
| training_dataset | 英文:16w pairs(11.8w 有用性 + 4.2w 有害性)
中文:3.9w pairs(3.1w 有用性 + 8k 有害性) |
| learning_rate | 5e-6 |
| batch_size | 4~128 动态变化(为了固定一个 batch 内 token 总数) |
| step | 1000(≈ 1.06 epoch) |
| β | 1.0 |
一般的,我们会使用 prefered sample - disprefered sample 的分差来衡量 RM 的效果:图左为在中文标注数据集上的分差分布,图右为在英文数据集上的分差分布(区分度不如中文) 完全理想的状况下,prefered - disprefered 应该都在 0 的右边(好样本的分数更高), 但考虑到标注中的噪声、模型的拟合能力等,存在少小部分 0 左边的样本是合理的,拉出来人工评估下即可。 此外,文中还提到:** 只看 Acc 并不能够很好的衡量 RM 的性能,但尚未给出其他可以衡量的指标 。**
PPO 训练中很常见的一个问题是「模式崩溃」,其典型特征为:长度很长且无意义的文字。
| prompt | response |
| --- | --- |
| 请帮我写一条货物的评论。 | 易碎品就的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的的 |
而对于这种「崩溃的输出」Reward Model 往往还容易打出一个很高的分数,这将导致我们无法在训练过程中及时的发现问题,等训完对着一个满意分数的 checkpoint 看生成结果的时候才发现空欢喜一场。
对于上述这种问题,我们可以通过 3 个指标来监控:KL、Response Length、Perplexity。
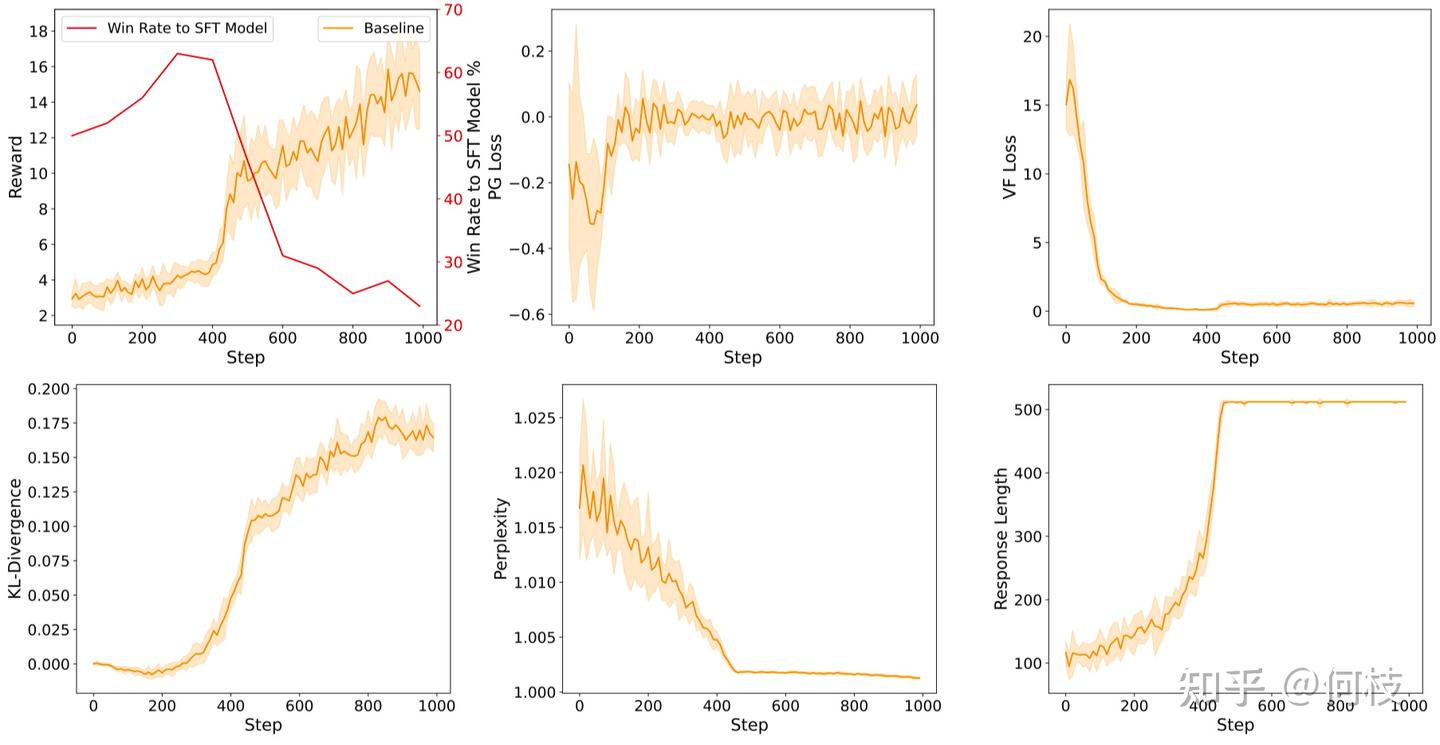 训练过程中的各种指标,从约第 420 step 开始: 1. reward 出现骤增。2. KL 出现骤增。3. Perplexity 出现骤降。4. Response Length 出现骤增。5. 训练效果出现骤降(图左上红线)
因此我们可以总结出几种指标异常的情况:
PPO 的整个训练都是围绕优化 Score 作为目标来进行的,和 Score 相关的变量有 2 个:
对于这 2 个值,我们都可以对其进行「归一化」和「裁剪」。
Reward 的处理公式如下:
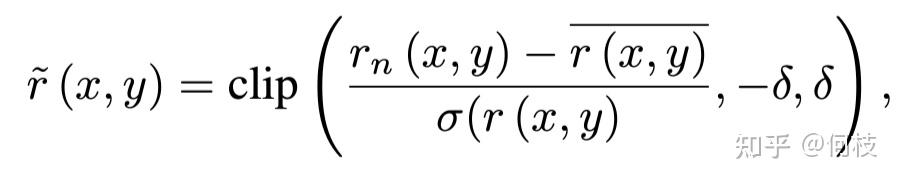 Reward Normalization & Clipping
上述式子将 reward 化成了一个均值为 0 的标准分布,均值为 0 是为了保证在训练过程中得到的正负奖励能够尽可能的均匀,如果一段时间内全为负或全为正从直觉上来讲不太利于模型学习。 文中提到,使用 clipping 可以限制模型进化的「最终分数」没有那么高, 鉴于之前「分数越高,并不一定有更好的效果」的结论,作者认为使用 clipping 对最终的效果是有益的。 至于 Advantages,在 PPO 的标准流程里已经会对其进行 Normalization,而 advantage clipping 和 reward clipping 在本质上其实很相似,则只用在 reward 阶段进行截断即可, 所以对于 Advantage 来讲不需要做太多其他额外的操作 。
在传统的 PPO 流程中,我们通常会对 Policy Molde 的 Loss 上做以下 2 种操作:
除了上述 2 个传统设置外,RLHF 中加入一个新的指标:Token Level KL-Penalty 。
在传统的 RL 流程中,agent 每采取一个 action 后都会得到一个 action reward,
对比到文本生成任务中,每新生成一个 token 就等于做出了一次 action,
但实际上我们无法每生成一个 token 就打出一个分数,我们只能在一个完整句子(Trajectory)生成完成之后打出一个 Total Reward。
这就比较痛苦了,当我们只有一个长序列的最后得分时,前面的每一个 step 的得分估计就变得非常困难。
因此,为了避免「sparse reward」的同时限制 Policy Model 朝着「相对合理的方向」进化,
我们会通过计算每个生成 token 与参考模型之间的 KL 来作为单个 token 的 reward 分数。
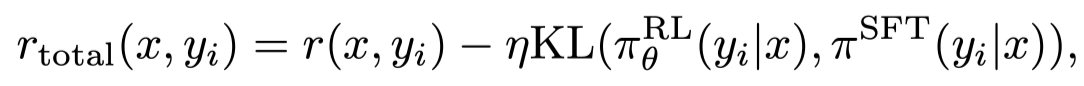 式子的前半部分为 reward(discounted)后半部分为 KL 惩罚分数
PPO 继承自 Actor-Critic 框架,因此算法中一共包含 2 个模型:Actor 和 Critic。
Policy Model 是指我们最终训练后使用的生成模型, Policy Model 需要具备一定基本的能力才能保证训练的稳定性,通常会选用SFT 之后的模型。这个比较好理解,如果我们选用 Pretrained Model 为起点的话,探索空间会非常大,同时也更加的不稳定(对 Reward Model 要求更高)。
一种很直觉的想法是:同样是「评判任务」,我们直接使用 Reward Model 来当作 Critic Model 就好了。 但其实这种想法不完全正确,从本质上来讲 Critic 需要对每一个 token 的状态进行打分,而 RM 是对整个句子进行综合得分评估,这两个任务还是存在一定的区别。 因此,一种更好的方式是:** 先训练 Critic Model一段时间,直到 Critic Loss 降的相对较低为止 。** 预先训练能够帮助在正式训练的初期 Critic 能够进行较为正确的 value 预估,从而稳定训练过程, 至于使用 SFT 还是 RM 作为 Critic 的结构,实验结果显示并没有非常明显的区别。
文章的末尾给出了作者汇聚了各种实验结果给出的一套推荐的策略:
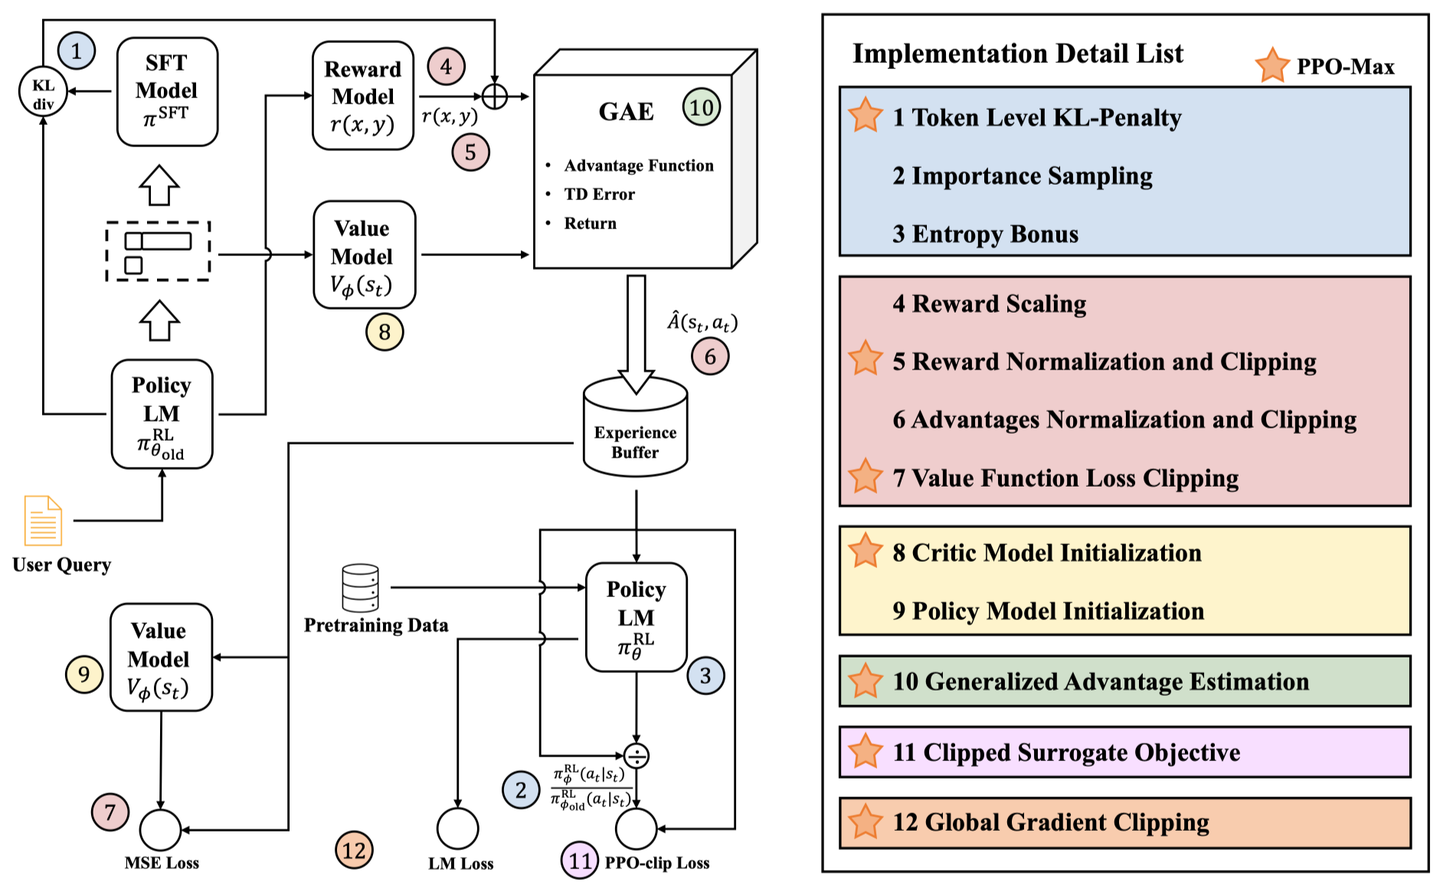
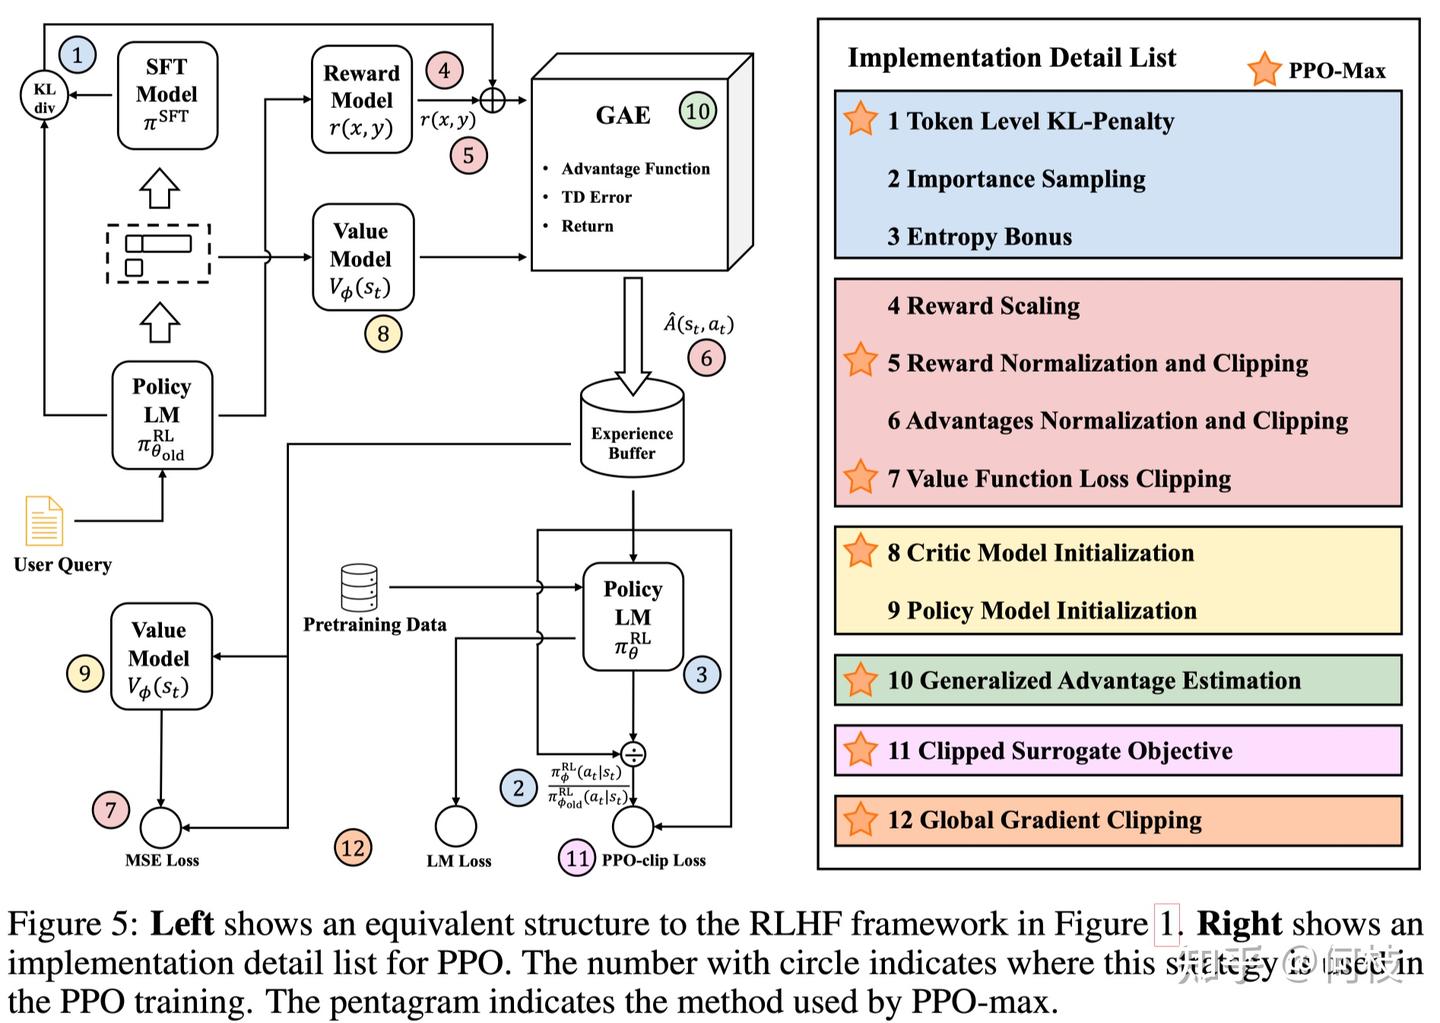 PPO-max 所使用的方法合集(标星的方法)
学习率设置:
| 阶段(7B Model) | 学习率 | batch size |
| --- | --- | --- |
| SFT | 9.5e-6( ≈ 1e-5) | 1024 |
| RM | 5e-6 | 4~128 |
| Actor | 5e-7 | sample:128
training:32 |
| Critic | 1.65e-6 | sample:128
training:32 |
这里顺便贴出 [Baichuan 2] 中 PPO 的参数设置:
| 参数 | 值 |
| --- | --- |
| critic pretraining step | 20 |
| learning rate(Actor & Critic) | 5e-6 |
| gradient clipping | 0.5 |
| ppo clip | 0.1 |
| KL penalty | 0.2 -> 0.005 |
| total training step | 350 |
以上就是这篇文章的全部内容,感谢观看。
编辑于 2023-12-26 04:29・北京
RLHF
LLM
强化学习 (Reinforcement Learning)
赞同 37425 条评论710 31
分享
申请转载
 未登录用户
25 条评论
默认
最新
 浮生若梦
太真实了我的训练效果就像图一一样不学无术,有点难绷
2023-12-01 · 天津
回复5
展开其他 1 条回复
 xiandi
太高产了
 2023-11-13 · 北京
回复1
 何枝
作者
 2023-11-14 · 北京
回复喜欢
 定格
想请假下,回复的长度初期忽然变短,然后稳定了。是什么原因呢
2023-11-15 · 上海
回复喜欢
 何枝
作者
常见问题,推测可能是因为 response_mask 的存在,导致 Policy Model 发现生成长度越短,KL 的惩罚就越小,但此时 RM 对于这种短答案给不出明显的负惩罚(之前大概率没有见过这类负例),所以 Actor 就倾向于生成的更短的回复。可以尝试下在 RM 的偏序中加入短回复以告知模型这种回复应该打惩罚分。
2023-11-15 · 北京
回复4
查看全部 9 条回复
 Lance黄
“至于 Advantages,在 PPO 的标准流程里已经会对其进行 Normalization,而 advantage clipping 和 reward clipping 在本质上其实很相似,则只用在 reward 阶段进行截断即可,所以对于 Advantage 来讲不需要做太多其他额外的操作。”
原本PPO中的clipping不是在policy的更新步长上做限制吗?还是不太清楚为什么在reward上做clipping在本质上可以替换掉之前的操作……
2025-07-24 · 广东
回复喜欢
 杨博
“但其实这种想法不完全正确,从本质上来讲 Critic 需要对每一个 token 的状态进行打分,而 RM 是对整个句子进行综合得分评估,这两个任务还是存在一定的区别。”
二者的区别在transformer架构重要吗?毕竟transformer的每个attention层里都有个softmax,相当于自动会对每个token的状态加权打分。
2024-06-20 · 美国
回复喜欢
 adsjfhakjsdgfajdgfk
可以问一下你训练的是多大的模型呢?更大的模型训练的时候是否更稳定呢?
2024-02-25 · 美国
回复喜欢
 贺茗风
想问一下,加入的LM loss为什么前面是正号呢?是想在拉大正负样本间分差的同时,减小正样本的平均分吗?
2023-11-29 · 中国香港
回复喜欢
 西红柿炒番茄
您好,我想请教一下,这个里面出现了critc网络,优势函数,但是我看的instruct gpt.还有llma2使用的,都只是reword值,这篇是介绍的通用的强化学习?而不只是针对llm的?
2023-11-25 · 北京
回复喜欢
 陈仲
第9个圆圈旁边的矩形里面不是value模型嘛? 怎么变成policy 模型了?
2023-11-15 · 美国
回复喜欢
展开其他 1 条回复
cerax
完全理想的状况下,prefered - disprefered 应该都在 0 的右边(好样本的分数更高),
但考虑到标注中的噪声、模型的拟合能力等,存在少小部分 0 左边的样本是合理的,拉出来人工评估下即可。
这个应该都在 0 的右边怎么理解,为什么disprefered理想情况不小于0?
还有个问题 openai明确提到将rw socre控制在均值为0的区间
2023-11-14 · 湖北
回复喜欢
何枝
作者
我理解:prefered_score - disprefered_socre > 0 (在 0 的右边)代表 RM 对 prefered 样本打出的分比 disprefered 样本更高,更能对齐人类的偏好标准,反之如果差值 < 0 代表 RM 的评价标准和人类的偏好相悖
2023-11-14 · 北京
回复喜欢
展开其他 2 条回复
未登录用户
关于作者
何枝
如果人人都做有意义的事,那有趣的事该由谁去做呢。
回答 60 文章 46 关注者 18,024
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 无需RL基础理解 PPO 和 GRPO JOYWI...发表于JOYWI...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码