 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
聊聊Anchor的"前世今生"(下)
首发于Winsty的技术碎碎念
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
聊聊Anchor的"前世今生"(下)
首发于Winsty的技术碎碎念
切换模式
 Naiyan Wang
 机器学习等 3 个话题下的优秀答主
收录于 · Winsty的技术碎碎念
468 人赞同了该文章
大家好,欢迎回来!我们继续上次的anchor之旅。从今年年初开始,整个detection领域掀起了“去anchor化”的潮流。由于有很多的解读都具体介绍过这些方法技术方面的细节了,所以这篇文章不会再重复,只做一个粗略的总结,更多讲讲我个人对这个潮流的一些想法。个人认为市面上现有的anchor free的方法基本可以分为真假anchor free两类(这个名字只是开个玩笑,不要当真,而且两者的界限也没有那么清晰 :-D):
“真”anchor free
这一类方法的鼻祖来自于ECCV18的工作CornetNet[8],一篇真的把detection当做了bounding box的corner keypoint detection,且第一次能和其他box based方法打成平手的文章。这一类方法的核心思想是没有直接instance的概念,独立预测框左上角和右下角的位置,然后通过associative embedding的办法聚起来对应的左上角和右上角从而得到一个instance。如果有了解human keypoint detection的同学就会知道,这个pipeline是和bottom up的multi-person keypoint detection一模一样的。
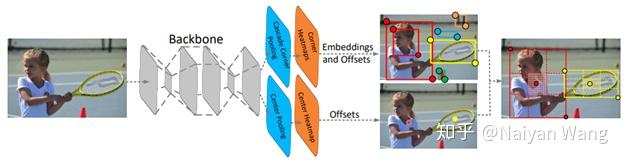
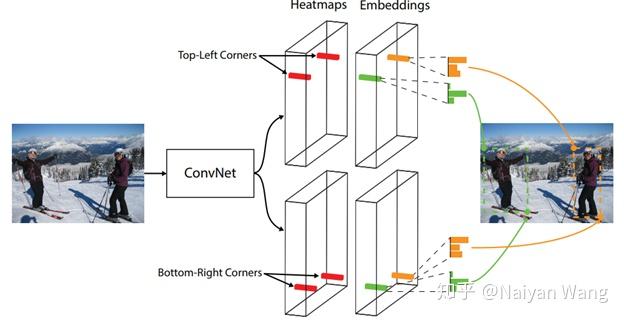 比较可喜的是,这类方法在性能上展示了非常强大的潜力,在ExtremeNet[9]和CenterNet[6]的不断改进下,甚至有超越传统one stage detector的趋势,而且方法本身也可以受益于各种SOTA的keypoint detection算法的研究。但就本质而言,框对于物体来说不是一个最好的表示。 框的顶点可能甚至都不在物体上,离物体本身已经很远了。CornetNet为了缓解这个问题,使用了Corner Pooling的办法来聚集在边上的检测结果到顶点。不过就算使用了CornerPooling,只使用两个顶点会导致存在大量的误检。CenterNet[6]的想法很简单,既然这些虚无缥缈的顶点这么难预测,我们为什么不去预测更简单更容易的中心点呢? 所以CenterNet在CornerNet的基础上加入了一支中心点预测,能够组成一个物体的要求不仅仅是两个顶点能匹配,同时这两个顶点定义的框的中心也要有对应的中心点相应,这样就缓解了很多奇怪的误检。CenterNet同时还提出了Center Pooling和Cascade Corner Pooling来改善对于中心点和顶点预测的精度。这里就不再展开,有兴趣的读者可以参阅原文。
 另外一个比较有意思的工作是RepPoints,这篇文章没有走CornerNet的老路,尝试去预测顶点,而是直接去预测9个representative points(这些顶点并没有明确的语义),然后找出包围这9个点的最紧框去和GT计算loss。然后loss只会回传给对生成这个框有贡献的那些点。整个的思路很清晰,而且方便实现,结果也相当不错。
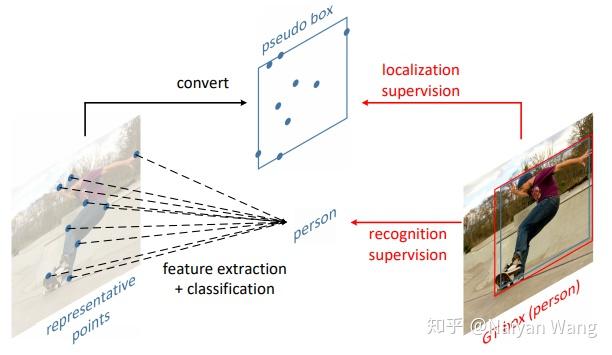 总结下这类方法:follow up工作不是很多,但是性能不俗。但是个人觉得这不会是这一类方法的终点:直接预测顶点虽然效果也不错,但是总是不是很直观;RepPoints的思路独树一帜,个人比较喜欢。后续这个思路应该可以延伸出一些直接使用更准确的mask为监督的工作,这也有可能是一条可以做出更干净更漂亮的panoptic segmentation之路。
“假”anchor free
这一类方法最早的起源是15年的工作DenseBox[10]。(为了避免争议,这是第一篇在这个思想下我认为达到高质量完成度的工作)这一类方法的核心思想是改变one stage detector中对于:1)分类任务中assign正负样本的方式和 2)回归中target的设置。原本anchor based的方法,通过预先指定的anchor和GT的IoU来assign正负样本,回归的都是相对于anchor box的偏移量。在这一批工作中,由于没有anchor的存在,这个流程就简化成了:1) 对是不是某个物体的中心点附近进行分类。2) 对是中心点的位置,直接回归对应的scale(可以是长宽,也可以是到框四条边的距离等)。**核心思想是改变了bounding box的编码方式。**最早了解到类似的思想是在自然场景文字检测中,EAST之类的方法提出了这样简单干净的pipeline,这样的想法加上一些改进也最终被运用到了通用物体检测中。
核心思想是这样的论文有[1-5],但是在细节上每篇处理不甚相同。FSAF[1]在网络中同时使用anchor based分支和anchor free分支,两支起到互补的作用,并在线选择了每个物体应该被assign到FPN的哪一层中;FCOS[2]除预测上述提到的中心点和长宽之外,还额外预测了一支Centerness,在实验中证明对于抑制一些偏离中心很远的误检非常有作用;另一篇CenterNet[3]在这样的基础上更进一步,除了2D框的长宽之外,把其他各种任务所需要的信息(如3D框的大小和朝向,深度信息等等)都作为这个中心点要来预测的任务,大幅拓展了这样一个想法的适用范围。
上次说了这么多anchor的产生原因和好处,为什么突然在这个时间点anchor free的方法不约而同地火了起来呢?个人觉得,机缘巧合,这个原因恰恰在于RetinaNet中两个重要的元素FPN和Focal Loss。
首先说FPN,anchor free的做法相当于feature map的每个位置只能输出一个框,可以想象,如果没有FPN这种多层级的表示,如果最终的feature map downsample的倍数是8或者16,那么可能会有很多物体的中心点落在同一格子中。这样就会导致训练的时候有很大的歧义性。随着FPN的引入,不同scale的物体被分配到了不同的层级上,冲突的概率大大降低。在CenterNet中,作者还特意起计算了冲突的比例,实际不到0.1%,对于性能的影响实际上也是微乎其微的。回顾下在上一篇文章提到的引入anchor的一个motivation恰恰就是,在FPN中这样的问题被规避掉了,这是我认为anchor free方法回归的第一个重要原因。
再说Focal loss,由于物体的中心区域是远小于其他背景区域的,整个分类的正负样本和难易样本是极不均衡的。直接训练这样的分类问题很难收敛到一个满意的结果。这样的问题其实在传统的one stage detector中同样存在,解决方案就是OHEM或者focal loss这样的加权办法。实测中,focal loss的结果会更好一些,所以focal loss也基本上被所有这类的方法所采用。
不过个人觉得这些方法其实没有触及到one stage detector中的一个核心问题:框和对应feature的misalignment。这个问题有机会我会再和大家展开介绍。
总结
虽然现阶段anchor free的办法在性能和简洁性上都还没完全压倒anchor based的前辈,但是其中蕴含的一些思想还是比较值得深思的,比如前面提到的,在图像上一个物体的更好表示是什么?怎么去更好利用这样的表示?相信这次anchor free的潮流也势必会孕育这下一次物体识别和分析领域的革命。
[1] Zhu, C., He, Y., & Savvides, M. (2019). Feature Selective Anchor-Free Module for Single-Shot Object Detection. arXiv preprint arXiv:1903.00621.
[2] Tian, Z., Shen, C., Chen, H., & He, T. (2019). FCOS: Fully Convolutional One-Stage Object Detection. arXiv preprint arXiv:1904.01355.
[3] Zhou, X., Wang, D., & Krähenbühl, P. (2019). Objects as Points arXiv preprint arXiv:1904.07850
[4] Kong, T., Sun, F., Liu, H., Jiang, Y., & Shi, J. (2019). FoveaBox: Beyond Anchor-based Object Detector. arXiv preprint arXiv:1904.03797.
[5] Liu, W., Liao, S., Ren, W., Hu, W., & Yu, Y. (2019). High-level Semantic Feature Detection: A New Perspective for Pedestrian Detection. arXiv preprint arXiv:1904.02948.
[6] Duan, K., Bai, S., Xie, L., Qi, H., Huang, Q., & Tian, Q. (2019). CenterNet: Keypoint Triplets for Object Detection. arXivpreprint arXiv:1904.08189.
[7] Yang, Z., Liu, S., Hu, H., Wang, L., & Lin, S. (2019). RepPoints: Point Set Representation for Object Detection. arXiv preprint arXiv:1904.11490.
[8] Law, H., & Deng, J. (2018). Cornernet: Detecting objects as paired keypoints. In Proceedings of the European Conference on Computer Vision (ECCV) (pp. 734-750).
[9] Zhou, X., Zhuo, J., & Krähenbühl, P. (2019). Bottom-up Object Detection by Grouping Extreme and Center Points. arXiv preprint arXiv:1901.08043.
[10] Huang, L., Yang, Y., Deng, Y., & Yu, Y. (2015). Densebox: Unifying landmark localization with end to end object detection. arXiv preprint arXiv:1509.04874.
编辑于 2019-06-10 05:47
深度学习(Deep Learning)
目标检测
赞同 46824 条评论434 5
分享
申请转载
 未登录用户
24 条评论
默认
最新
 划水
misalignment 用deformable 能缓解吗?感觉roi pooling才是two-stage核心.求大佬早点更新~~
2019-06-06
回复4
 Naiyan Wang
作者
Deformable weight是学的,所以并不能保证。这个问题我们是做了一篇nips... 等有结果了一起讲吧~
2019-06-07
回复1
查看全部 9 条回复
 王Sr
感觉目前很多anchor free的方法都在批判anchor based方法的label assignment,而没有真正触及anchor存在的合理性,很多anchor free的方法与anchor本质上也可以兼容
2019-08-09
回复3
 Yangyang
“one stage detector中的一个核心问题:框和对应feature的misalignment”,那么two stage detector中是因为有roi pooling减轻了misalignment问题?期待乃岩首席的下篇关于misalignment的文章~
2019-09-09
回复1
 快使用双截棍巴拉
centernet 和 densebox 有本质区别吗。。 感觉做法都是一个思路的呀
2019-09-01
回复喜欢
 cn123
““anchor free的做法相当于feature map的每个位置只能输出一个框” 这个是什么意思呢?为什么只能输出一个框?并没有这种直观的感觉
2019-08-29
回复喜欢
展开其他 2 条回复
 pyyy
开拓了眼界, 有想法的人相对多, 有想法又能高质量完成的很少
2019-06-10
回复喜欢
 陈云
我觉得fpn不是必需的,像object as points(也叫centernet)就是一个scale的feature map(4x)直接预测
2019-06-09
回复喜欢
展开其他 1 条回复
 KIvee
强!其实关于keypoint的这种方法,在BMVC2016有一篇LocNet,我觉得也是一篇有启发意义的文章,作者把twostage的第二个部分的bbox回归换成了直接输出两个向量,来表示物体框4条边的响应,因为输入的proposal里一般只有一个物体,所以不用考虑边的匹配。而且文章提出的pooling方式也和cornernet里面的corner pooling有相似之处。但估计作者没有解决在有多个物体的情况下,边之间如何匹配的问题,当时也就没有直接将这个方法扩展到以完整图片为输入。自己试过加上预测中心点的位置,然后利用边和中心点的几何约束来解决多个物体的情况,结果能work,但是效果并不高,也就不了了之了。去年看到cornernet,感觉真的是自己的知识面太窄了,别人竟然用keypoint里面的方法来做这个事情,自己却都没有听说过。。。深感自己的弱小,继续努力,向博主看齐
 2019-06-06
回复喜欢
 Naiyan Wang
作者
还没看过,回头学习一下。类似想法我觉得可能很早就有了,但是高质量完成cornernet是第一个。
2019-06-07
回复1
 kk111
感觉reappoints算是某种程度上在解决onestage框与feature misalignment 的问题吧,只不过似乎复现并不简单(至今未能复现),论文写的太赶了,很多细节都没交代,期待作者code吧
2019-06-06
回复喜欢
Naiyan Wang
作者
算是,但是也不是传统意义上的解决。。
2019-06-07
回复喜欢
展开其他 1 条回复
未登录用户
关于作者
Naiyan Wang
CS PhD, 机器学习与计算机视觉
机器学习、人工智能、深度学习(Deep Learning) 话题的优秀答主
回答 130 文章 46 关注者 82,159
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 Anchor-free Detection(上) MissingBear
 Anchor or No-Anchor smile...发表于浅析计算机...
 再谈Anchor 我思故我在发表于计算机视觉...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码