 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
开源的大模型预训练语料
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
开源的大模型预训练语料
切换模式
 nghuyong
略懂些NLP|非典型程序员
39 人赞同了该文章
本文汇总了当前中英文开源的预训练数据集。目前的核心观点是: 大规模高质量的网络数据 is All you Need ,无需手工调配各种数据源,例如百科,书籍,代码等。
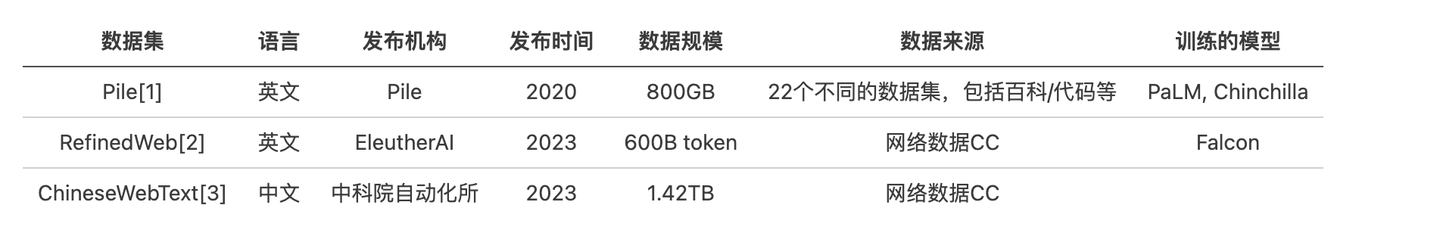
Pile是EleutherAI发布的一个英文的预训练语料。涵盖22个不同的数据来源,包括作者新构建的ArXiv, GitHub等,还包括已有的Books3,English Wikipedia等数据集。
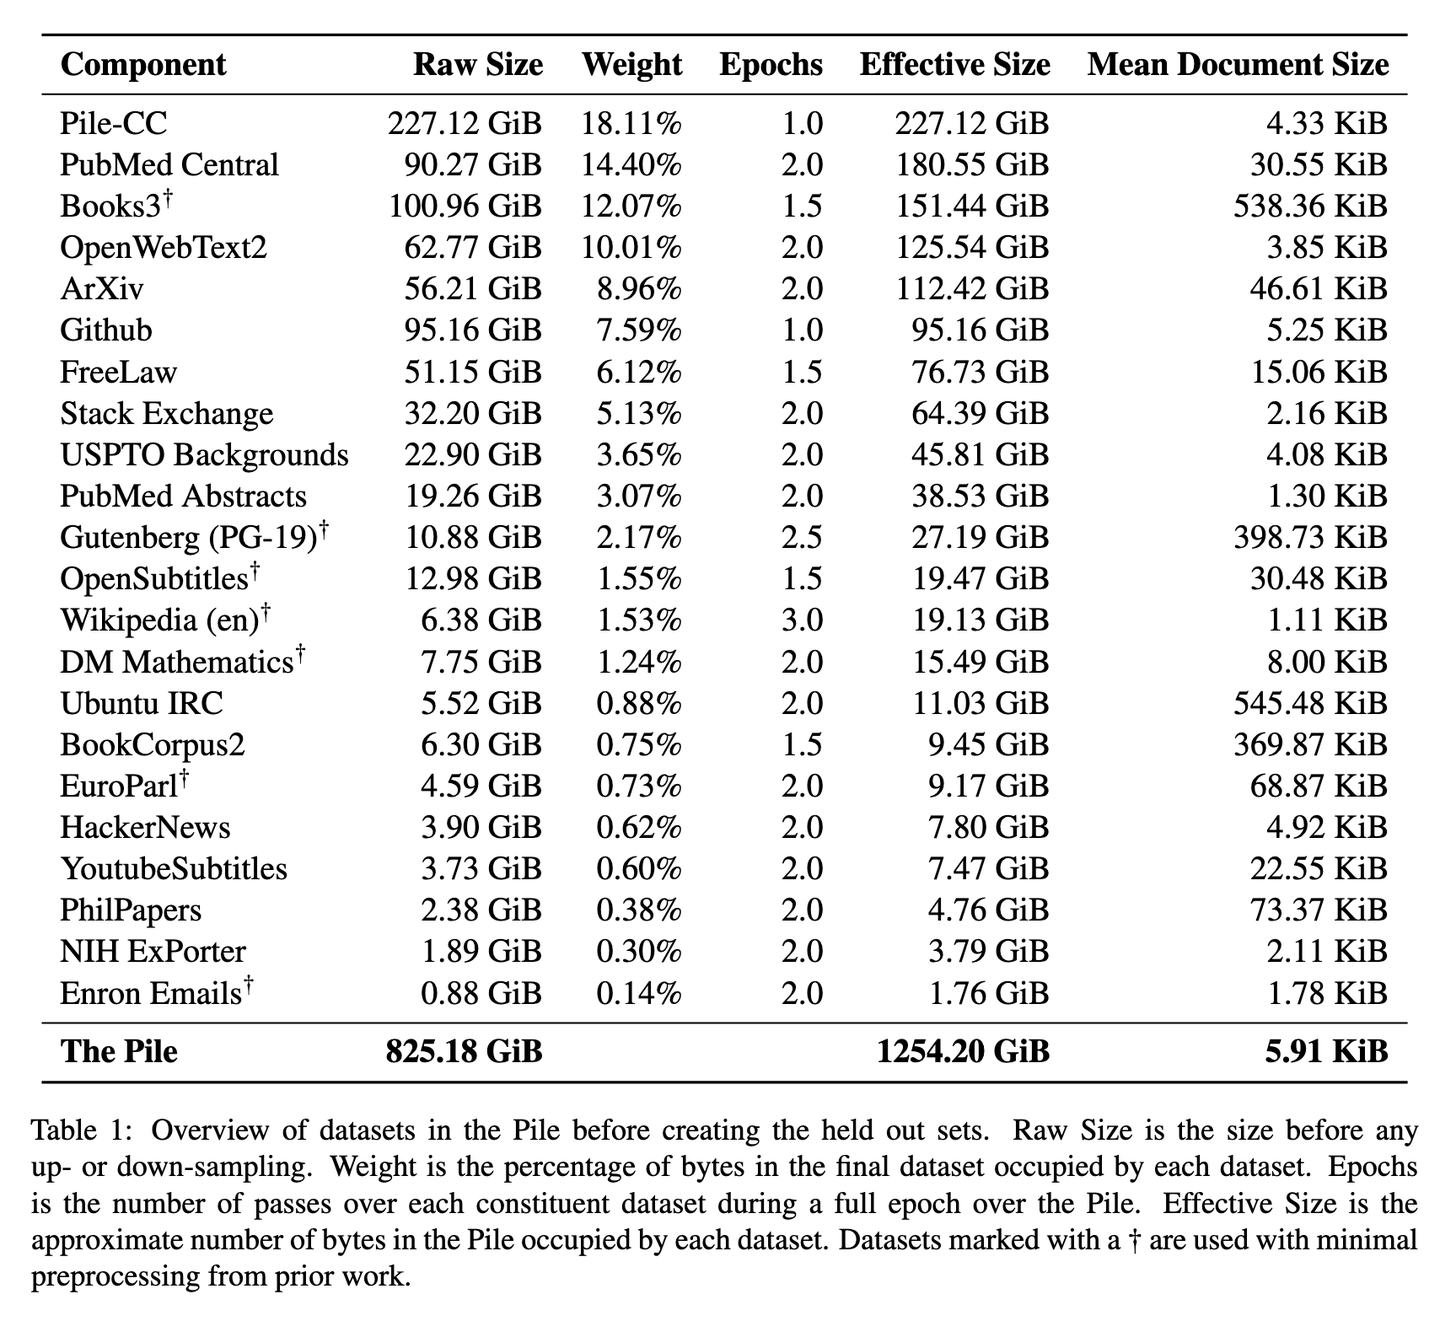 实验表明:
RefinedWeb是Falcon发布的一个英文的预训练语料,仅包含 网络数据,共5T,开源了其中的600B数据。
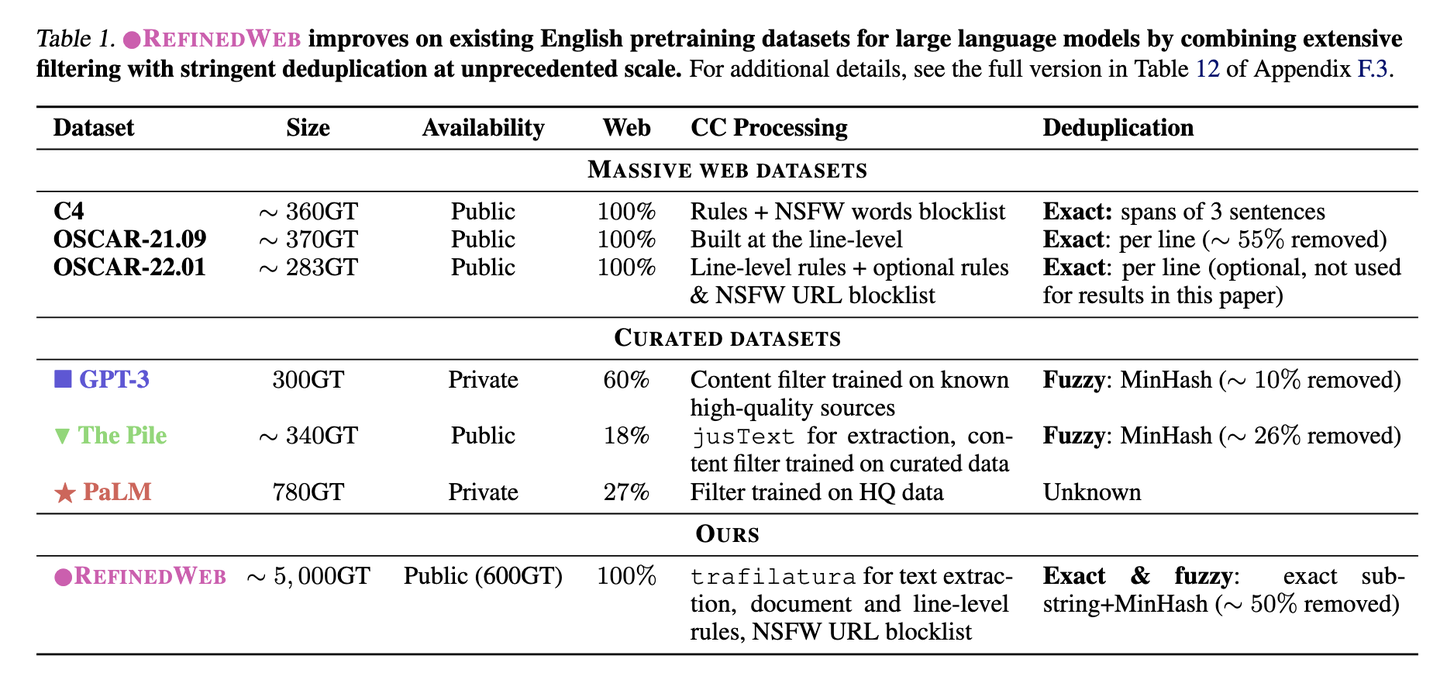 作者核心观点是:不需要精心手工构造数据源(例如百科,书籍等),直接采用大规模高质量的网络数据即可 。实验表明,仅通过高质量的网络数据训练出的模型能比手工调配出的数据集效果更好。
Pile之所以能比纯网络数据C4效果好,不是网络数据的问题,而是C4的数据规模太小,清洗规则有偏。同样的网络数据RefinedWeb就比Pile更好。
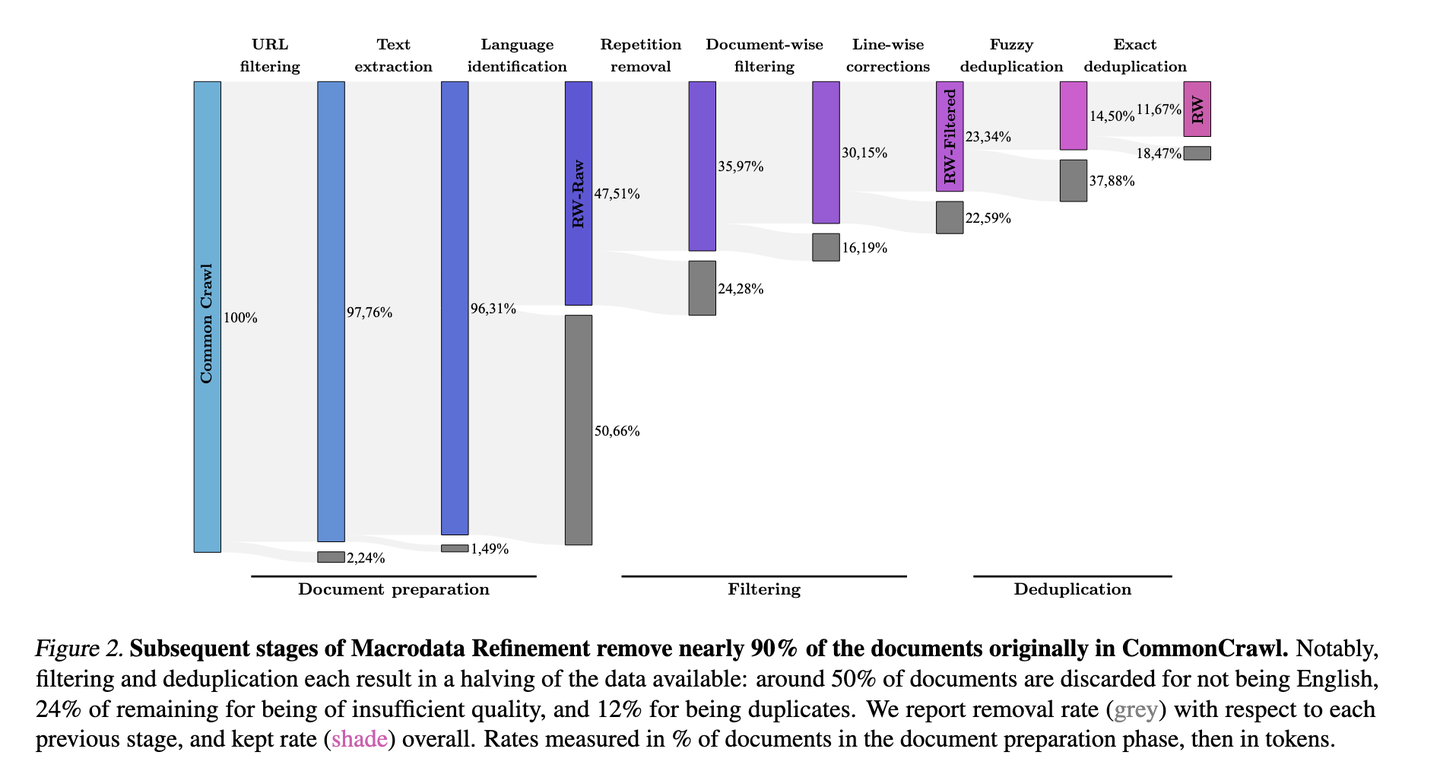 这个工作的核心如何对网络数据进行清洗,进而无偏 地提取出高质量的网络数据。作者提出了一个pipeline包括:
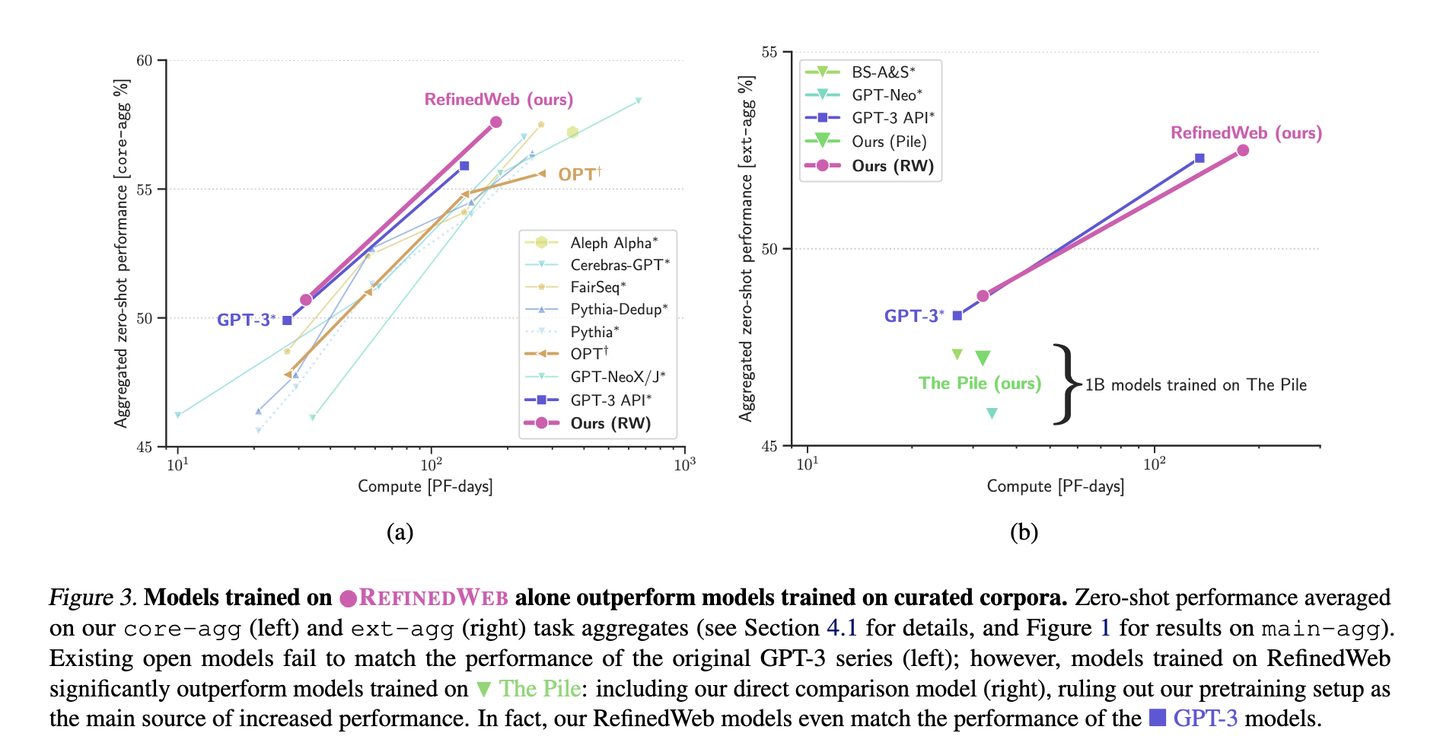 结果显示,仅使用web数据,并且排除了高质量的传统数据源(百科,code等),效果依然比手工精心构建的不同数据源的训练数据要好。
ChineseWebText是按照RefinedWeb的思路做的中文版本,由中科院自动化所发布,仅包含 网络数据,共1.42TB,并且每条数据都有一个打分,其中分数较高的高质量数据有600GB。
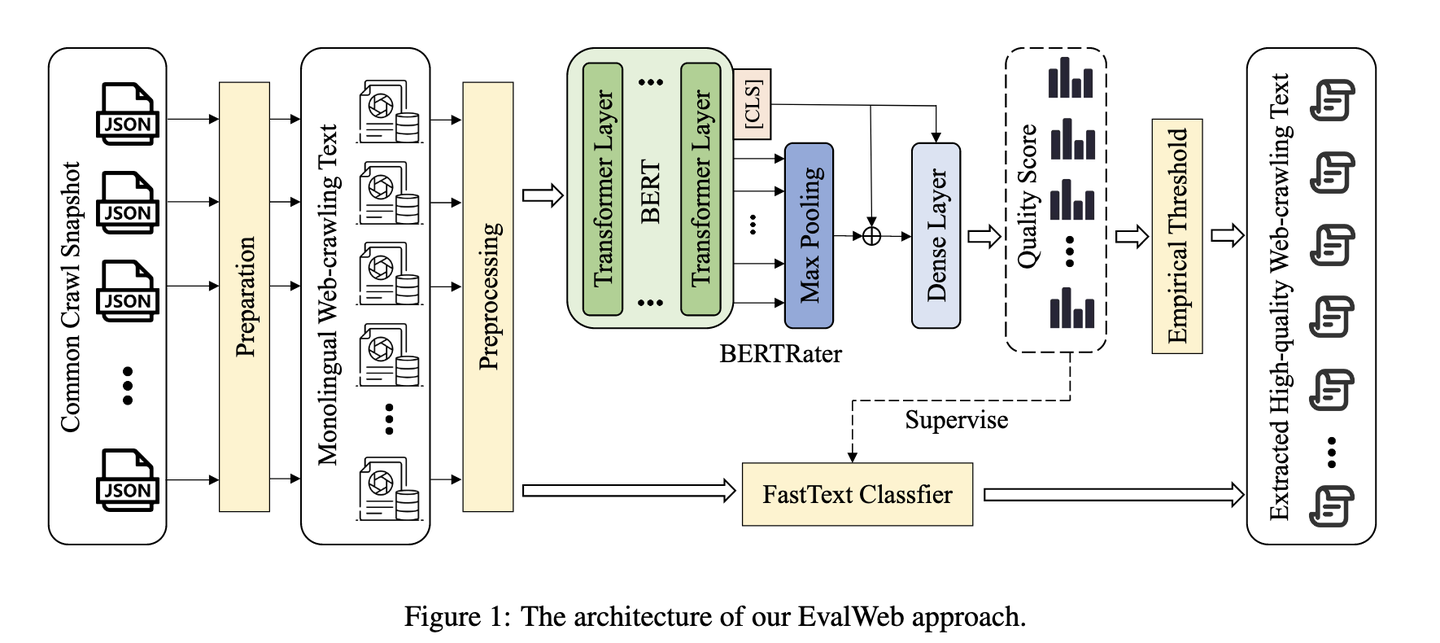 作者提出了一个新的数据处理pipeline,EvalWeb,包括下面几个步骤:
对每个文本都基于BERT进行打分,卡阈值为0.4过滤出高质量文本600GB。基于这个阈值过滤的文本,人工评估显示90%均为高质量文本。 不过相比RefinedWeb,本文没有给出训练出的模型的对比,所以基于该数据集训练的模型实际效果还有待验证。
编辑于 2023-11-21 09:21・北京
大模型
预训练
语料
赞同 39添加评论131 10
分享
申请转载
 未登录用户
还没有评论,发表第一个评论吧
关于作者
nghuyong
略懂些NLP|非典型程序员
回答 68 文章 31 关注者 11,469
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 中文预训练语言模型--ZEN sergio
 一大批中文(BERT等)预训练模型等你认领! Paper...发表于Paper... # 语法分析器bison 懒人在思考?WAF研究中... bison和flex配合使用,可以将用户提供的语法规则转化为一个语法分析器。 bison的作用:通过产生式多次构造,最终得到一个动作表,然后利用这个动作表去解析句子。… ailx10
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码