 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
语义分割之U-net
首发于图像语义分割
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
语义分割之U-net
首发于图像语义分割
切换模式
 stone
收藏之前点个赞呗
收录于 · 图像语义分割
28 人赞同了该文章
论文地址:U-Net: Convolutional Networks for Biomedical Image Segmentation 发表时间:18 May 2015
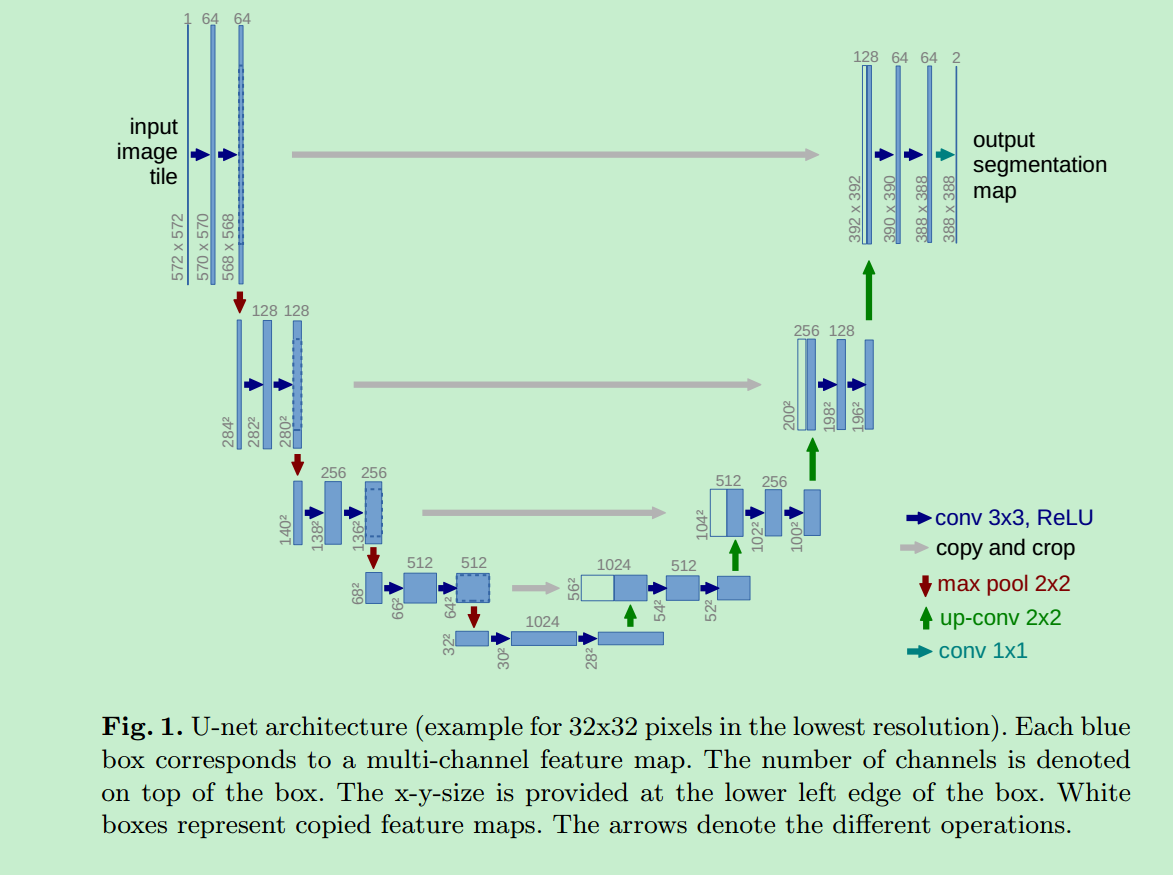
深度网络通常需要大量的数据进行训练,当样本量较少的情况下,深度网络可能表现没那么好。对于这个问题,本文提出了新的网络架构和图像增强策略。网络架构包括encoder和decoder(论文中称为浓缩路径(contracting path)和扩展路径(expanding path),实际上就是encoder和decoder),encoder可以有效地捕捉上下文信息,而decoder可以较好地预测位置信息。
U-net是基于FCN网络的思想设计的,整个网络只有卷积层,而没有全连接层。
在FCN中:网络的浓缩路径,图像分辨率逐渐降低,上下文信息会逐渐增强。在扩展路径中,通过上采样的方式,让特征图的分辨率逐渐增大。同时,为了结合低层feature map的强位置信息,将浓缩路径中的相应部分结合到扩展路径中。这种架构可以较好地进行位置定位。
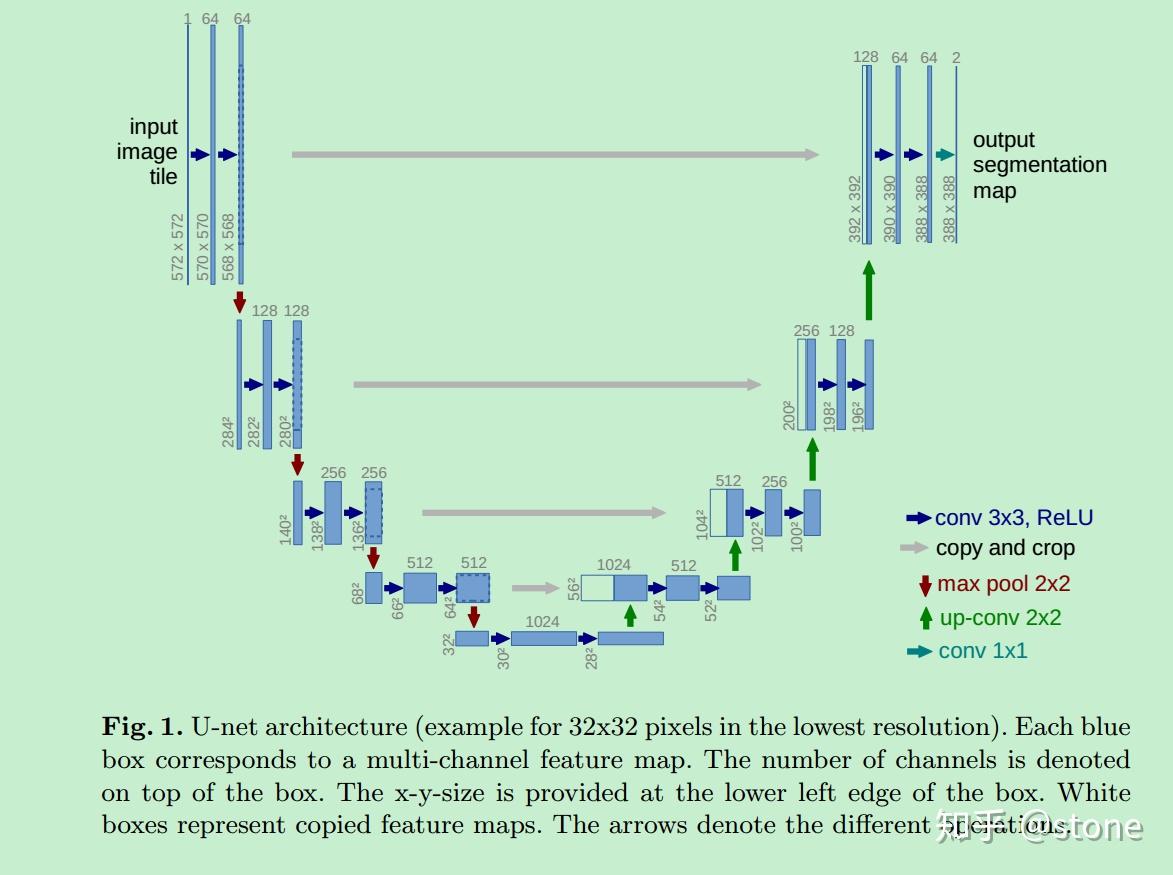 U-net做的修改有:
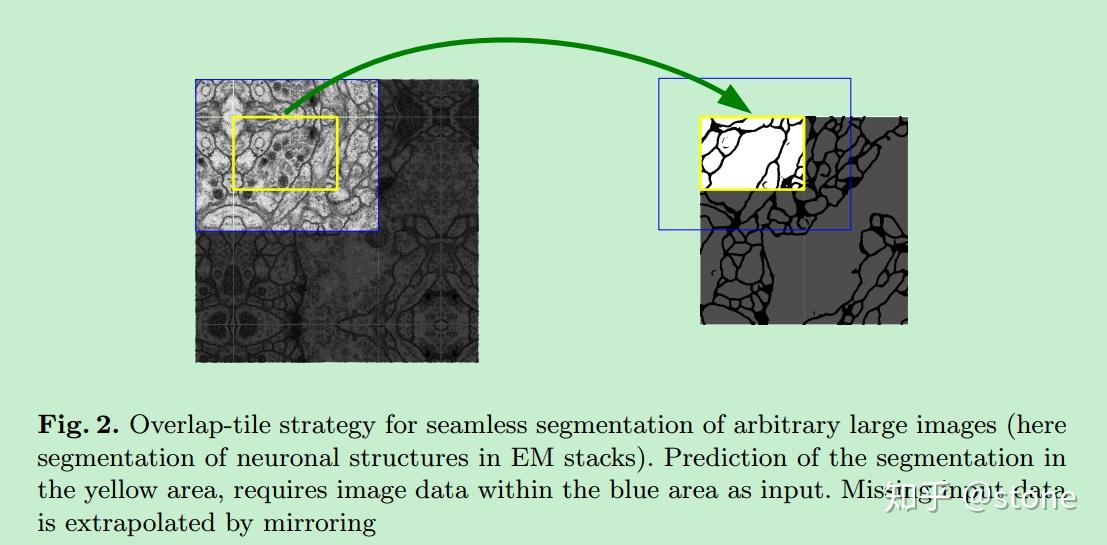
网络结构包括浓缩路径和扩展路径。 浓缩路径:
扩展路径:
网络输出的是pixel-wise的softmax。表达式如下:
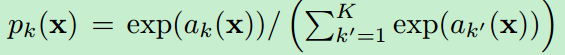 其中, x 为二维平面 Ω 上的像素位置, a_k(x) 表示网络最后输出层中pixel x 对应的第 k 个通道的值, K 是类别总数。 p_k(x) 表示像素 x 属于 k 类的概率。
损失函数使用negative cross entropy。cross entropy的数学表达式如下:
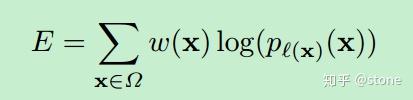 其中 p_l(x) 表示 x 在真实label所在通道上的输出概率。需要特别注意的是cross entropy中还添加一个权重项 w(x) 。这是因为考虑到物体间的边界需要更多的关注,所对应的损失权重需要更大。
在损失函数计算中我们讲到对于边界像素我们给的损失权重要更大,但怎么获取这个权重?我们得到一张图片的ground truth是一个二值的mask,本文首先采用形态学方法去计算出物体的边界。然后通过以下的表达式去计算权重图。
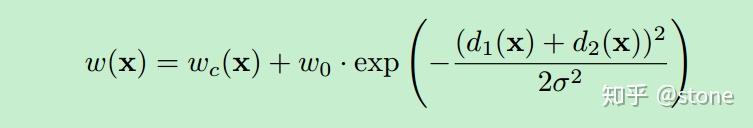 其中 w_c(x) 是类别权重,需要根据训练数据集中的各类别出现的频率来进行统计,类别出现的频率越高,应该给的权重越低,频率越低则给的权重越高(文章没有详细说是怎么计算的)。 d_1(x) 表示物体像素到最近cell的边界的距离, d_2(x) 表示物体像素到第二近的cell的边界的距离。在本文中,设置 w_0=10,\sigma=5 。
用到了很多图像增强方法。其中,作者特别强调,在训练数据很少的情况下,任意的弹性形变对网络训练有非常好的帮助。
编辑于 2018-06-21 13:33
计算机视觉
机器学习
深度学习(Deep Learning)
赞同 285 条评论65 5
分享
申请转载
 未登录用户
5 条评论
默认
最新
 空都
感谢分享,您知道在训练中2. 像素损失权重计算,这一节有没有复现代码,我在对d1(x)、d2(x)进行计算的时候遇到了困难,我一开始的想法是:先计算距离距离最近的细胞即d1(x),然后将归属于距离最近细胞的像素全设为背景像素;最后再计算距离最近的细胞壁(即第二近细胞壁),但是算法的复杂度太高,自己又没相当别的好的计算方式。
2023-07-27
回复喜欢
 BINGO Hong
做overlaptile一方面是为了减少大分辨率图像的尺寸,另一方面是减少图像边缘分割时,图像边缘分割模糊。
2018-06-24
回复喜欢
 KOD C
您好,您的文章写得很棒。有一个问题想请教您。
就是overlap-tile操作,论文中说的是对任意大的图像进行无缝分割。我的理解这个操作是在训练之前,对输入图片镜像操作来推断边缘区域的信息(388镜像操作后变成572),所以U-Net网络最后输出的是388图片,是跟原图一样大小的,这样实现了像素级别的分类。
但是overlap-tile操作又对镜像操作后的图像中的每个小块(Fig2中左图蓝框),在对这些小框做了一些弹性形变、双线性插值的数据增强,放入网络中去训练。
感觉有些乱,大佬能稍微解释一下么? 感谢~
2018-06-21
回复喜欢
 stone
作者
这里我也有点疑惑,我的理解是fig2中的蓝色框应该就是输入网络的图像,而不是你说的小块。因为原图可能分辨率非常大。
2018-06-21
回复喜欢
展开其他 1 条回复
关于作者
stone
收藏之前点个赞呗
回答 30 文章 15 关注者 10,013
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 语义分割网络U-Net详解 初识CV发表于初识CV # 汇总|实时性语义分割算法(全) 作者:明泽Danny Date:2020-10-27 来源:公众号【3D视觉工坊】 欢迎加入国内最大的3D视觉交流社区,1700+的领域从业者正在共同进步~ 注1:文末附有【计算机视觉】交流群加入方式哦~ 注2:… 第一具身范...发表于计算机视觉... # 【资源】常用的语义分割架构结构综述以及代码复现 作者:guanfuchen 项目:guanfuchen/semseg 原文链接:常用的语义分割架构结构综述以及代码复现 欢迎加小助手微信(cv-mart) 备注:研究方向-姓名-学校/公司-城市(如:目标检测-小极-北大-… 极市平台发表于极市平台 # 多篇开源CVPR 2020 语义分割论文 多篇开源CVPR 2020 语义分割论文 前言 1. DynamicRouting:针对语义分割的动态路径选择网络 Learning Dynamic Routing for Semantic Segmentation作者团队:中科院&国科大&西安交大… 吴建明wujianming
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码