 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
万字长文解读大语言模型指令调优最新综述
首发于总结&综述
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
万字长文解读大语言模型指令调优最新综述
首发于总结&综述
切换模式
 龟壳
 华中科技大学 工学硕士
收录于 · 总结&综述
122 人赞同了该文章
目录
文章名称:Instruction Tuning for Large Language Models: A Survey
文章地址:https://arxiv.org/abs/2308.10792 本文全面调研了近年来快速发展的指令调优(instrunction tuning, IT)领域的研究工作,它是提高大型语言模型能力和可控性的关键技术。指令调优是指在一个由(Instruction, output)对组成的数据集上,以有监督的方式对 LLM进一步训练的过程,它弥补了LLM的下一个单词预测目标与用户让LLM遵循人类指令的目标之间的差距。本文对文献进行了系统回顾,包括 IT的一般方法论、IT数据集的构建、IT 模型的训练、不同模式、领域和应用的应用,以及对影响 IT 结果的方面的分析(例如,生成指令输出、指令集的大小,等等),还回顾了 IT的潜在缺陷以及对它的批评,指出了现有策略的不足,并提出了一些有成果的研究途径。
近年来,大型语言模型(LLMs)研究取得了显著进展,LLMs的一个主要问题是训练目标和用户目标之间的不匹配:LLMs通常是在大型语料库上进行语境词预测使得误差最小化的训练,而用户则希望模型“有用且安全地”遵循他们的指示。为了解决这一问题,提出了指令调优技术,这是一种提高大型语言模型的能力和可控性的有效技术。它 涉 及 到 使 用(Instruction, output)对LLMs进行进一步的训练,其中Instruction表示针对模型的人工指令,而output 表示指令对应的期望输出。IT的好处有三方面:(1)在指令数据集上对LLMs进行微调,弥补了LLMs预测下一个单词目标与用户遵循指令目标之间的差距;(2)与标准 LLMs相比,IT 允许更可控和可预测的模型行为。指令的作用是约束模型输出,使其响应特征或领域知识符合预期,为人类干预模型提供一个通道;(3) IT 具有计算效率,可以帮助 LLMs快速适应特定领域,而无需大量的再训练或架构更改。 尽管IT非常有效性,但也带来很多挑战:(1)制作高质量的指令,适当地覆盖预期的目标行为是不简单的:现有的指令数据集通常在数量、多样性和创造性上有限;(2)越来越多的人担心,IT只会在 IT 训练数据集大量支持的任务上得到改善;(3) IT 只能捕捉表面的模式和风格而不是理解和学习任务,这一直是一个强烈的批评。提高指令依从性和处理意料之外的模型响应仍然是开放性的研究问题。这些挑战突出了在这一领域进一步调查、分析和总结的重要性,以优化微调过程,更好地理解指令微调LLMs的行为。 本文主要包括以下几个部分:
指令数据集中的每个实例由三个元素组成:一条指令 ,它是一个指定任务的自然语言文本序列(例如,为XX写一封感谢信给 XX,写一篇关于 XX主题的博客,等等);一个为上下文提供补充信息的可选输入 ,以及基于指令和输入的预期输出 。 通常有两种构造指令数据集的方法:
基于收集到的 IT 数据集,一个预先训练的模型可以直接以全监督的方式进行 微调(fine-tuned),在给定指令和输入的情况下,通过预测输出中的每个token来训练模型。
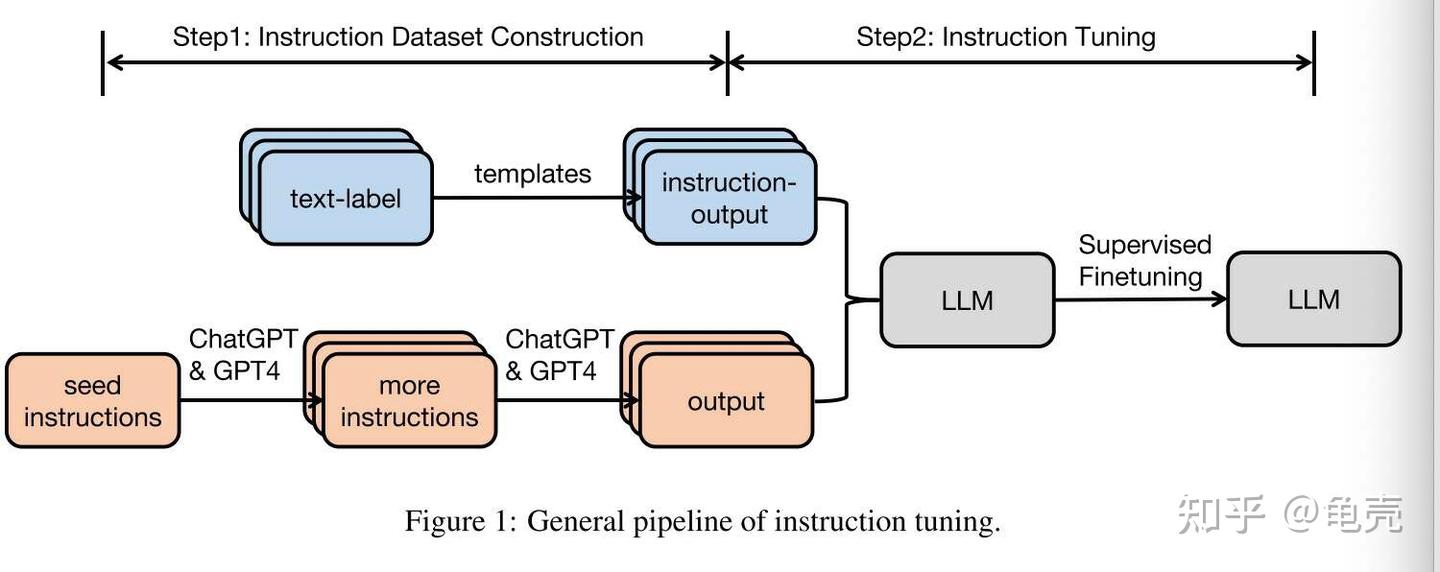
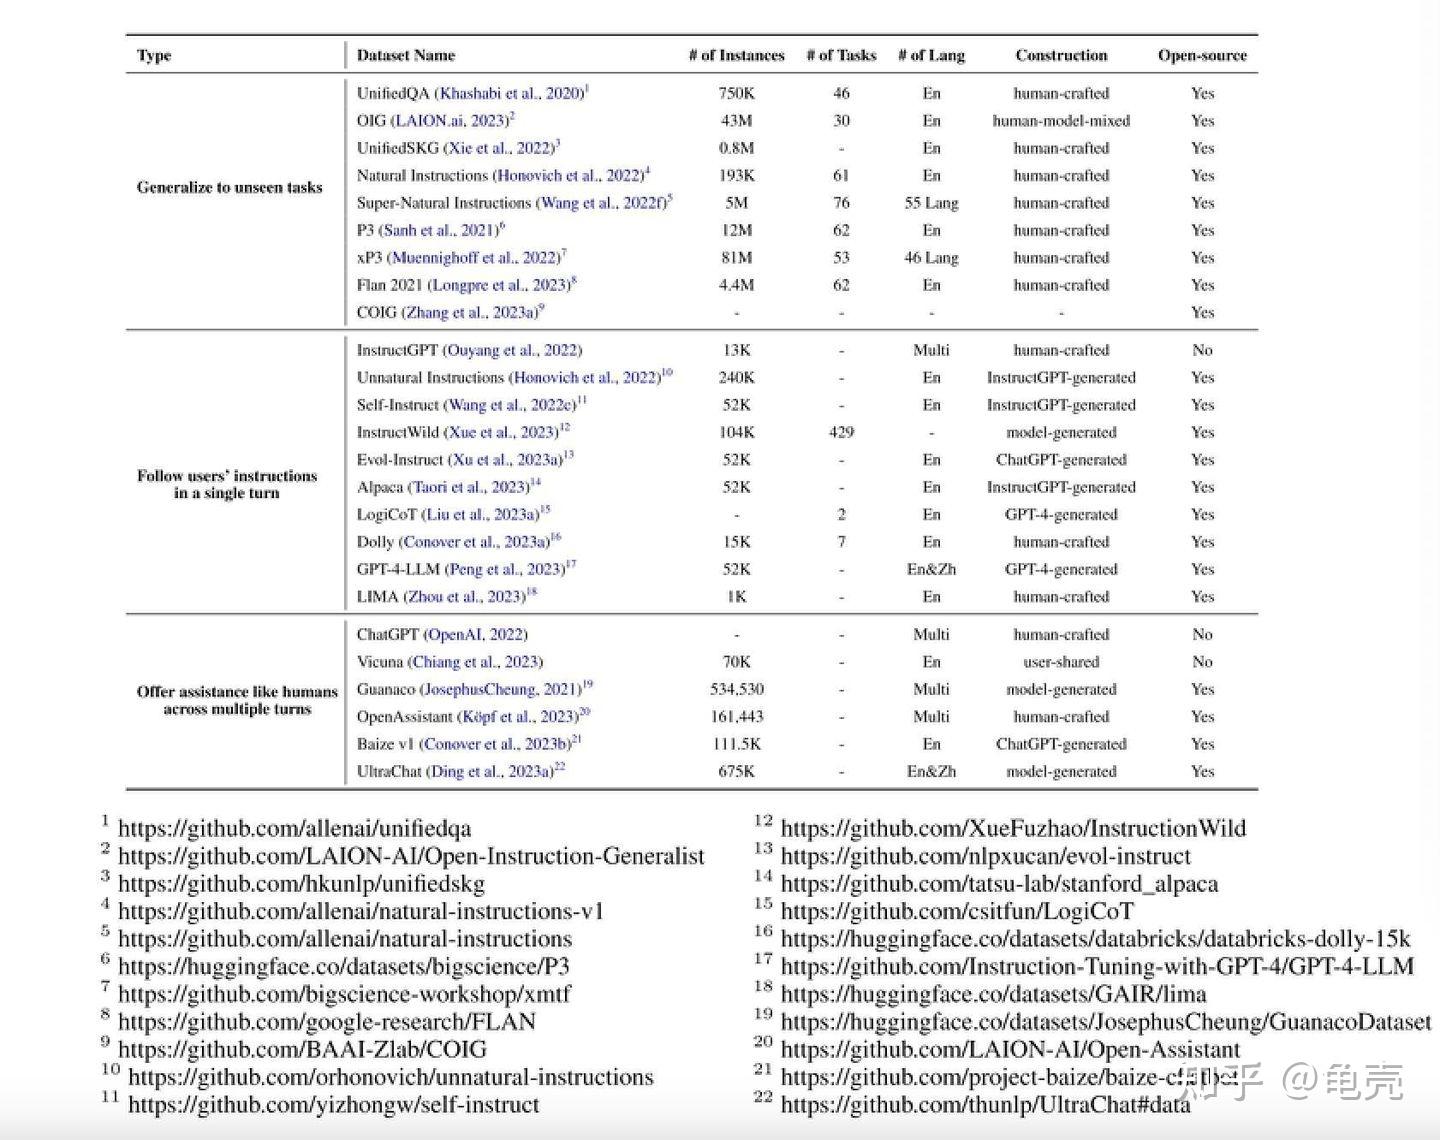 Table 1: An overview of instruction tuning datasets
自然指令是一个人工制作的英语指令数据集,包含了来自 61 个不同的NLP 任务的193K个实例。数据集由“指令”和“实例”组成。“指令”中的每个实例都是一个任务描述,由 7个部分组成:标题、定义、要避免的事情、强调/警告、提示、正面例子和负面例子。图2中的子图(a)给出了一个“指令”的例子。“实例”由(“输入”、“输出”)对组成,它们是正确地遵循给定指令的输入数据和文本结果。图2中的子图(b)给出了实例的一个例子。
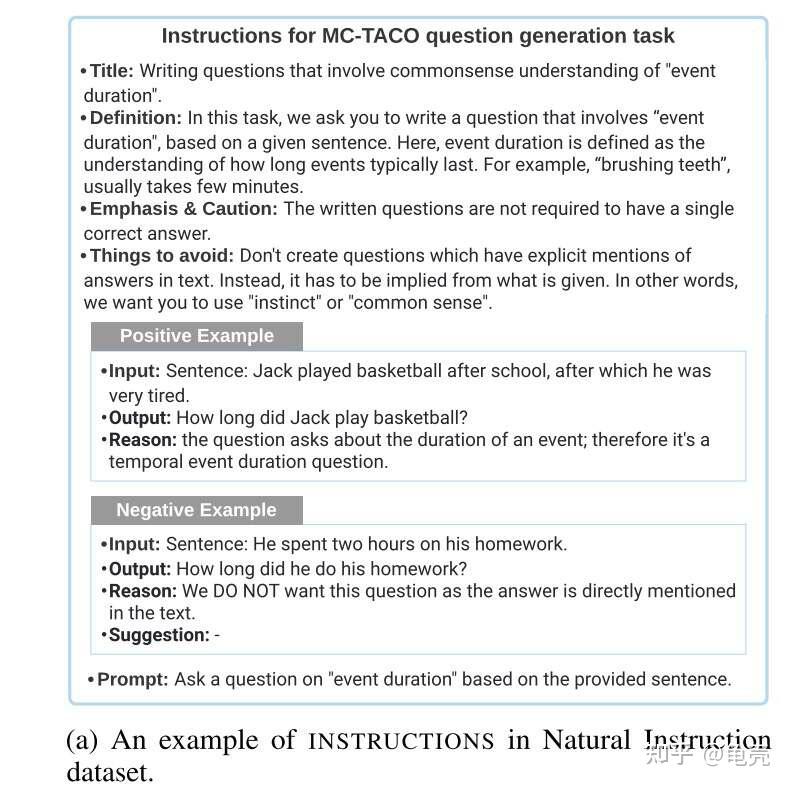
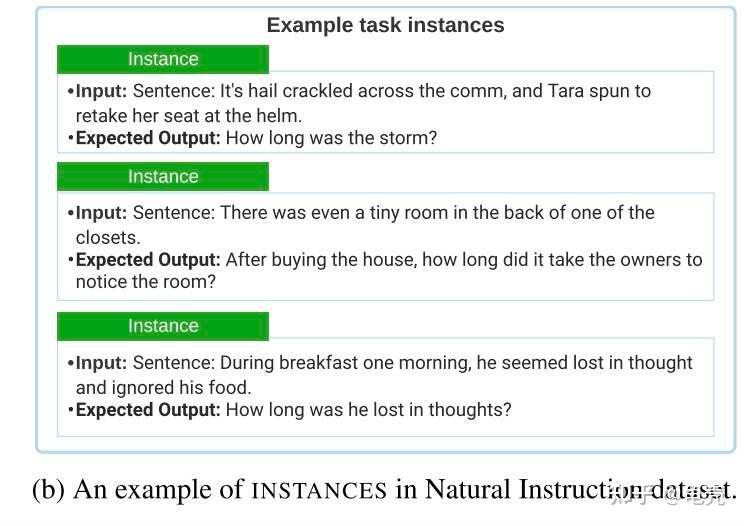 图2
P3 (Public Pool of Prompts)是一个由170 个英语NLP 数据集和 2052 个英语提示构建的指令微调数据集。提示符有时被称为任务模板,是将传统NLP任务(例如,问题回答、文本分类)中的数据实例映射到自然语言输入-输出对的函数。 P3 中 的 每 个 实 例 都 有 三 个 组件:“inputs”、“answer_choices”和“targets”。“输入”是一个用自然语言描述任务的文本序列(例如,“如果他喜欢玛丽是真的,那么他喜欢玛丽的猫也是真的吗?”)。“答案选择”是一个文本字符串列表,对给定的任务(例如,["yes", "no", "undetermined"])适用的响应。“Targets”是一个文本字符串,它是对给定“输入”(例如“yes”)的正确响应。作者构建了 PromptSource,这是一个用于协作创建高质量提示词的工具,也是一个用于开源高质量提示的存档。P3 数据集是通过从 PromptSource 中的多个提示符中随机抽样一个提示符来构建的,并将每个实例映射为(“输入”、“答案选择”、“目标”)三元组。
xP3(跨语言公共提示池)是一个多语言指令数据集,由 46 种语言的 16 种不同的自然语言任务组成。数据集中的每个实例都有两个组件:“输入”和“目标”。“输入”是一种自然语言的任务描述。“Targets”是正确地遵循“inputs”指令的文本结果。 xP3 中的原始数据有三个来源:英语指令数据集P3、P3 中的4个英语隐性任务(如翻译、程序合成 ) 和30个多语言 NLP 数据集。作者通过从PromptSource 抽取人工编写的任务模板,然后填充模板来将不同的NLP任务转换成统一的形式,从而构建了 xP3 数据集。例如,自然语言推理任务的任务模板如下:“如果前提为真,那么假设也为真吗?”;“是”、“可能”、“否”相对于原来的任务标签“包含(0)”、“中立(1)”和“矛盾(2)”。
Flan 2021是一个由 62 个广泛使用的NLP基准(如 SST-2、SNLI、AG News、MultiRC)转换成语言输入-输出对而构建的英语指令数据集。Flan 2021 中的每个实例都有“输入”和“目标”组件。“输入”是一个文本序列,通过自然语言指令来描述一个任务(例如,“确定句子‘他喜欢猫’的情感。积极还是消极?”)。“目标”是正确执行“输入”指令的文本结果(例如,“积极”)。将传统的自然语言处理数据集转换为输入-目标对:步骤 1:人工编写指令和目标模板;步骤 2:用数据集中的数据实例填充模板。
非自然指令是一个有大约 24 万个实例的指令集,使用 InstructGPT (text- davinci-002)构建。数据集中的每个实例有四个组件:指令、输入、约束和输出。“指令”是用自然语言对教学任务的描述。输入在自然语言中是一个参数,用于实例化指令任务。约束是对任务输出空间的限制。输出是一个文本序列,它在给定输入参数和约束条件的情况下正确地执行指令。作者首先从人工构建的超自然指令数据集中采样种子指令。然后,他们提InstructGPT引出一个新的(指令、输入、约束)对,其中包含三个种子指令作为示范。接下来,作者通过随机改写指令或输入来扩展数据集。指令、输入和约束的连接被送入 InstructGPT以获得输出。
Self-Instruct (Wang et al. , 2022c) 是使用InstructGPT构建的英语教学数据集,包含52K个训练指示和252个评价指示。每个数据实例由“指令”、“输入”和“输出”组成。“指令”是自然语言中的任务定义(例如,“请回答以下问题”)。“Input”是可选的,用作说明的补充内容(例如,“哪个国家的首都是北京?”),“output”是符合说明的文本结果(例如,“北京”)。根据以下步骤生成完整数据集:
Evol-Instruct是由 52K 指令的训练集和218条指令的评价集组成的英语指令数据集。作者促使ChatGPT (OpenAI, 2022)使用深度和吸气式进化策略重写指令。深度演化策略包含了增加约束、增加推理步骤、增加输入复杂度等五种操作类型。吸气进化策略将简单指令升级或直接升级为复杂指令生成一个新的指令来增加多样性。作者首先使用 52K(指令、响应)对作为初始集合。然后,他们随机抽取一种进化策略,并要求ChatGPT根据选择的进化策略重写最初的指令。利用 ChatGPT和规则过滤掉非进化指令对,用新生成的进化指令对更新数据集。重复上述过程 4 次后,作者收集了250K条指令对。除了训练集,作者还从真实的场景(例如,开源项目、平台和论坛)中收集了 218 条人类生成的指令,称为Evol-Instruct测试集。
LIMA 是一个英语指令数据集,由一个拥有1K实例的训练集和300 个实例的测试集组成。训练集包含 1K 对(“指令”、“响应”)。对于训练数据,75%的样本来自三个社区问答网站(即Stack Exchange、wikiHow和PushshiftReddit 数据集(Baumgartner et al., 2020),20%是由一组作者在他们的兴趣启发下手工编写的,5%的样本来自超自然指令数据集(Wang 等人,2022d)。对于验证集,作者从A组作者编写的集合中抽样 50个实例。测试集包含 300 个示例,其中 76.7%由另一组(B 组)作者编写, 23.3% 的样本来自 Pushshift Reddit 数据集,这是Reddit社区内的问题和答案的集合。
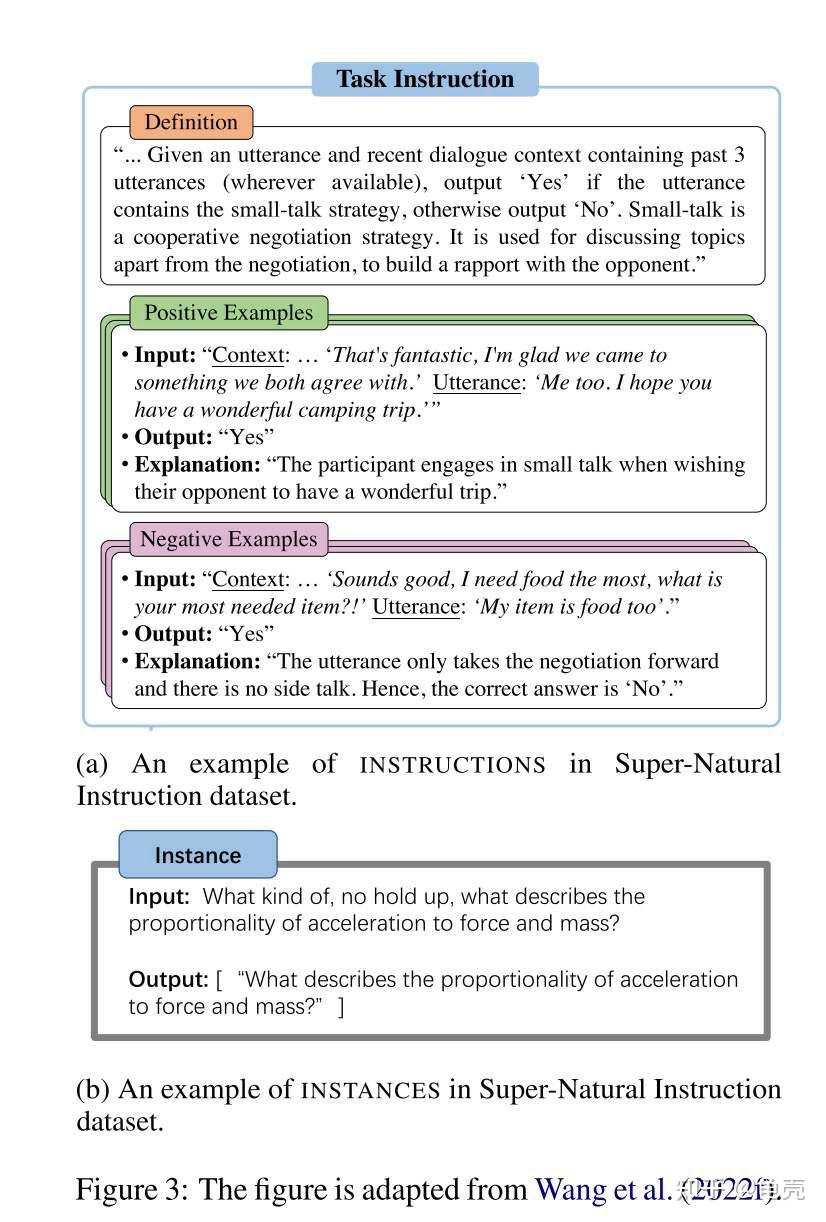
超自然指令(Wang et al., 2022f)是一个多语言指令集合,由 1,616 个NLP 任务和 5M任务实例组成,涵盖76种不同的任务类型(例如,文本分类、信息提取、文本重写、文本创作等)和55种语言。数据集中的每个任务都由一个“指令”和“任务实例”组成,具体来说,“指令”有3部分组成:用自然语言描述任务的“定义”;正面例子,即正确输出的样本,并对每个样本进行简短的解释;以及“负例子”,即输入和不期望输出的样本,以及对每个样本的简短解释,如图 3 (a)所示。“任务实例”是由文本输入和可接受文本输出列表组成的数据实例,如图 3 (b)所示。《超自然指令》中的原始数据来自三个来源:(1)现有的公共NLP数据集(如CommonsenseQA);(2)通过众包过程生成的适用中间标注(例如,在众包QA数据集中对给定问题进行释义);(3)合成任务,由符号任务转化而来,用几句话来表达(如数字比较等代数运算)。
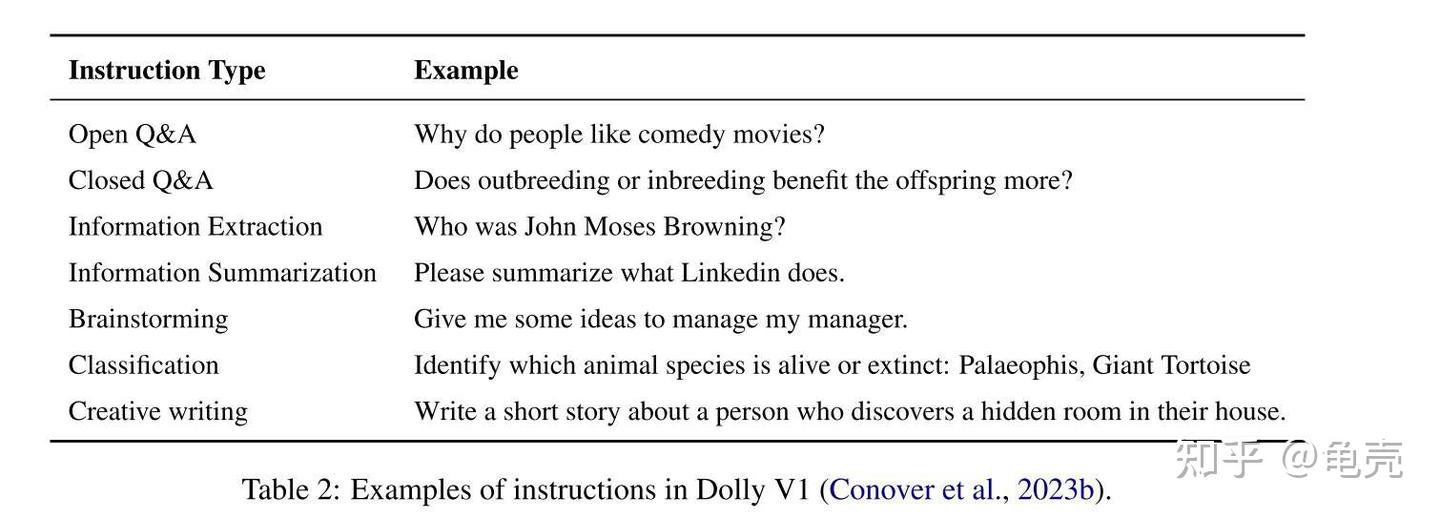
Dolly是一个英语指令数据集,包含 15000个人类生成的数据例,旨在使 LLMs能够与用户进行类似ChatGPT 的交互。该数据集旨在模拟广泛的人类行为,包括 7 种特定类型:开放问答、封闭问答、从维基百科中提取信息、从维基百科中总结信息、头脑风暴、分类和创造性写作。数据集中每种任务类型的示例如表2所示。
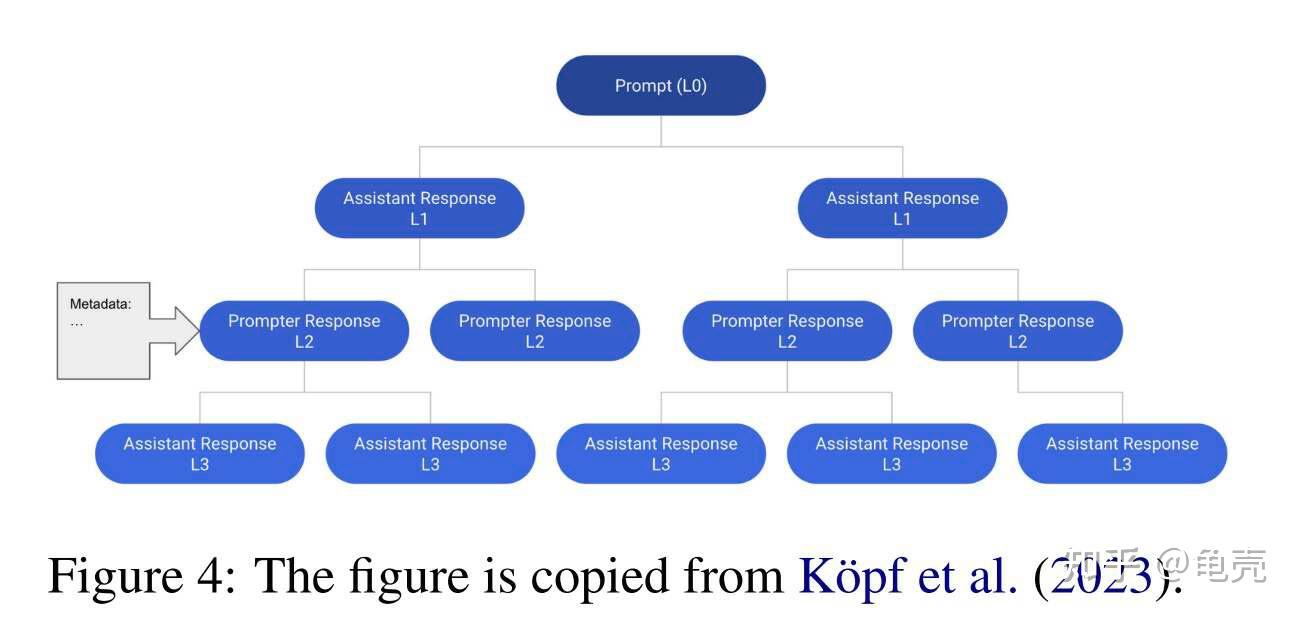
OpenAssistant Conversations是一个人工构建的多语言助理风格的会话语料库,由来自35种语言的66497 个会话树的161,443 条消息(即 91,829个用户提示,69,614个助理回复)组成,以及461292 个人工标注的质量评级。数据集中的每个实例都是一个会话树(conversation tree,CT)。具体来说,会话树中的每个节点表示会话中角色(即提示符、助手)生成的消息。CT 的根节点表示来自提示器的初始提示,而其他节点表示来自提示器或助手的回复。从根到CT中任何节点的路径表示提示符和助手之间依次进行的有效对话,称为线程。图 4 显示了会话树的示例,其中包含6个线程中的12条消息。作者首先收集了基于五步流程的对话树:
树状态机在整个会话构造过程中管理和跟踪状态(例如,初始状态、增长状态、结束状态)。随后,通过过滤掉冒犯性和不恰当的会话树来构建 OpenAssistantConversations数据集。
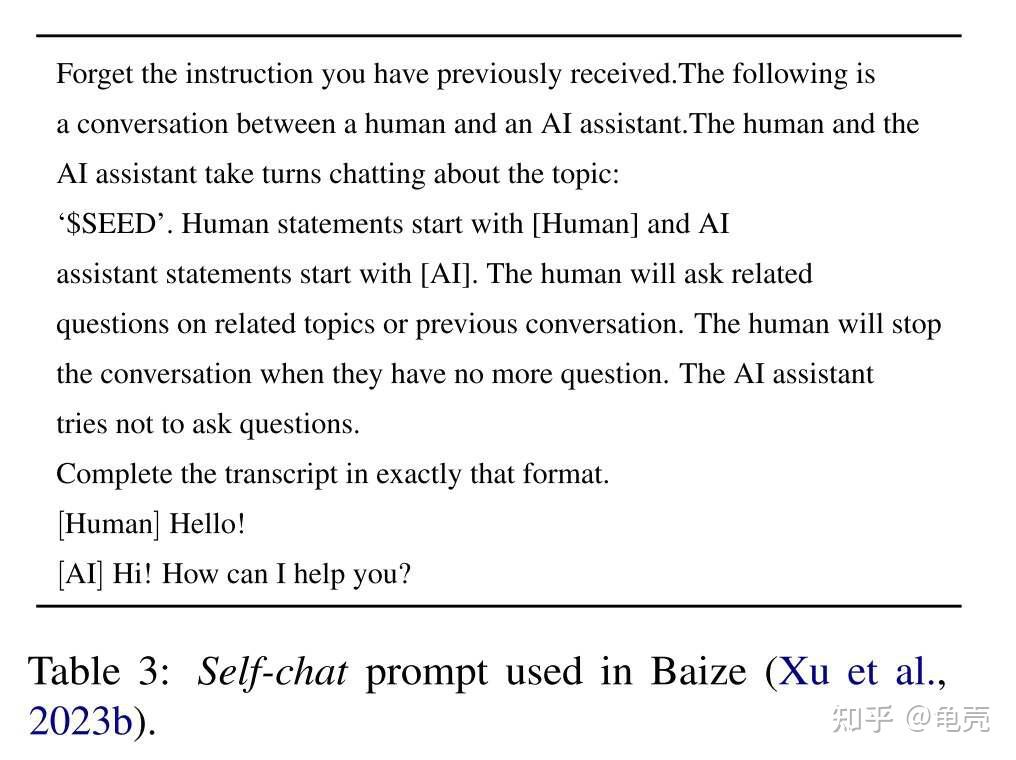
Baize (Conover et al., 2023b)是一个英语多回合聊天语料库,使用 ChatGPT 构建 111.5K 实例。每一轮都由用户的提示和助手的回答组成。Baize v1中的每个实例包含3.4轮会话。为了创建Baize 数据集,作者提出了自我聊天的建议,ChatGPT轮流扮演用户和人工智能助手的角色,并以会话的形式生成消息。具体来说,作者首先设计了一个任务模板,定义了ChatGPT的角色和任务(如表 3所示)。接下来,他们从Quora 和Stack Overflow数据集中取样问题(例如,“你如何修复一个不工作的谷歌 Play Store帐户?”)作为对话种子(例如,话题)。随后,他们用模板和取样的种子提示ChatGPT。ChatGPT不断地为双方生成消息,直到达到自然停止点。
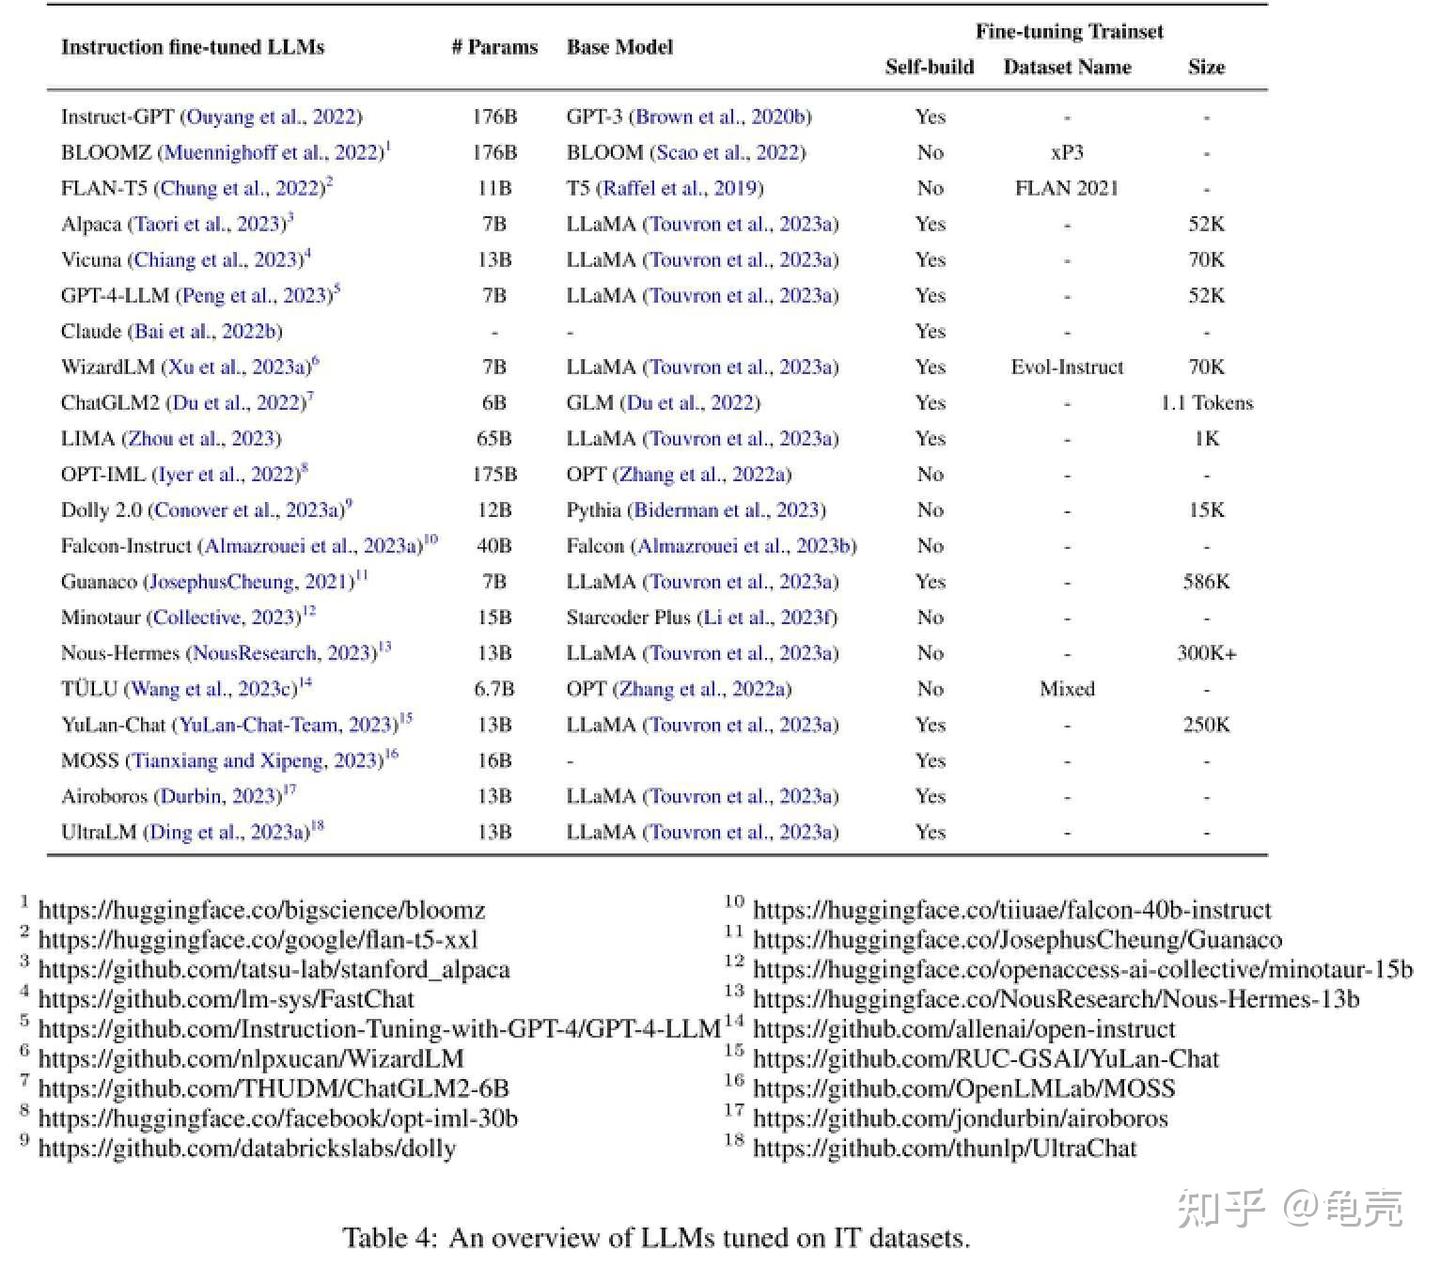
InstructGPT (176B) (Ouyang et al., 2022)使用GPT-3(176B) (Brown et al., 2020b)初始化,然后根据人类指令进行微调。该微调过程包括以下三个步骤:(1)基于 Playground API 历史记录的人工过滤指令数据集的监督微调(SFT);(2)通过人工对一个指令的多个反应进行采样,并对其进行排序,建立基于标注数据集的奖励模型来预测人类的偏好;(3)使用新的指令进一步优化第 1 步的模型和第 2 步的训练奖励模型。使用近端策略优化(PPO)(Schulman et al., 2017)方法更新参数,这是一种策略梯度强化学习方法。步骤(2)和步骤(3)交替多次直到模型性能没有显著改善。 总的来说,InstructGPT优于GPT-3。在自动评估方面,在TruthfulQA (Lin et al., 2021)数据集上,InstructGPT 的真实性比 GPT-3 高出 10% ,在RealToxicityPrompts (Gehman et al., 2020)数据集上,其毒性比GPT-3 高出7%。在NLP数据集(即WSC)上,InstructGPT实现了与GPT-3相当的性能。在人类评估中,在遵循正确指示、遵循明确约束、减少幻觉、产生适当反应四个方面,InstructGPT分别优于GPT-3 +10%、+20%、-20%和+10%。
BLOOMZ (176B) (muenighoff等人,2022)用 BLOOM(176B) (Scao 等人,2022)初始化,然后在指令数据集xP3上进行微调(muenighoff等人,2022),这是一个46种语言的人类指令数据集集合,来自两个来源:(1)P3,它是(英语指令,英语响应)对的集合;(2)一个(英语指令,多语言响应)集,通过在任务模板中填充预定义的英语指令,从多语言NLP数据集(如中文基准)转换而来。在自动评价方面,在零样本设置下,BLOOMZ在共指消解、句子完成度和自然语言推理数据集上分别比 BLOOM 提高了10.4%、20.5%和 9.8%。在HumanEval 基准测试中(Chen 等人,2021 年),在Pass@100 指标方面,BLOOMZ 的表现比 BLOOM高出10%。对于生成任务,在 lm-evaluation-harness 基准测试中,与 BLOOM 相比,BLOOMZ 获得了+9%的BLEU改进。
FLAN -T5 (11B)是一个由T5 (11B)初始化的大型语言模型(Raffel et al., 2019),然后在FLAN数据集上进行微调(Longpre et al., 2023)。FLAN 数据集是由 12 个NLP任务(如自然语言推理、常识推理、释义生成等)的62 个数据集组成的(指令、对)对集合,通过在统一任务形式化下填充各种指令模板来构建。在微调过程中,FLAN-T5对基于JAX的T5X框架进行了调整,每隔 2k步,就会根据所评估的保留任务选取最优模型。与 T5 的训练前阶段相比,微调需要0.2%的计算资源(约128个TPU v4芯片37小时)。在评估方面,FLAN-T5 (11B)优于 T5 (11B),并在少样本设 置 下 取 得 了 与 包 括 PaLM (60B)(Chowdhery 等人,2022)在内的更大模型的可比结果。在MMLU (Hendrycks et al., 2020)、BBH (Suzgun etal., 2022)、TyDiQA (Clark et al., 2020)、MGSM(Shi et al., 2022)、开放式生成和RealToxicityPrompts (Gehman 等人,2020 年),FLAN- T5 比 T5表现+18.9%、+12.3%、+4.1%、+5.8%、+2.1%和+8%。在少数情况下,FLAN-T5在BBH和TyDiQA数据集上的表现优于PaLM +1.4%和+1.2%。
Alpaca (7B) (Taori 等人,2023)是在 InstructGPT (175B,text-davinci-003) (Ouyang 等人,2022)生成的构建指令数据集上通过微调LLaMA (7B) (Touvron 等人,2023a)训练的语言模型。在带有混合精度训练和完全共享数据并行的8卡80GB A100设备上,微调过程大约需要3个小时。在人类评价方面,Alpaca (7B)取得了与 InstructGPT相 当 的 性 能 。 具 体 来 说 ,Alpaca 在指令数据集 的表现优于InstructGPT,获得了90个胜利实例,而不是89个。
Vicuna (13B) (Chiang 等人,2023)是在 ChatGPT 生成的会话数据集上通过微调 LLaMA (13B) (Touvron 等人,2023a)训练出来的语言模型。作者从 http://ShareGPT.com 网站上收集了用户共享的ChatGPT会话,过滤掉低质量的样本后,得到了 70K会话记录。LLaMA (13B)在构建的会话数据集上使用一个为多回合会话量身定制的修正损失函数进行微调。为了更好地理解跨多回合对话的长上下文,作者将最大上下文长度从512 扩展到 2048。在训练方面,作者采用了梯度检查点(the gradient checkpointing)和flash attention (Dao et al., 2022)技术来降低微调过程中的 GPU 内存成本。在完全共享数据并行的 8×80GB A100设备上,微调过程需要24小时。作者们建立了一个专门用于测量聊天机器人性能的测试集。他们收集了一个由 8 个问题类别组成的测试集,如费米问题、角色扮演场景、编程/数学任务等,然后要求GP-4 (OpenAI, 2023)考虑帮助性、相关性、准确性和细节来评估模型的回答。在构建的测试集上,Vicuna (13B)优于Alpaca (13B) (Taori 等人,2023)并且LLaMA (13B)在 90%的测试问题中,与 ChatGPT在45%的问题中产生相同或更好的评分响应。
GPT-4-LLM(7B) (Peng et al., 2023)是在GPT-4 (OpenAI,2023) 生成的指令数据集上通过微调 LLaMA (7B)(Touvron et al., 2023a)来训练的语言模型。GPT-4-LLM用 LLaMA 初始化,然后通过以下两个步骤进行微调: (1)对构造的指令数据集进行监督微调。作者使用了Alpaca 的指令(Taori 等人,2023 年),然后使用 GPT-4收集反馈。LLaMA在GPT-4 生成的数据集上进行了微调。在具有混合精度和完全共享数据并行性的 8*80GBA100 机器上,微调过程大约需要 3 个小时。 (2)利用近端 策 略 优 化 (proximal policy optimization, PPO)(Schulman et al., 2017)方法优化 step-1模型,作者首先通过收集 GPT-4、InstructGPT (Ouyang et al., 2022)和OPT-IML (Iyer et al., 2022)的响应来建立一个比较数据集,然后让GPT-4 对每个响应从 1 到 10 进行评分。使用评级,基于 OPT 训练奖励模型 (Zhang et al. ,2022a)。利用奖励模型计算策略梯度对第 1步调整后的模型进行优化。 在评估方面,GPT-4-LLM (7B)不仅优于基准模型Alpaca (7B),而且优于更大的模型,包括 Alpaca (13B)和 LLAMA (13B)。在自动评估方面,GPT-4-LLM (7B)在User-Oriented-Instructions-252 (Wang et al., 2022c)、Vicuna-Instructions(Chiang et al., 2023)和Unnatural Instructions(Honovich et al.,2022)数据集上分别比Alpaca高出 0.2、0.5和 0.7倍。在人类评价方面,GPT-4-LLM在帮助性、真诚度、无害方面的表现分别比Alpaca高出11.7、20.9和 28.6。
Claude 是一种语言模型,通过在指令数据集上对预训练语言模型进行微调来训练语言模型,目的是生成有益和无害的反应。微调过程包括两个阶段:(1)对指令数据集进行监督微调。作者通过收集52K条不同的指令并与GPT-4生成的响应配对创建了一个指令数据集。在具有混合精度和完全共享数据并行性的8卡80GB A100 机器上,微调过程大约需要8 小时。(2)利用近端策略优化方法优化 step-1 模型。作者首先通过收集多个大型语言模型(如 GPT-3)对给定指令集合的响应来建立一个比较数据集,然后让 GPT-4对每个响应进行评分。使用评级,一个奖励模型被训练。然后,利用奖励模型和近端政策优化方法对第 1 步的微调模型进行优化。与主干模型相比,Claude 产生了更多有益和无害的反应。在自动评估方面,Claude 在RealToxicityPrompts上的毒性表现比 GPT-3 高出 7% 。对于人类评估,在四个不同方面,包括遵循正确的指示、遵循明确的约束、减少幻觉和产生适当的反应,Claude 的表现分别优于 GPT-3+10%、+20%、-20%、+10%。
WizardLM (7B) (Xu 等人,2023a)是一种通过 LLaMA(7B) 对 ChatGPT 生成的指令数据集Evol-Instruct进行微调来训练的语言模型。它在Evol-Instruct的一个子集(70K)上进行了微调,以便与 Vicuna 进行公平的比较。基于Deepspeed Zero-3 技术的8卡V100 GPU,微调3个epoch大约需要70小时。在推理过程中,最大的生成长度是2048。为了评估LLMs在复杂指令上的性能,作者从真实的场景(例如,开源项目、平台和论坛)收集了218条人类生成的指令,称为Evol-Instruct测试集。 在Evol-Instruct测试集和 Vicuna测试集上进行评估。在人类评价方面,WizardLM大大超过了Alpaca(7B) 和Vicuna(7B),相比于ChatGPT在67%的测试样例中产生了相同或更好的响应。自动评估是通过让GPT-4对LLMs的回答进行评级来实现的。具体说,与Alpaca相比,WizardLM 的性能分别提高了6.2%、5.3%在 Evol-Instruct测试集和Vicuna测试集上。与Vicuna相比,在 Evol-Instruct测试集上高出 5.8%,在Vicuna测试集上高出 1.7%。
ChatGLM2 (6B) (Du et al., 2022)是在包含中英文指令的双语数据集上通过微调 GLM (6B) (Du et al., 2022)训练的语言模型。双语指令数据集包含 1.4T标记,英汉比例为 1:1。数据集中的指令是从问答和对话完成任务中取样的。ChatGLM使用GLM进行初始化,然后使用与 InstructGPT类似的三步微调策略进行训练(Ouyanget al., 2022)。为了更好地模拟多回合对话中的上下文信息,作者将最大上下文长度从1024 扩展到 32K。为了降低GPU微调阶段的内存成本,采用了multi-query attention和causal mask strategies。在推理过程中,使用 FP16 的ChatGLM2需要13GB的GPU内存,使用模型INT4量化技术后可以用6GB GPU内存支持长达8K的会话。评估以四种英语和汉语基准进行,包括MMLU(英语)、C-Eval(汉语)、GSM8K(数学)和 BBH(英语 )。在所有基准测试中,ChatGLM2 (6B)优于 GLM (6B)和基线模型 ChatGLM(6B)。具体来说,ChatGLM2 在MMLU上比GLM好+3.1,在 C-Eval 上比 GLM 好+5.0,在 GSM8K 上比GLM 好 +8.6 , 在 BBH 上 比 GLM 好 +2.2 。 在MMLU、C-Eval、GSM8K和BBH上,ChatGLM2 比ChatGLM 的性能分别提高了+2.1、+1.2、+0.4、+0.8。
LIMA (65B) (Zhou et al., 2023)是在指令数据集上通过微调 LLaMA (65B) (Touvron et al., 2023a)训练的大型语言模型,它是基于提议的表面对齐假设构建的。表面对齐假设是指模型的知识和能力几乎在预训练阶段就已经获得,而对齐训练(例如,指令微调)则会让模型在用户偏好的形式化状态下产生响应。基于表面对齐假设,作者声称大型语言模型可以通过对一小部分指令数据进行微调来生成用户满意的响应。因此,作者构建了指令训练集/有效集/测试集来验证这一假设。对构造的测试集进行评估。在人类评估方面,LIMA的表现分别比 InstructGPT 和 Alpaca 好 17%和 19%。此外,LIMA与BARD、Cladue和GP-4取得了可比的结果。对于自动评估,这是通过询问GPT-4对反应进行评分来进行的,评分越高表示表现越好,LIMA 比 InstructGPT 和Alpaca 分别高出 20%和 36%,与BARD达到了可比的结果,同时比Claude 和GP-4效果差。实验结果验证了所提出的表面对准假设。
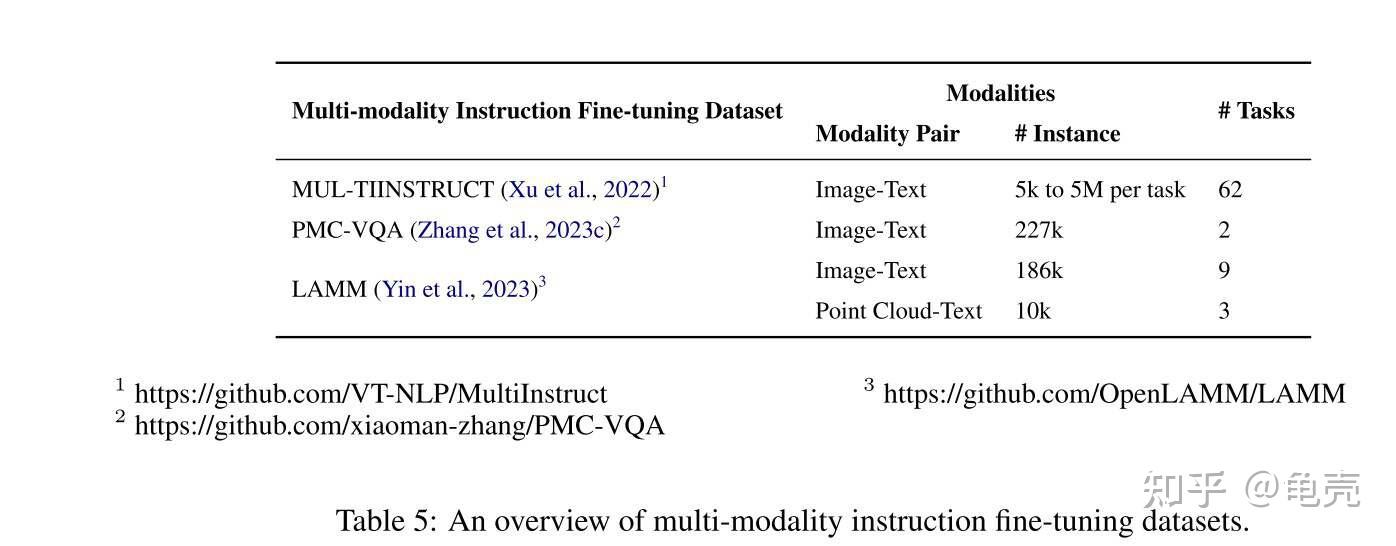
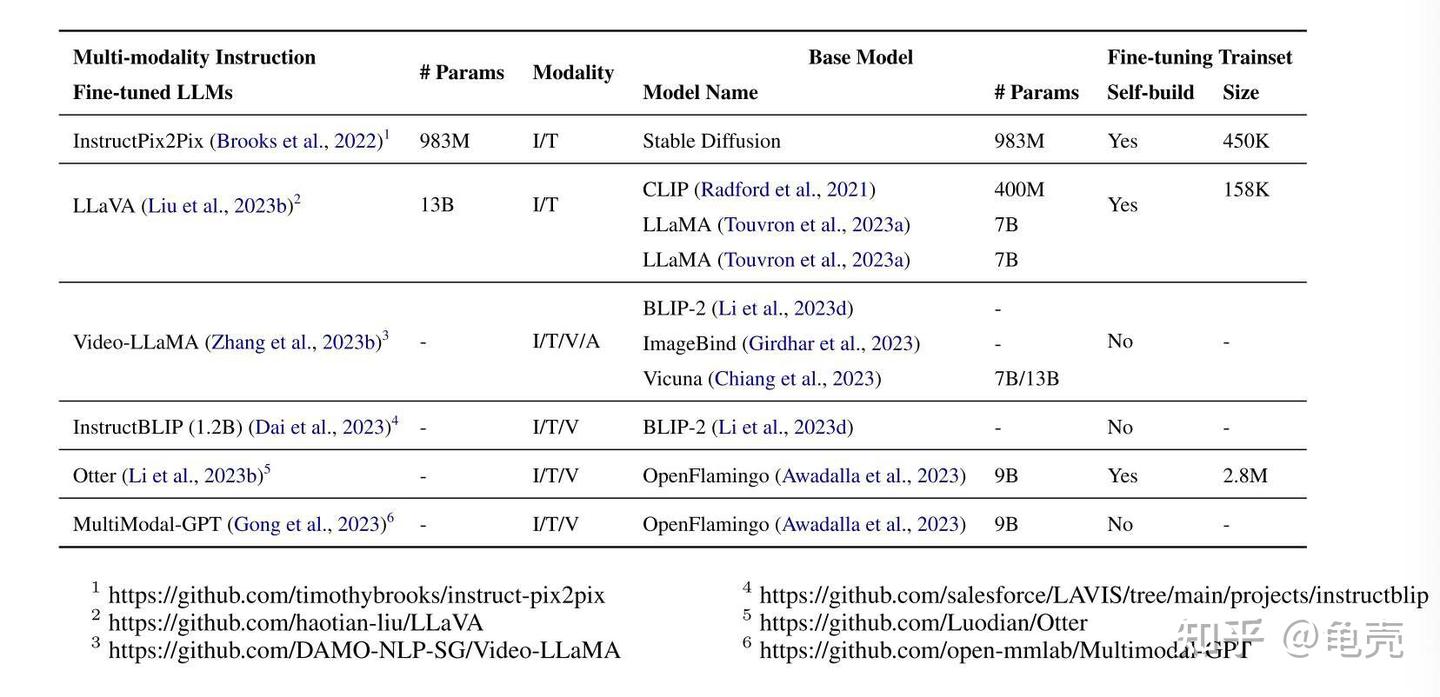
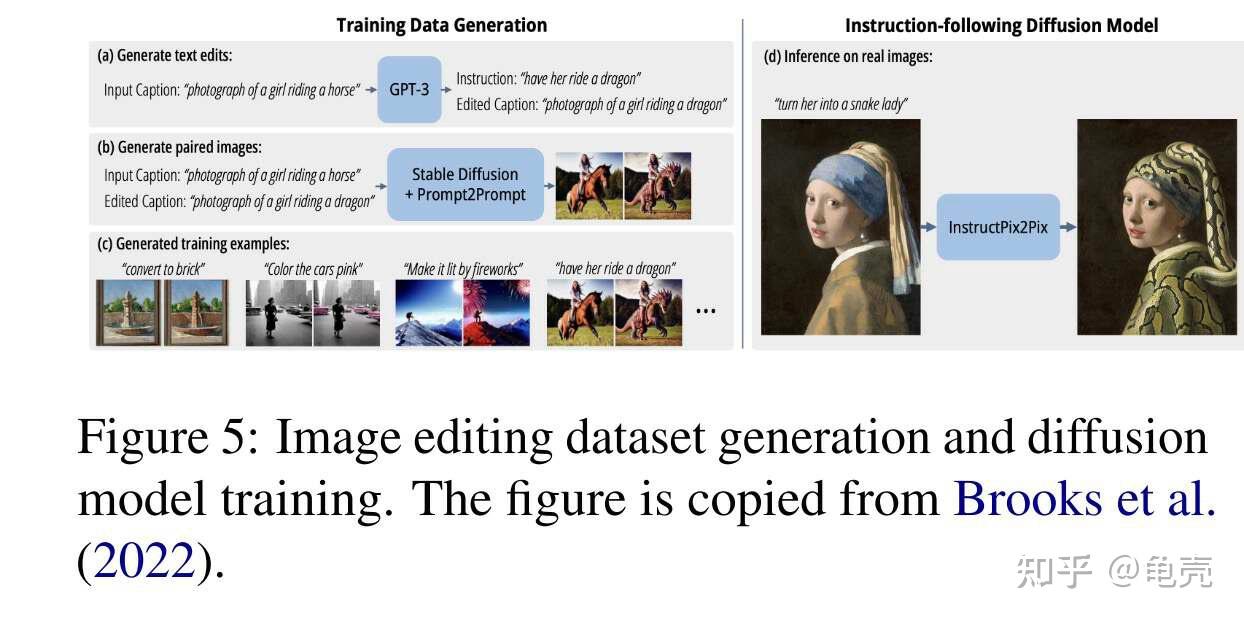
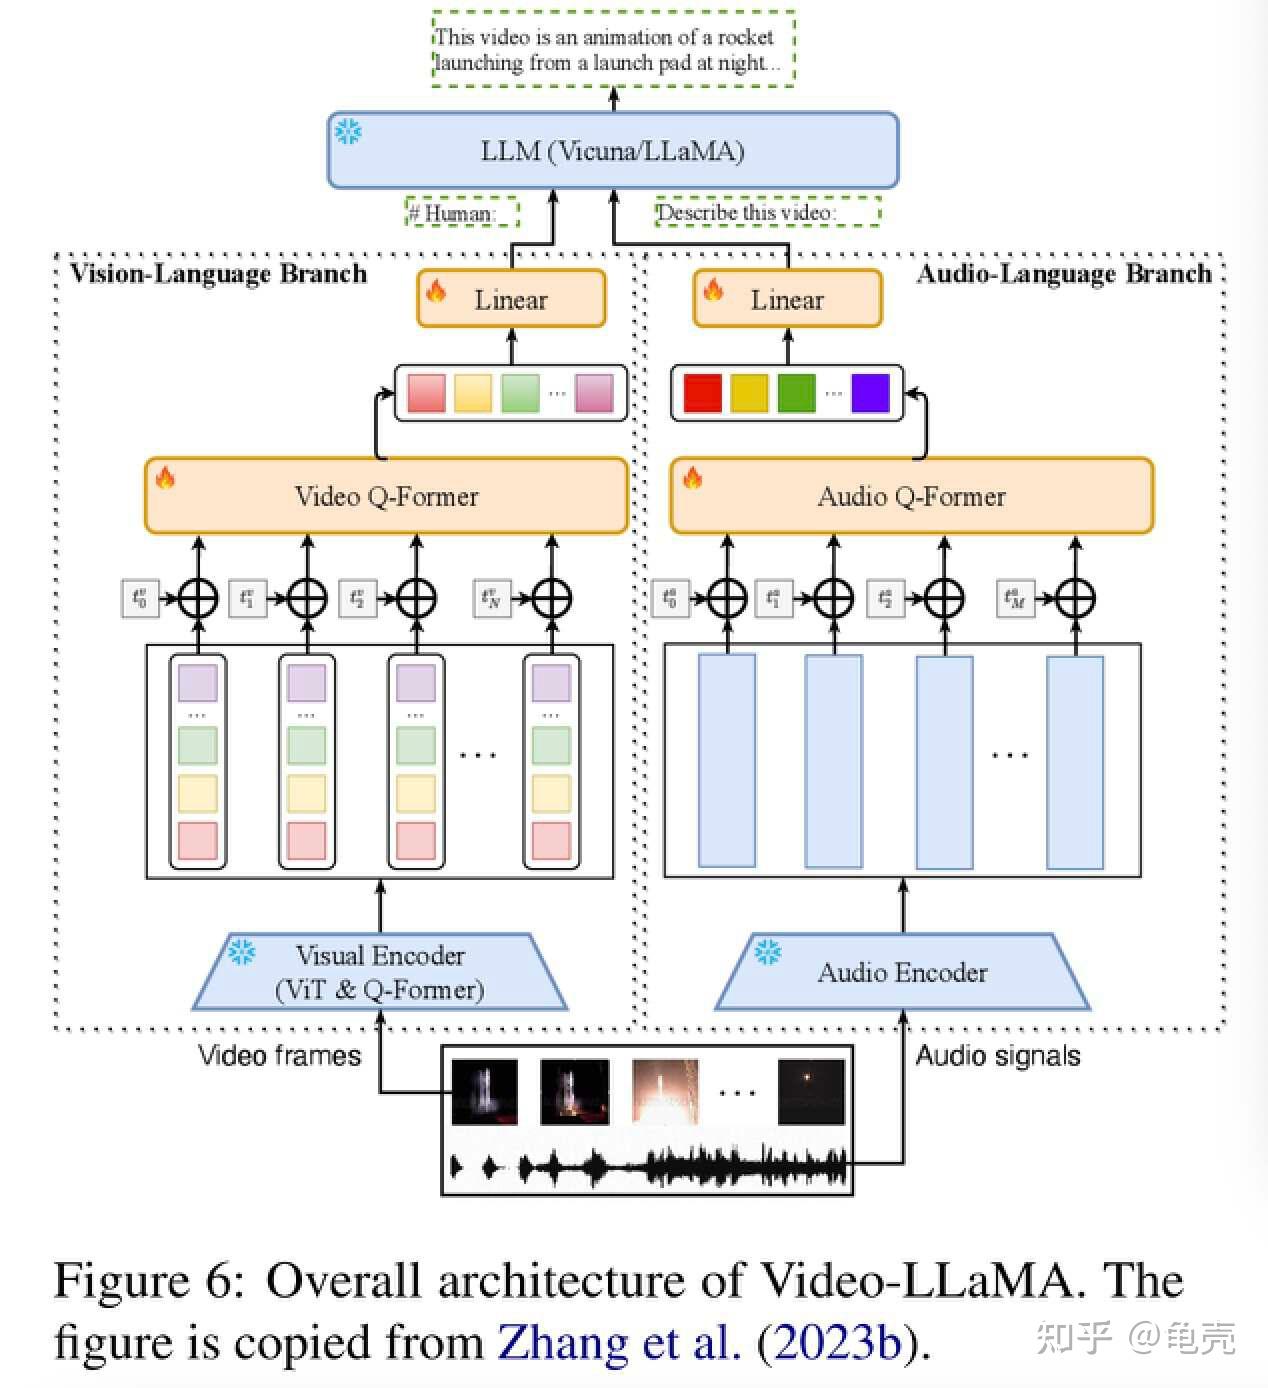
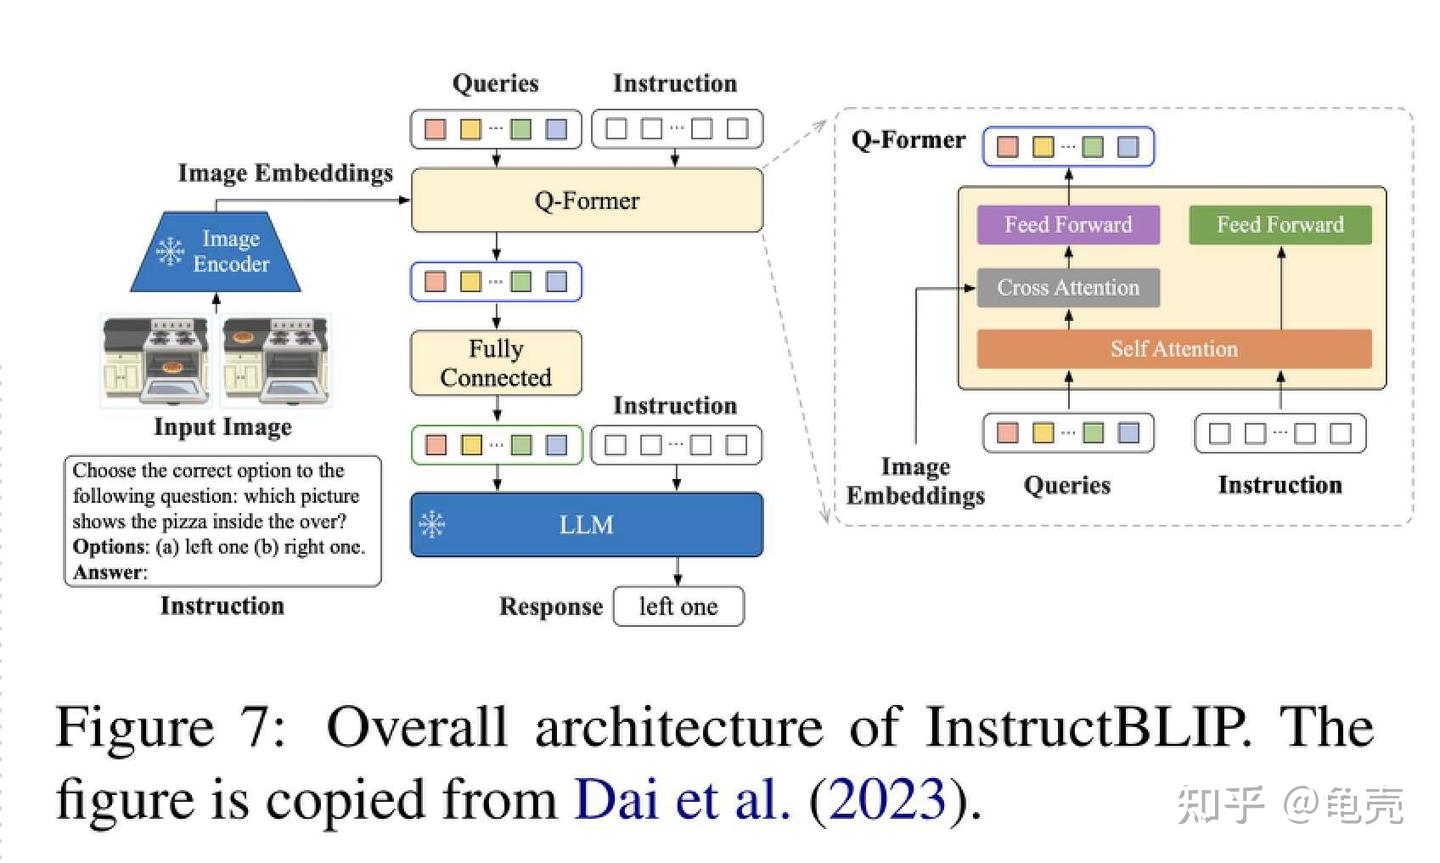
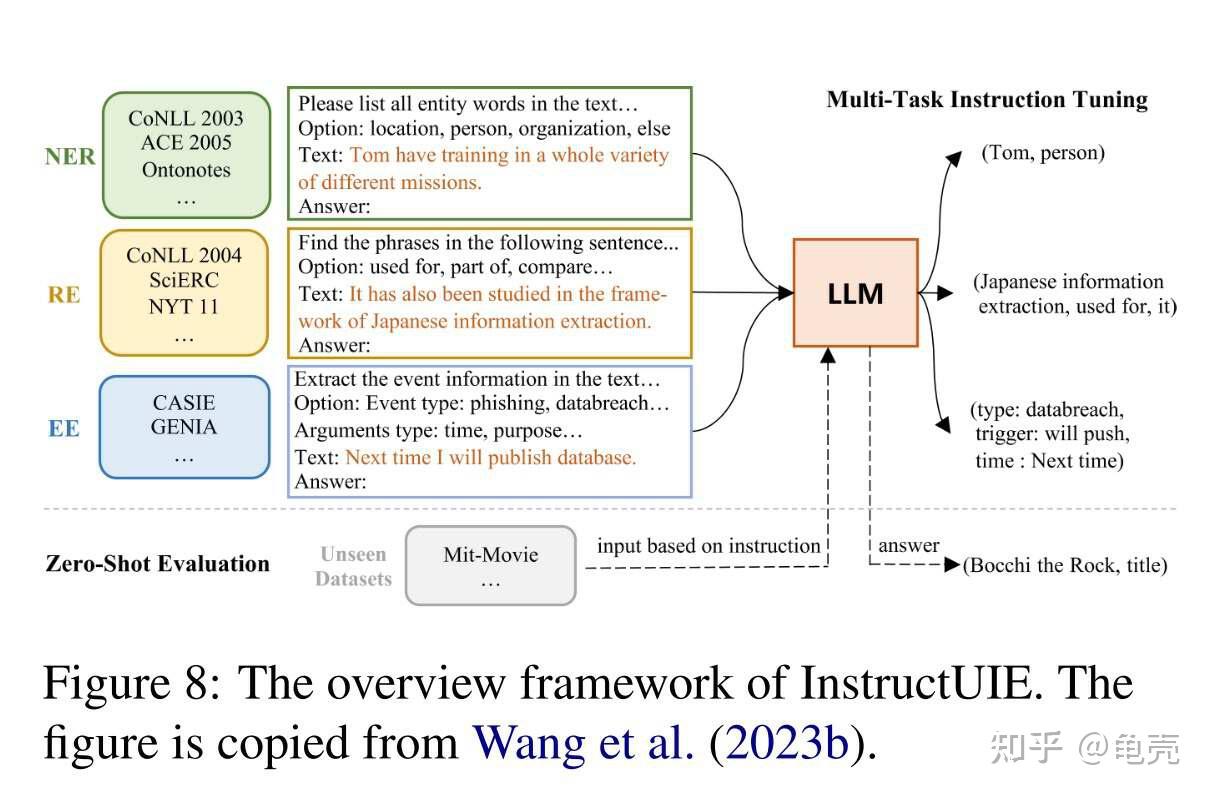
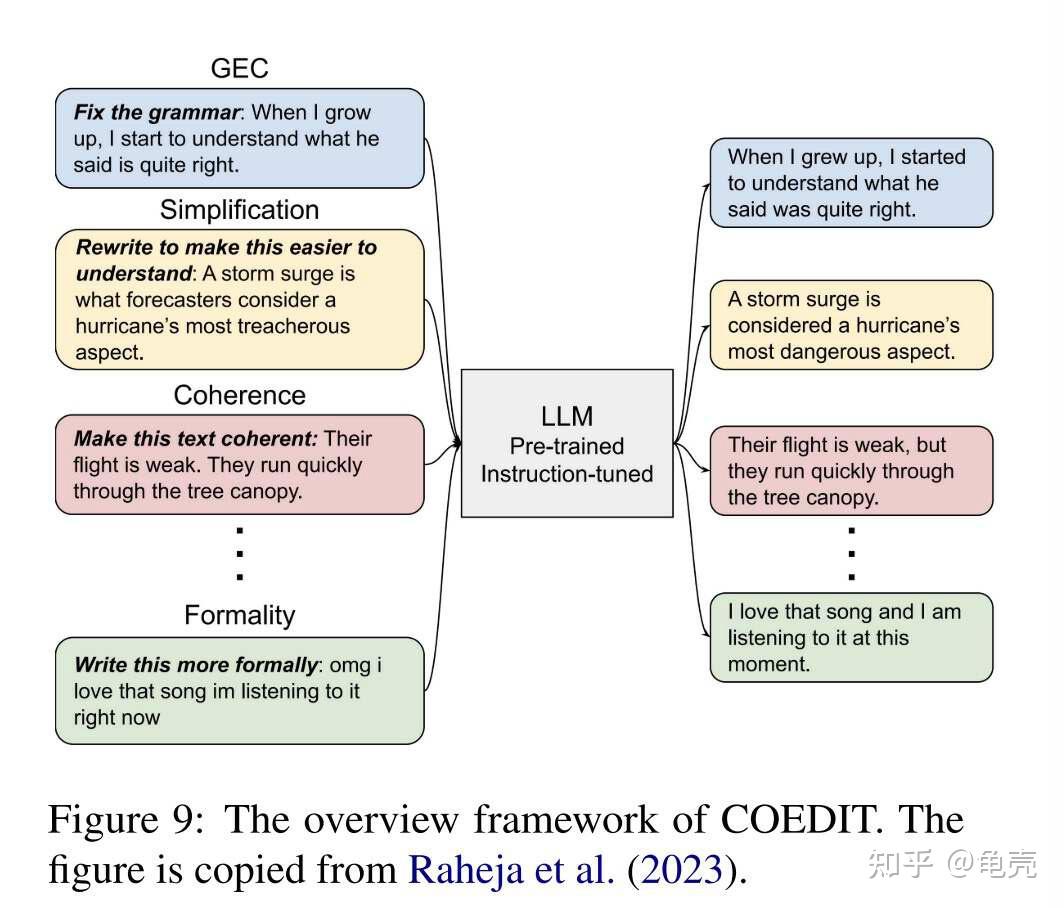
HELM(Liang et al., 2022)是对语言模型(LMs)的整体评估,以提高语言模型的透明度,提供对语言模型的能力、风险和局限性的更全面的理解。具体来说,与其他评价方法不同的是,HELM认为对语言模型的整体评价应该关注以下三个因素: (1) 覆盖面广。在开发过程中,语言模型可以适应各种NLP任务(如序列标注和问题回答),因此,语言模型的评估需要在广泛的场景中进行。考虑到所有可能的情况,HELM提出了一种自顶向下的分类法,首先将一个大型NLP 会议(ACL2022)中的所有现有任务编译成一个任务空间,并将每个任务划分为场景(如语言)和度量(如准确性)的形式。然后,当面对一个特定的任务时,分类法将在任务空间中选择一个或多个场景和指标来覆盖它。HELM通过分析每个任务的结构,明确了评估内容(任务场景和指标),将语言模型的场景覆盖率从 17.9%提高到96.0%。 (2) 多度量测量。为了使人类能够从不同的角度衡量语言模型,HELM提出了多度量度量。HELM涵盖了 16个不同的场景和 7 个指标。为了确保密集的多度量测量的结果,HELM测量了 112 个可能的核心场景中的98个(87.5%)。 (3) 标准化。语言模型的规模和训练复杂度的增加,严重阻碍了人们对各个语言模型结构的理解。为了建立对现有语言模型的统一理解,HELM对30个知名语言模型进行 了 基 准 测 试 , 包 括 谷 歌 (UL2(Tay et al. ,2022)) 、 OpenAI (GPT-3(Brown et al. , 2020b)) 和EleutherAI (GPT-NeoX(Black et al., 2022))等机构。有趣的是, HELM 指 出 , T5 (Raffel et al. , 2019) 和Anthropic- LMv4-s3 (Bai et al., 2022a)等 LLMs 在最初的工作中并没有直接比较,而 GPT-3、YaLM等 LLMs经过多次评估后,仍然与相应的报告存在差异。
Gupta 等人(2023)试图估 IT模型所需的最小下游训练数据,以匹配 SOTA监督模型对各种任务的要求。Gupta 等人(2023)在单任务学习(STL)和多任务学习(MTL)设置下,对来Super Natural Instructions(SuperNI)的 119个任务进行了实验。结果表明,在 STL设置中,只有25%的下游训练数据的IT 模型在这些任务上的表现优于 SOTA模型,而在MTL设置中,只有 6%的下游训练数据可以引导 IT 模型实现SOTA性能。这些发现表明,指令调优可以有效地帮助模型在数据有限的情况下快速学习任务。
IT 需要大量的专门的指令数据进行训练。Zhou 等人(2023)假设,预训练的LLM只需要学习风格或格式来与用户交互,并提出了通过仅在1000个精心挑选的训练示例上对LLM进行微调,从而实现强大性能的LIMA。具体来说,LIMA首先手动管理 1000 个具有高质量提示和响应的示例。然后,1000 个示例被用来微调预训练的 LLaMa-65B(Touvron 等人,2023b)。相比之下,在超过 300个具有挑战性的任务中,LIMA的表现优于 GPT-davinci003 (Brown 等人,2020b),后者通过人类反馈调整在 5200 个示例中进行了微调。此外,仅通过一半的示例 , LIMA 就 取 得 了 与 GPT-4 (OpenAI,2023)、Claude (Bai 等人,2022b)和Bard 相当的结果。最重要的是,LIMA证明了LLMs 强大的知识和能力可以向用户展示,只需要一些精心策划的微调说明。
IT模型的性能高度依赖 IT数据集。然而,对这些信息技术数据集缺乏开放式和主观的评价。为了解决这个问题,Wang 等人(2023c)在各种开放 IT数据集上通过微调 LLaMa 模型(Touvron等人,2023b)来执行数据集评估,并通过自动和人工评估来测量不同的微调模型。在 IT数据集的组合上训练一个额外的模型。对于结果,Wang et al. (2023c)表明,在所有任务中不存在单一的最佳 IT数据集,而通过手动组合数据集可以实现最佳的整体性能。此外,Wang et al. (2023c)指出,尽管 IT可以给所有尺寸的 llm带来很大的好处,但更小的模型和高质量的基础模型质是 IT 的最大受益者。对于人类评估,模型越大,可接受性得分越高。
为了解决模型通过指令调优获得的特定知识缺乏清晰性的问题,Kung 和 Peng(2023)深入分析了模型如何在 IT过程中使用指令,方法是比较提供修改指令和原始指令时的调优。 特别是,Kung 和Peng(2023)创建了简化的任务定义,删除了所有语义组件,只留下输出信息。此外,Kung和 Peng(2023)还引入了包含不正确的输入-输出映射的虚幻示例。令人惊讶的是,实验表明,根据这些简化的任务定义或错误示例训练的模型,可以获得与根据原始指令和示例训练的模型相当的性能。此外,本文还引入了零样本分类任务的基线,在低资源设置下实现了与 IT相似的性能。 总之,根据 Kung 和 Peng(2023)的观点,在当前的 IT 模型中观察到的显著性能改进可能归因于他们捕捉表层模式的能力,例如学习输出格式和猜测,而不是理解和学习特定的任务。
LLM仿制是一种从更强大的模型(如ChatGPT等专有系统)收集输出的方法,并使用这些输出对开源的 LLM进行微调。通过这种方式,开源LLM可以获得与任何专有模型竞争的能力。 Gudibande 等人(2023)进行了多次实验,批判性地分析了模型模仿的有效性。具体来说,Gudibande 等人(2023)首先从ChatGPT的广泛任务输出中收集数据集。然后,这些数据集被用于微调一系列模型,包括 1.5B到13B的大小,基础模型GPT-2 和LLaMA,数据量从0.3M token到 1.5M token。 对于评估,Gudibande等人(2023)证明,在支持数据集的任务中,模仿模型比以前好得多,输出结果与 ChatGPT 相似。而在没有模拟数据集的任务中,模拟模型的准确性并没有提高甚至下降。 因此,Gudibande et al.(2023)指出,正是模仿模型善于模仿ChatGPT 的风格(如流利、自信和结构良好)的现象,使得研究者对模仿模型的一般能力产生了错觉。因此,Gudibande 等人(2023)建议,研究人员最好将重点放在提高基础模型和指令示例的质量上,而不是模仿专有模型。
本工作概述了在快速发展的指令调优调领域的最新进展。本文对文献进行了系统的回顾,包括 IT的一般方法论、数据集的构建、模型的训练、IT对不同模式、领域和应用的应用。此外还回顾了对 IT模型的分析,以发现它们的优点和潜在的缺陷。希望这项工作能够激励人们进一步努力解决当前IT模型的缺陷。
编辑于 2023-12-29 07:24・北京
LLM
大模型优化
人工智能
赞同 1222 条评论308 27
分享
申请转载
 未登录用户
2 条评论
默认
最新
 Flux
感觉llm发展太快了,没几天这个综述又过时了
2023-09-18 · 北京
回复1
 龟壳
作者
 是的
2023-09-19 · 北京
回复1
关于作者
龟壳
人工智能方向研究生
华中科技大学 工学硕士
回答 67 文章 228 关注者 3,565
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 综述:推荐系统如何从大语言模型中受益 段超 # ICLR 2025 | SLMRec:重新思考大语言模型在推荐系统中的价值 宣传一下ICLR2025中稿的一篇LLM4Rec相关的paper,欢迎大家关注讨论。 探究了LLM在Sequential Recommendation中参数量与效果的关系,并提出了一种知识蒸馏的方法,使得SLM仅用13%的模型参数… 风中的读书人
 知识和大语言模型的集成趋势:综述 黄浴发表于大模型的技...
 基于大语言模型的推荐系统研究综述 段超
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码