 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
大模型LLM微调的碎碎念
首发于刘聪NLP的AIGC
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
大模型LLM微调的碎碎念
首发于刘聪NLP的AIGC
切换模式
 uuuuu
to be a good nlper
收录于 · 刘聪NLP的AIGC
132 人赞同了该文章
分享一下关于大模型微调最近看到的一些有意思的实验,涉及到1.模型微调的意义 2.lora微调还是全参微调及lora微调稳定性 4.base or chat版模型选择 5.lora微调的一些经验
顺便说一下,近期会持续更新大模型落地过程中的trick,感兴趣的可以关注一下噢~
一、模型微调的意义
blog:How to Fine-Tune a 6 Billion Parameter LLM for Less Than $7 (anyscale.com)
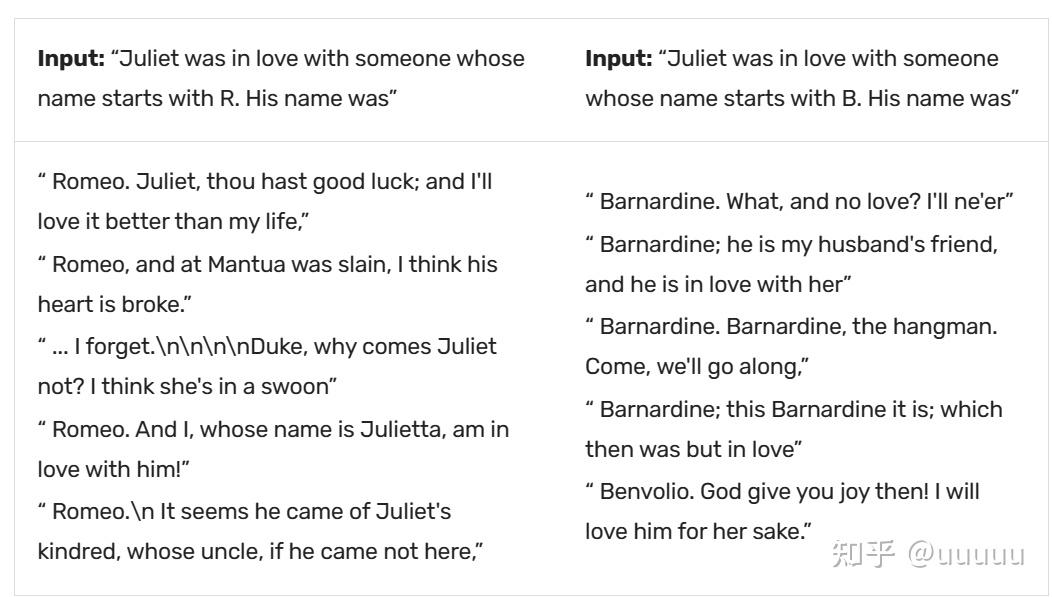
作者使用tiny-shakespeare数据集对6B的模型进行微调,想让模型学习莎士比亚剧本中的写作风格。并且他将数据集中的所有的“罗密欧”替换为“鲍勃”,如果对这个数据进行微调,是不是可以期望微调后的模型学到了鲍勃等于罗密欧,而罗密欧在这个新的领域数据里不存在。微调完成之后,他们测试分别测试输入“朱丽叶爱上了一个名字以罗开头的人。他的名字是”以及“朱丽叶爱上了一个名字以鲍开头的人。他的名字是”,结果是前者仍然能输出大量罗密欧开头的答案,而后者确基本不会出现鲍勃开头的答案。这个实验说明了即使是简单的通过文本替换微调训练得到的模型也很难去改变预训练模型内部记忆的知识。
下图是微调后模型的生成结果:
 因此,在进行微调之前,我们需要考虑的是解决相应的任务是否是要让模型学习新的概念。除了微调,我们还可以去从更多的角度来思考怎么更好的完成具体的业务需求,例如:
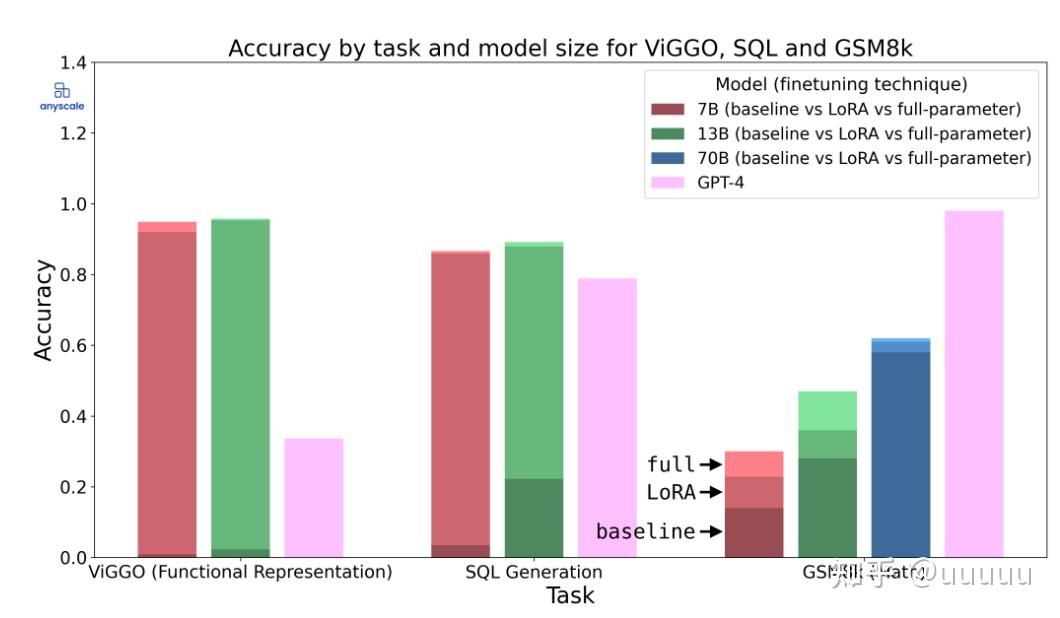 如果你没有足够的资源来进行全参数微调,并不是所有的任务使用LoRA 都能追齐全参微调的效果。假如LLM的原始权重视为矩阵“X”。 对于任何给定的任务,经过优化微调的 LLM 的权重由矩阵“Y”表示。 微调的目标是发现一个 delta 矩阵“Z”,使得 X+Z=Y。 然而,在 LoRA 的情况下,这个增量矩阵“Z”是通过低秩分解来近似的。 因此,对于某些类型的任务来说, 一些数据集可能更容易对齐,而另一些数据集可能会有效果损失。 相比之下,全参数微调则没有这个约束, 学习到的权重保留了原始模型的表达能力,可能简化了拟合不同数据的任务。
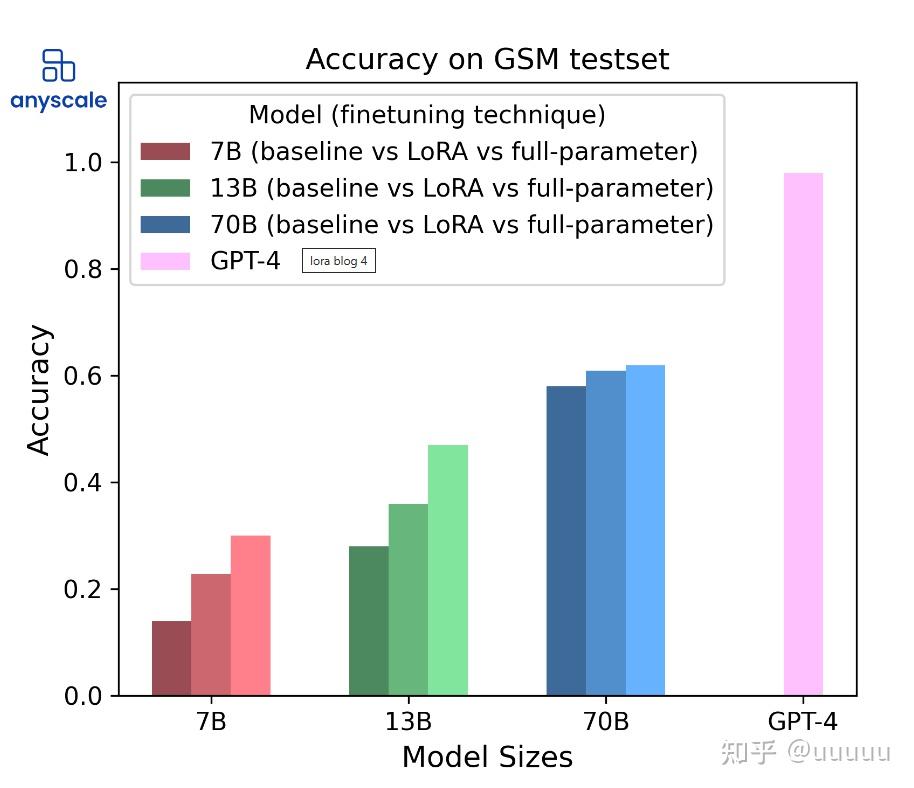
gsm8k数学任务要准确回答需要模型进行推理,所以相比于前2个抽取+格式对齐的任务,全参微调与lora微调的差异就比较大,具体差异看下图。
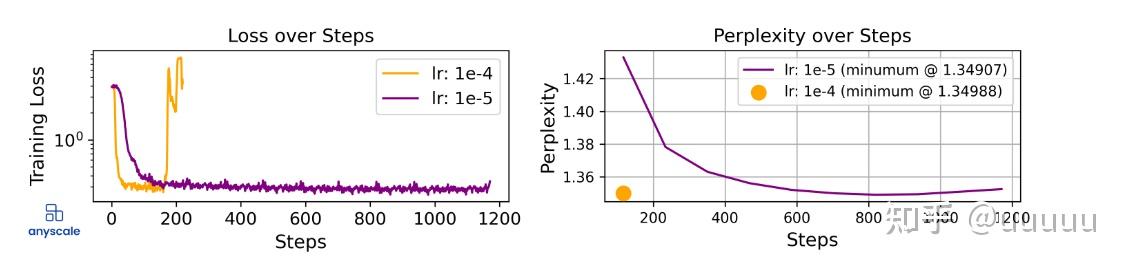
 即使是lora适合的任务,也需要用适合的学习率才能保证稳定的收敛。下图为70b的llama2固定所有参数除了学习率不同的训练曲线,尽管大学习率和小学习率最优的ckpt都能达到差不多的效果,但是这种潜在的损失爆炸的风险还是会干扰你的判断。
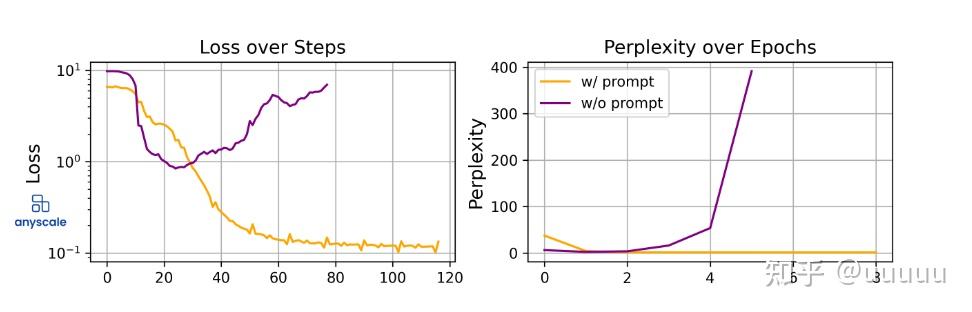
 通过微调进行对齐,prompt依然很重要,比如alpaca用的prompt是"Below is an instruction that describes a task. Write a response that appropriately completes the request.\n\n### Instruction:\n{instruction}\n\n### Response:{output}",下游对齐的适合如果你想简单编码成"<start_q>{instruction}<end_q><start_o>{output}<end_o>"。这样就省了prompt的长度,单次推理的rt也能快一些,但是这样的话使用lora微调效果不稳定,如下图
 如果额外新增了token,那使用lora是训练整个embedding层,还是只训练新增token的embedding?作者建议似乎是随机初始化然后再embedding插个lora就够了。
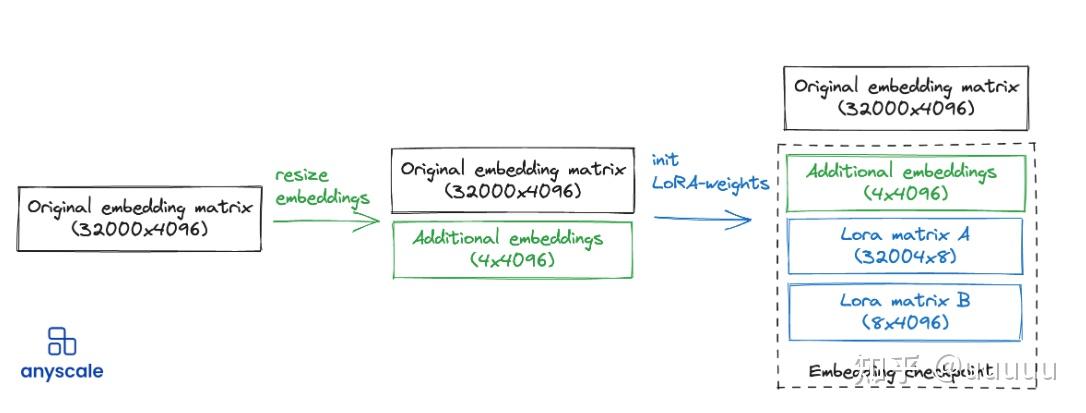 三、模型选择
blog: Fine-Tuning Llama-2: A Comprehensive Case Study for Tailoring Models to Unique Applications (anyscale.com)
大多的开源模型都会提供一个base版和一个chat版,这个实验是对比base和chat处理下游任务的具体情况,实验准备是使用llama2 7b 13b 70b,训练10个epoch,从最好的val 困惑度选择最优的ckpt,如下图
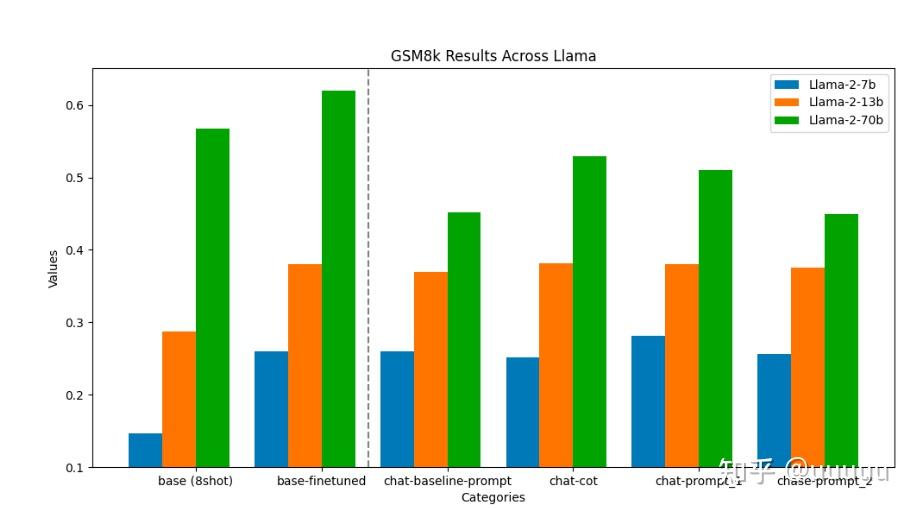
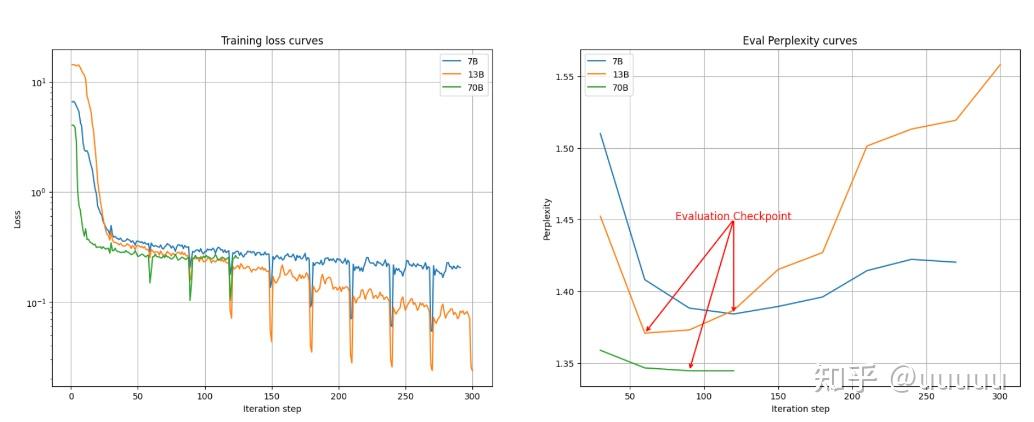 使用的测试数据为gsm 8k(math),一共8k个qa对
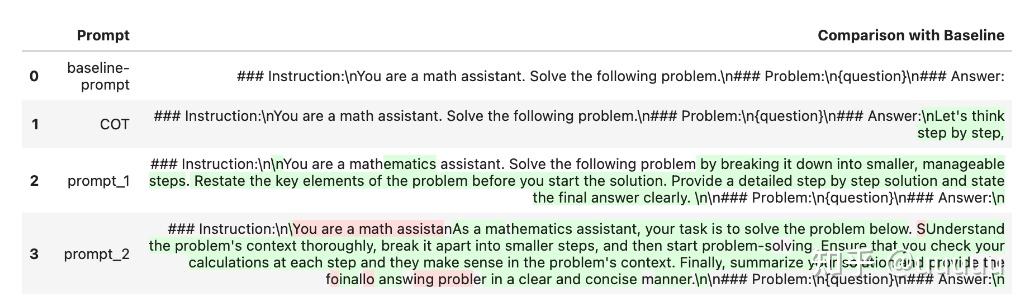
 图上用到的prompt如下图
 结论如下:
四、lora微调的秘密 blog:After 500+ LoRAs made, here is the secret : LocalLLaMA (reddit.com) 这个没有实验,是作者通过过去训练的大量的lora模型分享的经验 微调出效果的关键是在数据上,可能95%的效果取决于你得数据,剩下的5%在于你不要用错误的参数来破坏数据,如果不是为了刷榜没必要去追求一个最优的参数组合。你可能觉着你得训练数据里面只有几条脏数据,对大模型来说根本无所谓,但是可能就因为这些少量的脏数据影响了整个模型的效果。不必追求完美的学习率2.5647e-4,因为它并不存在。只需要朝着正确的方向努力,如果数据集好的话,大部分时间你都能达到预期的效果。 一些额外的注意事项:
近期文章推荐
浅谈LLM的长度外推
浅谈训练LLM的一些小技巧
再谈长度外推
LLM推理加速-Medusa
LLM监督微调-数据筛选
浅谈长文摘要
LLM长context微调技巧-LongLora
从开源LLM中学模型架构优化-Mistral 7B
从开源LLM中学模型架构-基础篇
发布于 2023-10-09 09:43・湖北
LLM(大型语言模型)
自然语言处理
深度学习(Deep Learning)
赞同 1328 条评论281 17
分享
申请转载
 未登录用户
8 条评论
默认
最新
 piamo
我的理解 lora 微调主要是能注入指令模板而非知识了吧,那 baseline 模型选择原 pretrain 模型还是 chat 模型好呢
2023-11-26 · 北京
回复喜欢
 uuuuu
作者
一般看要微调的数据量,数据很多用哪个都可以,数据很少用chat版本的
2023-11-26 · 广东
回复喜欢
展开其他 1 条回复
 战士金
 老哥我试了下,在选择题数据集上,验证集loss最低点并不是测试集表现最好的时候,得再多训训,准确率能差10%。。。 我验证集和测试集都是随机抽的,按理说分布不应该差太多。老哥遇到过这种情况嘛?
2023-10-13 · 北京
回复喜欢
 uuuuu
作者
涉及到推理的任务微调,确实多训练一下会更好
 2023-10-13 · 广东
回复喜欢
展开其他 1 条回复
 Yuuu
我去,为什么有评论却看不见……
 2023-10-13 · 北京
回复喜欢
uuuuu
作者
系统自动删的
 2023-10-13 · 湖北
回复喜欢
未登录用户
关于作者
uuuuu
to be a good nlper
回答 18 文章 39 关注者 1,602
关注发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 大模型LLM微调碎碎念(二) uuuuu
 大模型学习笔记(四) 更好的LLM:微调、提示词工程与对齐 水滴油穿
 领域大模型LLM训练Trick(2) 奇文王语发表于大模型相关... # llm微调记录 03 微调方法LlamaFactory 的微调方法有3种: Full: \theta_{new}=\theta_{old}+\Delta\theta Lora: \theta_{new}=\theta_{old}+B\cdot A^T Freeze:冻结层: \theta_{new}=\theta_{old} 训练层… 谁知道呢
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码