 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
【简评】Full-Resolution Residual Networks for Semantic Segmentation in Street Scenes
首发于Segmentation Paper Reading
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
【简评】Full-Resolution Residual Networks for Semantic Segmentation in Street Scenes
首发于Segmentation Paper Reading
切换模式
 余昌黔
 华中科技大学 控制科学与工程博士
收录于 · Segmentation Paper Reading
37 人赞同了该文章
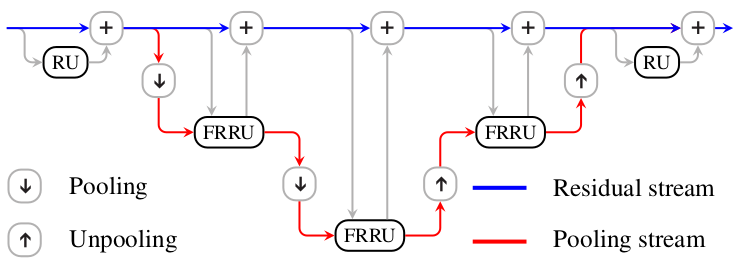
本文提出了一种two-stream的网络结构来实现strong recognition和strong localization performance。
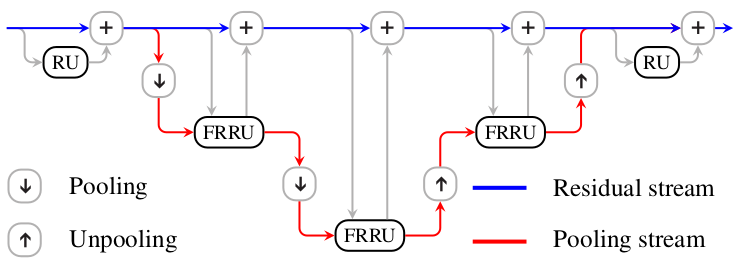 Two-Stream:
虽然看起来和普通的encoder-decoder网络结构比较类似,但是还是有所不同的。因为这个结构中存在residual stream,保持完整的resolution,而普通的encoder-decoder结构是会直接降低图像分辨率的,然后之后再逐渐升上去。
其中的RU就是不同的Residual block结构。其中FRRU的结构如下:
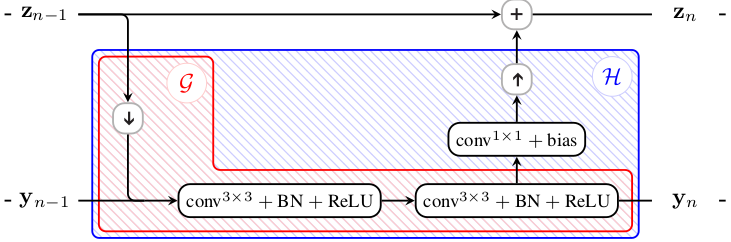 z_{n-1}是residual input; y_{n-1}是pooling input
可以看到,pooling stream其实完全是为residual stream服务的,将residual stream上的输出降下来处理之后再升上去。
对于这个结构我们还可以这样理解,普通的resnet中降采样的操作主要靠conv+stride来控制的,如下:
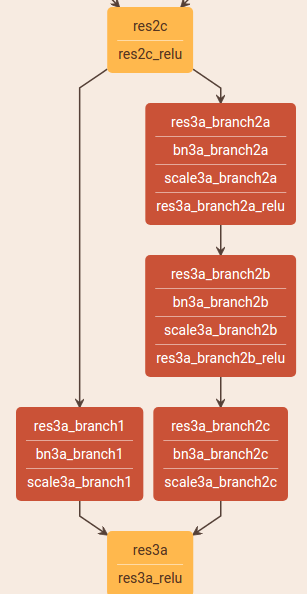 这样为了保证之后两条支路的feature map能够相加,shortcut上也进行了对应的尺寸调整。而现在FRRU中相当于保证了shortcut的绝对clean,然后将pool和unpool全放在了支路上进行。这样就实现了一条full-resolution的支路了。
FRRN具体网络如下:
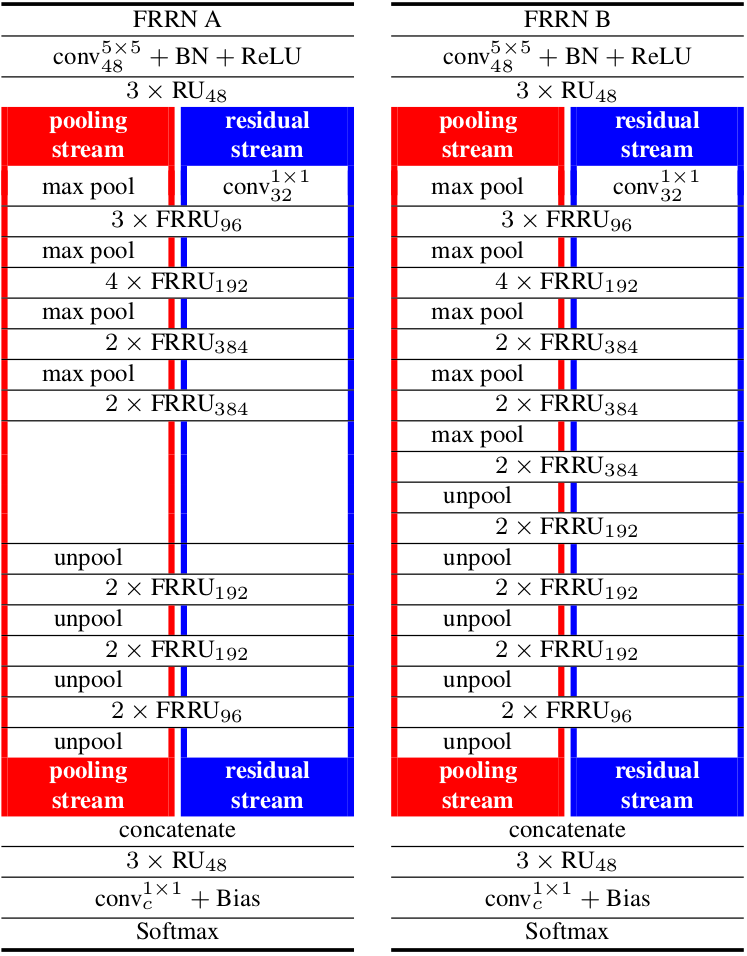 FRRN A和FRRN B主要是输入图片resolution不同。
文章中使用的是 bootstrapped cross-entropy loss 进行训练,即选择更难的像素进行训练。
l=-\frac{1}{K}\Sigma^{N}{i=1}1[p{i, y_i}<t_K]\log{p_{i, y_i}}
其中, 1[x] = 1 if x is true; t_k的选择使得:
|\{i\in\{1,...,N\}:p_{i, y_i}<t_k\}|=K t_k可以通过将预测的概率进行排序,然后选择第K+1个作为阈值。不同K值选择的效果如下:
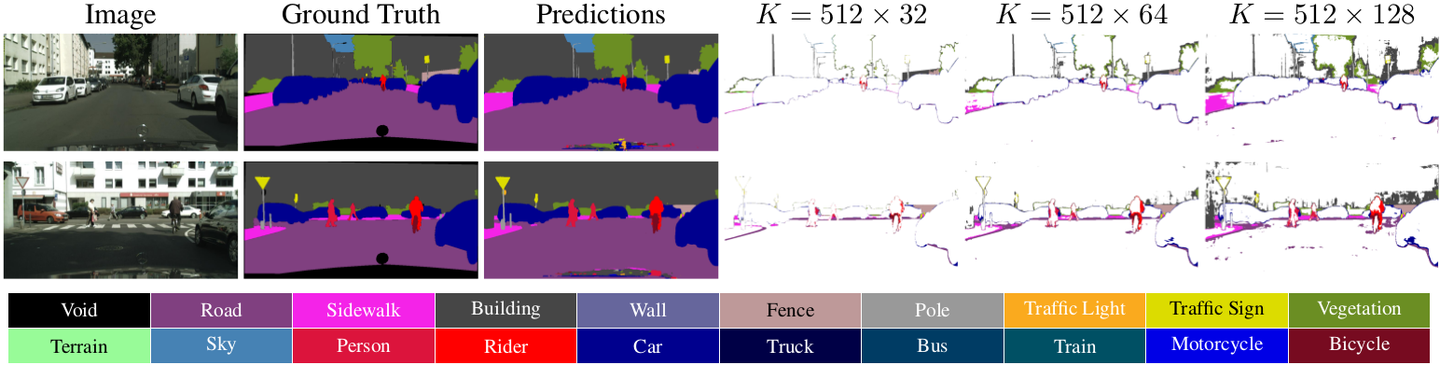 这种损失的计算方法来源于文章:[1605.06885] Bridging Category-level and Instance-level Semantic Image Segmentation,详细解释可以看看。
最后文章中还提到,因为full-resolution的存在,所以内存消耗是很大的。为了能用standard bp算法进行训练,文章将计算图分成了几个子块进行训练的。
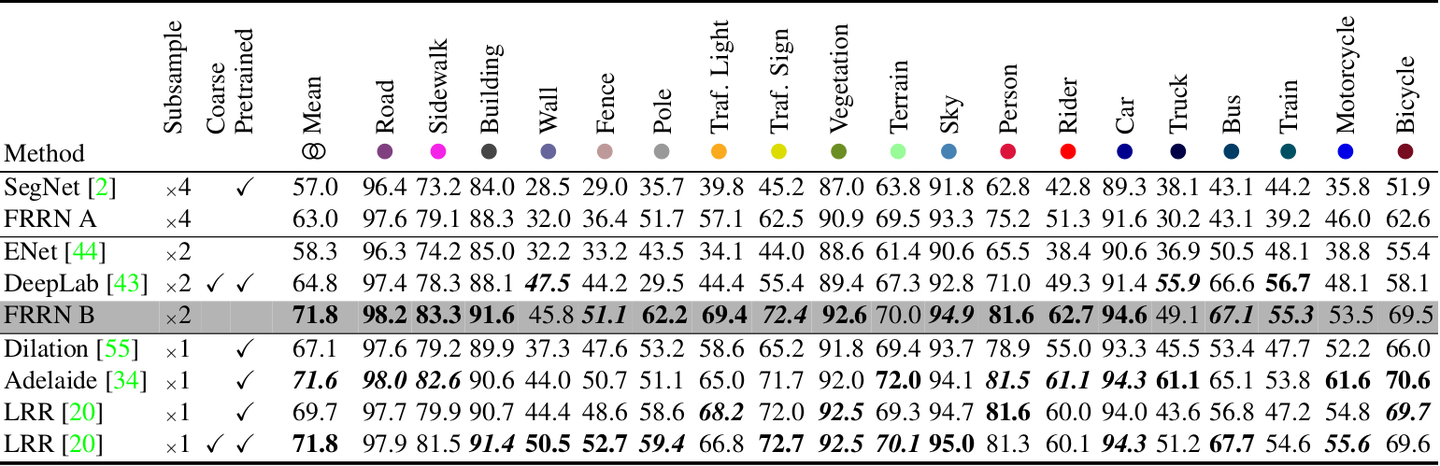 论文地址:[1611.08323] Full-Resolution Residual Networks for Semantic Segmentation in Street Scenes
作者Code:TobyPDE/FRRN
PS:知乎专栏的公式编辑真是无力吐槽,完全不知道该怎么搞成行内公式。
发布于 2017-07-06 11:25
深度学习(Deep Learning)
semantic segmentation
赞同 3716 条评论86 喜欢
分享
申请转载
 未登录用户
16 条评论
默认
最新
 哆来咪
搞不懂为啥这篇文章竟然是oral,PSPNet都只是一个poster
2017-10-13
回复喜欢
 余昌黔
作者
 可能因为这篇的结构fancy一些
2017-10-13
回复喜欢
 御宅暴君
你几乎快一年没更新专栏了诶!
2018-03-26
回复喜欢
 余昌黔
作者
哎,实习+发paper以来,各种事,各种锅,最近忙完就要开始补之前的一些paper了。谢谢关注哦
2018-03-26
回复1
展开其他 4 条回复
御宅暴君
bootstrapped cross-entropy loss 好奇特,与其放弃「概率大于一定阈值的像素」的 loss, 到不如加强「概率小于一定阈值的像素」的 loss 权重,说不定更好。
2017-08-24
回复喜欢
余昌黔
作者
这个只有实验一发了,最近的Focal Loss感觉应该有用,但是暂时还没有时间去做这个实验。
2017-08-24
回复喜欢
展开其他 1 条回复
 御宅暴君
我有个猜测,以往的语义识别网络都是把数据集的图片统一缩放到同一个大小再训练,接着在同样被缩放的测试集上评测,RefineNet 说它们一般缩放为八分之一,而 RefineNet 本身则只缩放到四分之一,现在 FRRN 则不缩放图片,直接在原分辨率上训练,对吗?
2017-08-23
回复喜欢
余昌黔
作者
FRRN也不是不缩放,只是有一路保持了full resolution。我的理解是这一路就是用来给另一路补信息的。这一篇好像还是今年CVPR的oral,不过performance不高。
2017-08-24
回复喜欢
展开其他 1 条回复
 SCP-173
行内公式真蛋疼
2017-07-06
回复喜欢
 余昌黔
作者
是的,最后只能直接写了
2017-07-06
回复喜欢
未登录用户
关于作者
余昌黔
华中科技大学 人工智能博士
华中科技大学 控制科学与工程博士
回答 82 文章 20 关注者 27,689
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 Hierarchical Attention Sequence Model over Semantic ID aabc
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码