 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
浅析经典目标检测评价指标--mmAP(一)
首发于欲穷千里目
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
浅析经典目标检测评价指标--mmAP(一)
首发于欲穷千里目
切换模式
 zzzz1
收录于 · 欲穷千里目
520 人赞同了该文章
大家好,我是旷视科技南京研究院研究员赵博睿,主要研究领域为目标检测。今天和大家聊聊mmAP的那些事~
目标检测是计算机视觉领域的一项基础问题,在许多智能场景的落地应用中目标检测通常都是视觉感知的第一步。在学术研究中,MS COCO作为目标检测领域中最常用、最权威的公共数据集被作为目前几乎每一个目标检测算法的标准“演武场”,其性能度量中的指标—mmAP更是被广大研究者耳熟能详成为经典。不过,经典之余,一些研究者往往对此“拿来主义”不求甚解。
本文上半篇将针对mmAP这一经典的目标检测评价指标详细解析其定义初衷和具体计算方式;本文的下半篇将继续分析mmAP的特点,并介绍针对这些特点现有方法如何“hack” mmAP,最后将提出几个mmAP未考虑到的评测要素。仅抛砖引玉,期待诸君有更优评价指标的提出。
目标检测
目标检测(Object Detection)是计算机视觉中非常常见的任务,该任务的输入是一张图像,输出为图像中的所有存在的目标,每个目标都要给出类别信息(是什么?)和位置信息(在哪里?)。这个位置信息通常用一个外接矩形框(俗称bounding box)来表示。
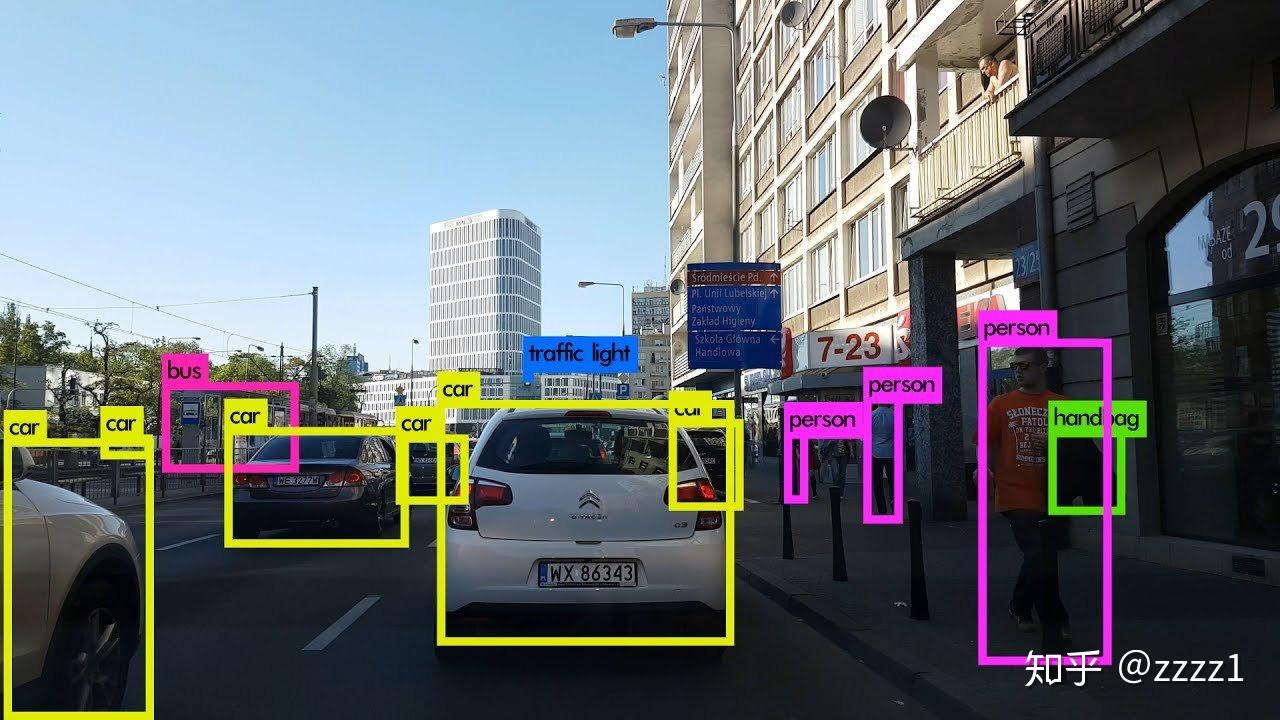 目标检测
这个任务有一个特点,就是它的输出是非结构化的。也就是说,它的输出具有很强的不确定性。举个例子,图像分类任务的输入也是一张图像,输出为一个标签/类别,代表着这张图的分类,因此分类任务的输出是结构化的,有且仅有一个标签;而目标检测的输出是图像中的所有目标(类别+位置),图像中到底有多少个目标是不确定的。这一特点非常重要,也正因为这一特点,目标检测的性能度量方法要比图像分类任务复杂得多,这在后面的分析中会提到。
什么样的检测结果是“好”的?
什么样的检测结果是好的?这个问题看起来很简单,因为我们在看一张图(包含了检测出来的框/分割掩码)时,很容易就能够对比出真实目标和检测结果的“贴合程度”。但是对于计算机视觉任务,我们需要一个明确的数字化的判断标准。(以下均使用目标检测任务作为示例)
下面我们用 GT(类别, 矩形) 来表示一个图中的目标(也就是我们希望找出来的目标,也可称作Ground Truth),用DT(类别, 矩形)来表示一个我们检测出来的目标(Detection Result)。
首先,一个好的检测结果,至少得把类别搞对。如果类别就错了,位置信息再准确都是白搭,也就是GT(类别)=DT(类别);其次,DT(矩形)要尽可能地“贴合”GT(矩形),越“贴合”越好。如何判断这个“贴合程度”呢?最常用的一种评价方式是交集和并集的比值(交并比、Intersection over Union、IoU)。顾名思义,交并比就是DT(矩形)和GT(矩形)的重合部分面积(交集) 与 两者的全部面积(并集,重合的部分不会重复计算面积)。
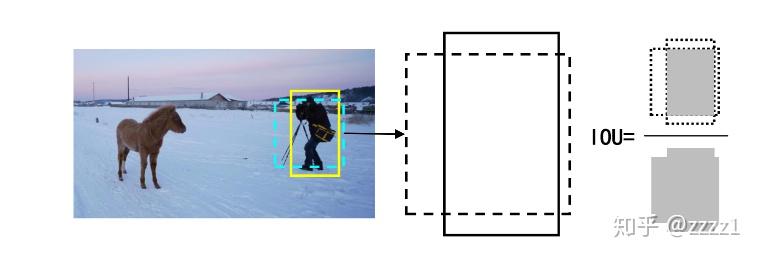 Intersection over Union(IoU)
这个比值最小为0,也就是两个矩形毫无交集;最大为1,也就是两个矩形完全重合。IoU越大,检测的结果越好。
评价检测性能之前
知道了什么样的检测结果是好的,就可以评价检测算法的性能了。但在这之前,先思考一个问题:评价一个检测算法的性能,真的像想象中那么容易吗?
我们都知道,评价一个图像分类结果的性能,只需要看预测类别是否正确即可,在一个数据集上面,我们可以很容易地得出一个平均准确率。可是目标检测的输出目标数量和真实目标数量都是不固定的(前文提到的非结构化的特性),因此评判时要考虑的就不仅是“对错”这么简单了,我们需要考虑的有:如果漏掉了一个目标对性能有多大损伤?如果多检测出了一个目标对性能有多大损伤?如果检测出来的位置信息有所偏差对性能有多大损伤?进一步地,在这么多的检测结果中,总有一些是检测器十分笃定的,有一些是模棱两可的。如果检测器对多检测出来的那个目标本身也不太确定呢?如果检测器最满意最信任的那个检测结果出错了呢?换言之:一个检测结果对性能的影响,是否应该和检测器对它的满意程度(置信度)相关?以及,检测错了一个稀有的物体和检测错了一个常见的物体所带来的性能损伤是否应该相同?......
正戏来了:mmAP
刚刚提到的所有问题,mmAP都要一一给出答案。
首先是位置偏差问题。有的使用场景对位置的准确度要求不高,有的则要求精确定位。因此,mmAP先按位置准确度的需求进行划分,设置一组IOU阈值,这组阈值为 (0.5, 0.55, 0.6, ..., 0.9, 0.95),如果DT与GT的IOU超过阈值,则视作检测成功。这样每给定一个阈值就可以计算出一个性能(也就是mAP,后面详述),然后对这些性能取平均(也就是mmAP,后面详述)就是整个检测算法的性能了。
然后是类别平衡问题,这一问题在分类领域非常常见,“将一个白血病患者错分为健康的人“和“将一个健康的人错分为白血病患者“是一样的吗?显然不是,因为白血病患者本身就属于少数,如果一个分类器把所有人都无脑地判断为健康,其正确率就是 健康的人/全部人。这个分类器的正确率很高但是完全失去了判断病患的功能。mmAP为了公平的评价检测器在各个类别上的性能,采用了类别间求平均的方法:先给定一个IOU阈值,然后将所有的GT和DT按照类别先进行划分,用同一类的所有GT和DT计算出一个性能(也就是AP,马上详述),然后对所有类别的性能取平均(mAP),就是检测算法在这个IOU阈值下的性能。
现在我们来看看,给定了一个IOU阈值、并给定了一个类别,如何具体地计算检测的性能。首先,我们要先对所有的检测结果排序,得分越高的排序越靠前,然后依次判断检测是否成功。将排序后的所有结果定义为DTs,所有同类别的真实目标定义为GTs。先依序遍历一遍DTs中的所有DT,每个DT和全部GT都计算一个IOU,如果最大的IOU超过了给定的阈值,那么视为检测成功,算作TP(True Positive),并且最大IOU对应的GT被视为匹配成功;如果该DT与所有GT的IOU都没超过阈值,自然就是FP(False Positive);同时,每当一个GT被检测成功后,都会从GTs中“被取走”,以免后续的检测结果重复匹配。因此如果有多个检测结果都与同一个GT匹配,那么分数最高的那个会被算为TP,其余均为FP。遍历完成后,我们就知道了所有DTs中,哪些是TP,哪些是FP,而由于被匹配过的GT都会“被取走”,因此GTs中剩下的就是没有被匹配上的FN(False Negative)。以下是为了方便理解的代码(Python),这段代码仅用于理解,效率较低。真实代码请参考MS COCO的官方源码。
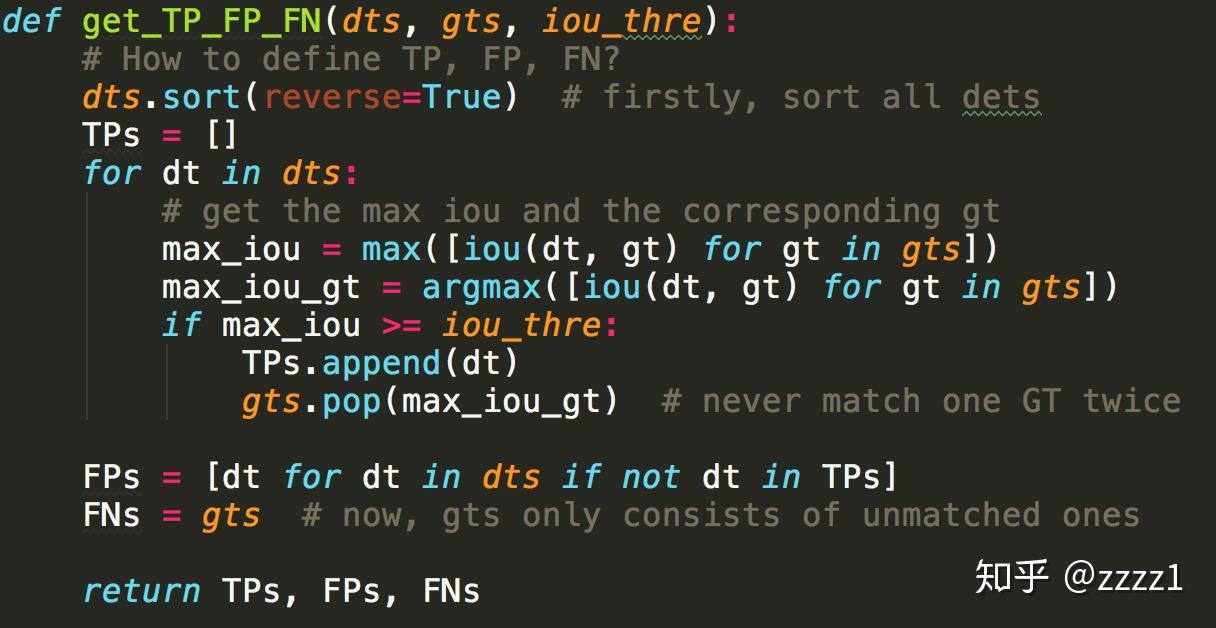 TP,FP,FN
有了TP、FP、FN的定义,就可以方便地得出准确率(Precison,P,即所有的检测结果中多少是对的)和召回率(Recall,R,即所有的真实目标中有多少被检测出来了),两者的定义分别为:P = TP / (TP + FP), R = TP / (TP + FN) = TP / len(GTs)。
但是,单纯地用Precision和Recall来评价整个检测器并不公平,因为有的检测任务要求更高的Recall,“错检”几个影响不大;有的检测任务则要求更高的Precision,“漏检”几个影响不大。因此我们需要对Precision和Recall做一个整体的评估,而这个评估就是前文提到的AP(Average Precision),其定义非常简单,对排序好的det结果进行“截取”,依次观察det结果的前1个(也就是只有第一个结果)、前2个、...、前N个,每次观察都能够得到一个对应的P和R,随着观察数量的增大,R一定会变大或不变。因此可以以R为横轴,P为纵轴,将每次的“截取”观察到的P和R画成一个点(R,P)。值得注意的是,当“截取”到的新结果为FP时,因为R没有变化所以并不会有新的(R,P)点诞生。最后利用这些(R,P)点绘制成P-R曲线,定义: AP = \int_{0}^{1}PdR 。通俗点讲,AP就是这个P-R曲线下的面积。AP计算了不同Recall下的Precision,综合性地评价了检测器,并不会对P和R有任何“偏好”,同时,检测分数越高的结果对AP的影响越大,分数越低的对AP的影响越小。
我们再重新过一遍计算方法:给定一组IOU阈值,在每个IOU阈值下面,求所有类别的AP,并将其平均起来,作为这个IOU阈值下的检测性能,称为mAP(比如mAP@0.5就表示IOU阈值为0.5时的mAP);最后,将所有IOU阈值下的mAP进行平均,就得到了最终的性能评价指标:mmAP。
值得注意的一个细节是:在实际计算时,mmAP并不会把所有检测结果都考虑进来,因为那样总是可以达到Recall=100%,为了更有效地评价检测结果,mmAP只会考虑每张图片的前100个结果。这个数字应该随着数据集变化而改变,比如如果是密集场景数据集,这个数字应该提高。
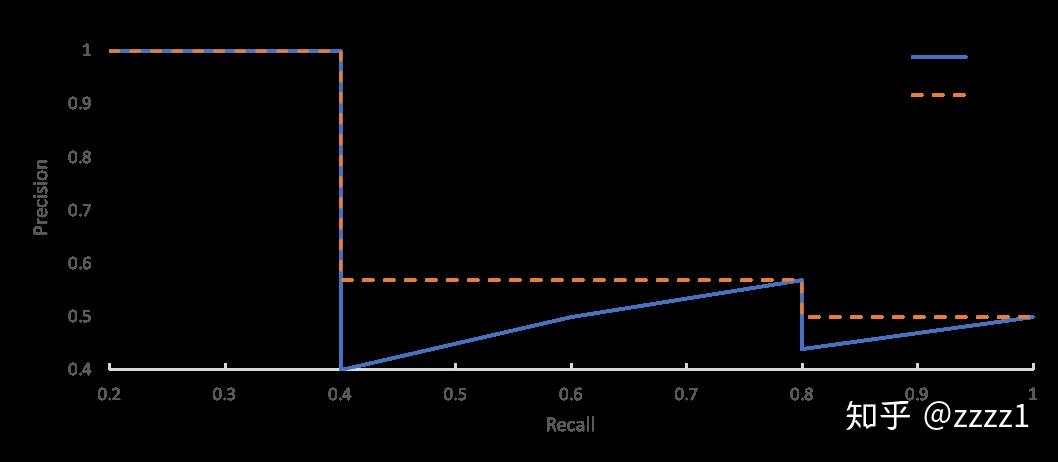
还有一个细节非常重要:刚才说AP是P-R曲线下的面积,其实这个说法并不准确。实际上在计算AP时,都要对P-R曲线做一次修正,将P值修正为当R>R0时最大的P(R0即为该点对应的R),即 AP=\int_{0}^{1}max({\left\{ P(r) | r \geq R \right\}})dR 。下图即为修正前P-R曲线和修正后P-R曲线。
 P-R curve
如图,蓝色实曲线为原始P-R曲线、橘色虚曲线为修正后P-R曲线。为什么要修正P-R曲线呢?这是因为评价检测性能时,更应该关心“当R大于某个值时,能达到的最高的P是多少”、而不是“当R等于某个值时,此时的P是多少”。
除了AP、mAP、mmAP之外,还有一个重要的性能是Recall,有时我们也需要关心“检测器能达到的最大Recall是多少?尽管此时的Precision可能非常低”,AR就是度量Recall的。每给定一个IOU阈值和类别,都会得到一个P-R曲线,该曲线P不为0时的最大的R,就称为该IOU阈值下该类别的Recall(其实是“最大Recall”),在类别尺度上平均后,就是该IOU阈值下的AR,通常我们会用AR[0.5:0.95]表示所有IOU阈值下AR的平均值(也就是mAR)。值得注意的是,AR并不是和mmAP同等量级的性能度量指标,因为AP综合考虑了P和R,而AR只是考虑了Recall。计算AR通常是用于帮助我们分析检测器性能特点的。在两个检测结果的mmAP相同时,更高的AR并不意味着更好的检测效果,而仅仅意味着“更扁平的P-R曲线”(可自行脑补该曲线)。
本文上篇完。
关于mmAP的其他特点,及在这些特点的基础上怎样理解“为何有些论文会涨点”,以及mmAP局限等内容,且听本文下回分解:浅析经典目标检测评价指标--mmAP(二)
PS:旷视南京研究院全职、实习岗位持续open,欢迎推荐、自荐,简历请发送至南京研究院负责人:songrenjie@megvii.com
编辑于 2021-03-22 08:04
计算机视觉
目标检测
深度学习(Deep Learning)
赞同 52063 条评论1008 41
分享
申请转载
 未登录用户
63 条评论
默认
最新
 xxyp
认真读了您的文字,受益匪浅,醍醐灌顶,谢谢您!
2019-02-20
回复7
展开其他 1 条回复
 驾雾
感谢您的分享。有个地方有点疑问:如果一个GT与两个DT的iou都超过了阈值,而在遍历时,首先遍历到iou较小的DT,这样结果不是就不够准确了吗?
2019-03-01
回复2
 zzzz1
作者
这个结果的不准确并不是评价指标造成的,而是检测器本身性能不好造成的。给好的检测结果打低分本身就是一种性能差的体现。在使用检测器时,通常是卡一个分数阈值,要么都保留要么滤掉低分的,并不会出现保留低分滤掉高分的情况,因此评价和匹配都需要按分数排序。
2019-03-02
回复2
展开其他 2 条回复
 AIer 蓝蒂斯
目前见过讲的最清楚的,赞!
2023-03-24
回复1
 大魔导师
多张图片的mmAP怎么算?将每张图片的mmAP分别求出来然后取平均吗?还是说在计算时要考虑所有图片的gts和dts?
2020-07-17
回复3
展开其他 1 条回复
 为啥非得取个名
每给定一个阈值就可以计算出一个性能(也就是mAP,后面详述)
先给定一个IOU阈值,然后将所有的GT和DT按照类别先进行划分,用同一类的所有GT和DT计算出一个性能(也就是AP,马上详述)
楼主你的表述前后不一致啊,给定一个IOU阈值,能够确定mAP,还是AP,按照我的理解,一个IOU阈值只能确定一对(P,R)值,也就是P-R曲线上的一个点,不能得到mAP,也不能得到AP
2019-07-08
回复1
展开其他 1 条回复
 泡泡糖
P = TP / (TP + FP) 是不是就P = TP / (TP + FP)=TP/DTs呢?
2019-04-03
回复1
zzzz1
作者
对的
2019-04-03
回复喜欢
展开其他 1 条回复
 柏拉图爱唠叨
文中“因此如果有多个检测结果都与同一个GT匹配,那么分数最高的那个会被算为TP,其余均为FP。”我认为是一个悖论。计算IoU时是按照置信度分数排序从上至下计算的,当分数高的DT匹配上GT时,GT会从GTs中取走。置信度分数低的DT在计算IoU时,GTs里面已经没有所谓的“同一个GT”了。
2025-04-17
回复喜欢
 开心锤锤
iou是不是就是置信度啊
2021-07-28
回复喜欢
 luo13
你好,非常感谢您的分享,但有一个小小的疑惑,为什么最后一个图中,蓝线P会有0的情况
2020-08-14
回复喜欢
tyler tang
“值得注意的是,当“截取”到的新结果为FP时,因为R没有变化所以并不会有新的(R,P)点诞生。”
这句话有问题吧, R没变化P会降低啊?可能对修正后的RP曲线还有点意义
2020-08-08
回复喜欢
点击查看全部评论
未登录用户
关于作者
zzzz1
回答 11 文章 2 关注者 649
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 机器学习算法评估指标——2D目标检测 格物钛发表于技术分享
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码