 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
多语言SFT可以显著提高LLM数学推理能力
首发于paper
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
多语言SFT可以显著提高LLM数学推理能力
首发于paper
切换模式
 promise
港科phd,nlp
收录于 · paper
13 人赞同了该文章
目录
论文标题
 论文链接
 Breaking Language Barriers in Multilingual Mathematical Reasoning: Insights and Observationsarxiv.org/abs/2310.20246
代码链接
https://mathoctopus.github.io/mathoctopus.github.io/
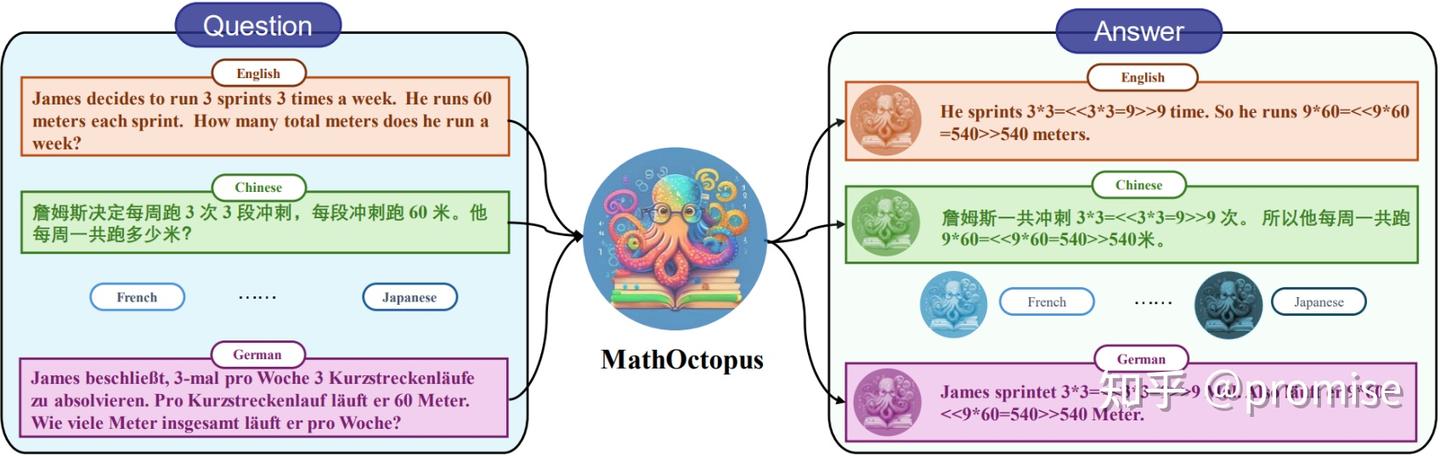
近来,不少研究工作都集中于如何通过instruction tuning的方式来提高大模型(LLMs)的复杂数学推理能力。但是,这些基于的LLMs研究基本都集中于单语言,如何训练一个多语言数学推理大模型依然丞待解决。 因此,在这篇论文中研究者们基于LLaMA探索并构建了一系列的多语言数学推理大模型:MathOctopus 。MathOctopus不仅可以广泛地提高LLMs在多语言上推理的平均性能,而且与单语训练的模型相比在其对应的语言测试中依然可以取得更加优越的表现。 本文的主要贡献如下:
经过大量的实验,本文总结出以下结论:
在多语言数学推理任务中,面临的问题是在low-resource语言中缺乏相应高质量的训练数据集,为此,本文使用ChatGPT将英文的GSM8K数据集翻译成多种语言,其中包括孟加拉语(Bn),中文(Zh),法语(Fr),德语(de),日语(Ja),俄语(Ru),西班牙语(Es),斯瓦希里语(Sw)和泰语(Th),并对翻译后的语料进行校对,确保数据的质量。基于此,构建了MGSM8KInstruct多语言数学推理训练数据集。
| Language | Prompt | Question | Answer |
| --- | --- | --- | --- |
| English | Below is an instruction that describes a task. Write a response that appropriately completes the request in English. Please answer in English. | Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May? | The number of clips sold in April is 48/2 = <<48/2=24>>24.\nNatalia sold 24 + 48 = <<24+48=72>>72 clips altogether in April and May. |
| Bengali | Below is an instruction that describes a task. Write a response that appropriately completes the request in Bengali. Please answer in Bengali. | নাতালিয়া এপ্রিল মাসে 48 জন বন্ধুদের ক্লিপ বিক্রি করেছিলেন, এবং তারপরে মে মাসে সে অর্ধেক ক্লিপ বিক্রি করেছিলেন। নাতালিয়া এপ্রিল এবং মে মাসে মোট কতগুলি ক্লিপ বিক্রি করেছিলেন? | নাতালিয়া মে মাসে 48/2 = <<48/2=24>>24 টি ক্লিপ বিক্রি করেছিলেন।\nনাতালিয়া এপ্রিল এবং মে মাসে মোট 48 + 24 = <<48+24=72>>72 টি ক্লিপ বিক্রি করেছেন। |
| Language | Prompt | Question | Answer |
| --- | --- | --- | --- |
| English | Below is an instruction that describes a task. Write a response that appropriately completes the request in English. Please answer in English. | Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May? | The number of clips sold in April is 48/2 = <<48/2=24>>24.\nNatalia sold 24 + 48 = <<24+48=72>>72 clips altogether in April and May. |
| Bengali | Below is an instruction that describes a task. Write a response that appropriately completes the request in Bengali. Please answer in Bengali. | Natalia sold clips to 48 of her friends in April, and then she sold half as many clips in May. How many clips did Natalia sell altogether in April and May? | নাতালিয়া মে মাসে 48/2 = <<48/2=24>>24 টি ক্লিপ বিক্রি করেছিলেন।\nনাতালিয়া এপ্রিল এবং মে মাসে মোট 48 + 24 = <<48+24=72>>72 টি ক্লিপ বিক্রি করেছেন। |
在这篇文章中,使用了ChatGPT将英文的GSM8K训练集和他们对应的 chain-of-thought (COT)回答翻译成了十种语言。为了保证翻译的质量,本文在翻译时使用的提示词(prompt)中遵循以下规则:
下面是完整的翻译提示词
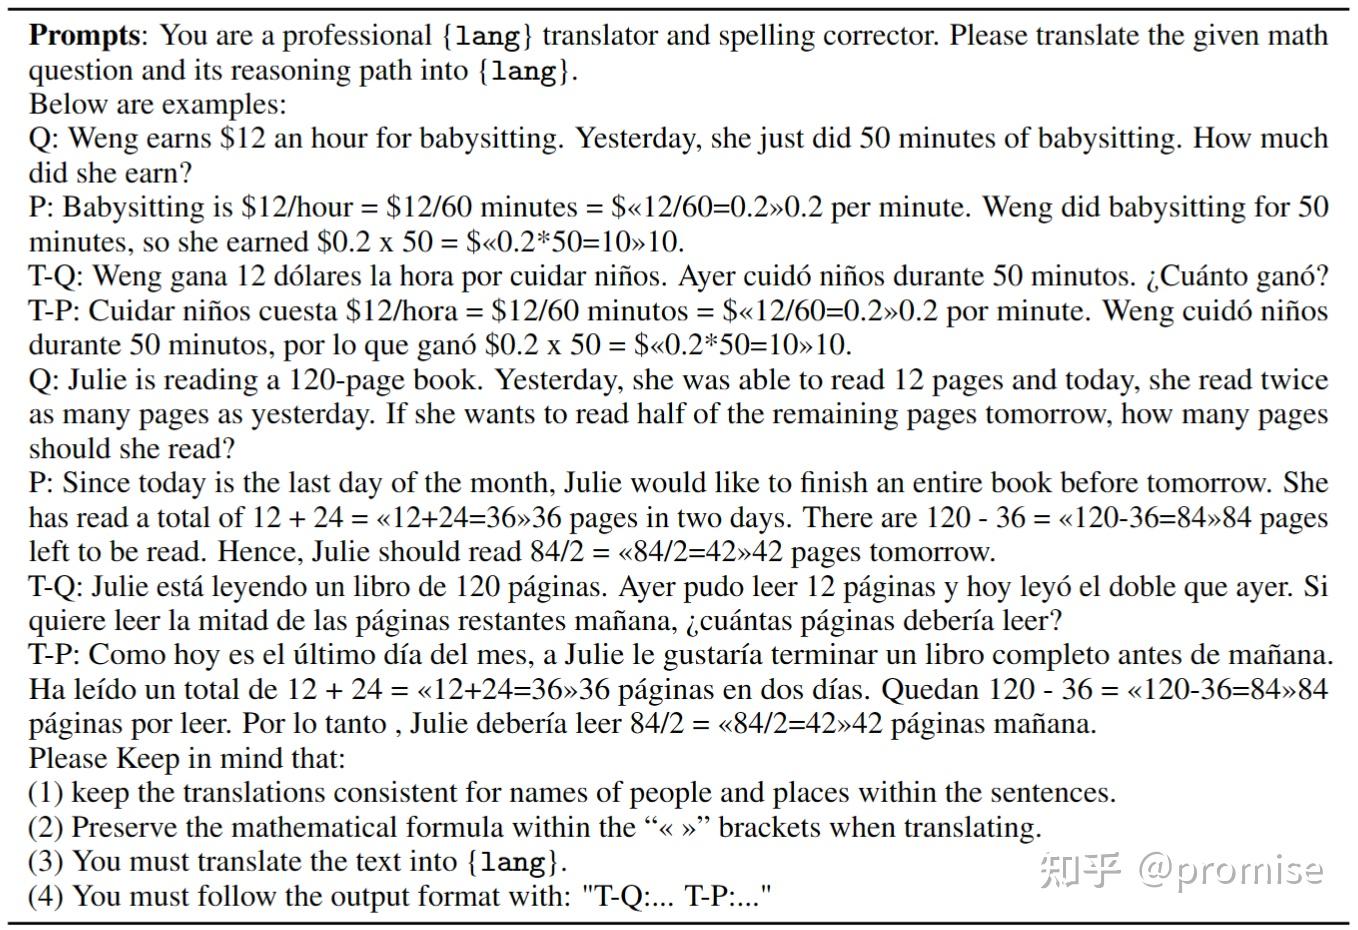
在翻译问题与答案后,ChatGPT生成的句子通常没有语言翻译错误,但存在数学公式在翻译前后不一致的情况。为了确保翻译前后的准确性,本文采取了以下做法,首先,提取翻译后答案中的所有数学公式,然后与原英文数据集中的公式进行比较,如果它们匹配,就认为翻译是准确的。如果某一数据连续五次出现翻译错误,将删除该数据。这样做有助于确保翻译的准确性。
为了更近一步测试当前LLMs在多语言数学推理任务上的鲁棒性,本文在现有的SVAMP数据集的基础上构建了out-of-domain(OOD)多语言数学推理测试集MSVAMP。
| Language | Prompt | Question | Answer |
| --- | --- | --- | --- |
| English | Below is an instruction that describes a task. Write a response that appropriately completes the request in English. Please answer in English. | julia played tag with 18 kids on monday . she played tag with 10 kids on tuesday . how many more kids did she play with on monday than on tuesday ? | 8.0 |
| Bengali | Below is an instruction that describes a task. Write a response that appropriately completes the request in Bengali. Please answer in Bengali. | জুলিয়া সোমবার ১৮ জন ছেলেমেয়ের সঙ্গে ট্যাগ খেলেন। মঙ্গলবার তিনি ১০ জন ছেলেমেয়ের সঙ্গে ট্যাগ খেলেন। সোমবার তিনি কতজন ছেলেমেয়ের সঙ্গে আরও খেলেন তার সংখ্যা কত? | 8.0 |
由于这个数据集的答案只包含最终的数字答案而不包括chain-of-thought(COT)过程,所以我们使用google翻译系统仅对问题进行翻译,本文将SVAMP测试集中1000条数据翻译成和训练集中对应的语言。
为了确保翻译的质量:首先,翻译后的句子再次被翻译回英文,以检查是否存在翻译上的差异。此外,还有三名专业的人员对翻译前后的意思是否一致进行了审查,进一步确保翻译的准确性。
本文基于MGSM8KInstruct,为了让模型拥有更多样化的能力,本文提出了两种不同的训练方式。 - 为了使模型更好地理解问题与答案,本文提出的第一种方法是parallel-training,即问题与回答是相同的语言。 - 为了帮助模型融汇贯通不同的语言,本文提出的第二种方法是cross-training,即问题是英语,回答是别的语言,这可以使模型更好地解决多语言问题。
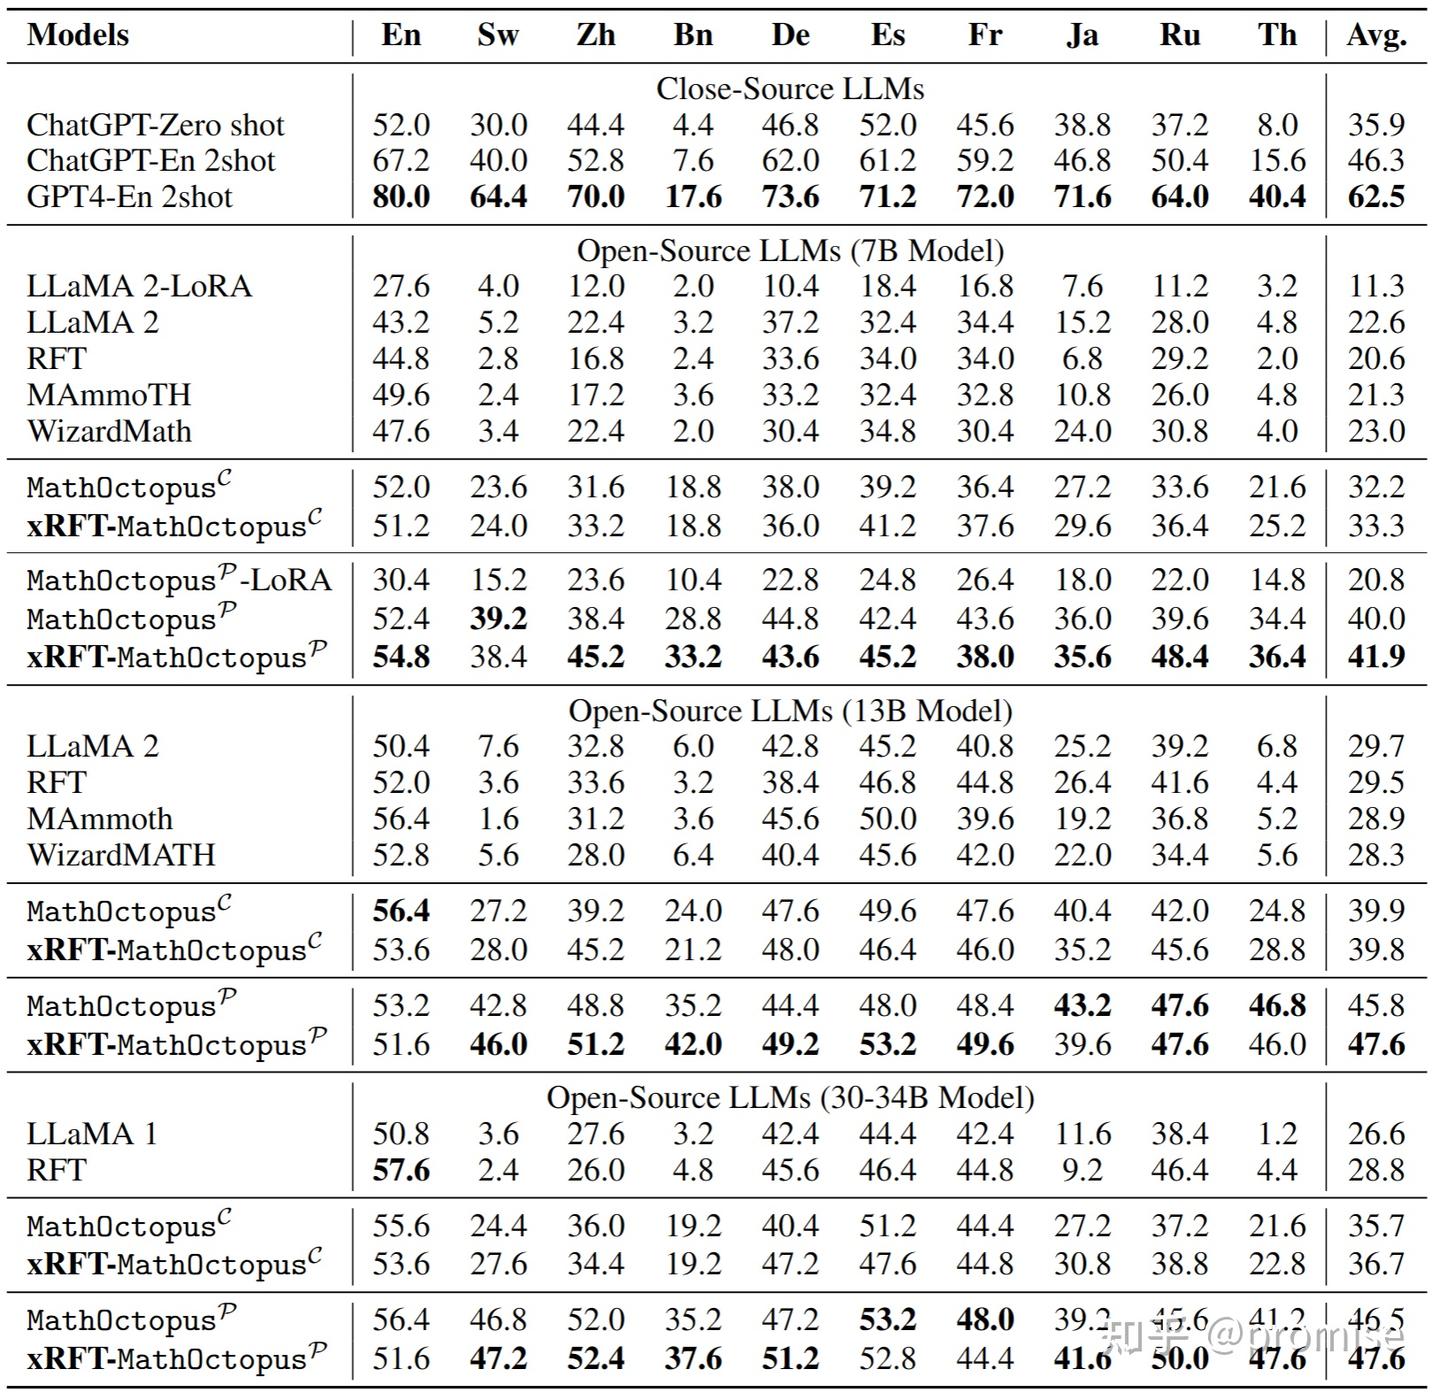
下图是模型在MGSM测试集上的表现,MathOctopusP 和 MathOctopusC 指的是模型训练方式分别为parallel-training和cross-training,xRFT 指的是多语言数学推理的拒绝采样,LLaMA 指的是只在英语GSM8K上训练,RFT 指的是在英语GSM8K上训练后,进行拒绝采样。
下图是模型在MGSM测试集上的表现
下图是模型在MSVAMP测试集上的表现
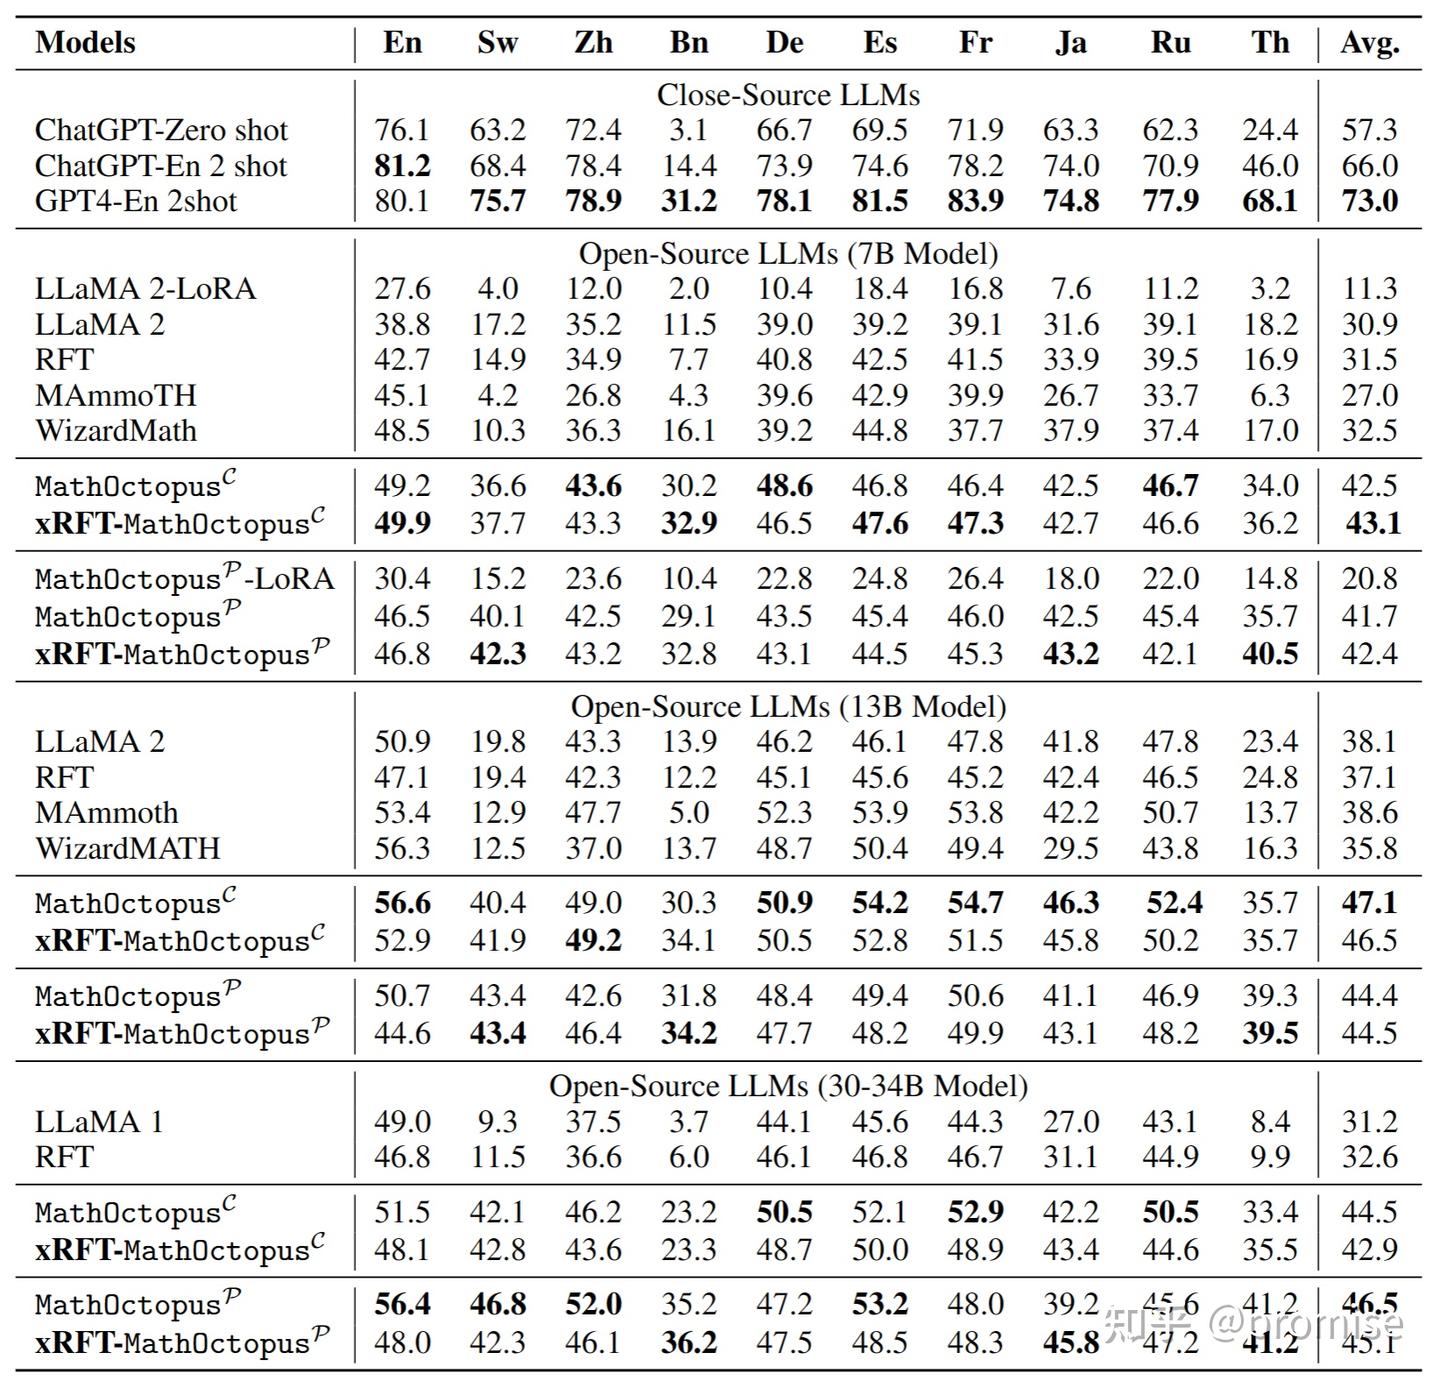
根据实验结果,本文有以下发现:
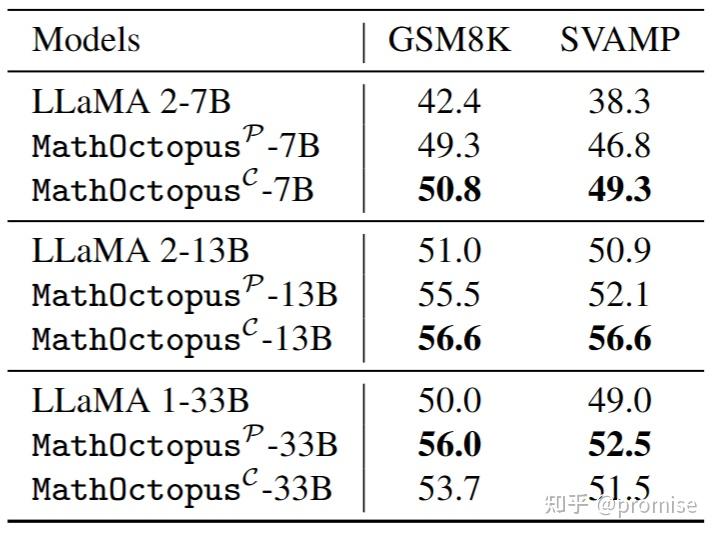 本文发现,和只在单语言上训练的LLMs相比,MathOctopus在英语数据测试中也取得了更好的效果。为了进一步探索在其他语言上是否有相同的现象,本文进行了以下实验:
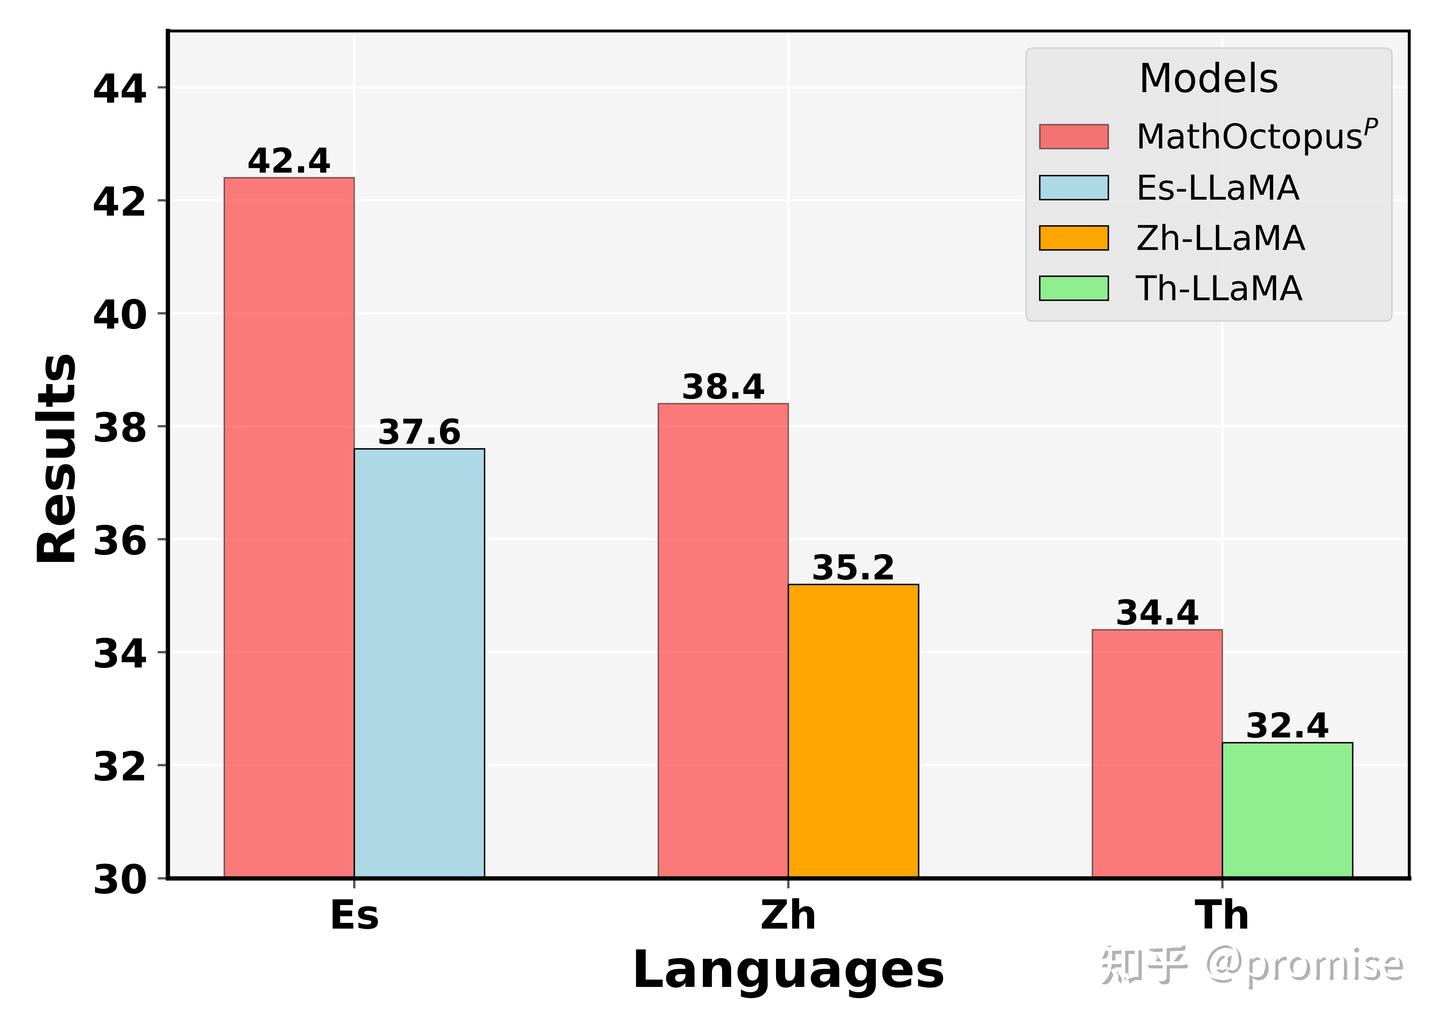
随机从训练集中挑选三种语言,分别是西班牙语,中文,泰语。使用它们对应的训练语料分别训练三个模型,分别命名为 ES-LLaMA ,CN-LLaMA ,Th-LLaMA 。下图展示了这几个模型在他们对应训练语言下的测试结果。由图可见,在单一语言上,MathOctopus的表现仍然超过了单语SFT模型的结果。这表明,在数学推理任务中,多语言训练比单语言训练有更好的效果。
有研究[1]表明,拒绝采样rejection sampling(RFT)可以大幅提升模型的表现。为了探究在多语言训练的场景下拒绝采样对模型的提升效果,本文在得到多语言SFT模型后,采样模型在MGSM8KInstruct数据集上的推理结果,对采样到的推理过程进行验证,如果符合要求则将其并入到原本的数据集。具体做法如下:
 本文发现,通过多语言拒绝采样(xRFT)增加的数据对模型的提升效果有限,主要表现在以下几点: - 在MGSM测试集上,多语言拒绝采样只能提升MathOctopusP模型1%-2%的效果。 - 在MSVAMP测试集上,多语言拒绝采样的提升效果不到1%。 - 多语言拒绝采样对MathOctopusC的提升效果更小,在MGSM数据集上的表现反而有所下降。
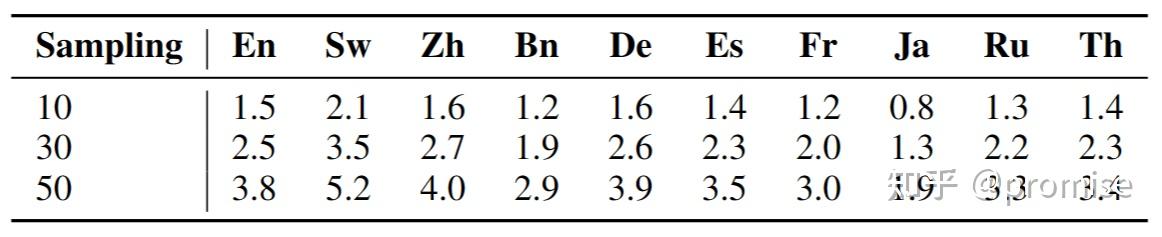
为了探究xRFT生成的数据量对模型的影响,本文在三个不同的采样次数(10,30,50)下分别探究对应的模型在测试集上的表现。
下图是不同采样次数下模型在MGSM数据集上的表现
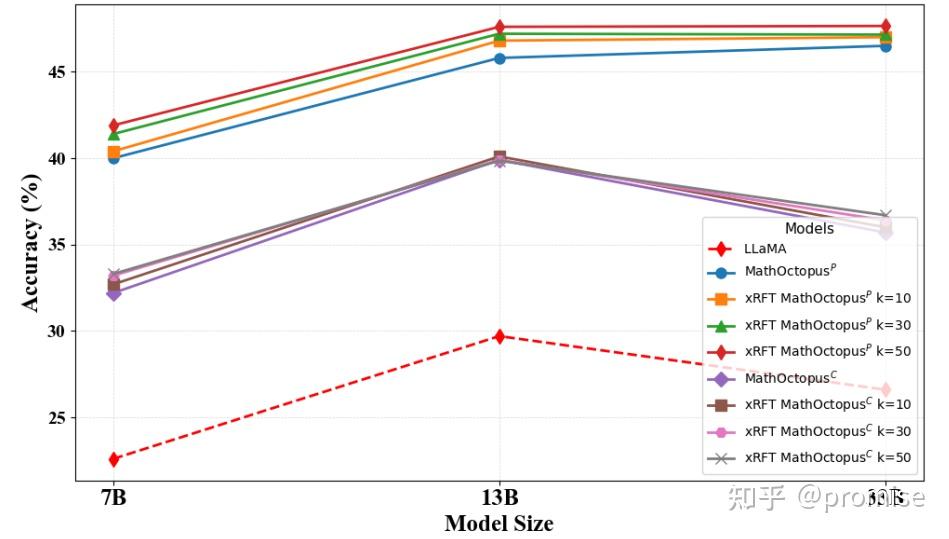 下图是不同采样次数下模型在MSVAMP数据集上的表现
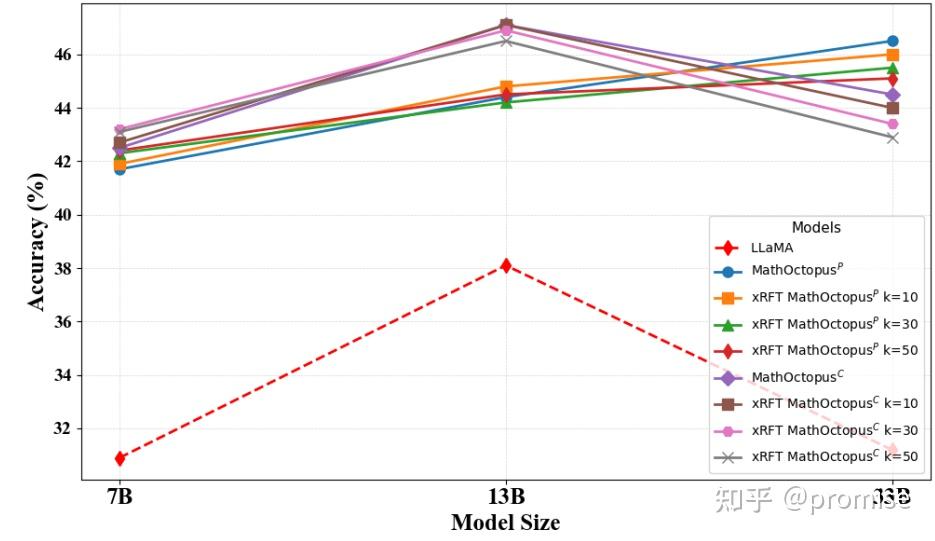 可以发现,在MGSM测试集上,当拒绝采样的次数越多,训练语料越多时,MathOctopusP的表现也略微变好。与之相反,在MSVAMP数据集上,当拒绝采样的次数越多,训练语料越多时,MathOctopusC的表现反而有所下降。
本文最后提到了将来还可以在LLaMA2-70B的基础上探索更大的MathOctopus模型,除此之外,在这些更大的模型上使用多语言拒绝采样也是将来的研究点之一。由于MathOctopus只有十种训练语言,更多的训练语言是否会给模型带来更好的效果仍然有待研究。
[1] Yuan Z, Yuan H, Li C, et al. Scaling relationship on learning mathematical reasoning with large language models[J]. arXiv preprint arXiv:2308.01825, 2023.
[2] Luo H, Sun Q, Xu C, et al. Wizardmath: Empowering mathematical reasoning for large language models via reinforced evol-instruct[J]. arXiv preprint arXiv:2308.09583, 2023.
编辑于 2023-12-02 11:23・中国香港
开源大语言模型
指令微调
数学推理
赞同 13添加评论44 5
分享
申请转载
 未登录用户
还没有评论,发表第一个评论吧
关于作者
promise
港科phd,nlp
回答 22 文章 3 关注者 88
关注发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 R1相关:少量高质量数据SFT激活LLM推理能力 长琴发表于技术与人 ... # [推理加速] LLM推理加速的5大方案 零、总览LLM推理方向小结 https://www.bilibili.com/opus/1112295486312677381LLM推理优化分为以下几个方面: 分离部署服务:PD分离和KVCache并行化:数据并行、流水线并行、张量并行、序列… 平平无奇小熊猫 # Awesome LLM4Math:大语言模型(LLM)数学推理相关资源集锦 大语言模型(LLM)数学推理相关资源集锦,其中绝大部分经过 @天欲雪 筛选,确保质量较高,且添加了精心撰写的简要描述,以便读者尽快理了解相关要点。✨ 独家内容: 可能是全网最全面的复杂… 天欲雪发表于Aweso... # LLM理解能力提升研究 step-dpo:背景:普通DPO方法以单个样本为整体,在需要多个推理步骤才能解决问题的样本时,模型通过dpo训练难以学习到某一个步骤的推理正确性(示例:一个错误数学推理题样本中,前3个步骤… lucy9527
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码