 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
语义分割江湖的那些事儿——从旷视说起
首发于R4D
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
语义分割江湖的那些事儿——从旷视说起
首发于R4D
切换模式
 余昌黔
 华中科技大学 控制科学与工程博士
收录于 · BaseDetection
1195 人赞同了该文章
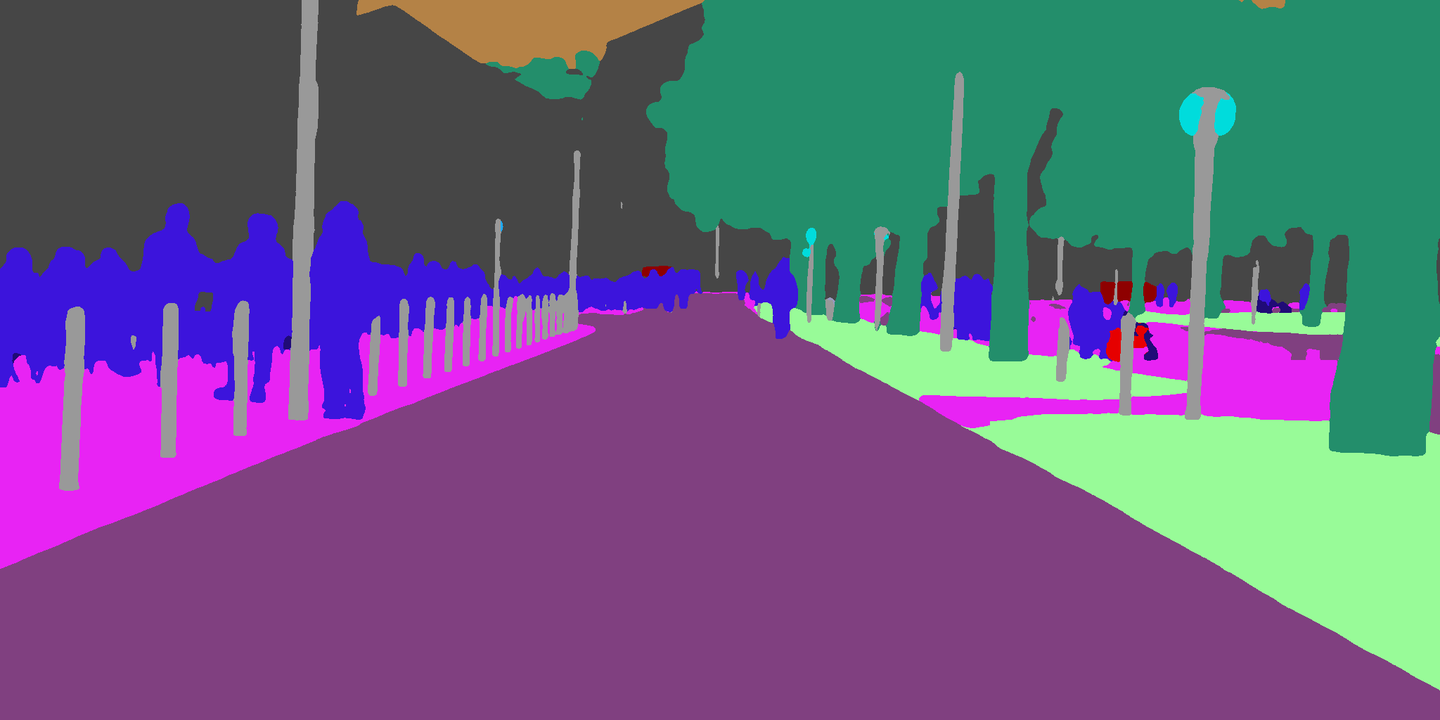
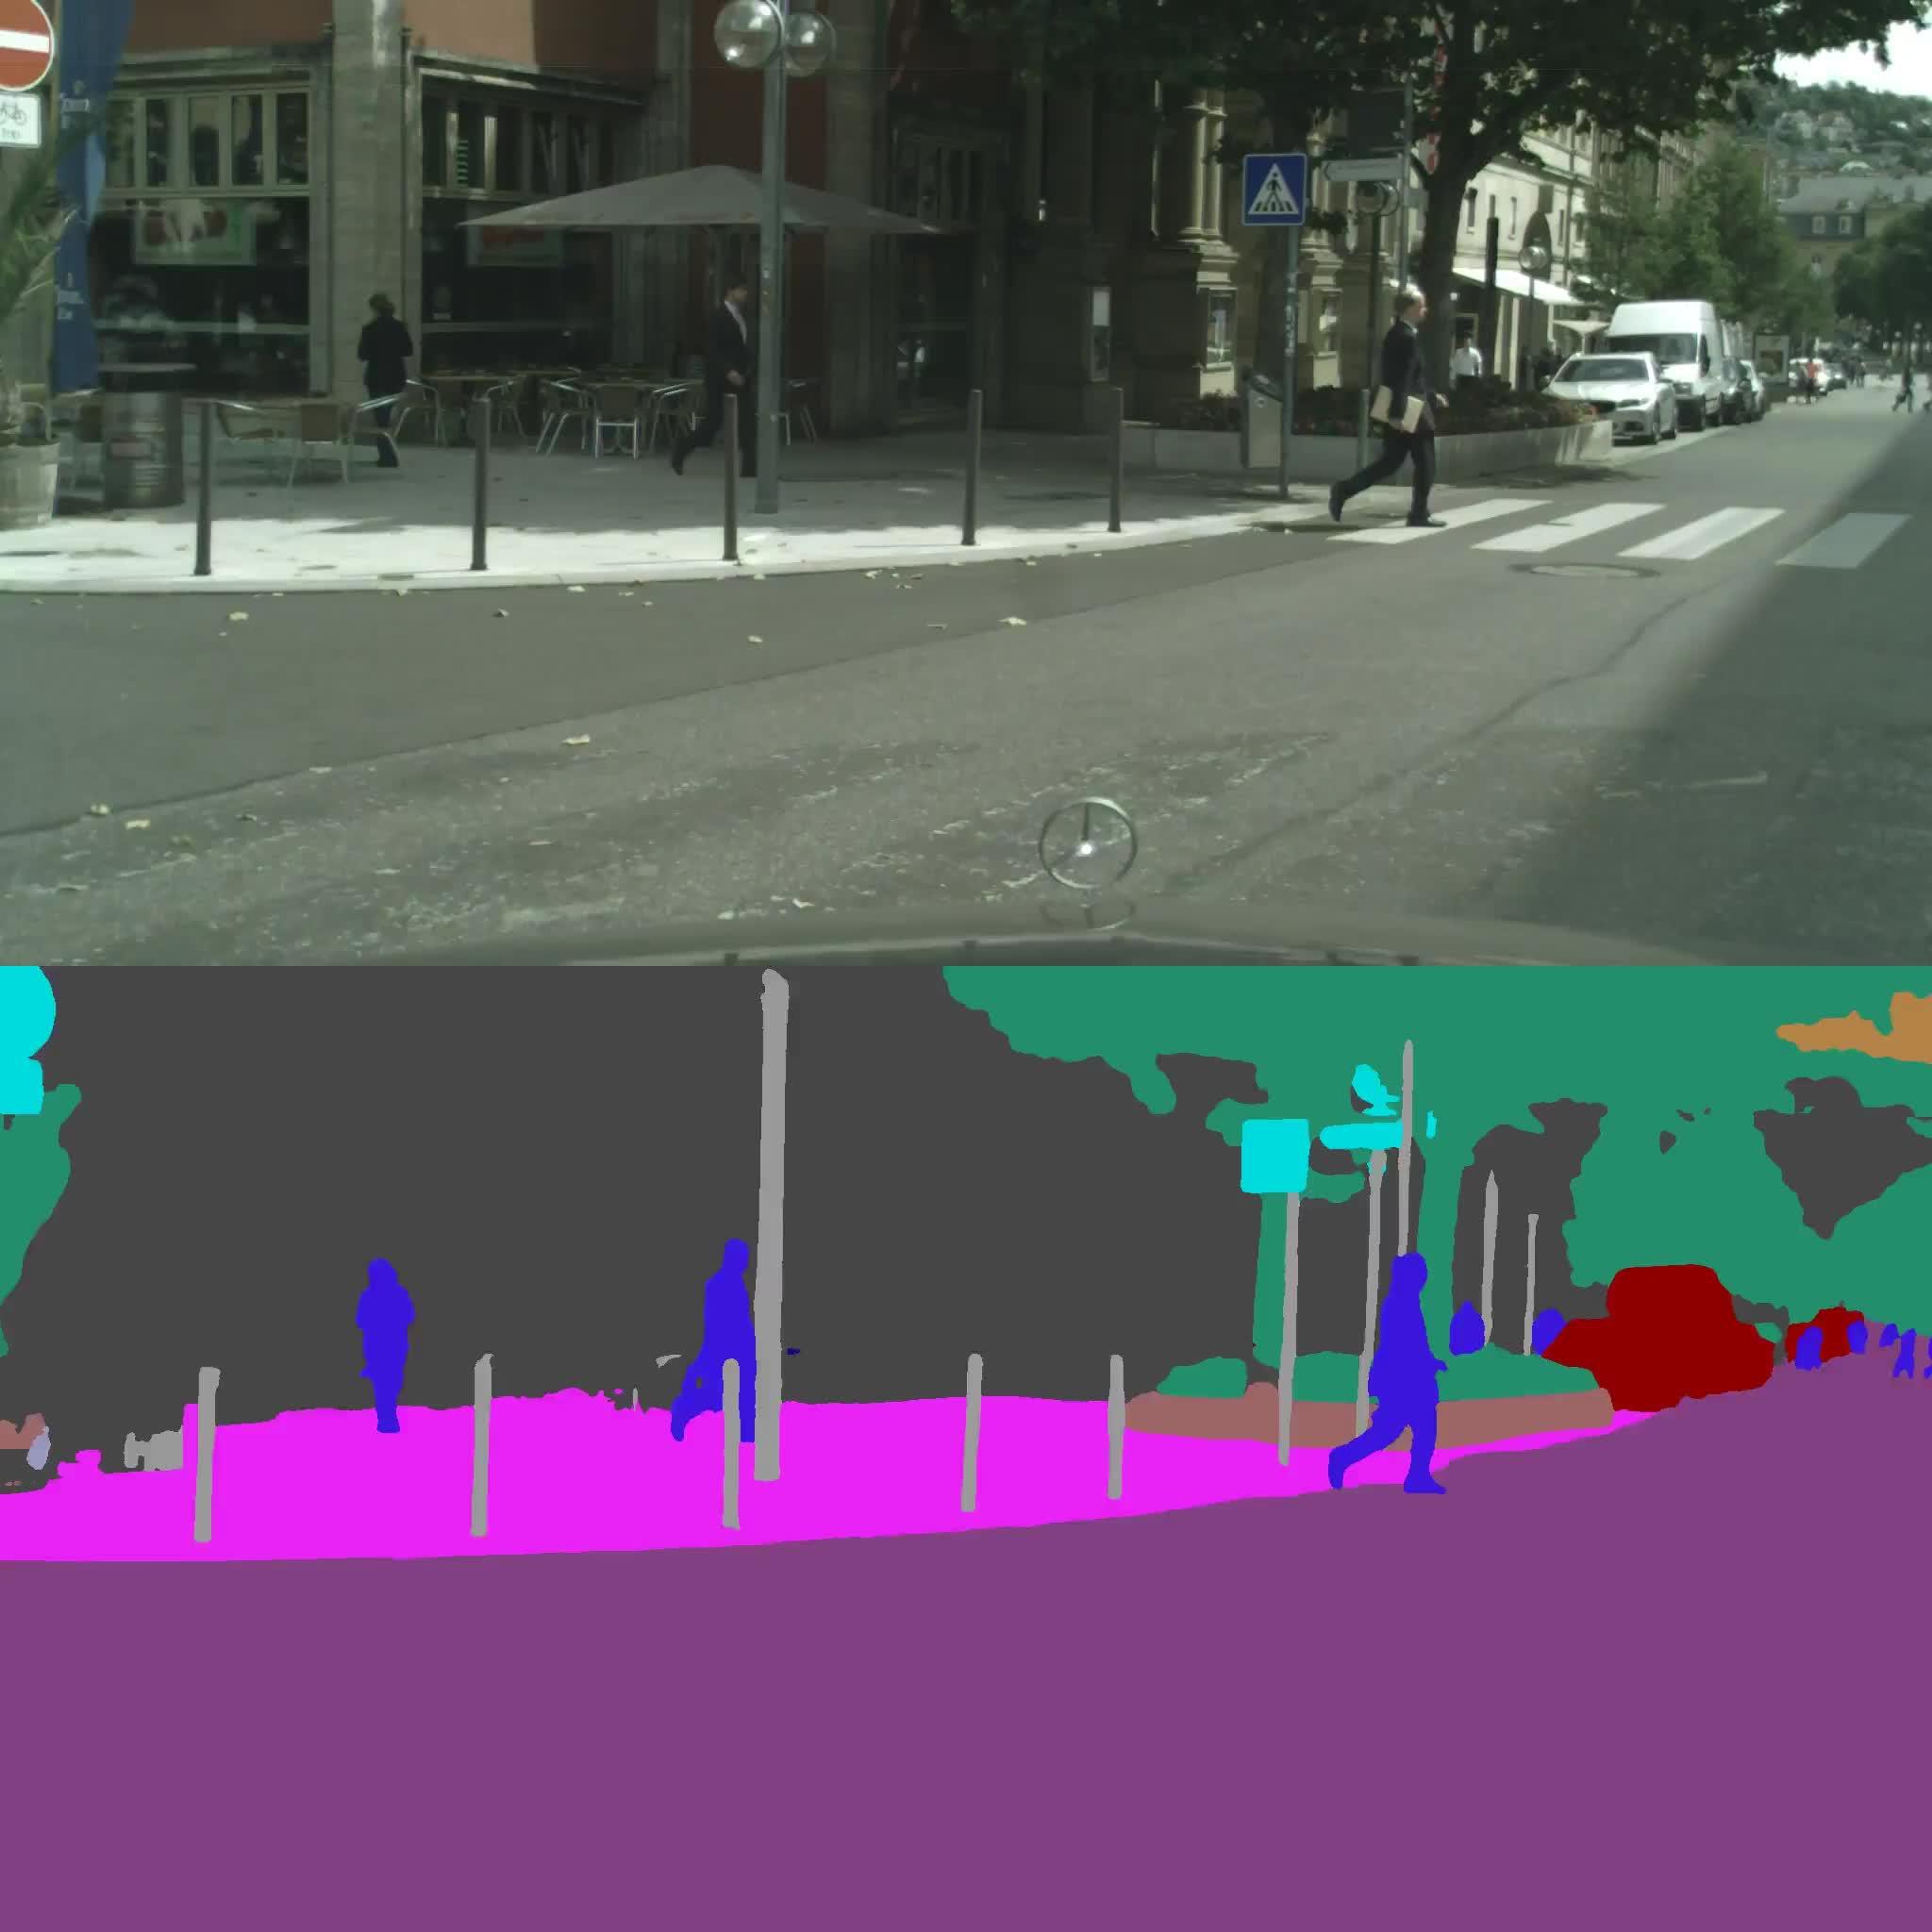
今天的主题是 Face++ Detection 组近两年持续在做的 Semantic Segmentation相关工作,代表性成果主要有 1)GCN (CVPR2017)、2)DFN (CVPR2018)、3)BiSeNet (ECCV2018)。我们先来看一段演示 Demo:
 00:40
CVPR2018 DFN算法结果展示
介绍算法之前,我们先简单回顾一下语义分割(semantic segmentation)的历史。众所周知,计算机视觉有三大核心任务——分类、检测、分割,三者号称是深度学习炼丹师的“三大浪漫”。分类针对整张图片,检测针对图片的局部,语义分割则如图1所示,旨在给输入图片上的每个像素赋予一个正确的语义标签。
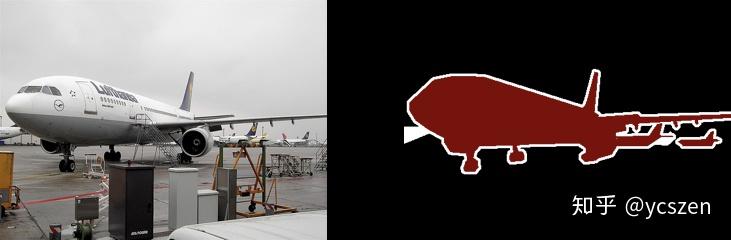 图 1:PASCAL VOC 2012 图片示例
传统的分割算法我们先按下不表。时间拨回到 2015 年,语义分割江湖之中,FCN 横空出世,自此 DL/NN 方法席卷了整个语义分割领域。短短几年,各个 Benchmark 的 state-of-the-art 不断刷新,成果喜人。
FCN 前期阶段,研究重点主要是解决“网络逐渐衰减的特征尺寸和需要原图尺寸的预测之间的矛盾”,换言之,就是如何解决网络不断 downsample 造成的信息损失;期间百家争鸣,百花齐放,涌现了希望保存或者恢复信息的 unpool、deconv 等方法,也出现了进行结构预测的各种花式 CRF 方法。
“大道之争”之中,碰撞出了两个最重要的设计:U-shape Structure 和 Dilation Conv,据此形成当下语义分割领域网络设计最常见的两大派系:1)U-shape 联盟以 RefineNet、GCN、DFN 等算法为代表;2)Dilation 联盟以 PSPNet、Deeplab 系列方法为代表;随着 Base Model 性能不断提升,语义分割任务的主要矛盾也逐渐渐演变为“如何更有效地利用 context”;这中间又是一番腥风血雨,我们今天介绍的 3 位主角也在其中贡献了一份力量。
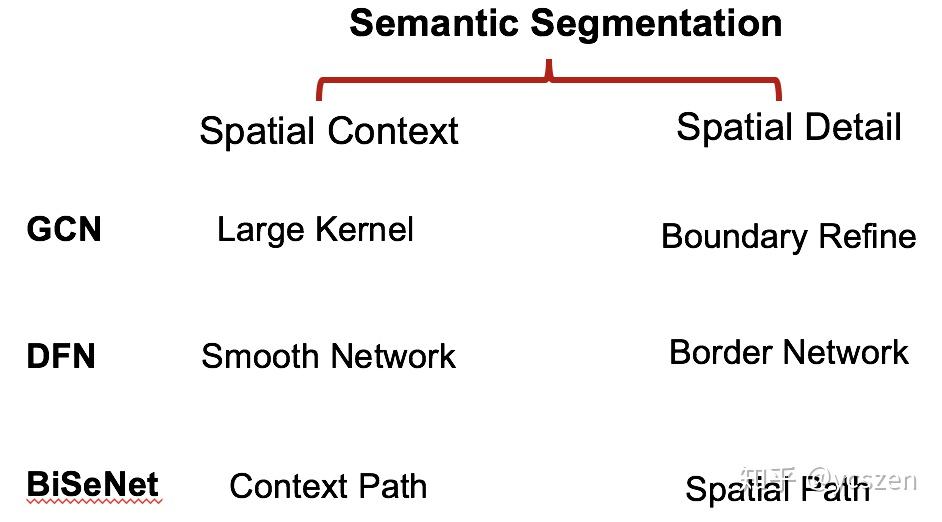
语义分割任务同时需要 Spatial Context 和 Spatial Detail 。今天我们介绍的三种算法都将从这两方面分别提出各自对应的解决方案。整体对比如下:
Global Convolutional Network
第一位主角是 CVPR2017 算法 Global Convolutional Network(GCN),江湖人送外号“Large Kernel”。论文 Arxiv 链接请见:https://arxiv.org/abs/1703.02719。
——Motivation——
GCN 主要将 Semantic Segmentation分解为:Classification 和 Localization两个问题。但是,这两个任务本质对特征的需求是矛盾的,Classification需要特征对多种Transformation具有不变性,而 Localization需要对 Transformation比较敏感。但是,普通的 Segmentation Model大多针对 Localization Issue设计,正如图2(b)所示,而这不利于 Classification。
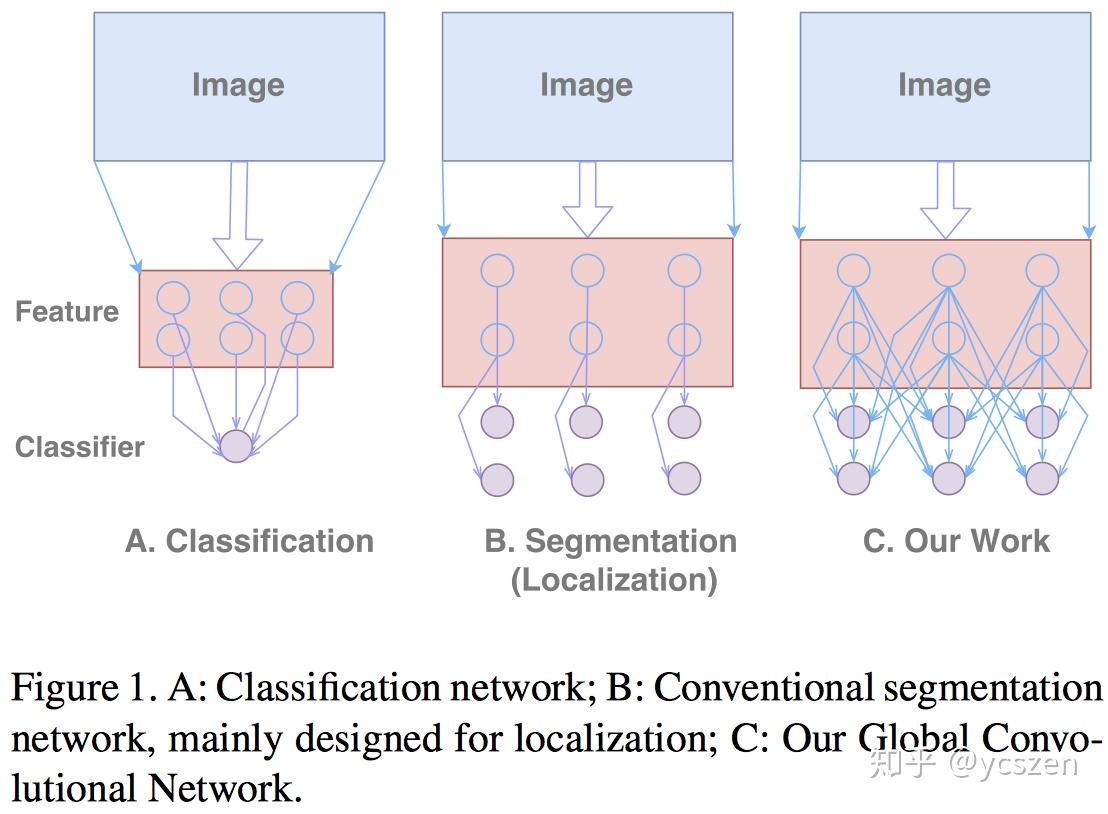 图2
所以,为了兼顾这两个 Task,本文提出了两个 Principle:
——网络结构——
根据这两条 Principle,本文提出了Global Convolutional Network(GCN)。如图3所示,这个方法整体结构正是背景介绍中提到的U-shape结构,其核心模块主要包括:GCN 和 BR。
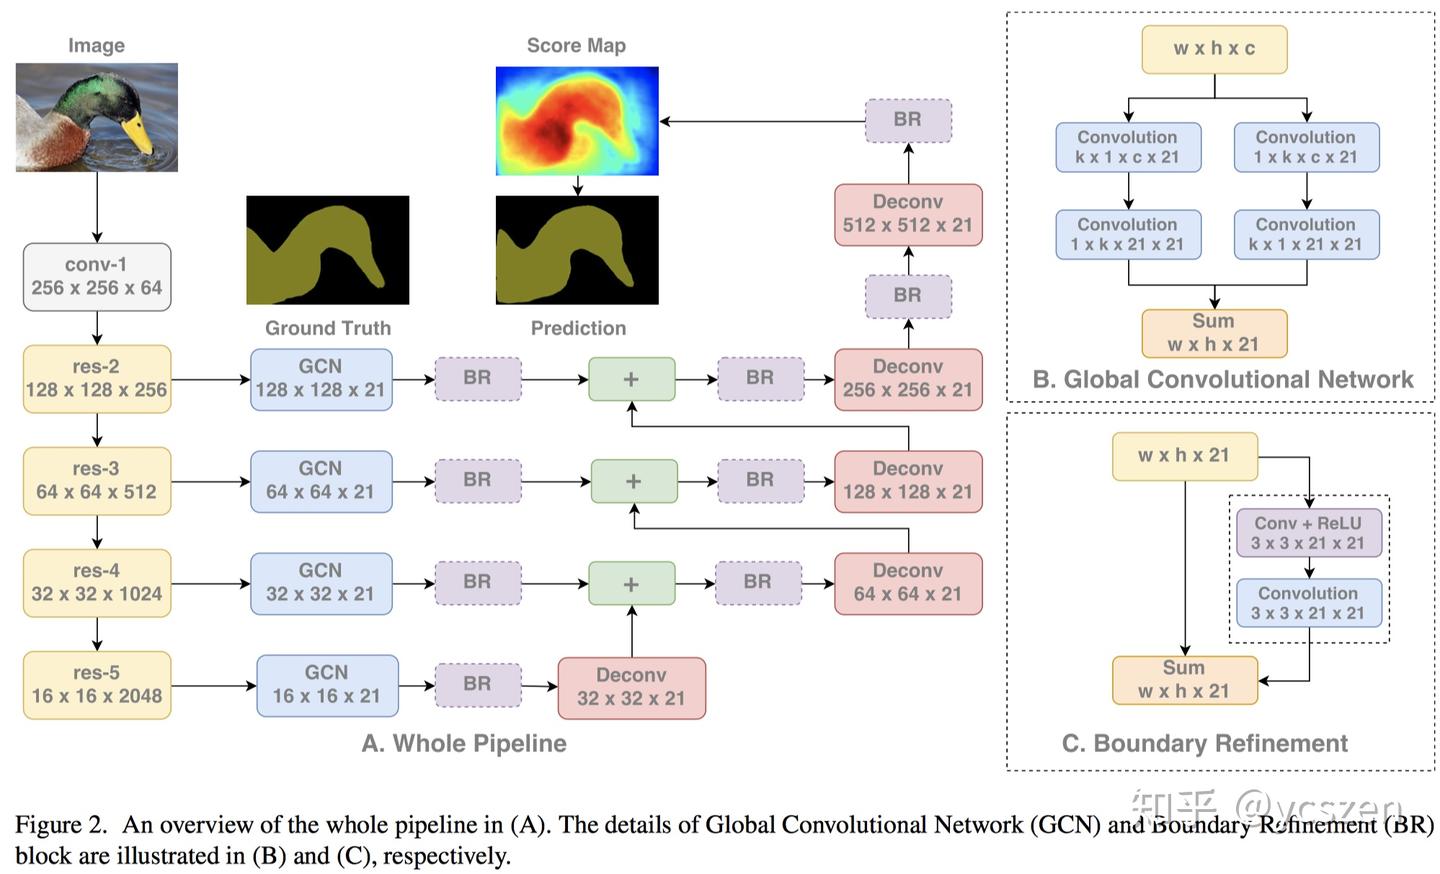 图3 网络结构
此处主要介绍GCN设计。正如图3(b)所示,它采用了较大 Kernel Size的卷积核,来同时解决上述的两个 Issue;然后根据矩阵分解,利用 1 \times k + k \times 1 和 k \times 1 + 1 \times k 的卷积来替代原来的 k \times k 大核卷积。相对于原本的大核卷积,该设计能明显降低参数量和计算量。图4可视化了 Large Kernel Conv 和 普通 Conv网络有效感受野的对比。
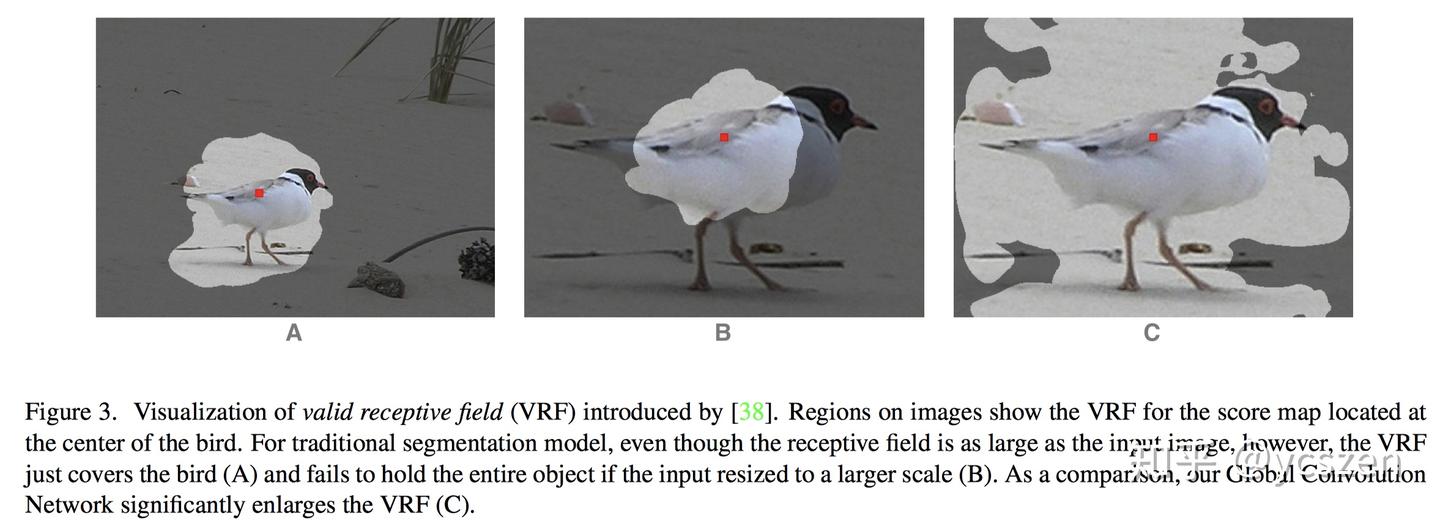 图4
可以看到,Large Kernel Conv 的有效感受野显著增大。
——实验——
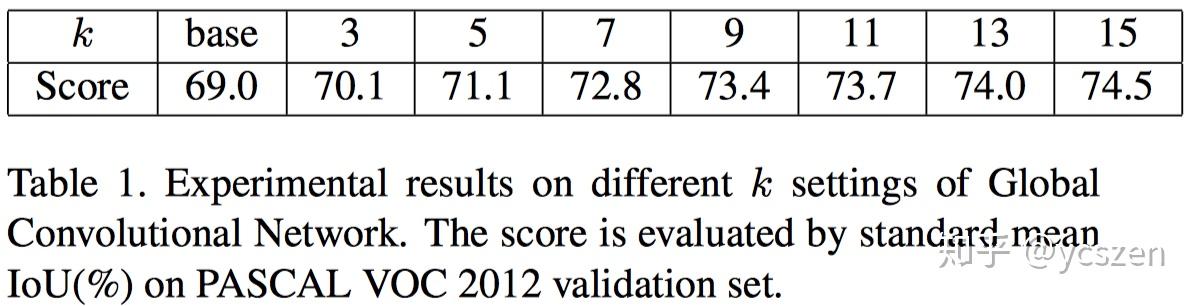
文中为了验证 Large Kernel Conv的有效性,对比了不同 Size的 Kernel,可以看到Kernel Size=15时比 Base Network整整高了 5.5% mean IoU.
 此外,文中还对 Large Kernel Conv 进行了一系列讨论。
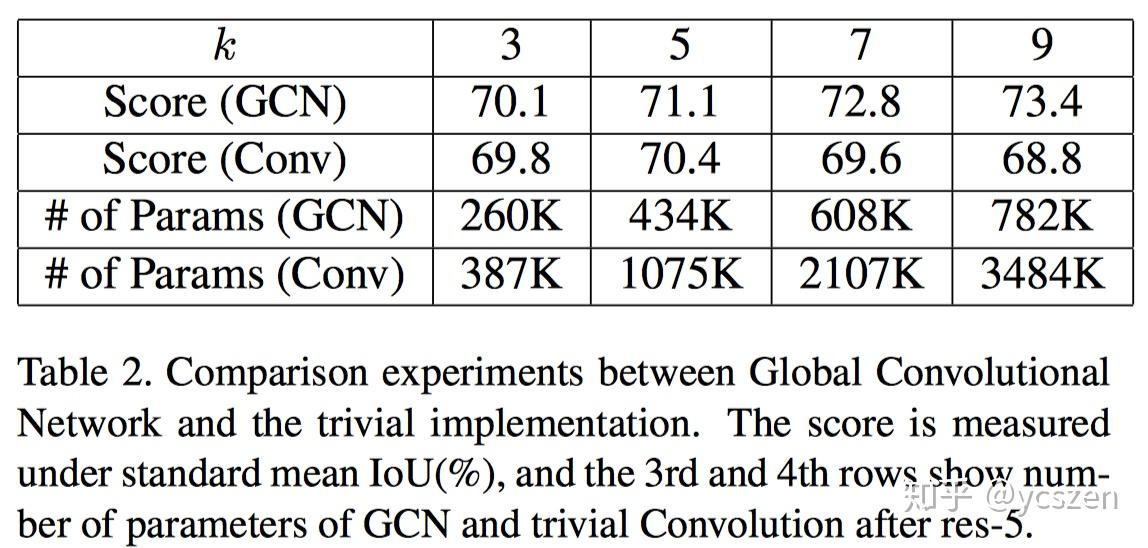
通过实验结果可知,随着 Kernel Size的增加,普通 Conv的参数量远大于GCN,但是GCN的性能却持续地优于普通 Conv。
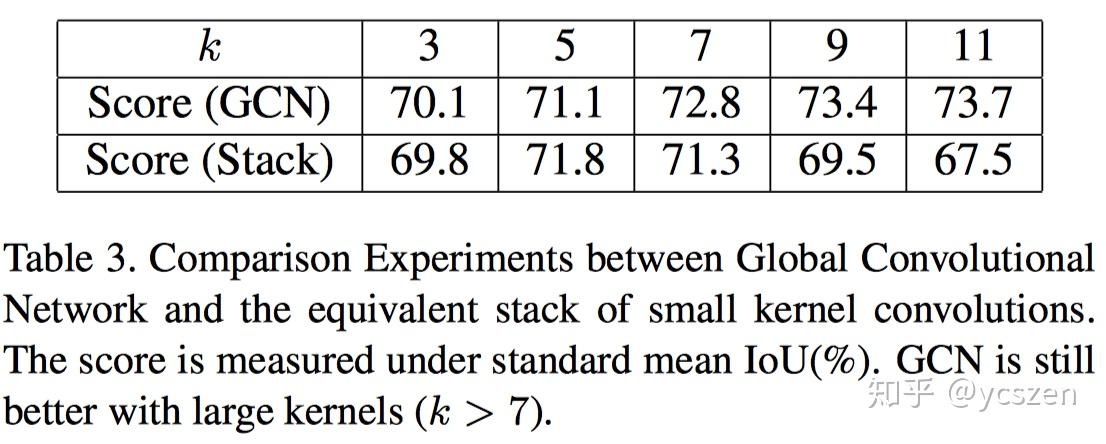
可以看到 GCN 依然优于普通 Conv 的堆叠,尤其是在较大 Kernel Size 的情况下。笔者认为这是一个很有价值的实验,可以启发我们去思考关于网络感受野的问题。我们以往认为,通过堆叠多个小核 Conv 可以达到和大核 Conv 一样的感受野,同时计算量还更少。最常见的应用比如 VGG-Net。但是,实际上并非如此。
随着网络深度的提升,理论上网络的感受野大多可以直接覆盖全图,但是实际有效感受野却远小于此。笔者的理解是对同一个 Feature Map 进行卷积,边缘区域进行计算的次数会小于中心区域,所以随着 Conv 的不断堆叠,实际上会导致边缘感受野的衰减,即有效感受野会远小于理论感受野。
最后文中给出了在 PASCAL VOC 2012 和 Cityscapes 上完整的 Training Strategy,这在当时还是很良心的,之前的一些 Paper 对此都语焉不详。具体详细的 Training 过程请参考原文。
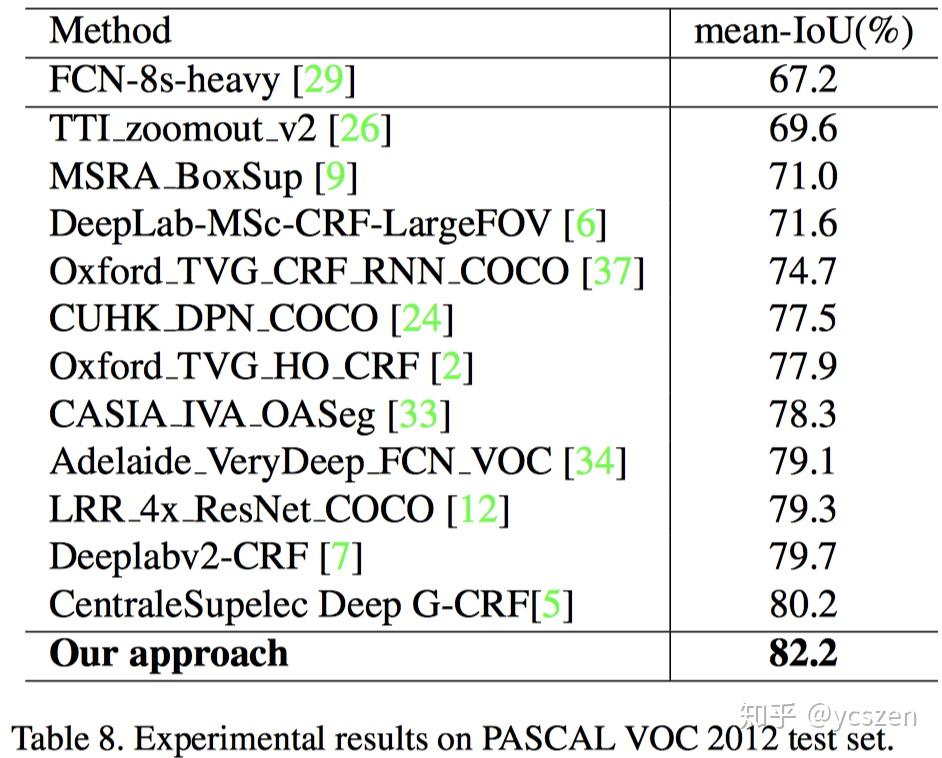
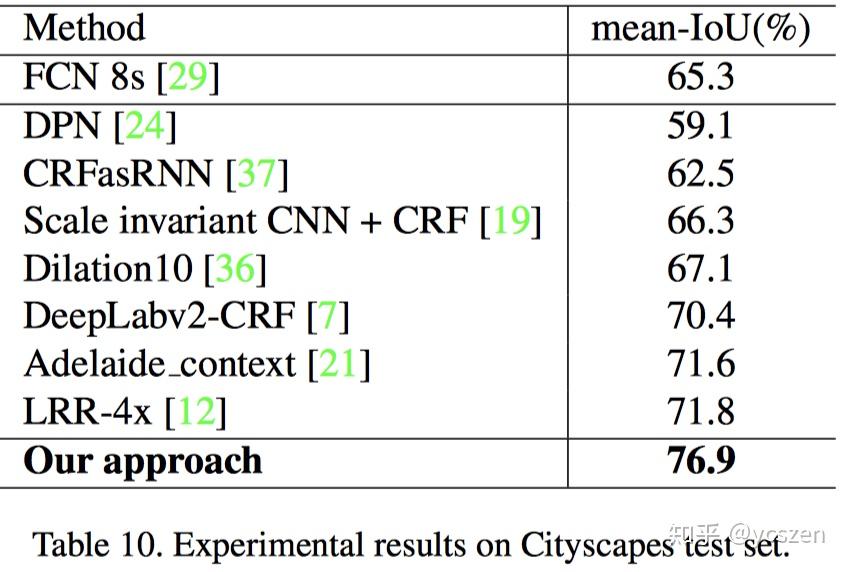
最终 GCN 在 PASCAL VOC 2012 和 Cityscapes 上都取得了不错的结果。
——PASCAL VOC 2012——
 ——Cityscapes——
 Discriminative Feature Network
接下来出场的是 CVPR2018 算法 Discriminative Feature Network(DFN)。论文Arxiv链接请见:https://arxiv.org/abs/1804.09337。详细解读请见:CVPR 2018 | 旷视科技Face++提出用于语义分割的判别特征网络DFN。
——Motivation——
本文总结了现有语义分割方法仍然有待解决的两类 Challenge(如图 5 所示):
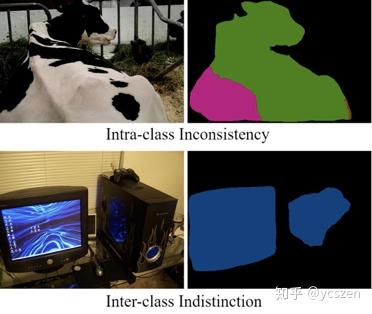 图5
所以,本文从宏观角度出发重新思考语义分割任务,提出应该将同一类的 Pixel考虑成一个整体,也就需要增强类内一致性,增大类间区分性。总结而言,我们需要更具有判别力的特征。
——网络结构——
本文提出的DFN主要包括两部分:Smooth Network 和 Border Network,如图6所示。
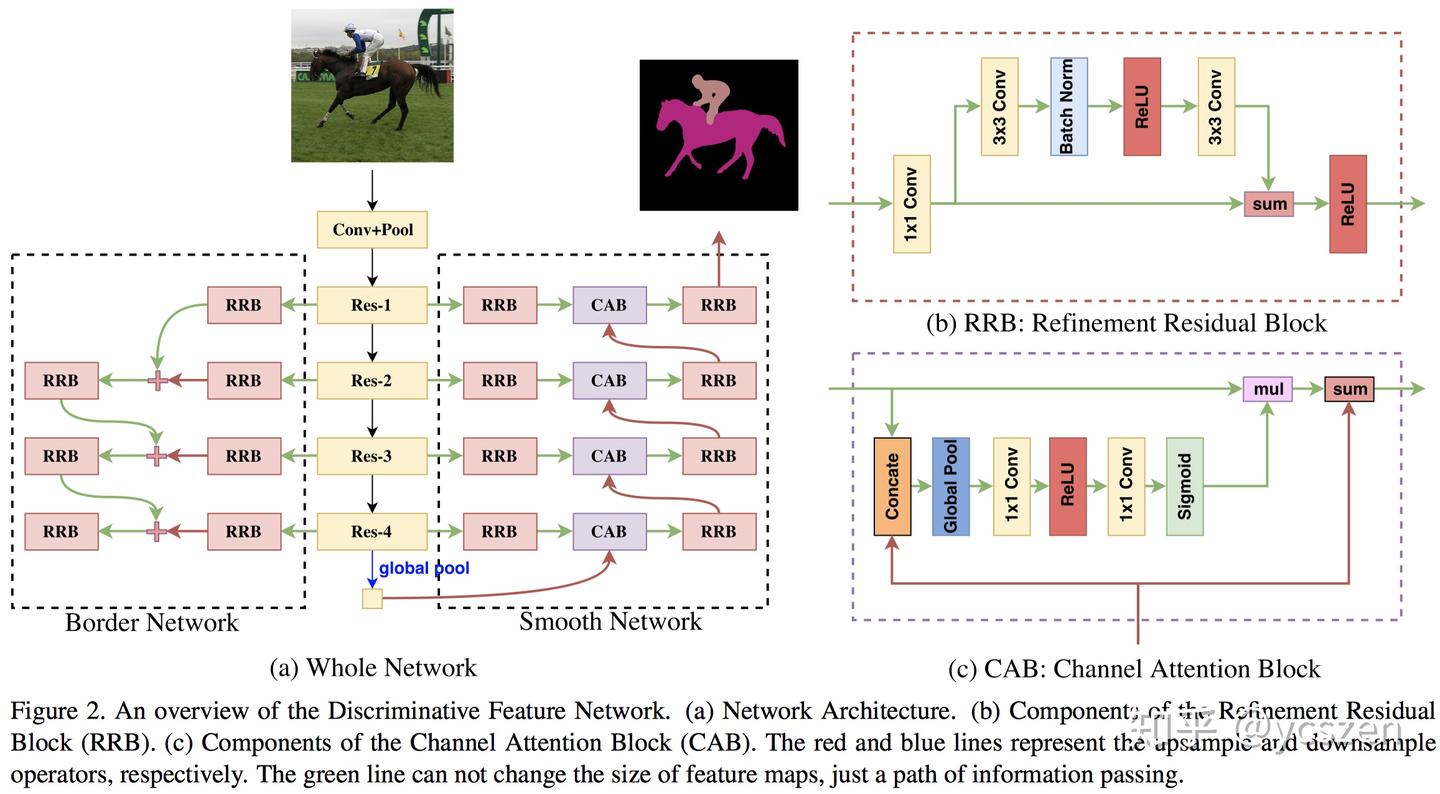 图6
Smooth Network 主要解决类内不一致性问题。文中认为类内不一致性问题主要来自Context 的缺乏。进而,我们需要引入 Multi-scale Context 和 Global Context;但是,不同 Stage 的特征虽然带来了 Multi-scale Context,与此同时也带来了不同的判别能力;因此,我们需要对这些具有不同判别力的特征进行筛选,这就诞生了其中核心的设计——Channel Attention Block(CAB)。
CAB 利用相邻 Stage 的特征计算 Channel Attention 然后对 Low-stage 的特征进行筛选,如图 7 所示。因为文中认为,High-stage 的特征语义信息更强,更具有判别力。
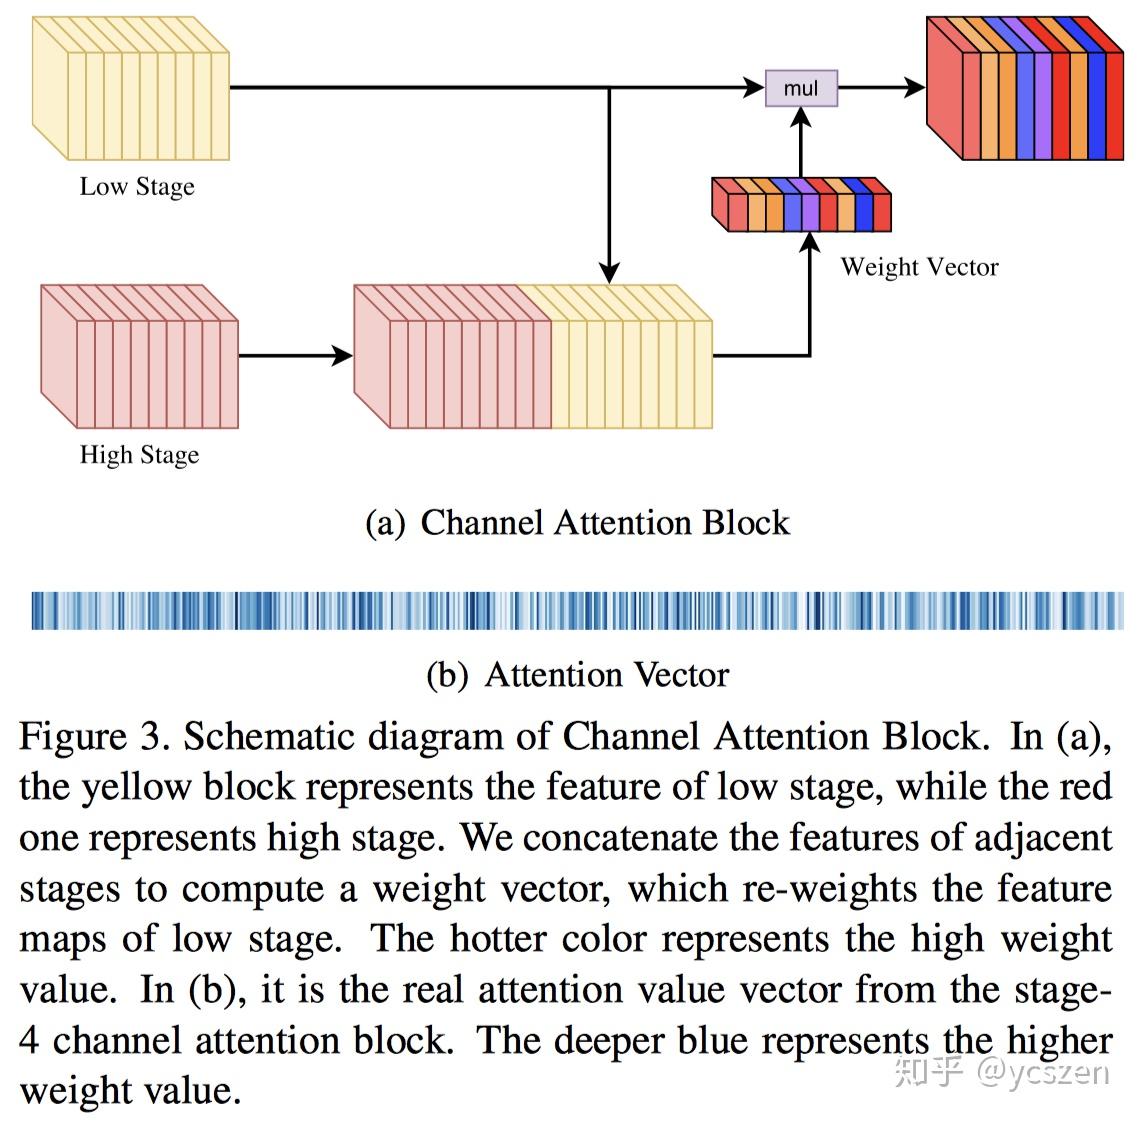 图7
此外,本文首次在 U-shape 结构中采用 Global Average Pooling,这个设计非常有效。ParseNet 首次在语义分割中使用 Global Average Pooling 提取 Global Context,而之后的 PSPNet,Deeplab V3 将其在 Dilation 阵营发扬光大。而本文将其应用 U-shape 的High-stage,并命名为“V-shape”。我们尝试将其迁移到 Detection 中的 FPN 结构,结果证明同样有效。
Border Network 主要解决类间低区分性的问题。文中认为具有相似表观特征的不同区域很容易被网络混淆,尤其是相邻之时。所以,需要增大特征之间的区分性。为此文章显式地引入了 Semantic Boundary 来引导特征学习。因为 Low-stage 主要关注一些细节边缘区域,而随着语义的增强,High-stage 的特征才是更多关注语义边界,所以 Border Network 采用了“反 U-shape”结构。
——实验——
文中进行了丰富的消融实验和可视化分析。
首先是对 Smooth Network 各部分的消融实验分析。可以看到Smooth Network非常有效,在PASCAL VOC 2012 Validation Set上可以达到 Single Scale 79.54% mean IoU。
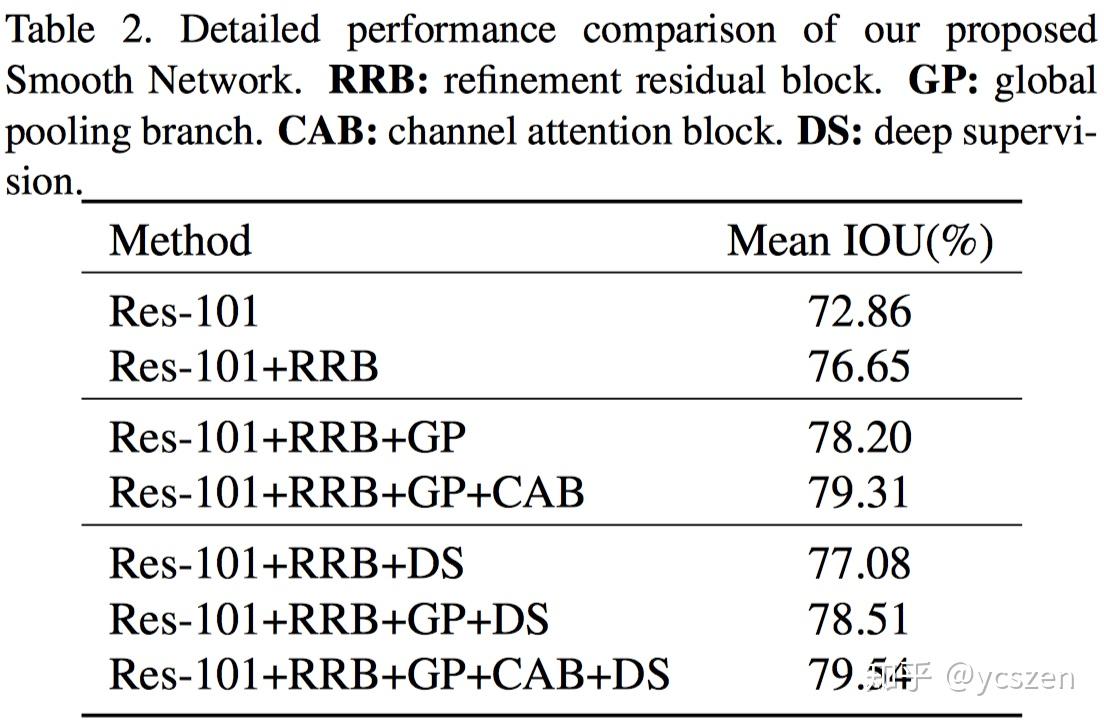 而通过可视化输出,可以看到Smooth Network确实可以将类内区域变得更加一致,如图8所示。
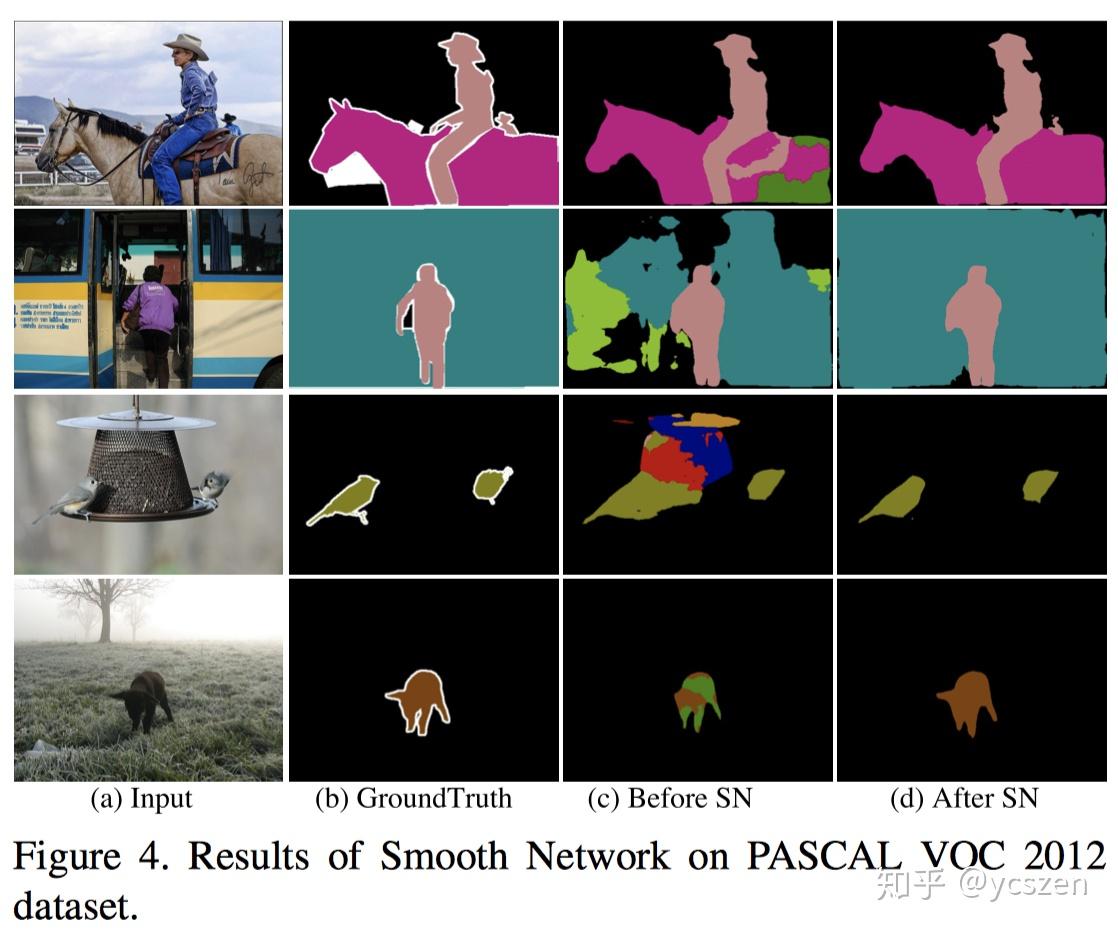 图8
同时,文中还对 Smooth Network 和 Border Network 进行了消融实验分析。
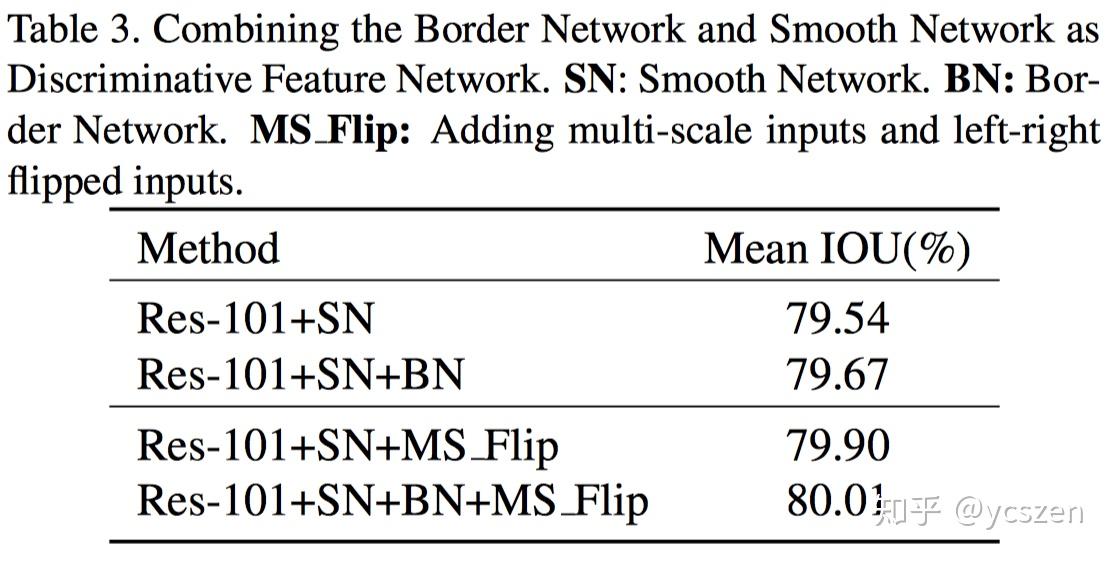 通过可视化Border Network的输出,可以看到Border Network确实可以很好地关注到Semantic Boundary区域,如图9所示。
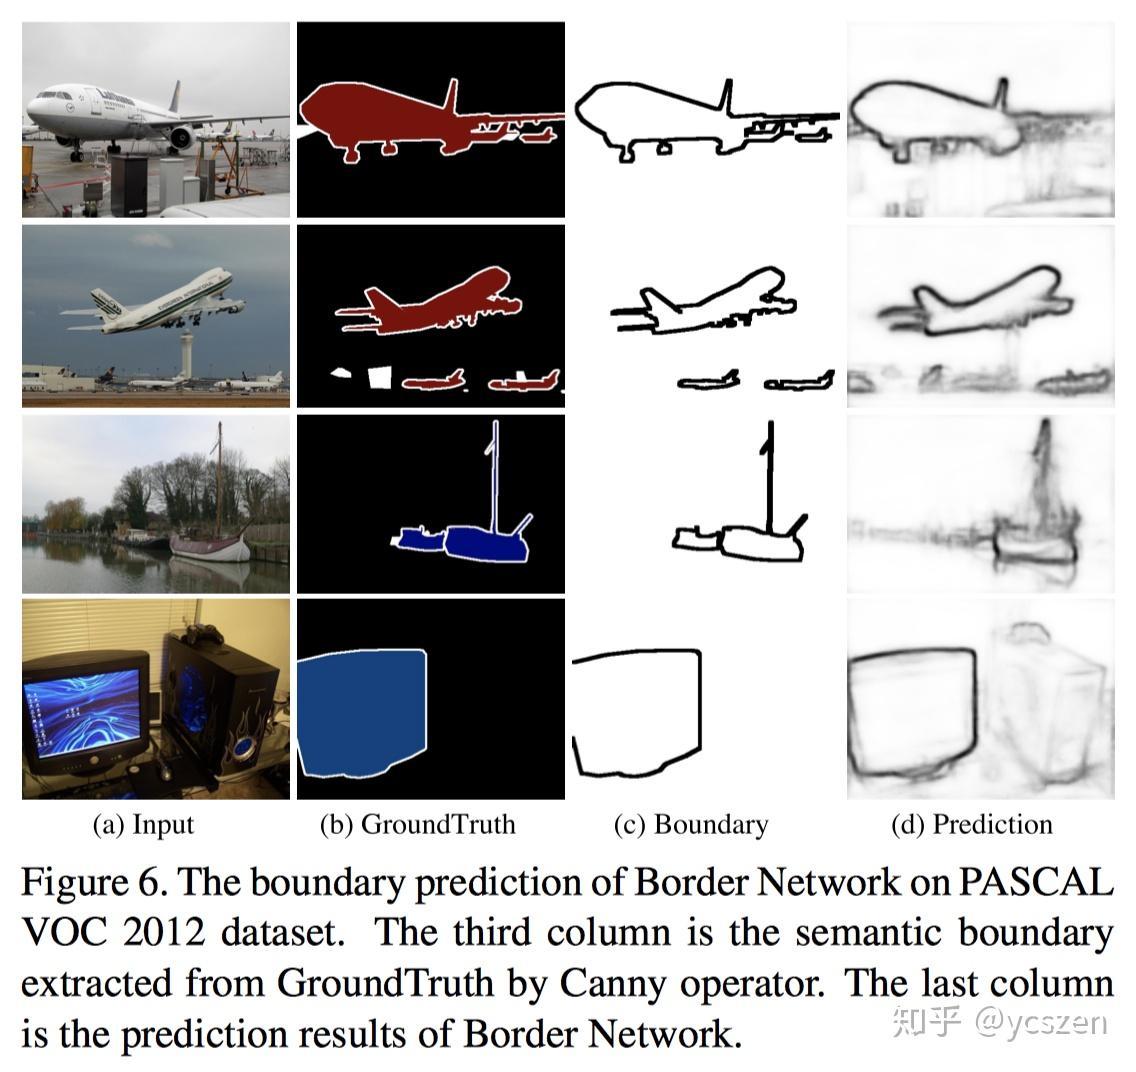 图9
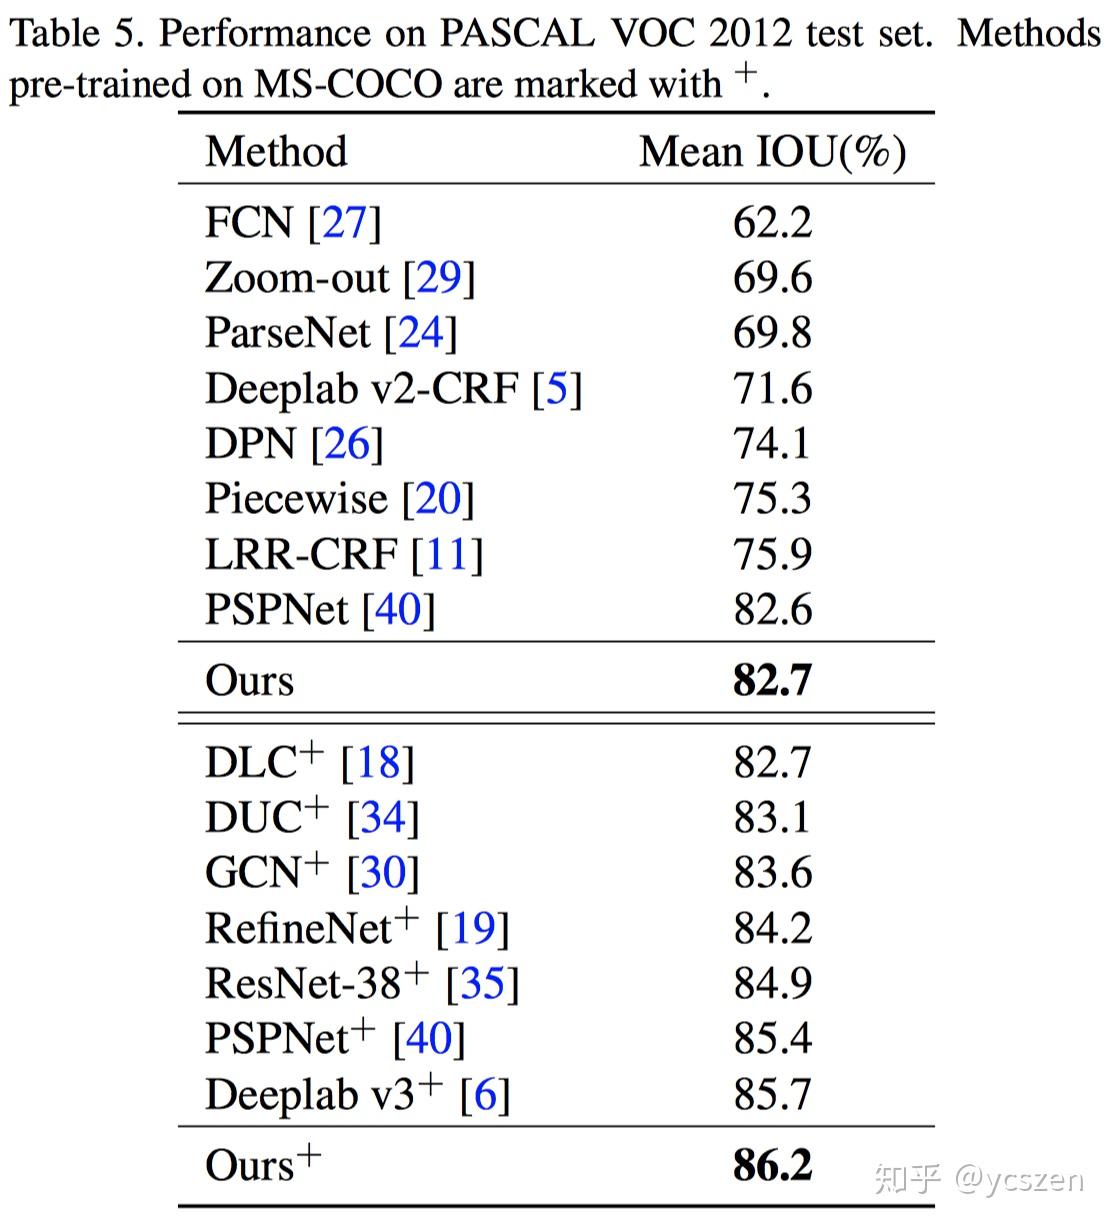
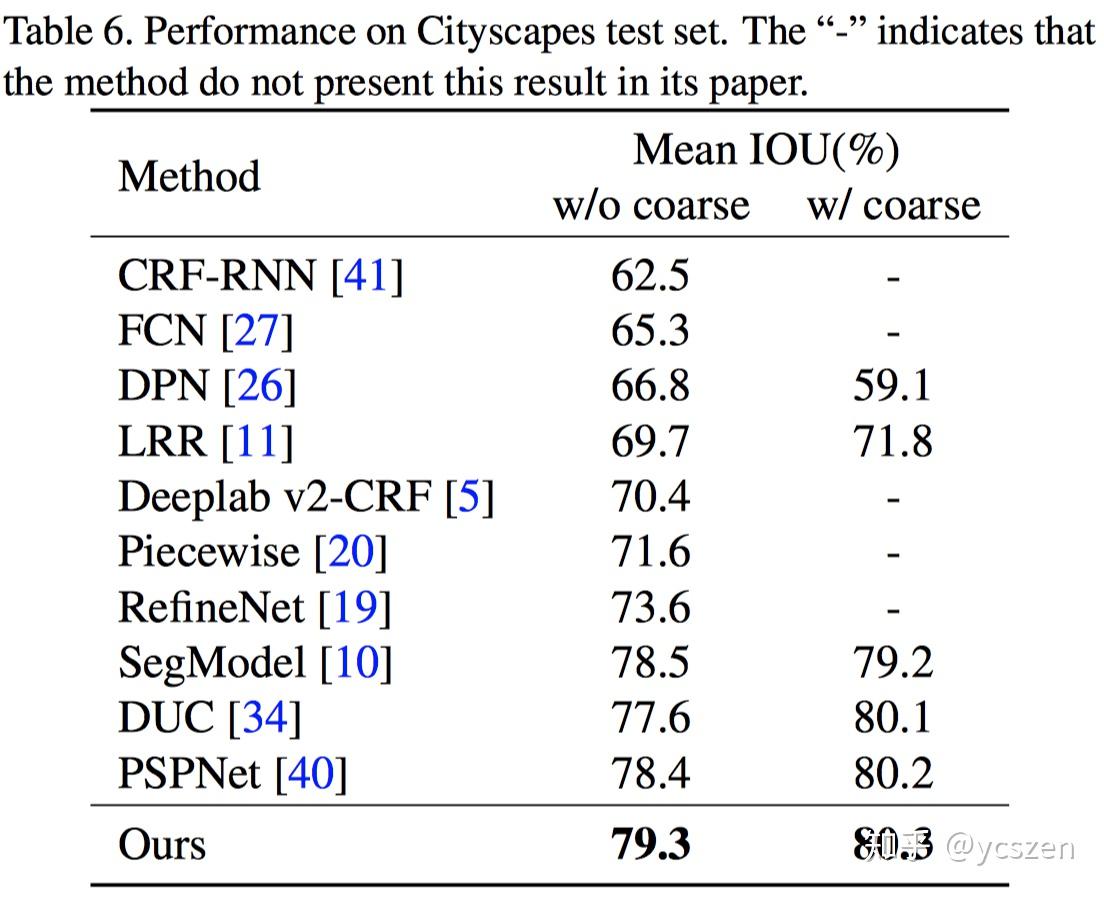
最终,DFN在PASCAL VOC 2012和 Cityscapes上性能都达到了当时的state-of-the-art。
 BiSeNet
最后出场的主角是 ECCV 2018 算法 Bilateral Segmentation Network(BiSeNet)。前面两个算法主要关注 Accuracy,探索 mean IoU 的极限;而 BiSeNet 关注于做出一个既快又好的实时语义分割算法。最终该算法在 Cityscapes 上能取得 68.4% mean IoU 105 FPS (NVIDIA Titan XP)的好成绩。当然,我们希望这篇工作能抛砖引玉,尝试探讨到底什么架构才更适合 Segmentation 任务,什么框架才能很好地同时获得充足的 Context 和丰富的空间信息?论文 Arxiv 链接请见:https://arxiv.org/abs/1808.00897。
详细解读请见:ECCV 2018 | 旷视科技提出双向网络BiSeNet:实现实时语义分割。
——Motivation——
本文对之前的实时性语义分割算法进行了总结,发现当前主要有三种加速方法:1) 通过 Crop 或者 Resize 限制输入图片进而减少计算量;2) 减少网络通道数,尤其是 Early Stage;3) 还有像 ENet 类似的方法直接丢掉最后一个 Stage,如图10(a)所示。
这些提速的方法会丢失很多 Spatial Details 或者牺牲 Spatial Capacity,从而导致精度大幅下降。为了弥补空间信息的丢失,有些算法会采用 U-shape 的方式恢复空间信息。但是,U-shape 会降低速度,同时很多丢失的信息并不能简单地通过融合浅层特征来恢复,如图 10(b) 所示。
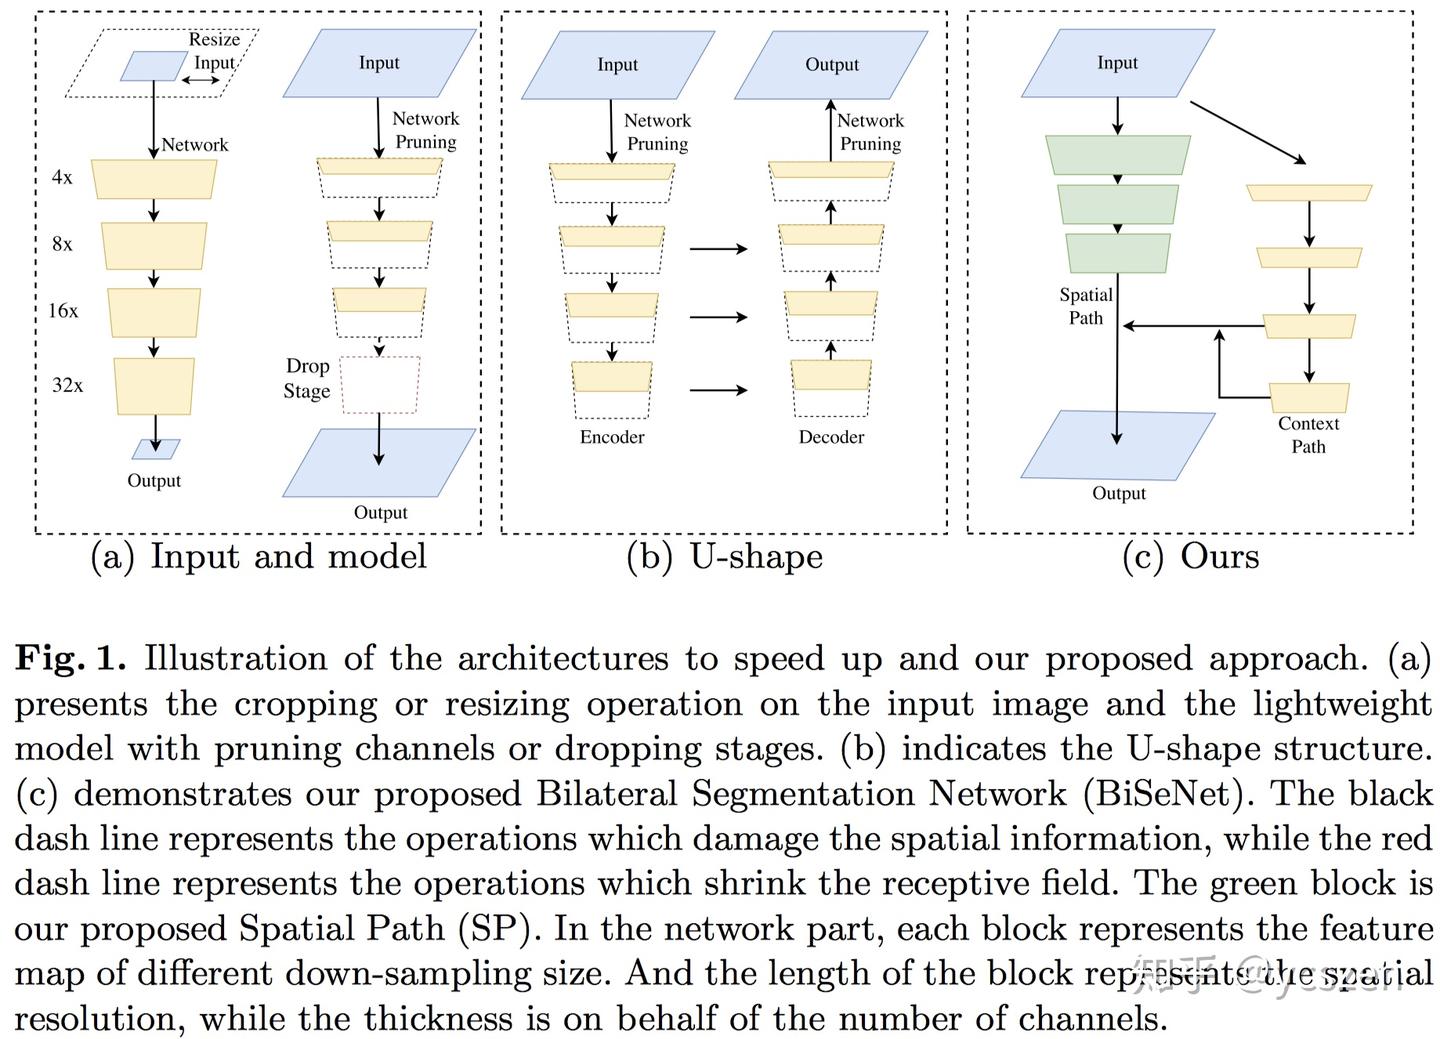 图10
总结而言,实时性语义分割算法中,加速的同时也需要重视空间信息。基于这些观察,本文提出了一种新的解决方案Bilateral Segmentation Network(BiSeNet)。
——网络结构——
BiSeNet区别于 U-shape 和 Dilation 结构,尝试一种新的方法同时保持 Spatial Context 和 Spatial Detail 。所以,我们设计了Spatial Path和Context Path两部分。顾名思义,Spatial Path使用较多的 Channel、较浅的网络来保留丰富的空间信息生成高分辨率特征;Context Path使用较少的 Channel、较深的网络快速 downsample来获取充足的 Context。基于这两路网络的输出,文中还设计了一个Feature Fusion Module(FFM)来融合两种特征,如图11所示。
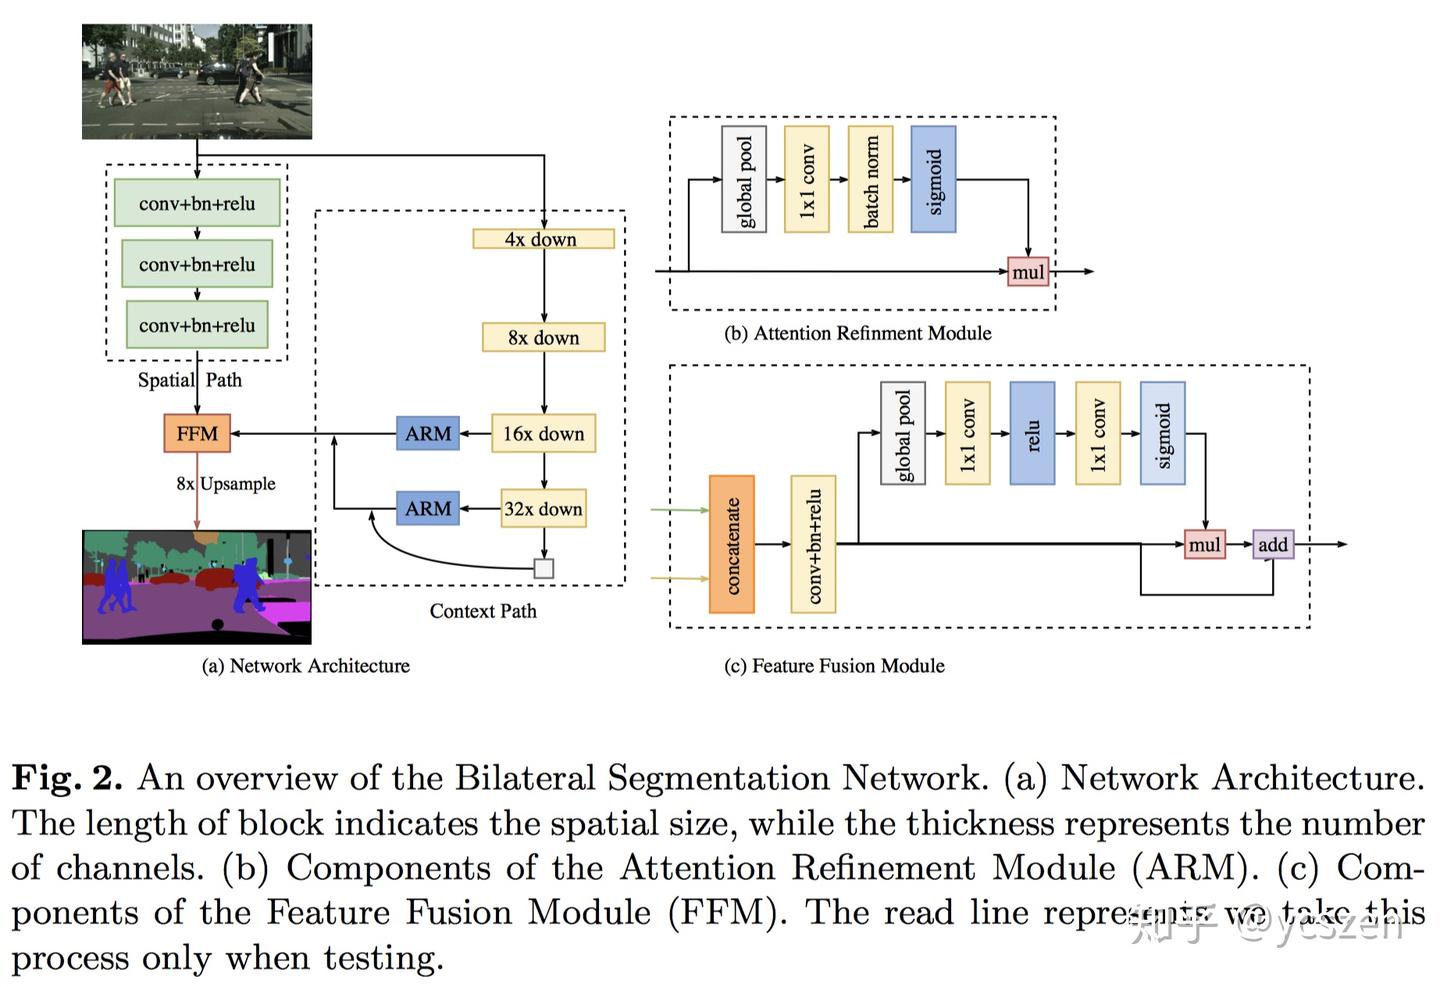 图11
Spatial Path 只包含三个 stride=2 的 Conv+BN+Relu,输出特征图的尺寸为原图的 1/8 。为了访存比考虑,此处并没有设计 Residual结构。
Context Path 可以替换成任意的轻量网络,比如 Xception,ShuffleNet 系列,MobileNet 系列。本文主要采用 Xception39 和 ResNet-18 进行实验。可以看到,为了准确率考虑,Context Path 这边使用了类似 U-shape 结构的设计。不过,不同于普通的 U-shape,此处只结合了最后两个 Stage,这样设计的原因主要是考虑速度。此外,和 DFN 类似,Context Path 依然在最后使用了 Global Average Pooling 来直接获取Global Context。
最后,文章中提到因为两路网络关注的信息不同,属于 Different Level 的特征,所以文中设计了一个 FFM 结构来有效融合两路特征。
——实验——
本文从精度和速度两个维度,进行了丰富的分析实验。
首先文中分析了 Context Path 这边使用不同变体的 U-shape 结构的速度和精度的对比。
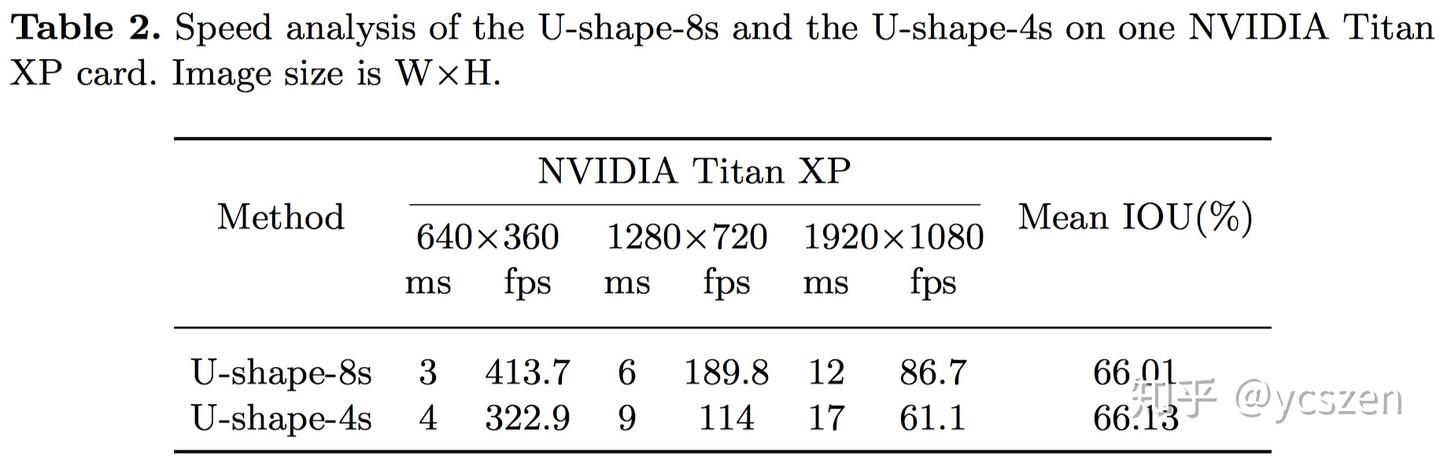 此处,U-shape-8s 就是文中所展示的结构,U-shape-4s 则是普通的 U-shape 设计,即融合了更多 stage 特征。可以看到,U-shape-4s 的速度会明显慢于 U-shape-8s.
文中还对 BiSeNet 的各个部分进行了消融分析实验。
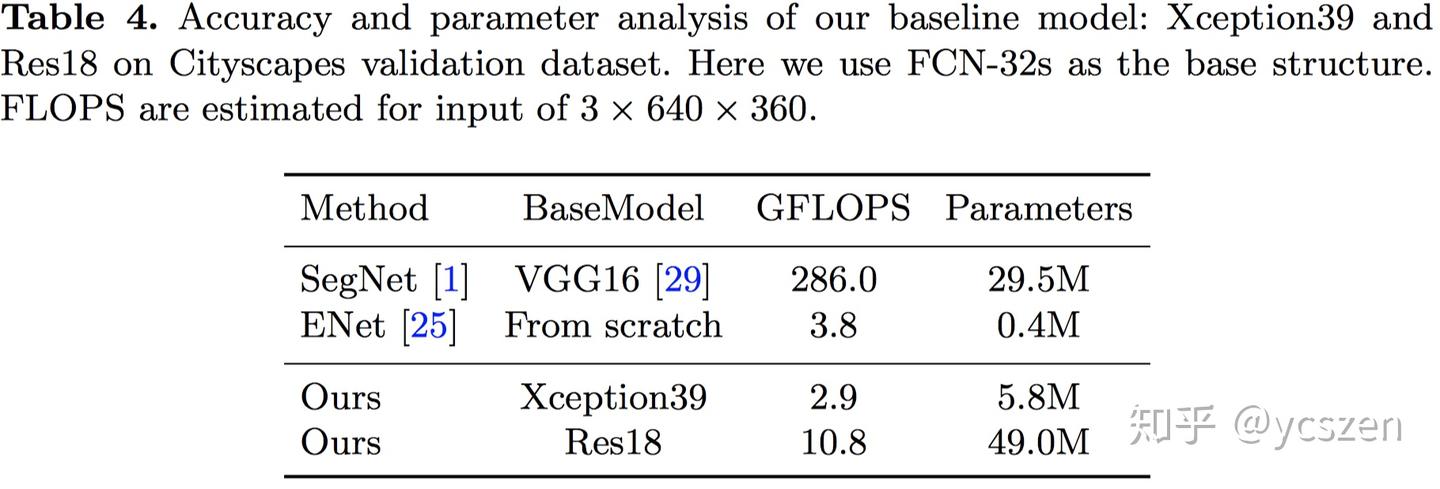
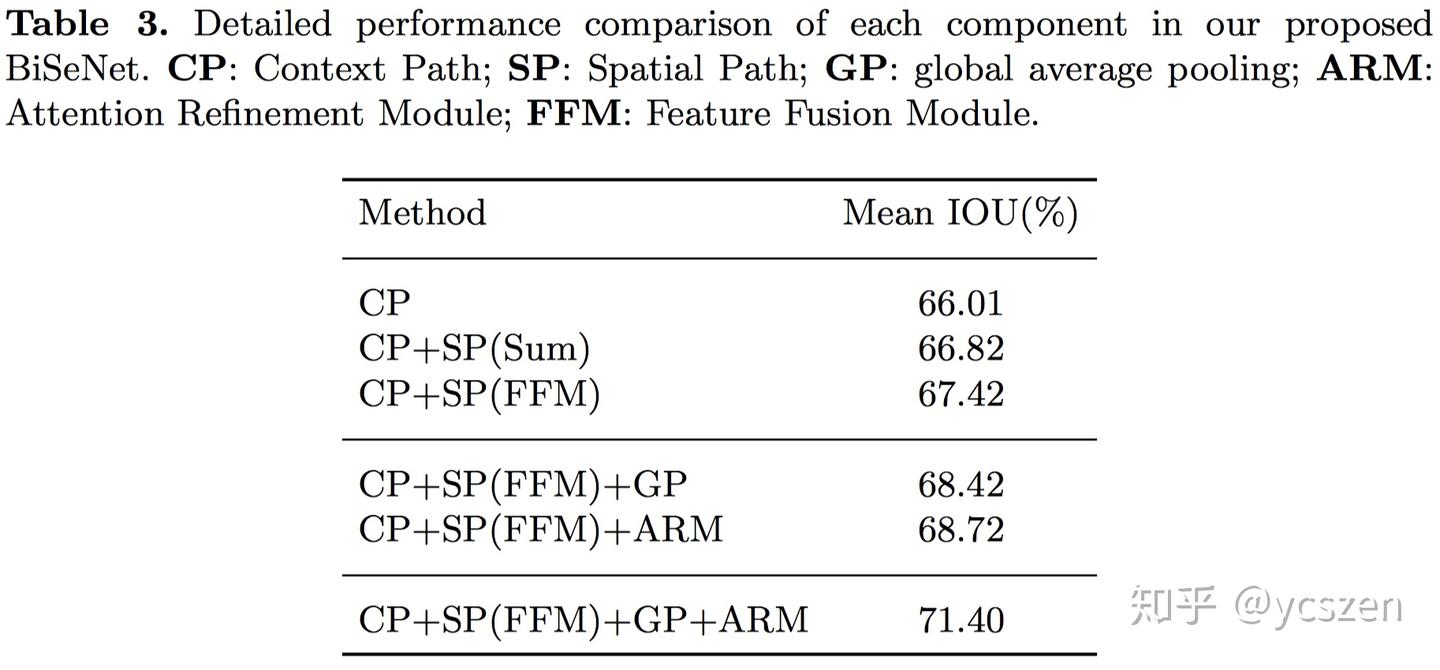 文中还给出了 BiSeNet 的 GFLOPS、参数量等信息,以及在不同硬件平台不同分辨率下的速度对比。
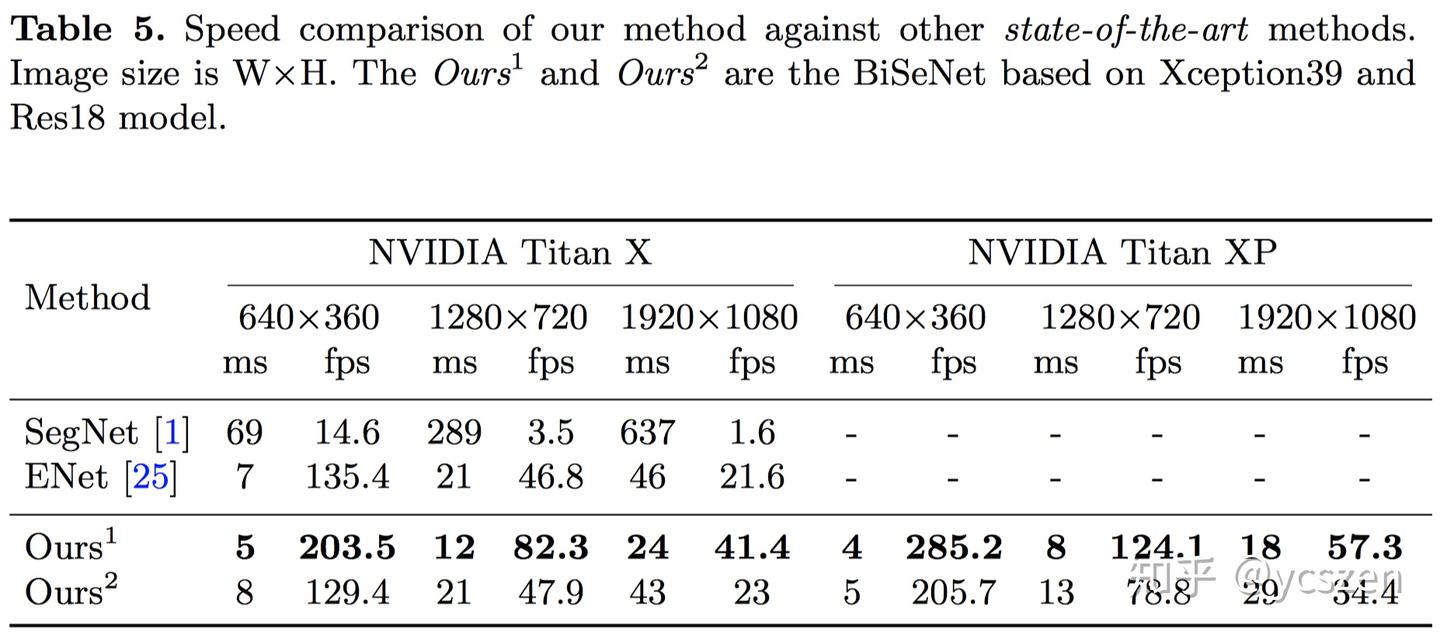 文中给出了 BiSeNet 分别与实时性算法和非实时性算法比较的结果。
与实时性算法比较:
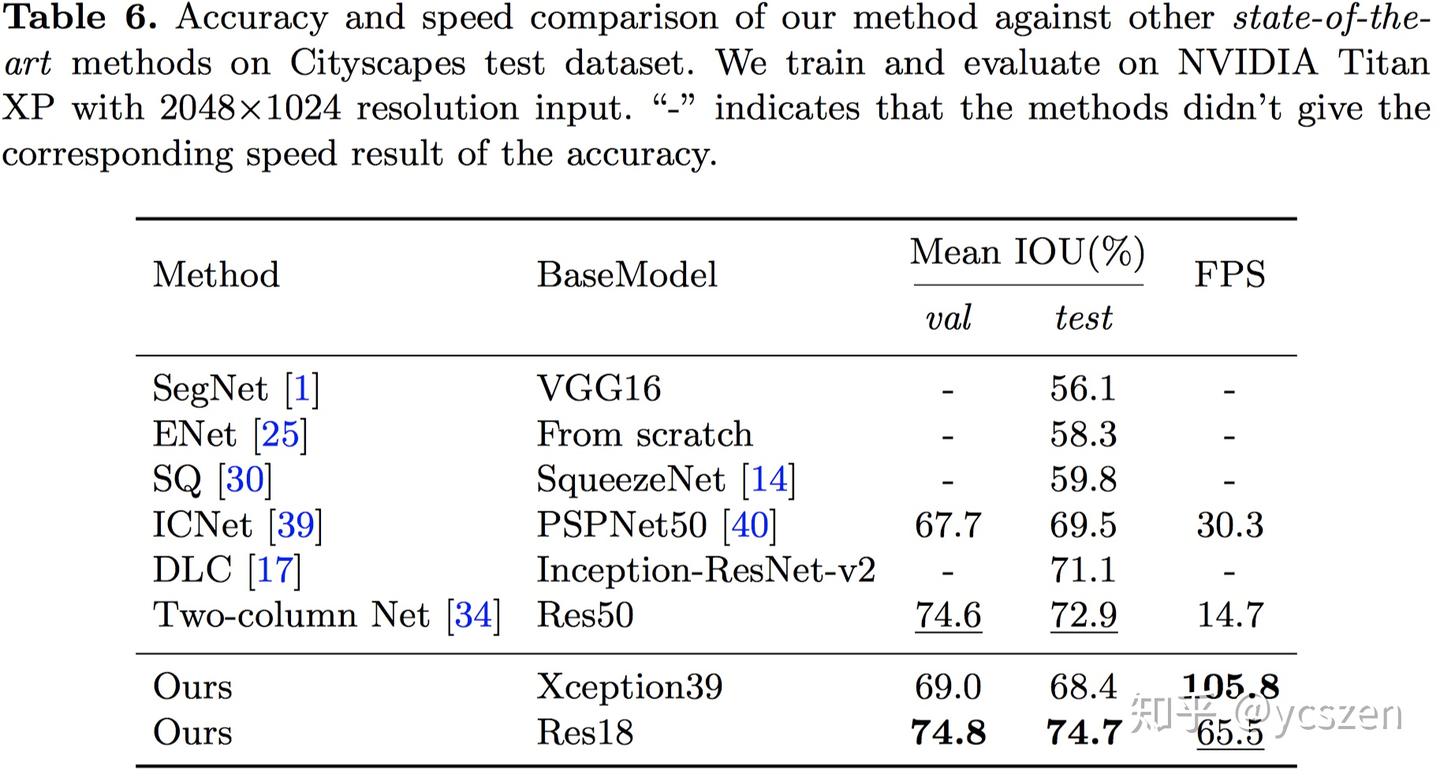 虽然 BiSeNet 是实时性算法,但是它的精度甚至比一些非实时性算法还高。
与非实时性算法比较:
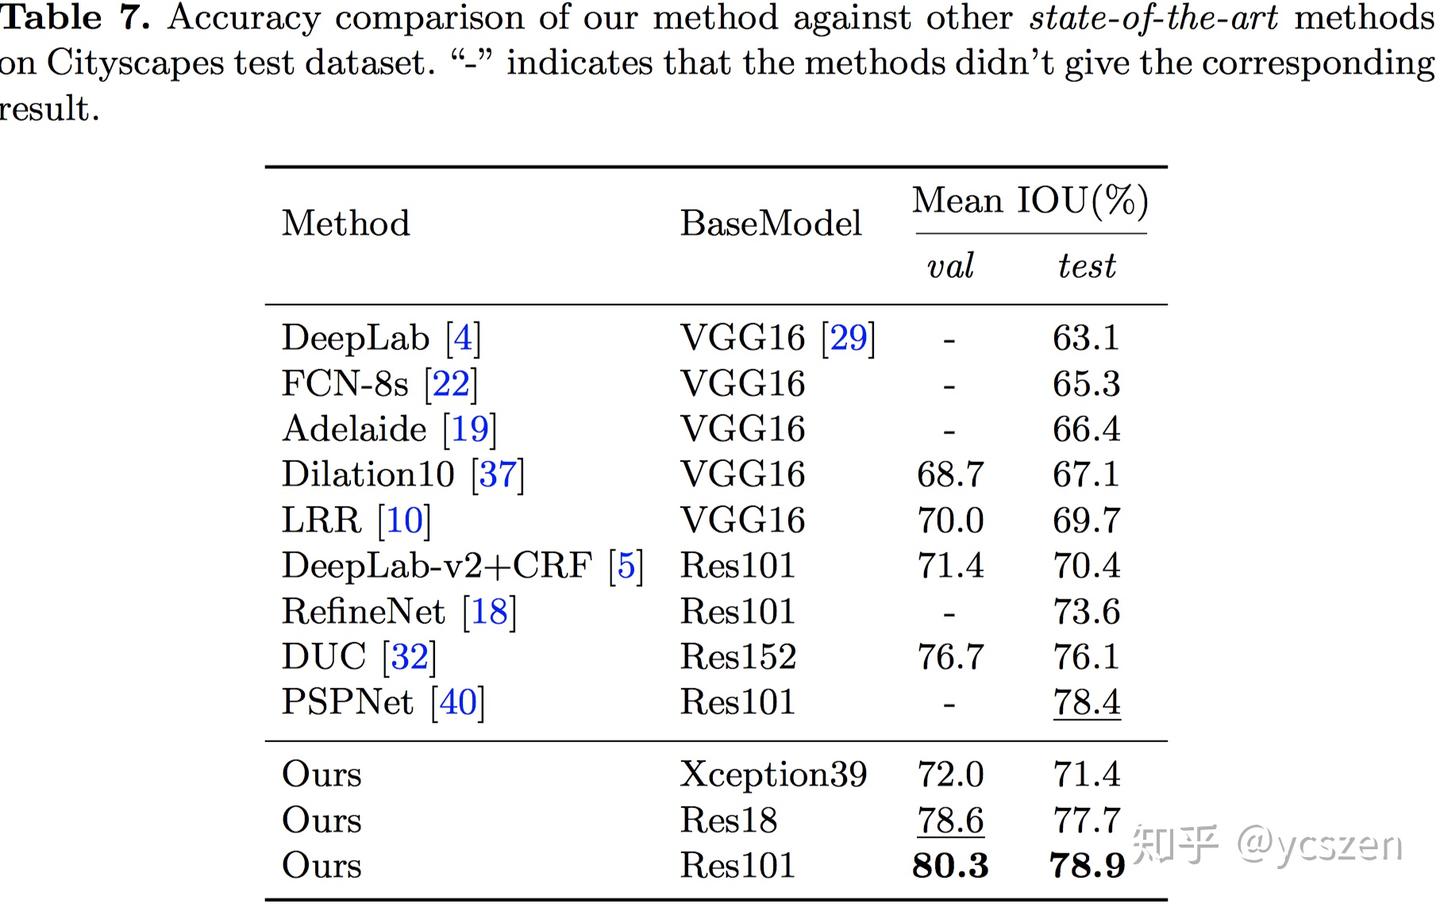 可以看到,BiSeNet 是一种很有效的设计。当替换上大模型之后,精度甚至高于 PSPNet 等算法。另外,需要注意的是,为了和非实时性算法进行比较,在关注精度这部分实验 BiSeNet 使用的不同于关注速度部分的 Setting,具体细节详见论文。
BiSeNet 算法对实时性语义分割算法提出了新的思考,在提升速度的同时也需要关注空间信息。同时,该设计也是一次对 Segmentation Backbone 的思考,希望设计一个对 Segmentation 任务友好的框架,当然现在还存在许多需要改进的地方。此外,该方法不仅仅可应用于实时性语义分割算法,也可应用于其他领域,尤其是在对 Spatial Detail 和 Context 同时有需求的情况下。据笔者了解,已有研究将其应用于 Potrait Segmentation.
Reference
[1] Peng, C., Zhang, X., Yu, G., Luo, G., & Sun, J. (2017). Large kernel matters—improve semantic segmentation by global convolutional network. In Computer Vision andPattern Recognition (CVPR), 2017 IEEE Conference on(pp. 1743-1751). IEEE.
[2] Yu, C., Wang, J., Peng, C., Gao, C., Yu, G., & Sang, N. (2018). Learning a Discriminative Feature Network for Semantic Segmentation.arXivpreprint arXiv:1804.09337.
[3] Yu, C., Wang, J., Peng, C., Gao, C., Yu, G., & Sang, N. (2018, September). Bisenet: Bilateral segmentation network for real-time semantic segmentation. In European Conference on Computer Vision(pp. 334-349). Springer, Cham.
[4] Long, J., Shelhamer, E., & Darrell, T. (2015). Fully convolutional networks for semantic segmentation. In Proceedings of the IEEE conference on computer vision and pattern recognition(pp. 3431-3440).
[5] Ronneberger, O., Fischer, P., & Brox, T. (2015, October). U-net: Convolutional networks for biomedical image segmentation. In International Conference on Medical image computing and computer-assisted intervention(pp. 234-241). Springer, Cham.
---------解读者介绍-------
余昌黔,华中科技大学自动化系在读博士,旷视科技研究院算法实习生,语义分割算法DFN、BiSeNet 第一作者,研究方向涵盖语义分割、全景分割、快速分割、视频分割等,并在上述方向有着长期深入的研究;2018 年,参加计算机视觉顶会 ECCV 挑战赛 COCO+Mapillary,分获全景分割(Panoptic Segmentation)两项冠军,并受邀作现场口头报告。个人网页:
编辑于 2019-01-23 09:57
semantic segmentation
深度学习(Deep Learning)
人工智能
赞同 119595 条评论2134 14
分享
申请转载
 未登录用户
95 条评论
默认
最新
 高级动物
hhhh炼丹师的三大浪漫还行
2019-01-23
回复4
 余昌黔
作者
 哈哈哈
2019-01-23
回复1
 闲钓无鱼心自娱
车标怎么处理的?
2019-01-23
回复3
 余昌黔
作者
那部分是ignore的
2019-01-23
回复2
 Brain
说得真好,反正我也看不懂
 2019-03-13
回复2
 阿元
终于等到了~
2019-01-23
回复2
 淋雨
……天哪你们都在说些什么
2019-03-11
回复1
 虚渊献身
我一个文科生怎么会被推这种文章,点进来完全一脸懵逼
2019-03-07
回复1
 托洛茨卡娅
妈耶,这玩意儿用在影视后期方面的话,普天之下皆绿背啊
2019-02-24
回复1
 晴明
开源好评,等了很久了,谢谢大佬
2019-01-30
回复1
 泡芙小姐
嘻嘻
2019-01-28
回复1
余昌黔
作者
 2019-01-28
回复喜欢
 也无风雨也无晴
 膜拜大佬,顺便请教一下,要对小面积目标进行实时分割(目标和背景两类)用什么网络比较好,因为首先要实时,所以我先复现了enet,但准确率较低,最近在复现erfnet,但是感觉一直这样复现别人的也没有什么意义,还是得抓住问题关键,所以请问一下大佬有没有什么建议,感谢
 2019-01-24
回复1
余昌黔
作者
小目标的分割本身就是个难题。你可以考虑先做一下非实时的小目标分割,然后再进行加速。而对于小目标而言的话,我的理解是需要更多的context,因为有些目标太小可能单独看根本识别不了,但是有相对丰富的context之后可能反倒能识别出来。
2019-01-24
回复喜欢
展开其他 1 条回复
查看被折叠评论
点击查看全部评论
未登录用户
关于作者
余昌黔
华中科技大学 人工智能博士
华中科技大学 控制科学与工程博士
回答 82 文章 20 关注者 27,689
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 图像语义分割论文综述 AdamL...发表于CV学习笔...
 CVPR 2022 | 做语义分割不用任何像素标签!英伟达提出GroupViT:基于文本监督的语义分割 机器学习社...发表于机器学习社...
 图片语义分割深度学习算法要点回顾 AI研习社
 一种用于量化衡量MLLM中视觉特征的视觉语义对齐与视觉结构程度的方法 徐土豆发表于计算机视觉...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码