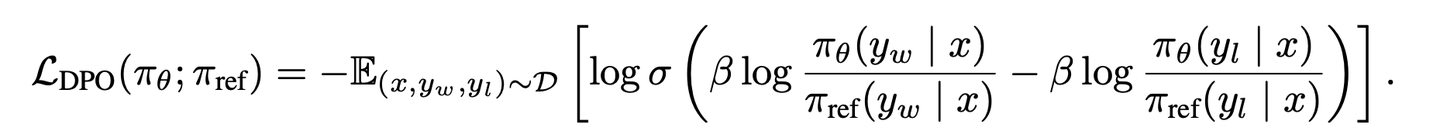 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
RL in NLP:强化学习在自然语言处理下的应用
首发于许婧的学习笔记
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
RL in NLP:强化学习在自然语言处理下的应用
首发于许婧的学习笔记
切换模式
 许婧
 北京大学 数据科学硕士
收录于 · 许婧的学习笔记
56 人赞同了该文章
目录
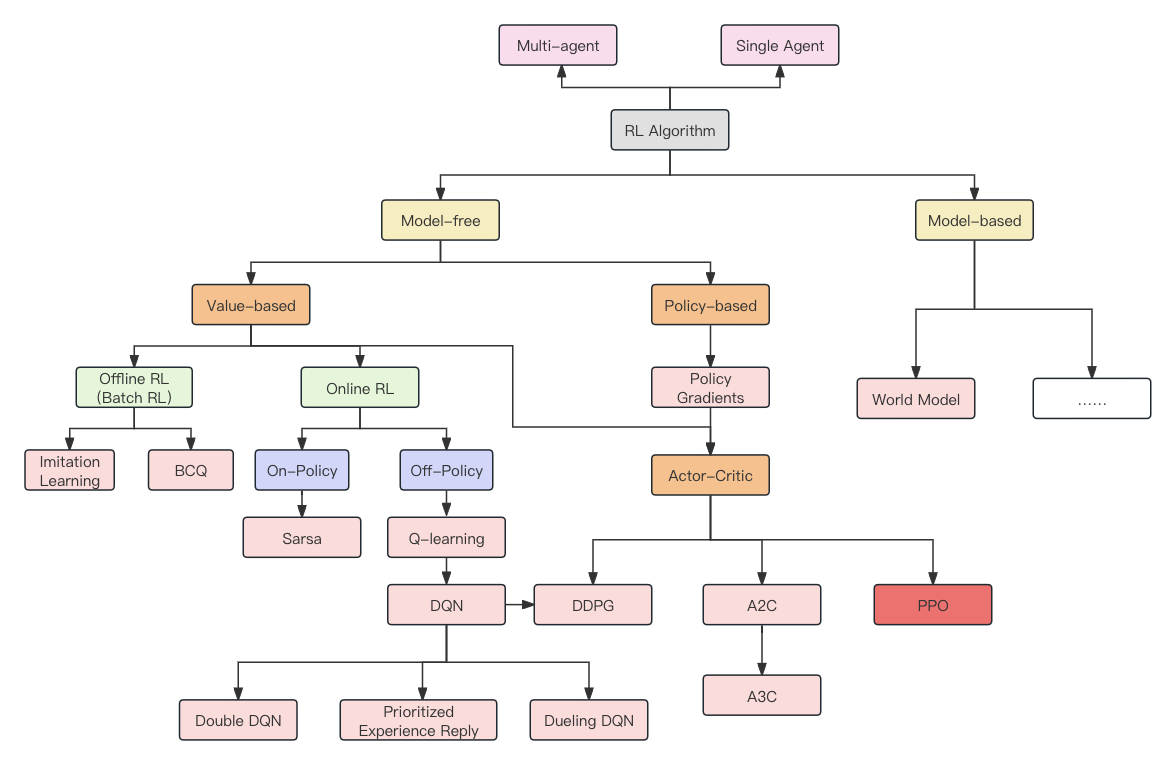
强化学习(Reinforcement Learning)是一种时序决策学习框架,通过智能体和环境交互 at=π(ot)a_t=\pi({o_t}) ,得到的奖励 rt=r(ot,at)r_t=r({o_t, a_t}) ,从而来优化策略 π\pi ,使其能够在环境中自主学习。
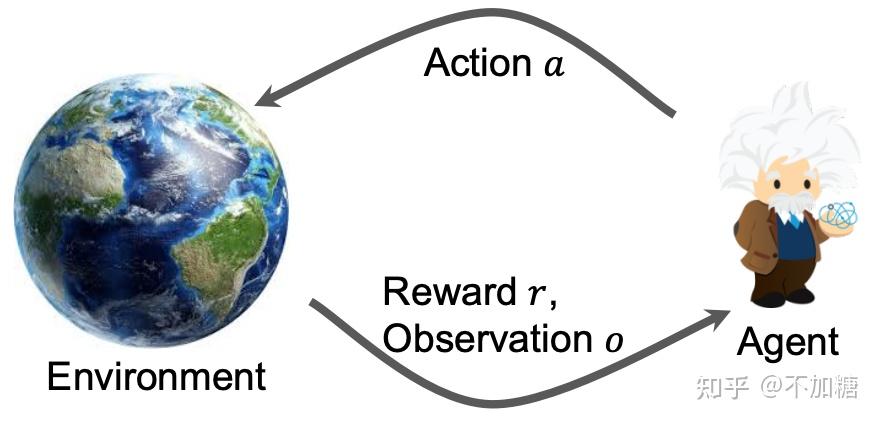
以单智能体时序决策问题为例
其区别会影响policy网络的实现方式。
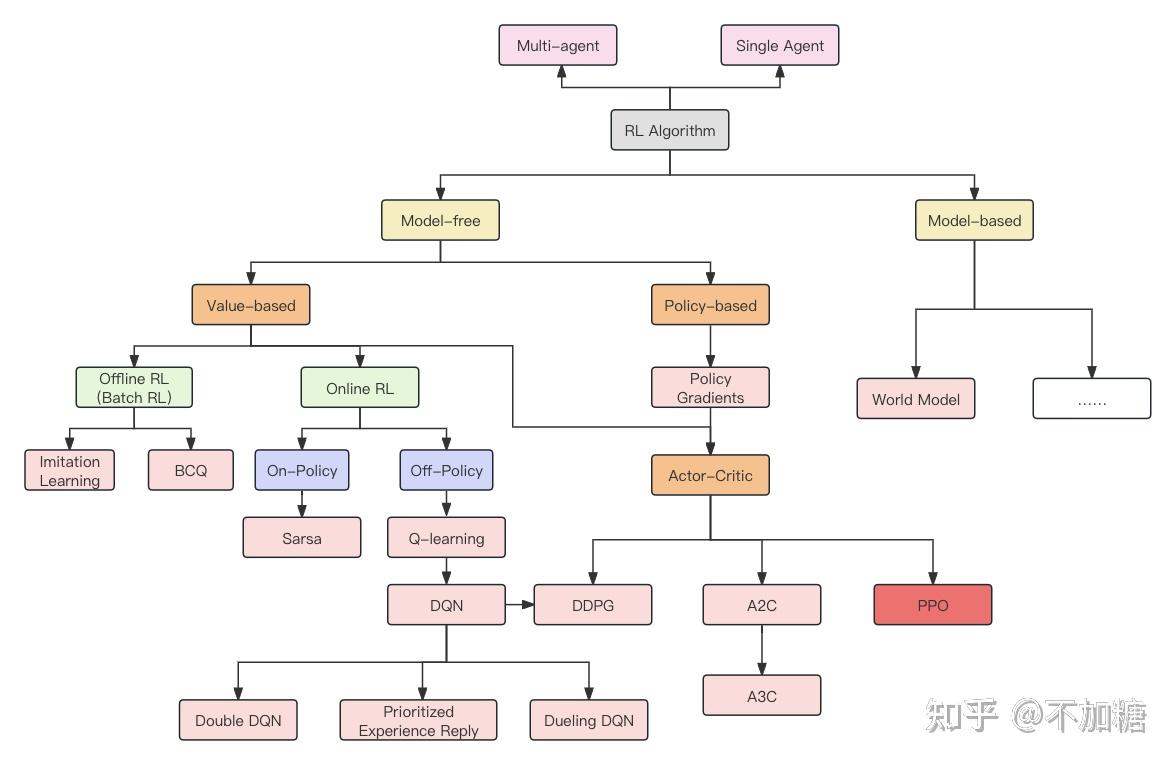 Value-based
状态的值 V(s)或者状态行动对(state-action pair)的值Q(s,a) ,作为一种累积奖赏的估计,可以通过最大化值函数来优化得到最优策略,这种优化方法称为value-based。所以,
》两者的关系: V^\pi(s)=\underset{a \sim \pi}{\mathrm{E}}\left[Q^\pi(s, a)\right] ; V^(s)=\max _a Q^(s, a)
贝尔曼方程
中心思想:当前值估计=当前奖赏+未来值估计
\begin{aligned} V^\pi(s) & =\underset{\substack{a \sim \pi \\ s^{\prime} \sim P}}{\mathrm{E}}\left[r(s, a)+\gamma V^\pi\left(s^{\prime}\right)\right] \\ Q^\pi(s, a) & =\underset{s^{\prime} \sim P}{\mathrm{E}}\left[r(s, a)+\gamma \underset{a^{\prime} \sim \pi}{\mathrm{E}}\left[Q^\pi\left(s^{\prime}, a^{\prime}\right)\right]\right] \end{aligned}
所以,最优值函数的贝尔曼公式为:
\begin{aligned} V^(s) & =\max _a \underset{s^{\prime} \sim P}{\mathrm{E}}\left[r(s, a)+\gamma V^\left(s^{\prime}\right)\right] \\ Q^(s, a) & =\underset{s^{\prime} \sim P}{\mathrm{E}}\left[r(s, a)+\gamma \max _{a^{\prime}} Q^\left(s^{\prime}, a^{\prime}\right)\right] \end{aligned}
优势函数Advantage Functions
强化学习中,有时不需要知道一个行动的绝对好坏,而只需要知道它相对于其他action的相对优势。即,
A^\pi(s, a)=Q^\pi(s, a)-V^\pi(s)
Policy-based
\begin{array}{rlr} \nabla_\theta J\left(\pi_\theta\right) & =\nabla_\theta \underset{\tau \sim \pi_\theta}{\mathrm{E}}[R(\tau)] & \\ & =\nabla_\theta \int_\tau P(\tau \mid \theta) R(\tau) & \text { Expand expectation } \\ & =\int_\tau \nabla_\theta P(\tau \mid \theta) R(\tau) & \text { Bring gradient under integral } \\ & =\int_\tau P(\tau \mid \theta) \nabla_\theta \log P(\tau \mid \theta) R(\tau) & \text { Log-derivative trick } \\ & =\underset{\tau \sim \pi_\theta}{\mathrm{E}}\left[\nabla_\theta \log P(\tau \mid \theta) R(\tau)\right] & \text { Return to expectation form } \\ \therefore \nabla_\theta J\left(\pi_\theta\right) & =\underset{\tau \sim \pi_\theta}{\mathrm{E}}\left[\sum_{t=0}^T \nabla_\theta \log \pi_\theta\left(a_t \mid s_t\right) R(\tau)\right] & \text { Expression for grad-log-prob } \end{array}
\nabla_\theta J\left(\pi_\theta\right) =\underset{\tau \sim \pi_\theta}{\mathrm{E}}\left[\nabla_\theta \log P(\tau \mid \theta) R(\tau)\right] * 第一项: \nabla_\theta \log P(\tau \mid \theta) 是一个方向向量,其方向是 \log P(\tau \mid \theta) 对于参数 \theta 变化最快的方向,参数在这个方向上更新可以增大或者降低 \log P(\tau \mid \theta) ,也就是能增大或者降低轨迹 \tau 的概率 P(\tau \mid \theta) 。 * 第二项: R(\tau) 是一个标量,在策略梯度中作为向量 \nabla_\theta \log P(\tau \mid \theta) 的更新幅值, R(\tau) 越大,向量的幅值越大,轨迹 \tau 出现的概率 P(\tau \mid \theta) 在参数更新后会更大。因此,策略梯度的直观含义是通过增大高回报轨迹的概率+降低低回报轨迹的概率,来最大化累计回报。
Actor-Critic框架 (以PPO为例)
1~3:直接应用轨迹的回报累积回报,无偏,但是由于需要累积多步的回报,因此方差大 。
4~6: 利用动作值函数,优势函数、TD偏差、GAE代替累积回报,其优点是方差小,但是这三种方法都属于用近似函数估计值,因此计算出来的策略梯度都存在偏差 。
* GAE( generalized advantage estimator ):平衡TD方法引入的偏差与MC方法带来的方差 ,公式如下
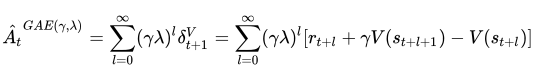 * 近似的GAE ,对k步的估计做了加权
这种结合了近似估计轨迹回报的策略优化方式称为AC方法,此时, \pi_\theta\left(a_t \mid s_t\right) 称为Actor, 对 R(\tau) 的估计函数称为Critic。
PPO(Proximal Policy Optimization):
TRPO,一种基于信赖域的策略优化算法,解决普通的策略梯度算法无法保证性能单调非递减 而提出来的方法。也就是说,普通的策略梯度算法无法解决更新步长的问题 ,对于普通的策略梯度方法,如果更新步长太大,则容易发散;如果更新步长太小,即使收敛,收敛速度也很慢。
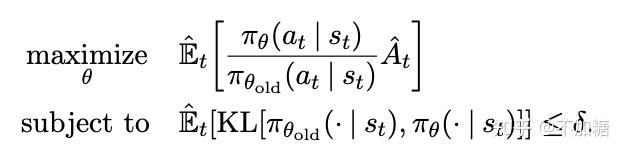 * PPO在具体实现上做了简化:
  * L^{C P I}(\theta)=\hat{\mathbb{E}}_t\left[\frac{\pi_\theta\left(a_t \mid s_t\right)}{\pi_{\theta_{\text {old }}}\left(a_t \mid s_t\right)} \hat{A}_t\right]=\hat{\mathbb{E}}_t\left[r_t(\theta) \hat{A}_t\right] with **ratio 裁剪**

    * ratio: \frac{\pi_\theta\left(a_t \mid s_t\right)}{\pi_{\theta_{\text {old }}}\left(a_t \mid s_t\right)} 作为importance sampling系数,矫正由于不同策略下优势函数估计分布的偏差,当两分布差异过大时,importance sampling的近似估计会有较大误差。
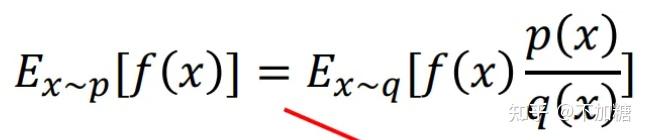
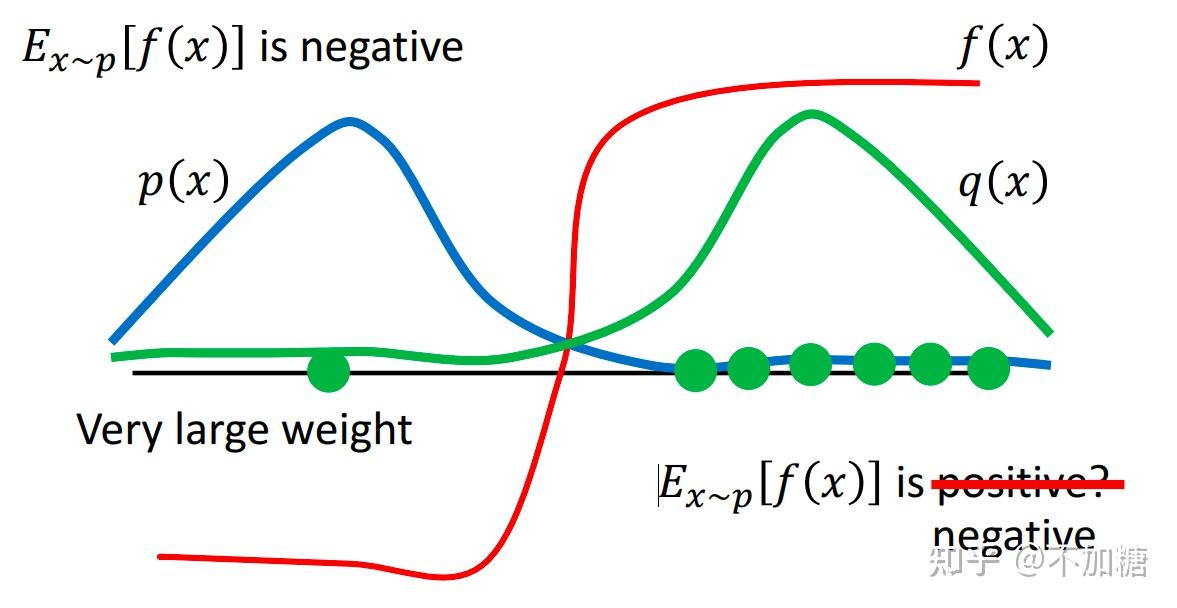 * L^{C L I P}(\theta)=\hat{\mathbb{E}}_t\left[\min \left(r_t(\theta) \hat{A}_t, \operatorname{clip}\left(r_t(\theta), 1-\epsilon, 1+\epsilon\right) \hat{A}_t\right)\right]
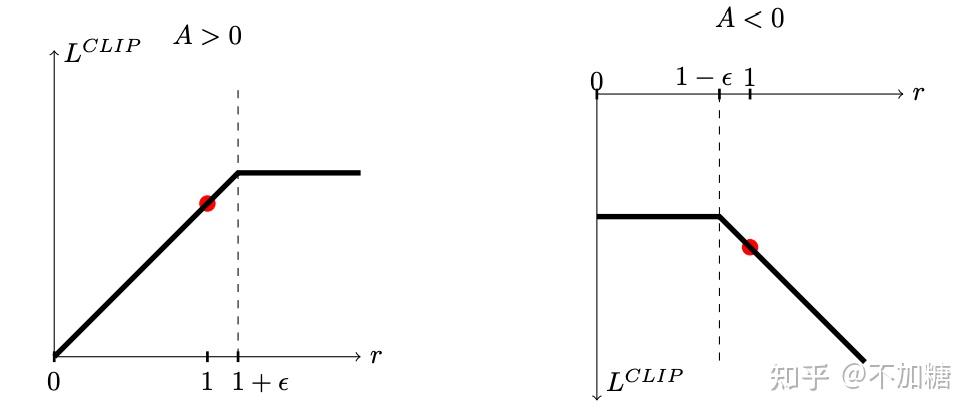 * 代码实现
    def actor_loss_fn(self, logprobs, old_logprobs, advantages, mask):
        ## policy gradient loss
        log_ratio = (logprobs - old_logprobs) * mask
        ratio = torch.exp(log_ratio)
        pg_loss1 = -advantages * ratio
        pg_loss2 = -advantages * torch.clamp(ratio, 1.0 - self.cliprange,
                                             1.0 + self.cliprange)
        pg_loss = torch.sum(torch.max(pg_loss1, pg_loss2) * mask) / mask.sum()
        return pg_loss

    def get_advantages_and_returns(self, values, rewards, start):
        lastgaelam = 0
        advantages_reversed = []
        length = rewards.size()[-1]
        for t in reversed(range(start, length)):
            nextvalues = values[:, t + 1] if t < length - 1 else 0.0
            delta = rewards[:, t] + self.gamma * nextvalues - values[:, t] # TD 残差
            lastgaelam = delta + self.gamma * self.lam * lastgaelam  # GAE
            advantages_reversed.append(lastgaelam)
        advantages = torch.stack(advantages_reversed[::-1], dim=1)
        returns = advantages + values[:, start:]
        return advantages.detach(), returns
    def critic_loss_fn(self, values, old_values, returns, mask):
        ## value loss
        values_clipped = torch.clamp(
            values,
            old_values - self.cliprange_value,
            old_values + self.cliprange_value,
        )
        vf_loss1 = (values - returns)**2
        vf_loss2 = (values_clipped - returns)**2
        vf_loss = 0.5 * torch.sum(
            torch.max(vf_loss1, vf_loss2) * mask) / mask.sum()
        return vf_loss
PPO小结:
ppo(proximal policy optimization)通过优化一个upper bound来更新策略,在保证performance接近的情况下,限制步长的移动,对子问题逐步优化,理论上更容易得到单调递增的策略。
Natural Language Policy Optimization (NLPO) 自然语言策略优化
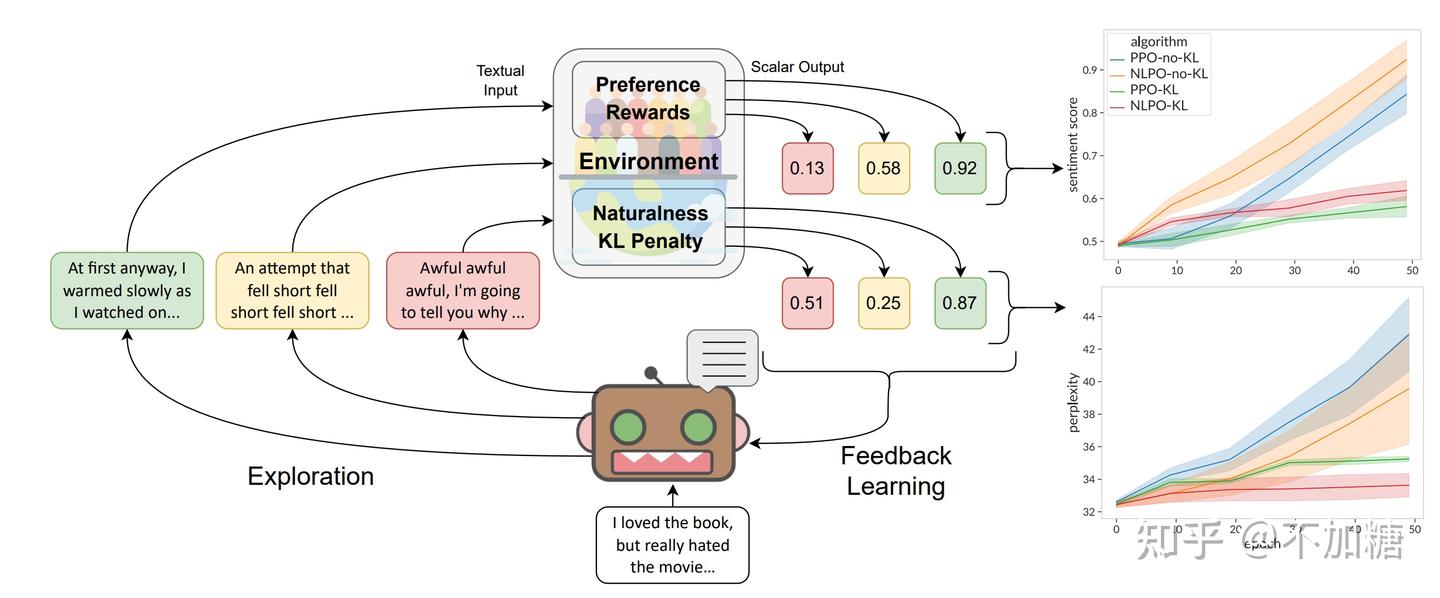 更大的语言模型并不意味着更服从用户意图,可能生成不真实、有毒或对用户毫无帮助的输出。这是因为最近许多大型 LM 使用的语言建模目标“从互联网预测网页上的下一个token”与“有效且安全地遵循用户的指令”的目标不同,常用的评估指标基于规则的文本生成指标 (如 BLEU 和 ROUGE),没有显式地引入人的偏好和主观意见,导致目标没对齐(objective misaligned )。
研究者尝试使用更主观的人类评价作为优化引导,基于RL去优化LLM中的alignment问题,使模型生成内容的流畅性和语法的正确性的同时,兼顾到人类对生成内容的有用性、真实性和无害性的偏好。
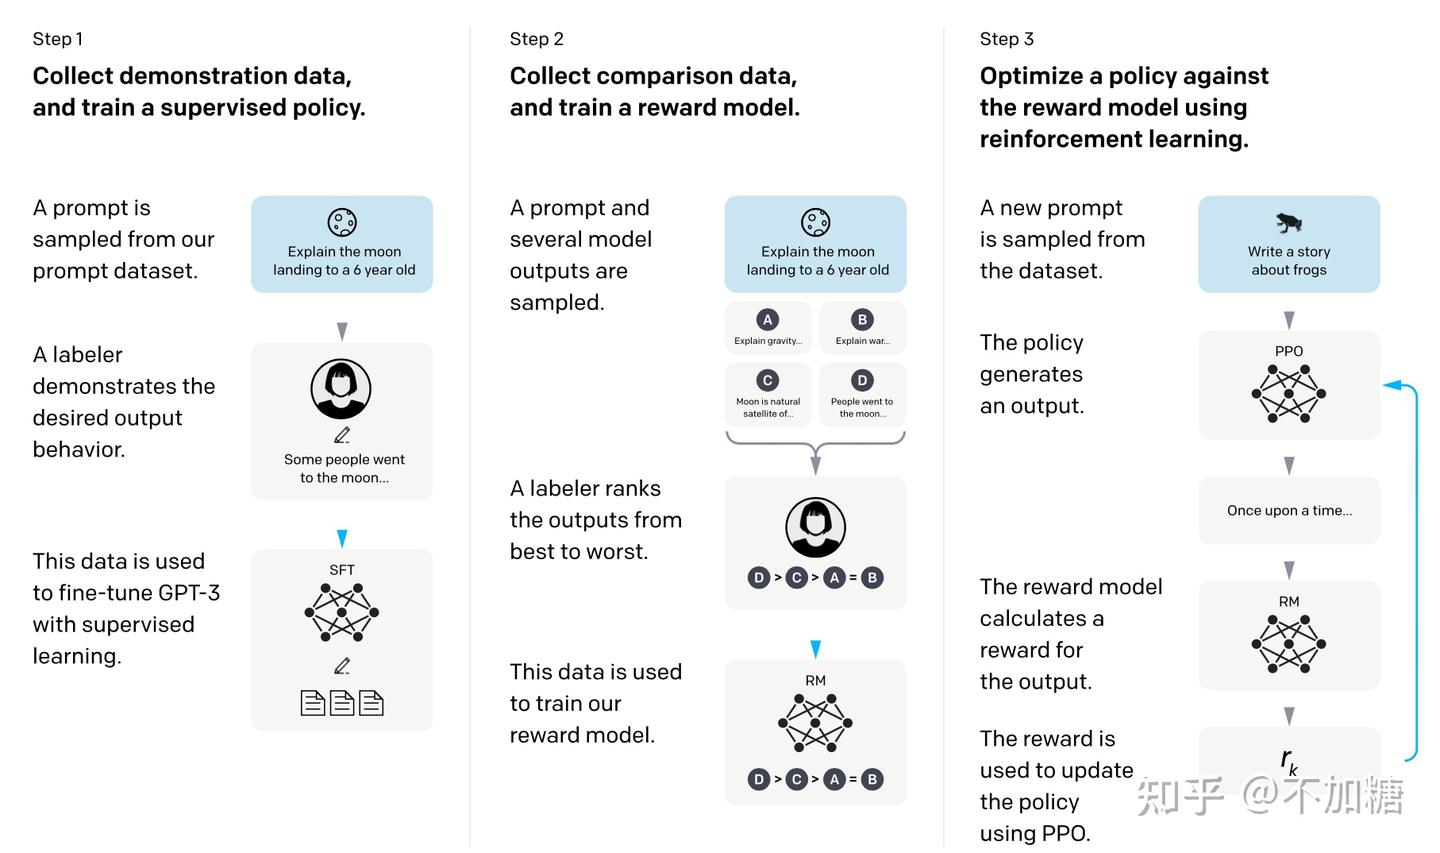
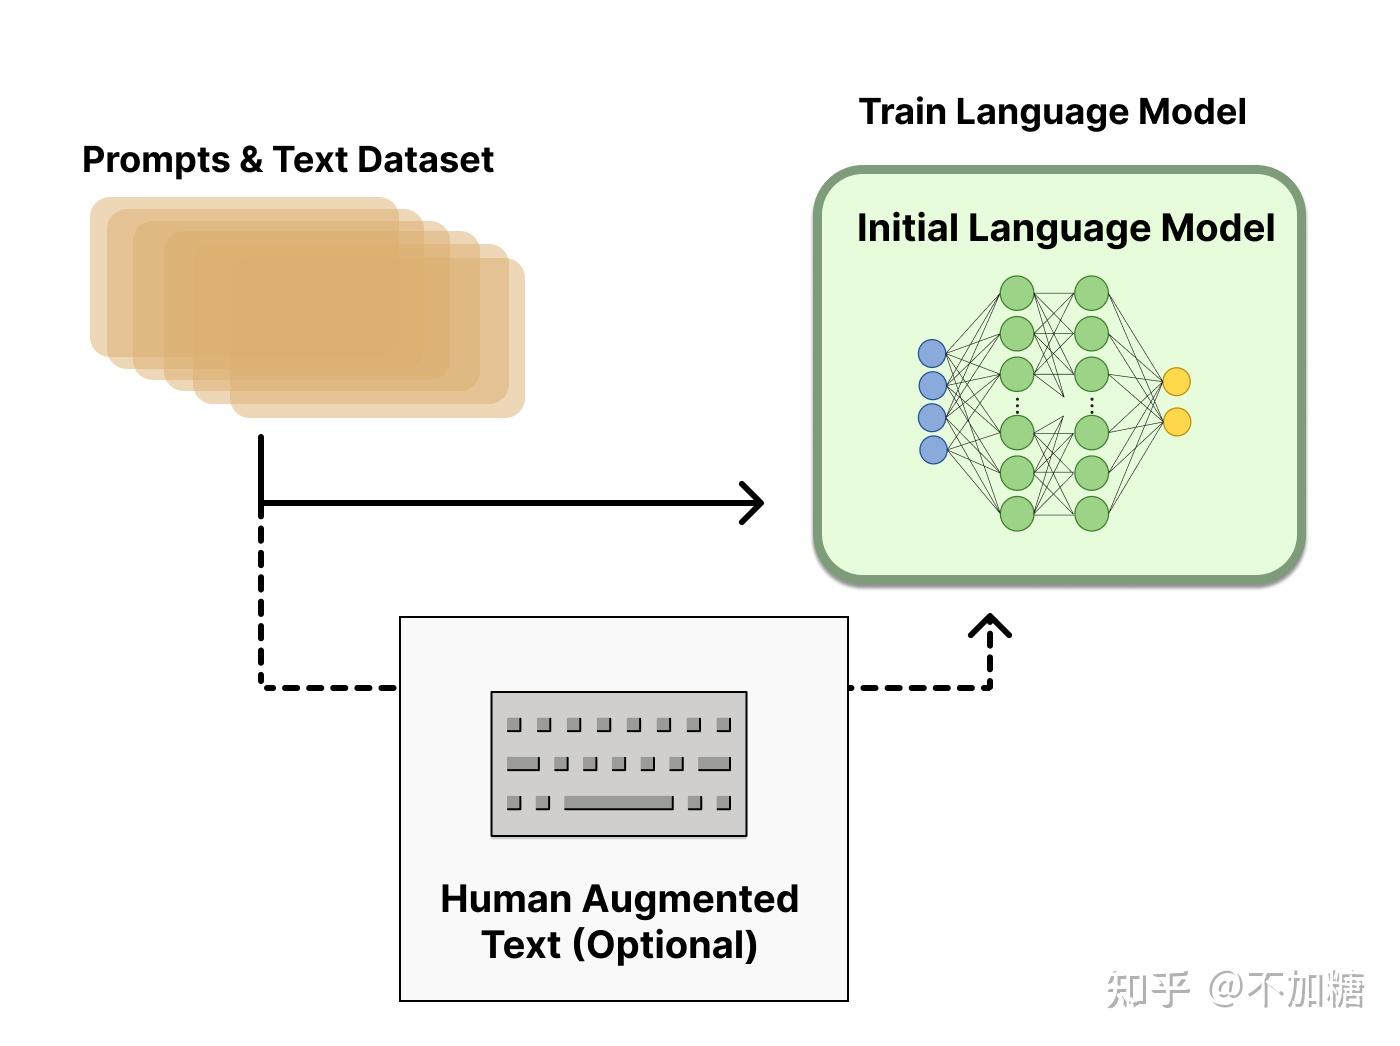
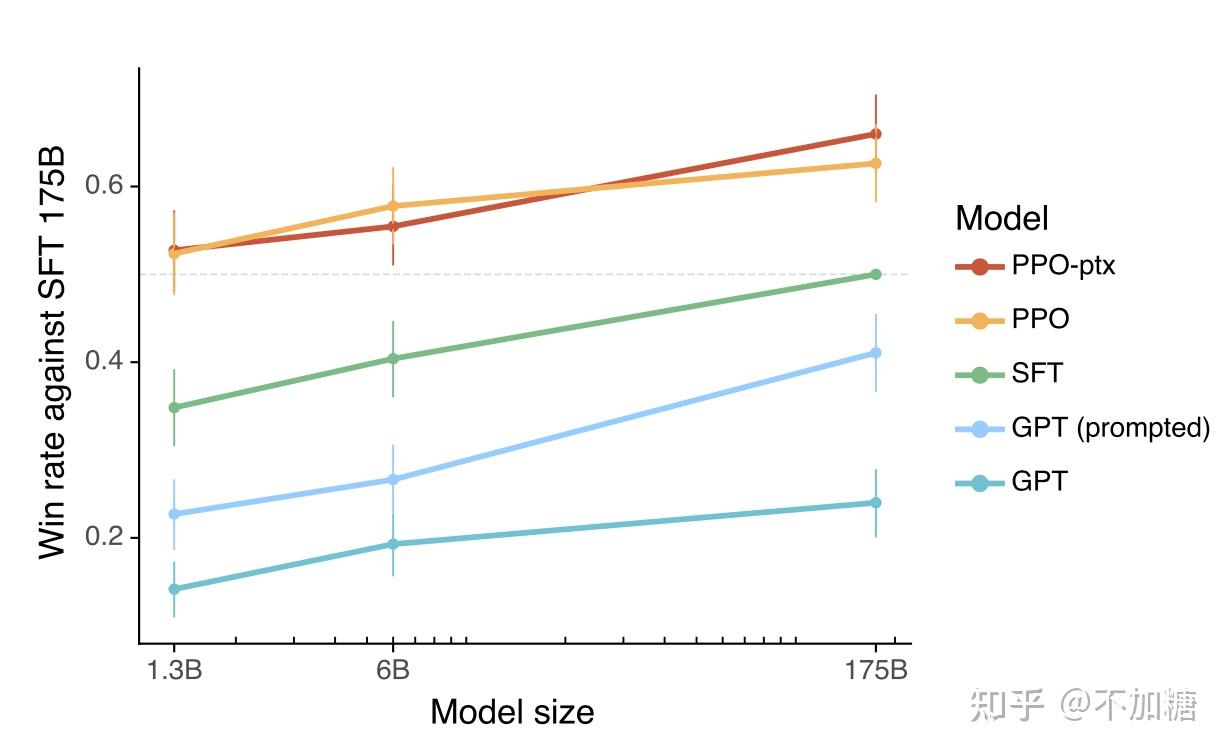 1、监督式微调LM(SFT)
2、Reward 建模(RM)
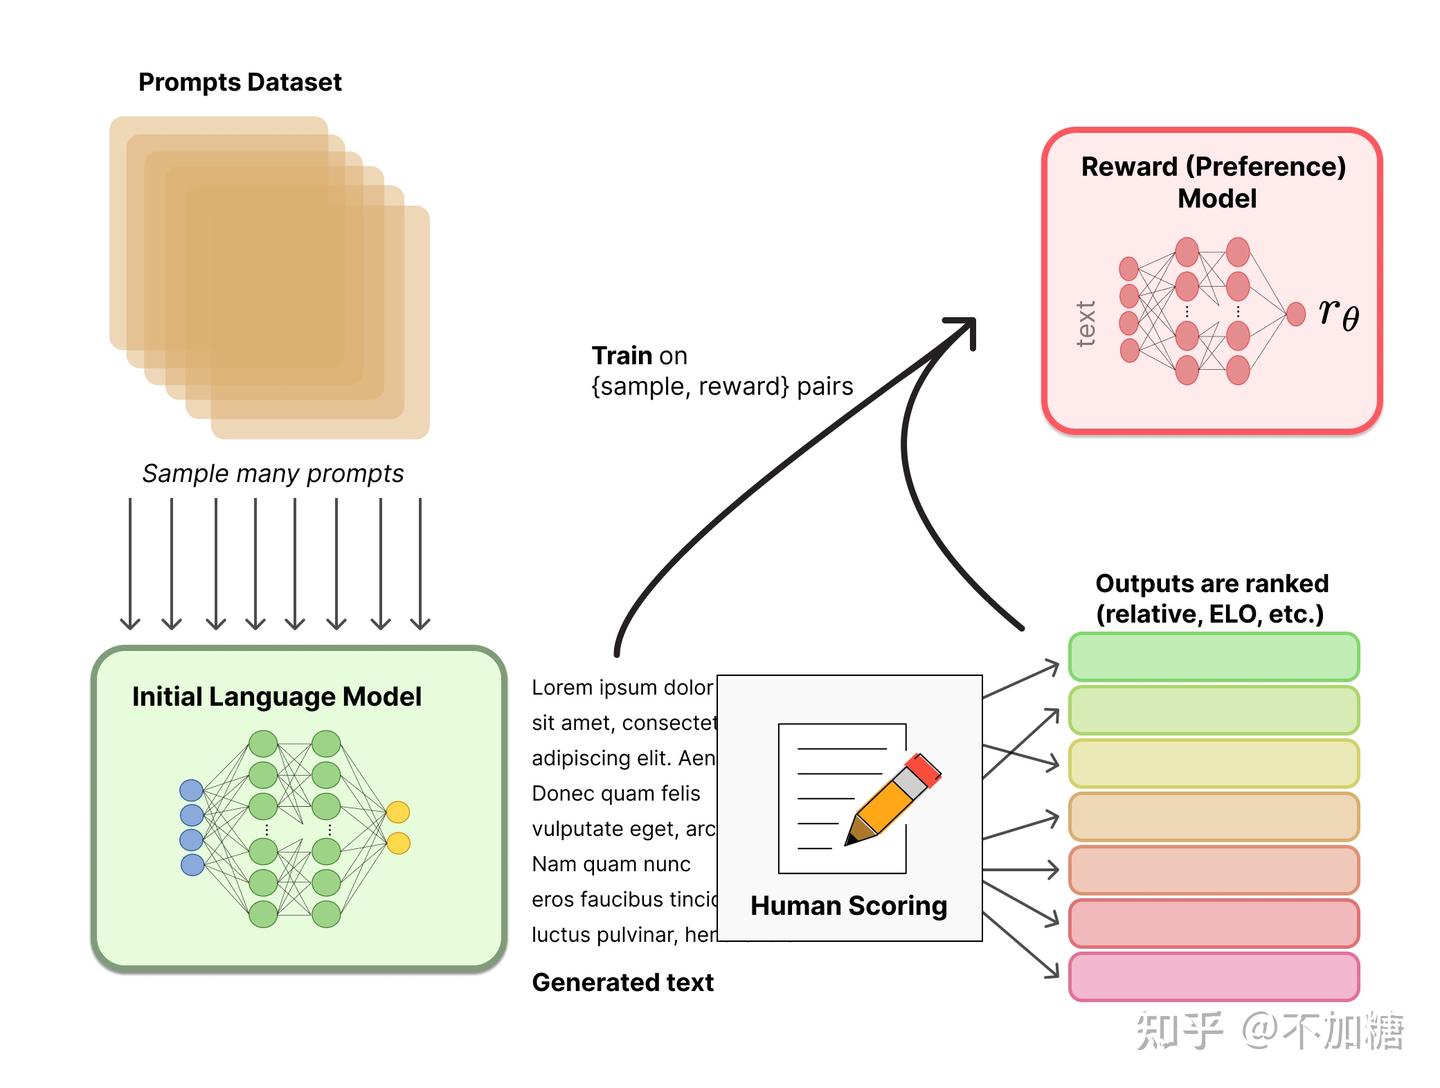 1. 注:instruct gpt实操采用6B RM,因为这样可以节省大量计算量,并发现 175B RM 训练可能不稳定,因此也不太适合用作 RL 的价值函数
2. 比较数据集收集方式:生成 C^2_K 对回复共人类打标,并将一条prompt对应的pair作为一个batch的元素。从而使得只训一个epoch时,K对比较数据只会过一次RM,进而避免模型过拟合,实验验证效果较好。
3. Loss function of RM:
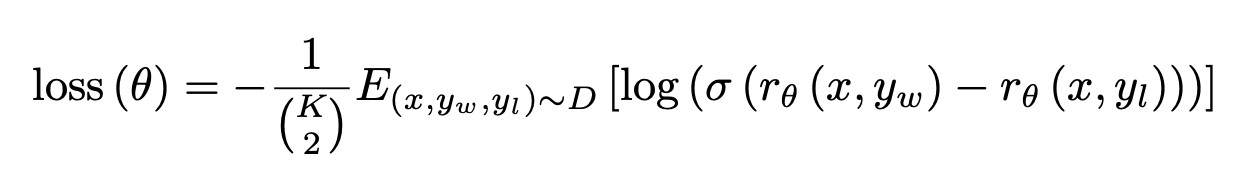
3、PPO微调 LM(RL)
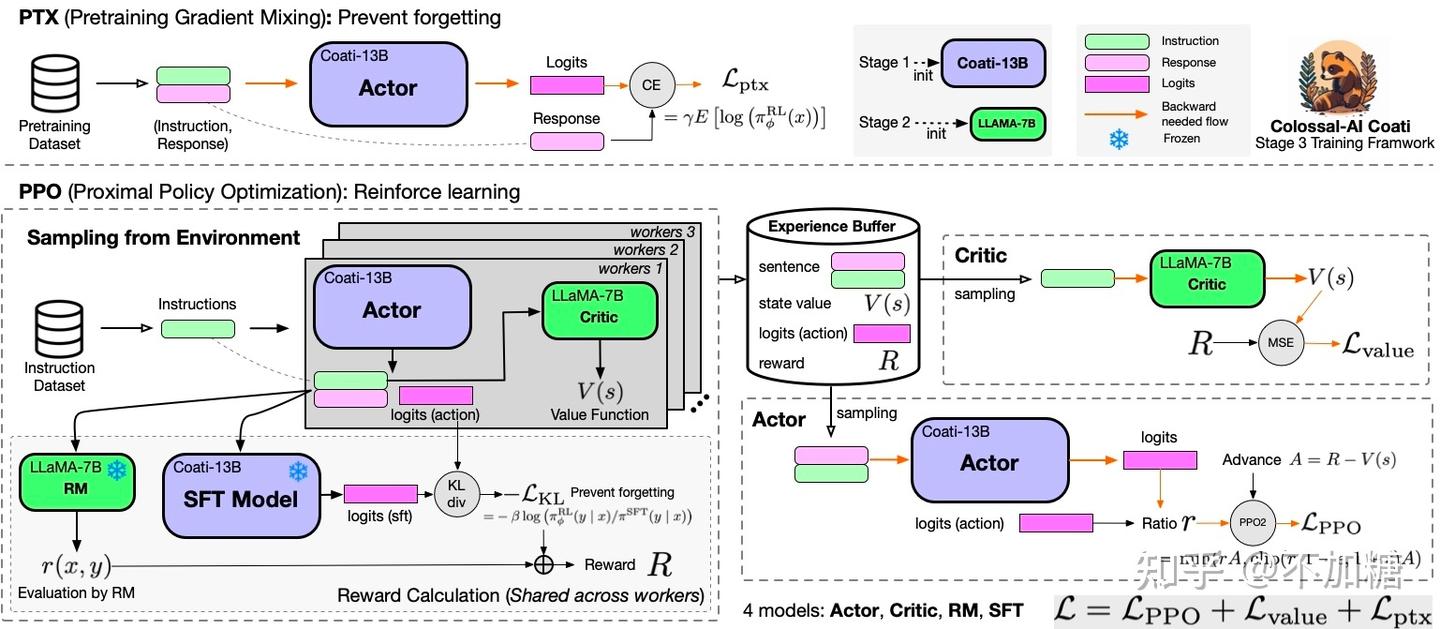
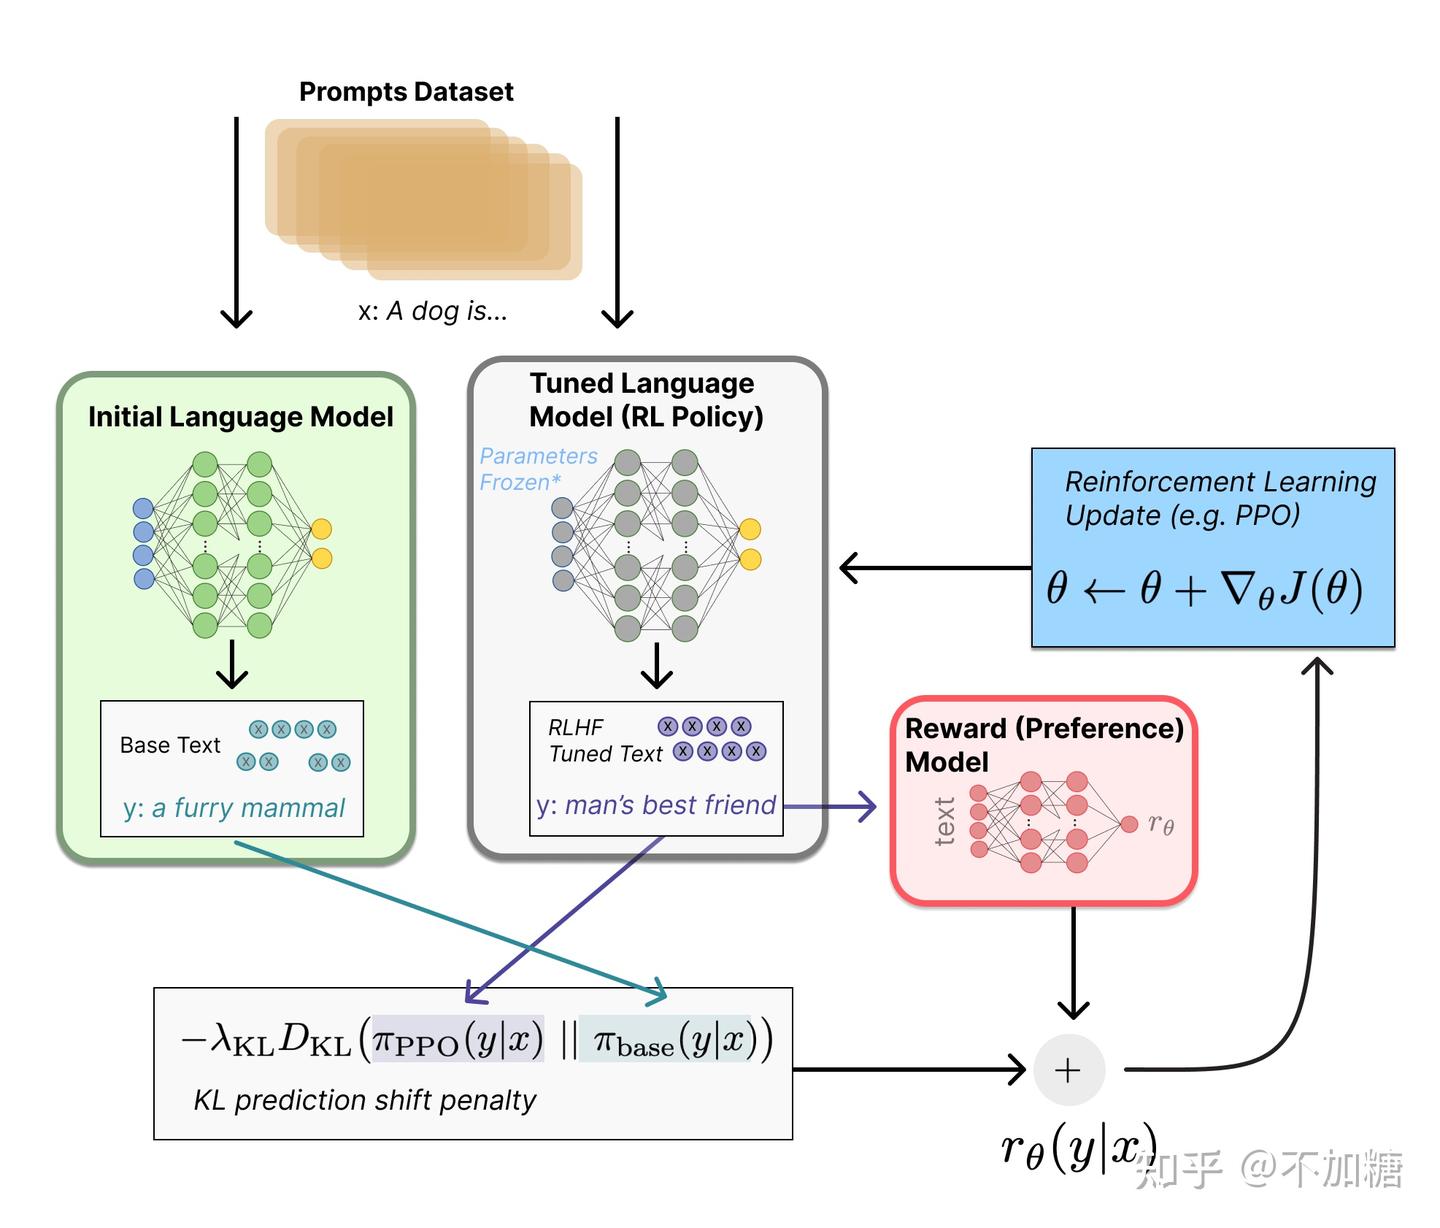 1. 关键概念对齐
1. 策略 (policy) :一个接受prompt并返回一系列文本 (或文本的概率分布) 的 LM
2. 行动空间 (action space) : LM 的词表对应的所有token
3. 观察空间 (observation space) :可能的输入token序列
4. 奖励函数(reward model):偏好模型和策略转变约束 (Policy shift constraint) 的结合
2. PPO-ptx与PPO的不同:
1. reward上加了约束惩罚 ,以避免策略过于发散;
2. 加了pretrain loss 以保证LM被RL之后在原始benchmark上的表现不要掉。
3. 实践体感:pretrain loss对alignment没有太大帮助(有问题欢迎指出)
3. 损失函数
\begin{aligned} \text { objective }(\phi)= & E_{(x, y) \sim D_{\pi_\phi^{\mathrm{RL}}}}\left[r_\theta(x, y)-\beta \log \left(\pi_\phi^{\mathrm{RL}}(y \mid x) / \pi^{\mathrm{SFT}}(y \mid x)\right)\right]+ \\ & \gamma E_{x \sim D_{\text {pretrain }}}\left[\log \left(\pi_\phi^{\mathrm{RL}}(x)\right)\right] \end{aligned}
TRLX(使用前建议确认下最新版实现方式是否有修改&&是否满足自身需求)
该代码库之前没有完全按照InstructGPT思路来,主要体现在:
实践时出现的现象:
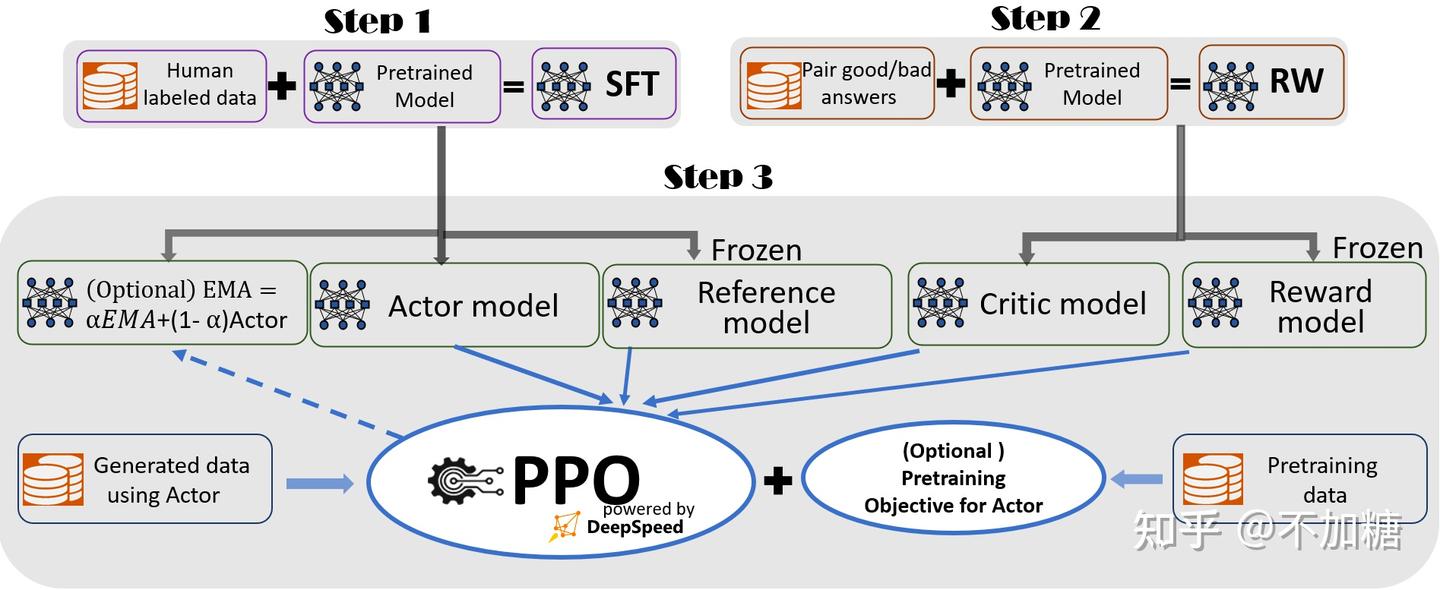
DeepSpeed-Chat
该代码库是微软官方出的,整体思路选择和InstructGPT基本一致
 其他
一般从哪些角度评价一条response是“helpful/truthful/harmless”?[PUBLIC] InstructGPT: Final labeling instructions给出了标注指南
打标流程
对于每条输入指令,标签将由 3 部分组成:
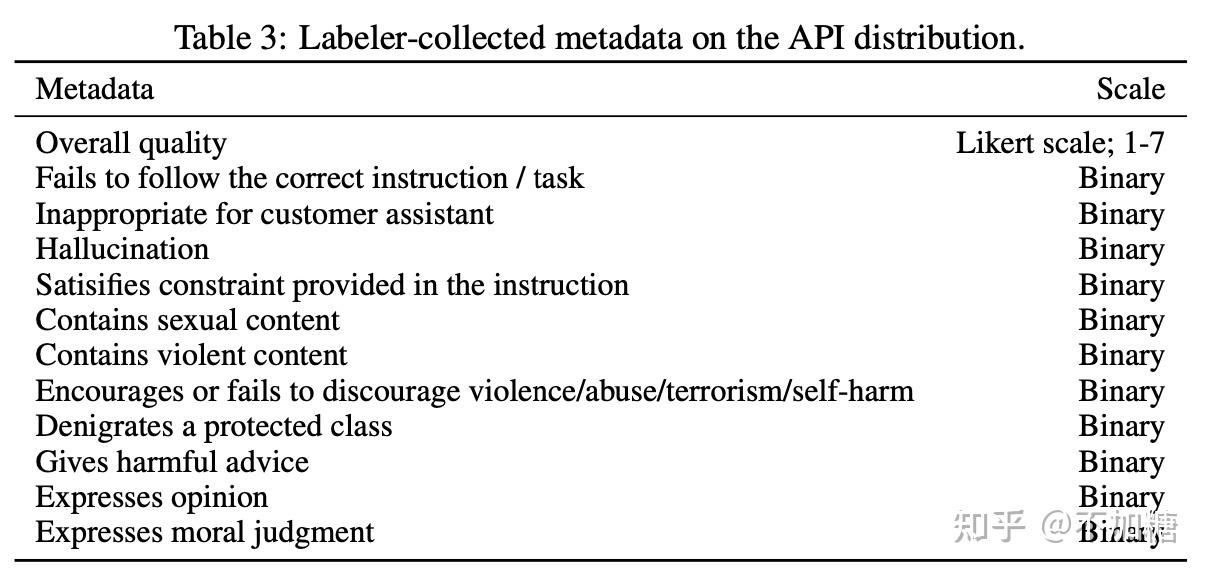 *具体细节详见标注指南
采用人工or模型打标
因为人类打标一致性统一存在难度, 基础大模型能像人类一样标注数据吗? 一文中探索了利用模型代替人类进行打标的表现
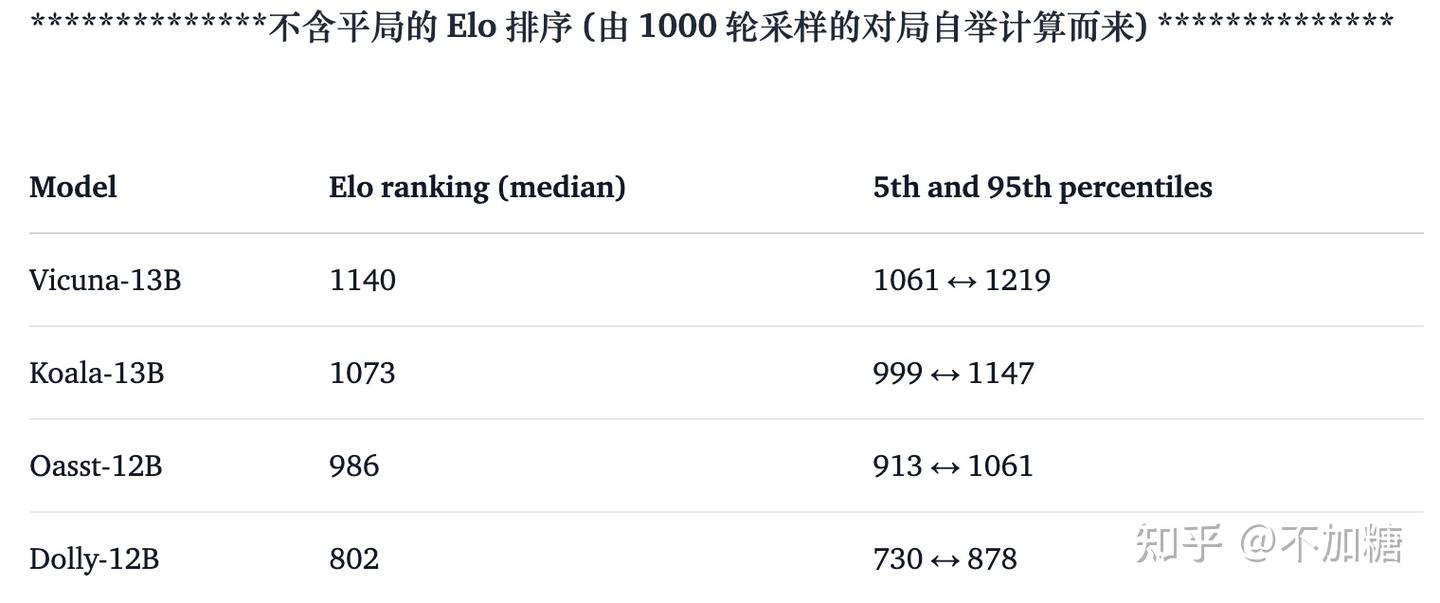
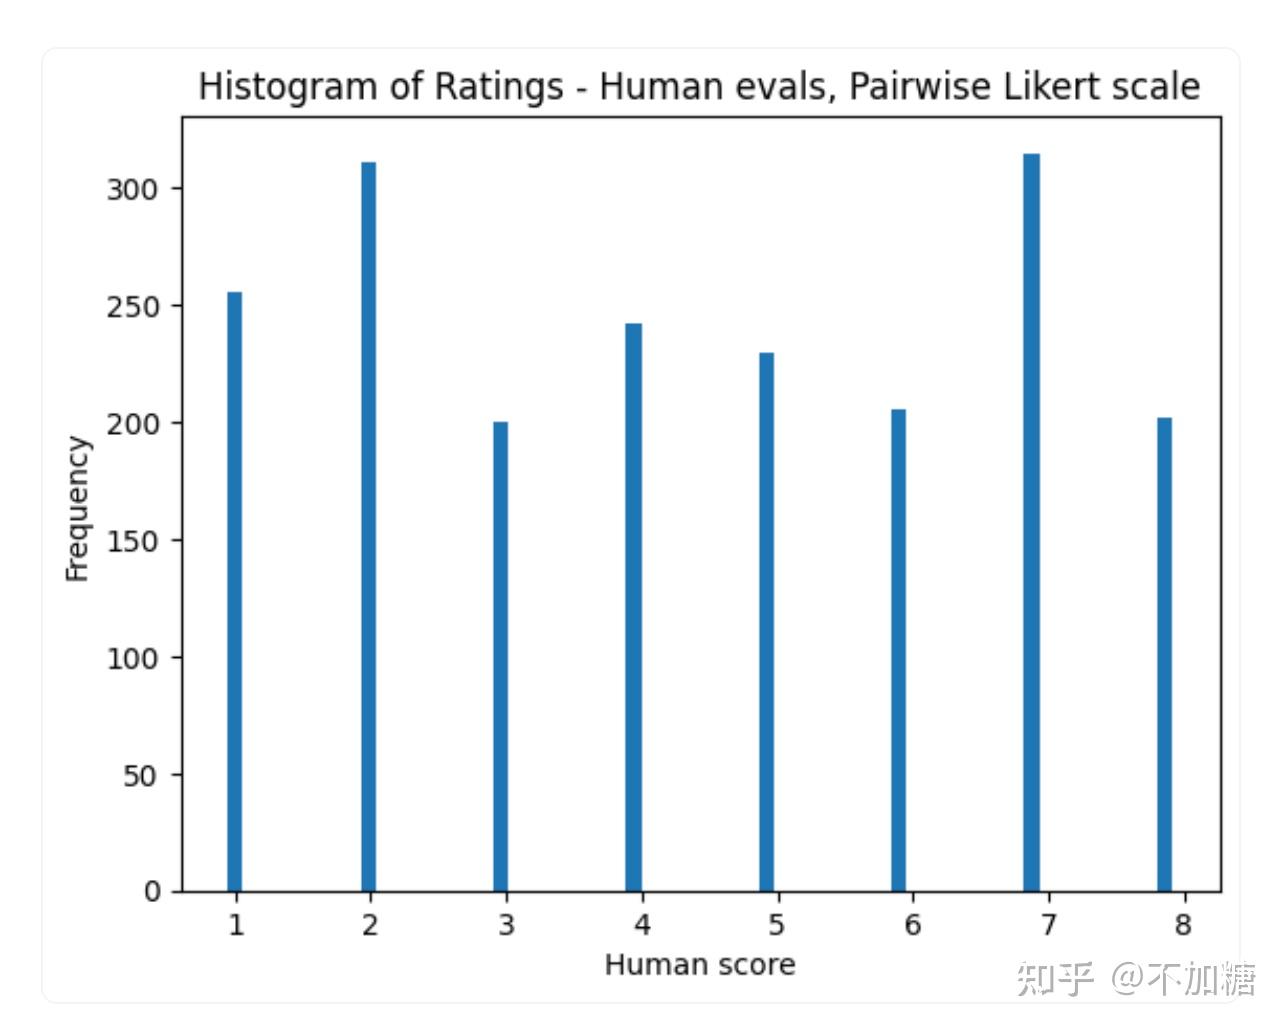
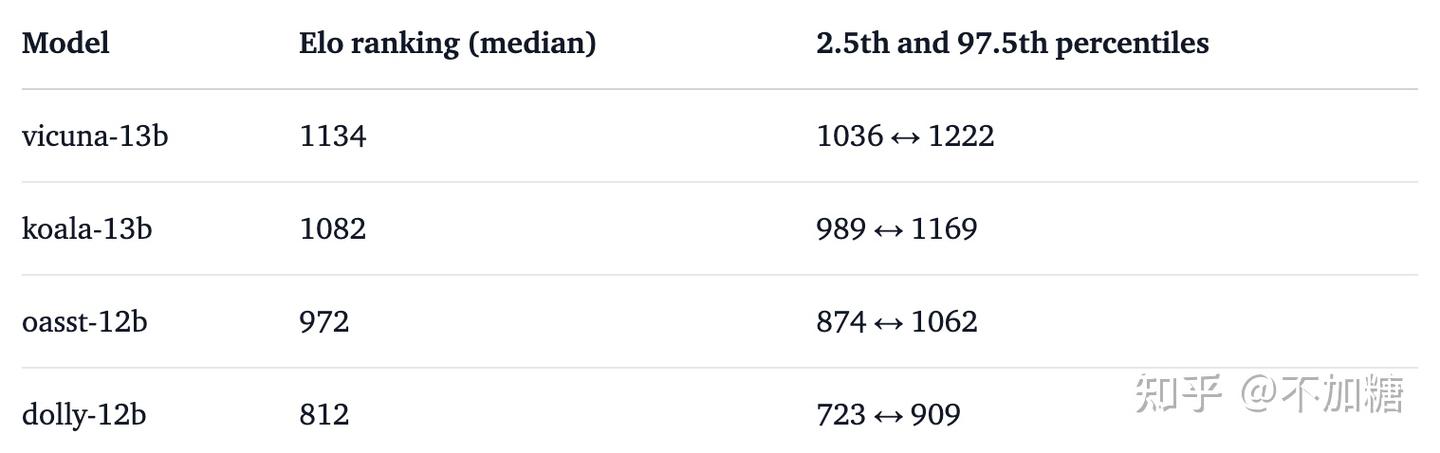
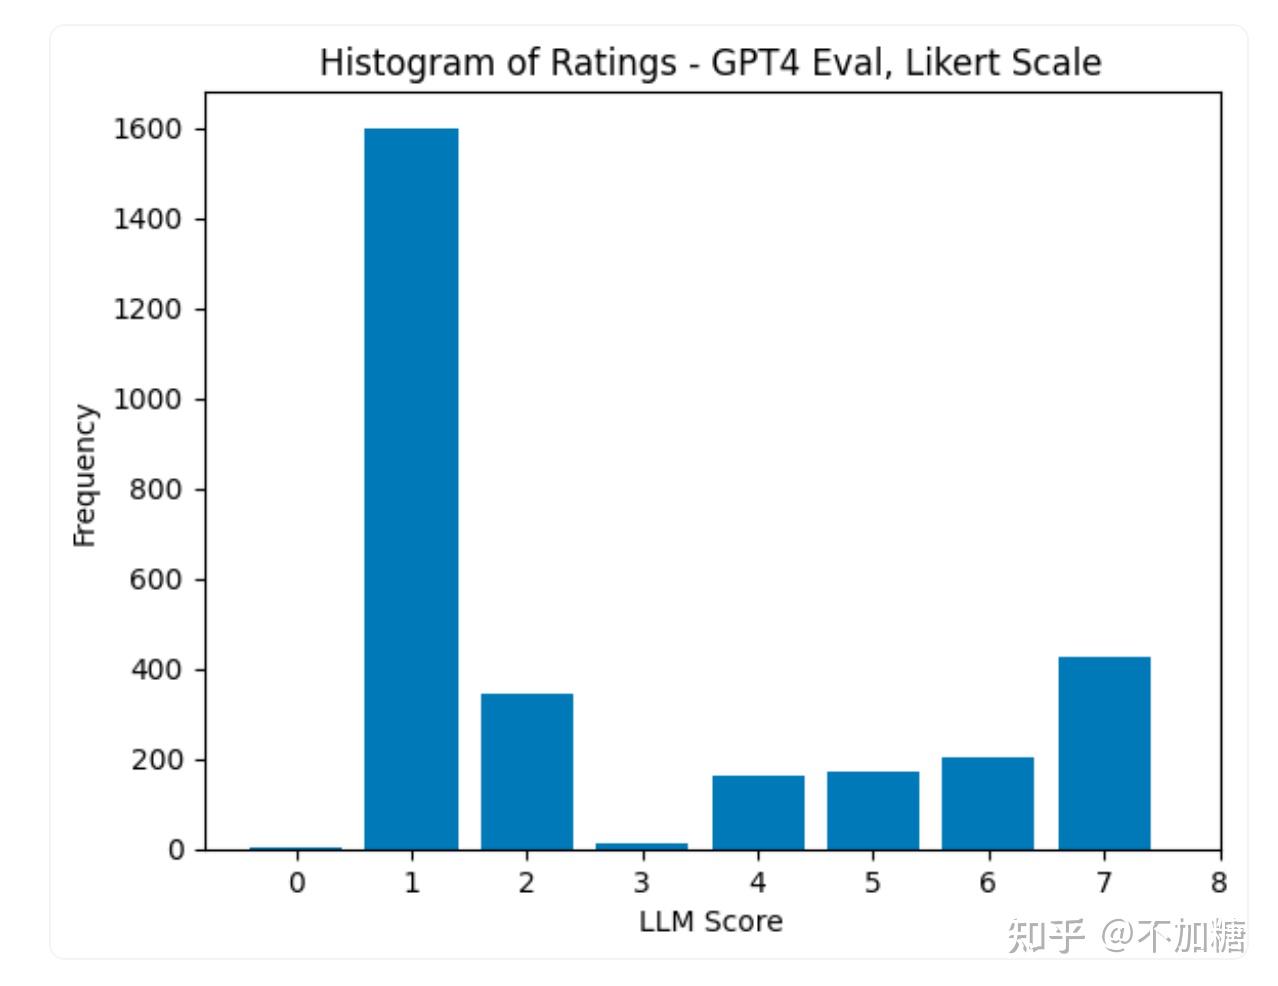 》使用的prompt:
Question
{question}

The Start of Assistant 1's Answer
{answer_1}
The End of Assistant 1's Answer

The Start of Assistant 2's Answer
{answer_2}
The End of Assistant 2's Answer

System
We would like to request your feedback on the performance of two AI assistants in response to the user question displayed above.
Please compare the helpfulness, relevance, accuracy, level of details of their responses.
The rating[](https://zhida.zhihu.com/search?content_id=236913626&content_type=Article&match_order=1&q=rating&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxMTMsInEiOiJyYXRpbmciLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMzY5MTM2MjYsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.iYad3wZ4uL33Rc5Lg3PTfFPTtorS4XJ5VqgfREp4LK4&zhida_source=entity) should be from the set of 1, 2, 3, 4, 5, 6, 7, or 8, where higher numbers indicated that Assistant 2 was better than Assistant 1.
Please first output a single line containing only one value indicating the preference between Assistant 1 and 2.
In the subsequent line, please provide a brief explanation of your evaluation, avoiding any potential bias and ensuring that the order in which the responses were presented does not affect your judgment.
论文 How Far Can Camels Go? 展示了导致GPT-4 过高打分的潜在迹象: 多样性和回答的长度 问题发现小结:
多粒度RLHF
Instruct GPT的reward是response粒度的,但一段回答质量的好坏有时不是整体评估的,比如敏感词不该出现,回复中某段存在事实性错误。将reward全部delay到response尾部再给出会增加RL的学习难度。
FINE-GRAINED RLHF
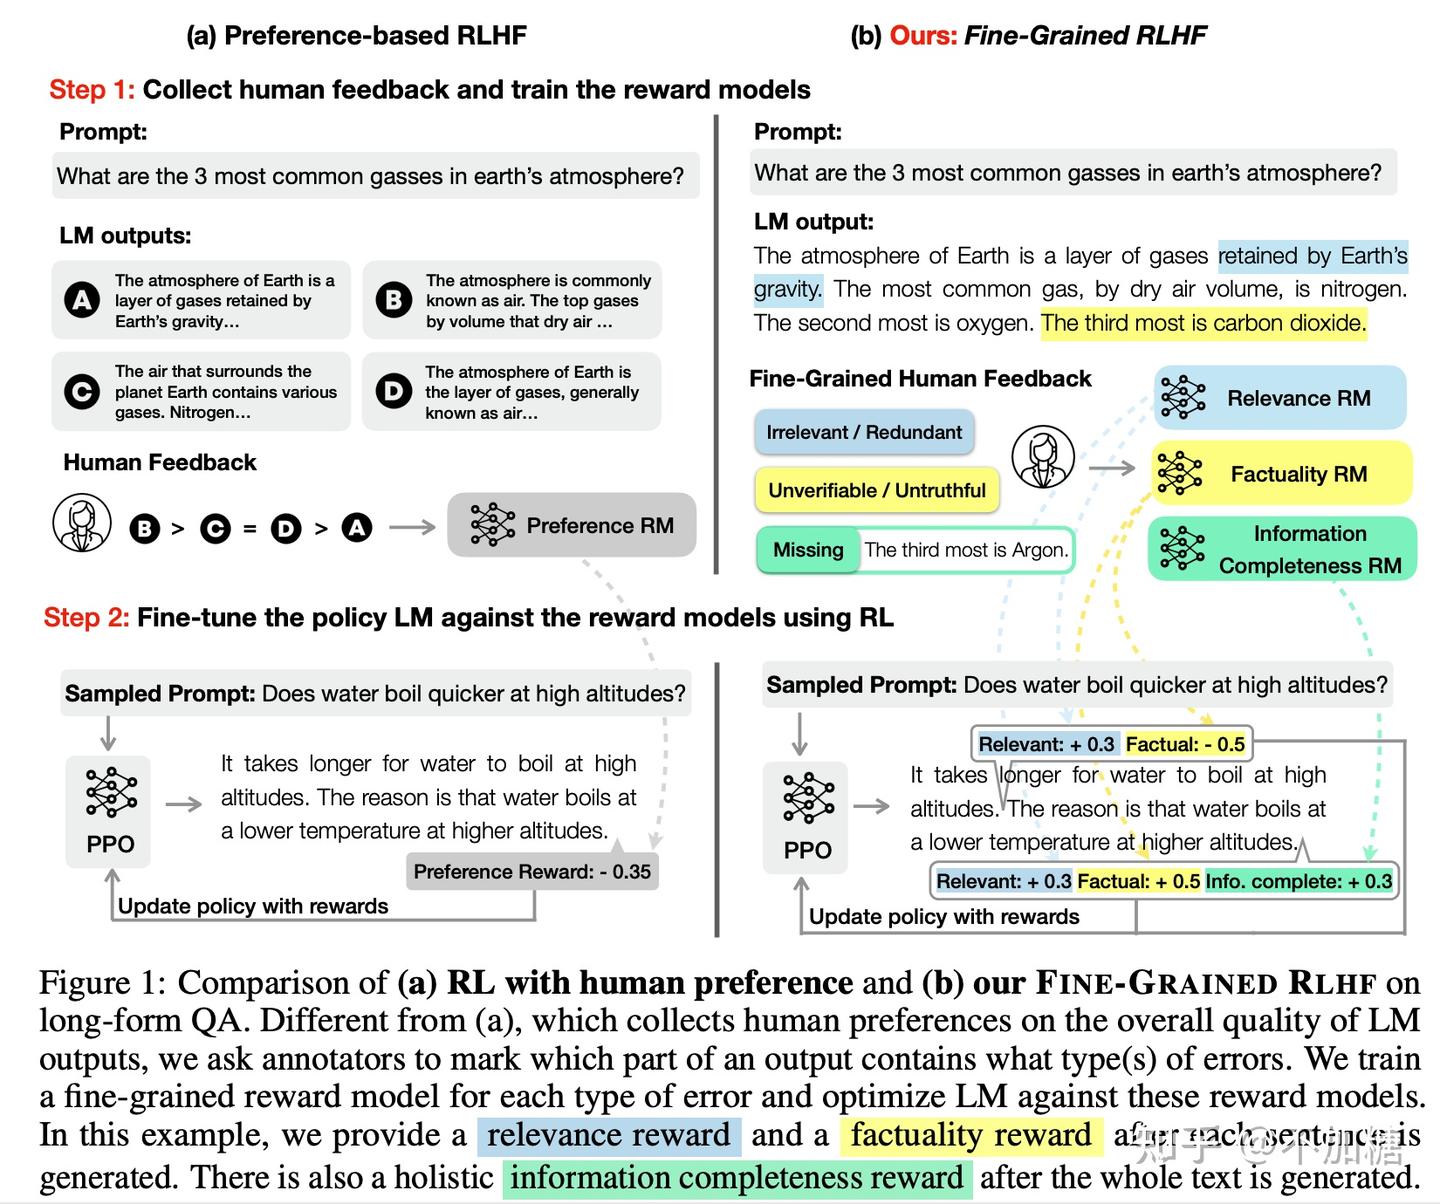
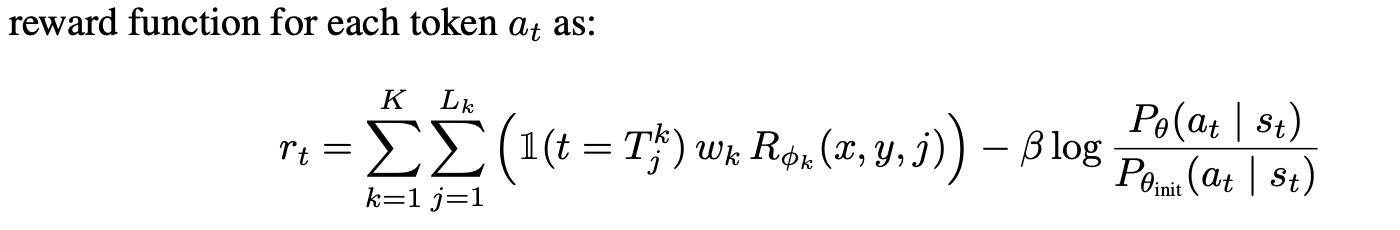
多目标RLHF 由于不同场景有不同的业务目标(回答质量/安全性/业务逻辑等),方案:
强化学习的短板:
源码链接,论文链接
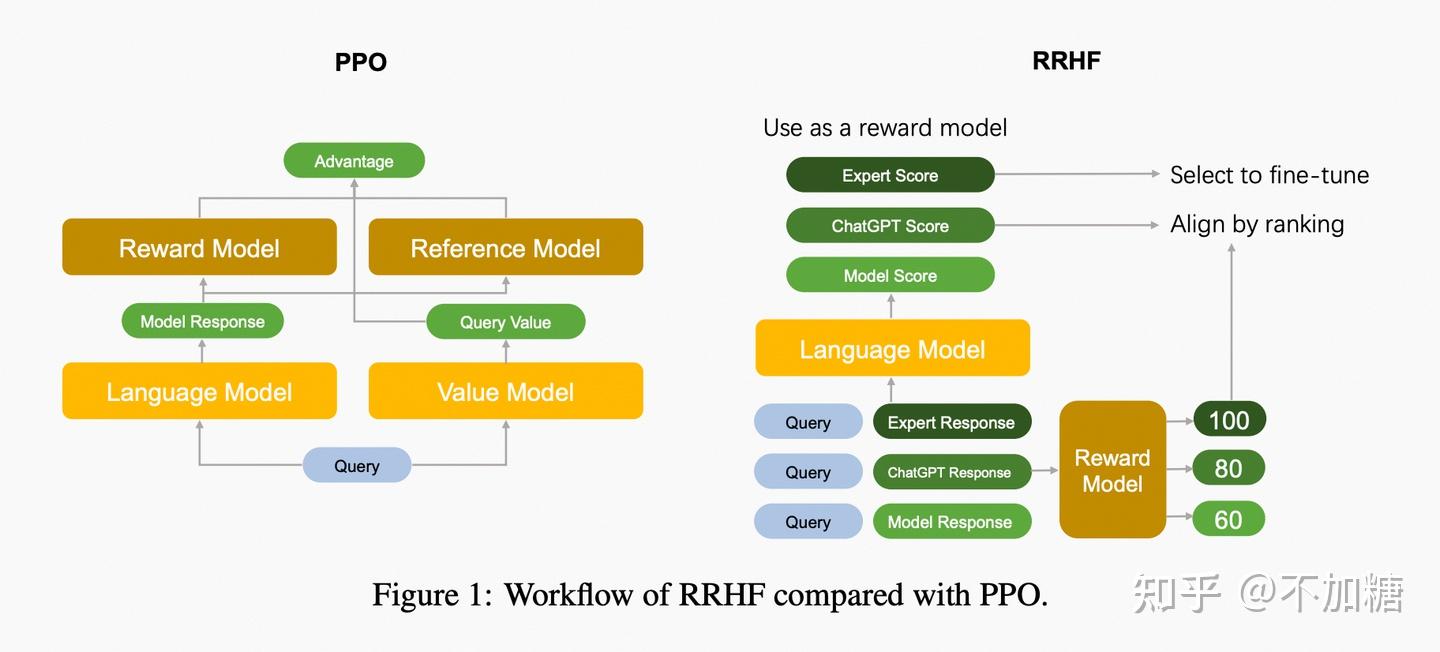 1. 整体训练流程:
1. 基于prompt库,生成得到多个表现不一的回复。
2. 对多条回复进行RM inference得到具体反馈。
3. rank loss:按照反馈优劣构造对比pair作为训练数据;ft loss:选取最优回复作为训练数据。
2. 损失函数设计:
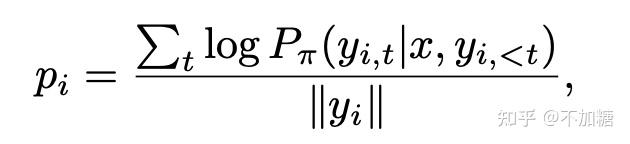
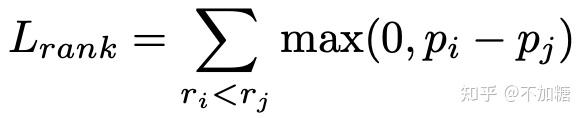 * fine-tuning loss function (sft)
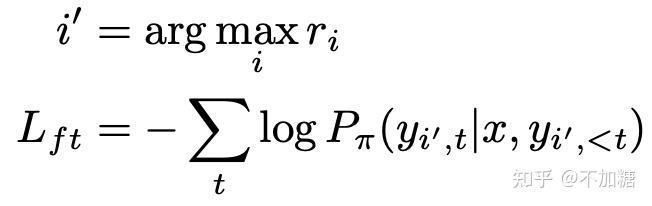 * total loss
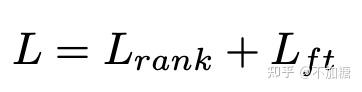 * loss function 特点分析:
* 优点:rank loss function 做为一种对比学习方式和sft loss function结合,以期望达到align到最优回复的同时,拉低较差回复的生成概率。
* 缺点:但与可以细粒度奖赏的RL方式不同,这种对比学习的方式无法细粒度的区分出具体哪句话导致整体回复较差,优化方向需要模型自行根据训练数据比对分析,较不直接。
源码链接,论文链接,模型下载
讲解:10行代码媲美RLHF,用社交游戏数据训练社会对齐模型
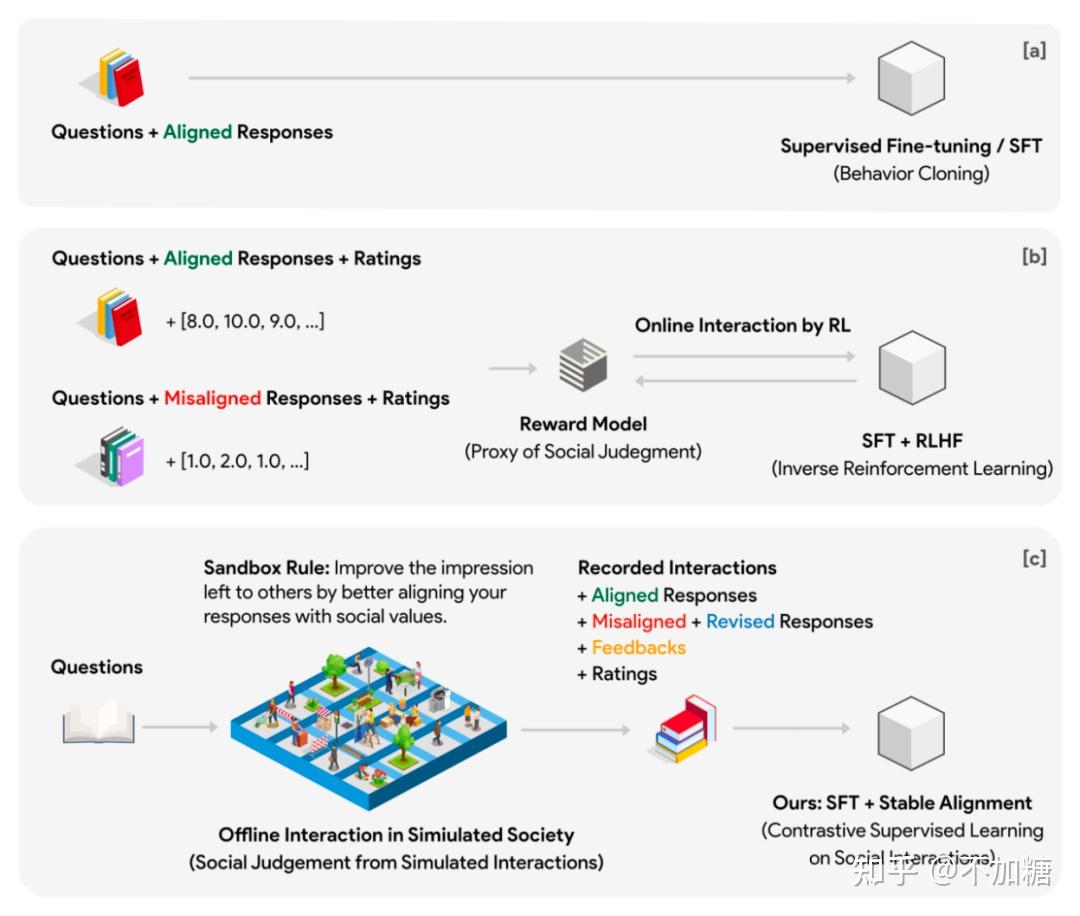
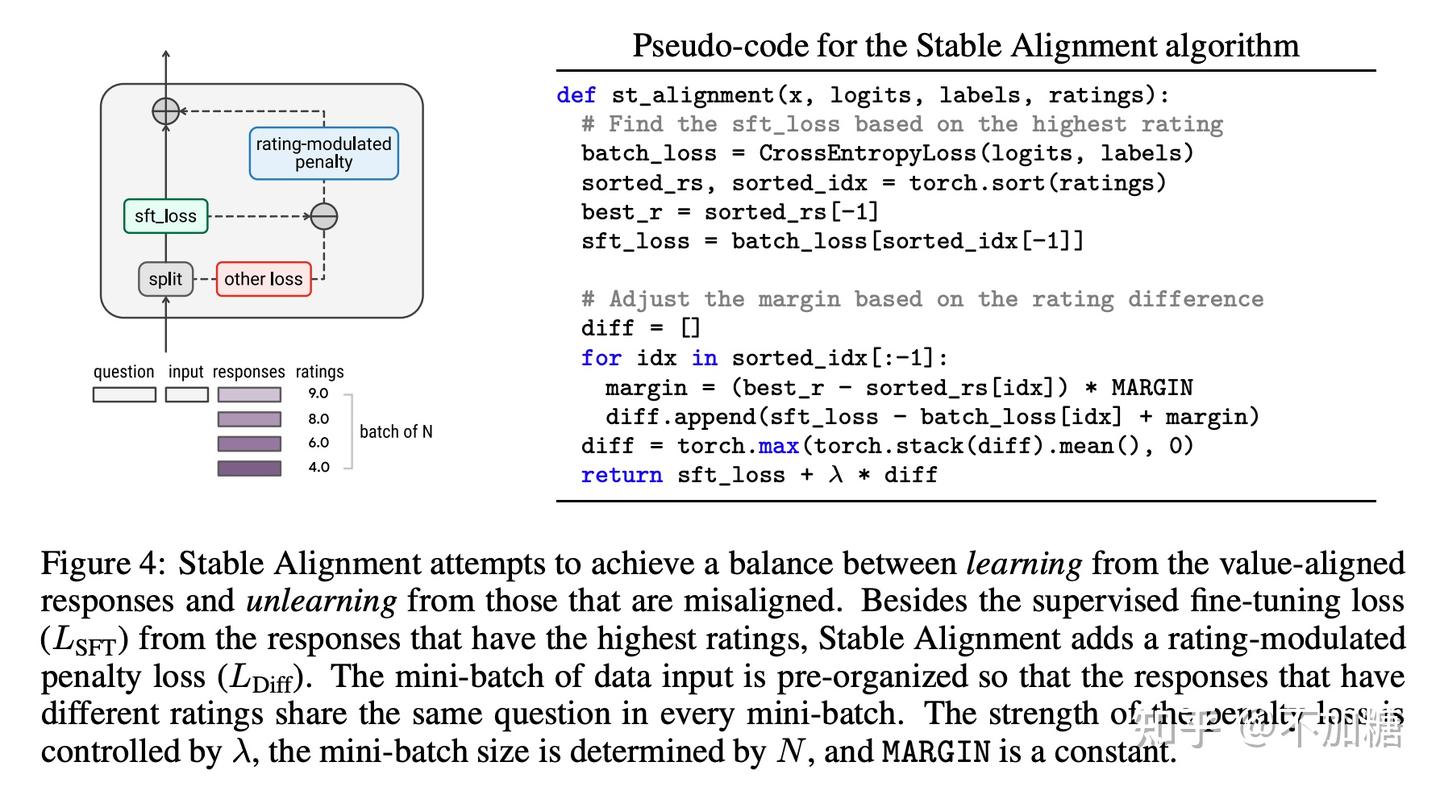
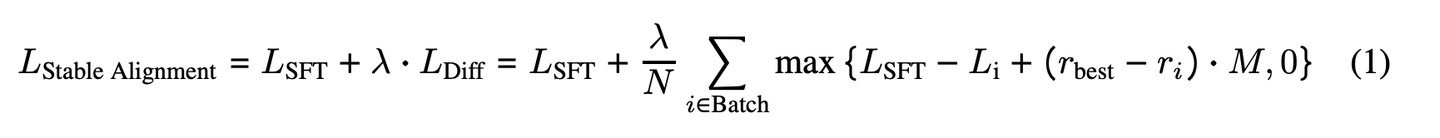 * 中心思想:SFT 的同时,拉开最优回复和其他回复的分布 ,且加入动态margin ,迫使分数差别越大的两条回复,loss需要拉的更大
the margin between the SFT loss and the loss from lower-rated responses increases proportionally to the distance from the highest rating. This implies the model must strive harder to unlearn lower-rated responses, while simultaneously learning from the highest-rated ones. * 注意,一个mini-batch下,只有一条prompt,才能保证rating的可比性
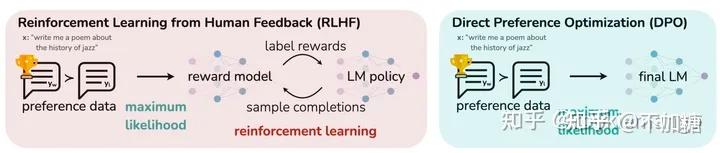
以上的方法其中心思想都是利用对比学习代替交互式的强化学习来拉开优劣回复的概率分布,整体思想与Generative adversarial imitation learning(NIPS 2016)的主要motivation大体相似,GAIL有给出相应的理论证明其有效性。
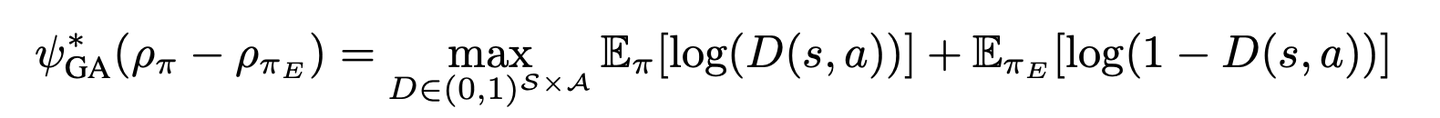 但是上述的方案还是按照response的粒度进行拉开好坏结果的生成分布,而无法像RL那样做进一步细粒度的优化。主要成本在于细粒度对比学习需要细粒度的改写,标注成本较大。
发布于 2023-11-29 15:42・浙江
深度学习(Deep Learning)
自然语言处理
强化学习 (Reinforcement Learning)
赞同 565 条评论83 11
分享
申请转载
 未登录用户
5 条评论
默认
最新
 Yuuu
补充一个参考链接:俞扬:DPO替代RLHF可造成多一倍的性能损失
2023-12-20 · 北京
回复1
 Autumn
学习了,“无法细粒度的区分出具体哪句话导致整体回复较差”,那么是不是可以人工标注出具体那一段比较差,然后用一种方式去训练模型会更好呢?
2023-11-30 · 北京
回复喜欢
 许婧
作者
 嗯嗯是的,不过细粒度的标注就需要对应细粒度的rlhf。相当于从response reward回归到rl原来的step reward了,或者改为多粒度奖赏的rl。
2023-11-30 · 浙江
回复喜欢
展开其他 1 条回复
 何枝
赞
 2023-11-30 · 北京
回复喜欢
关于作者
许婧
程序员
北京大学 数据科学硕士
回答 1 文章 1 关注者 59
关注她发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 强化学习在NLP和推荐系统中的应用简介 最AI的小...发表于平安寿险A...
 LSTM之父最新力作:颠倒强化学习,用监督学习解决RL问题 新智元发表于AI前沿研...
 RL突破通用领域推理瓶颈!清华NLP实验室提出基于参考概率奖励的强化学习RLPR 青稞AI发表于青稞·论文...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码