 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
大模型高效微调PEFT综述-从Adpter、PrefixTuning到LoRA
首发于大模型原理和实战
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
大模型高效微调PEFT综述-从Adpter、PrefixTuning到LoRA
首发于大模型原理和实战
切换模式
 LeonYi
 四川大学 计算机技术硕士
收录于 · 大模型原理和实战
29 人赞同了该文章
目录
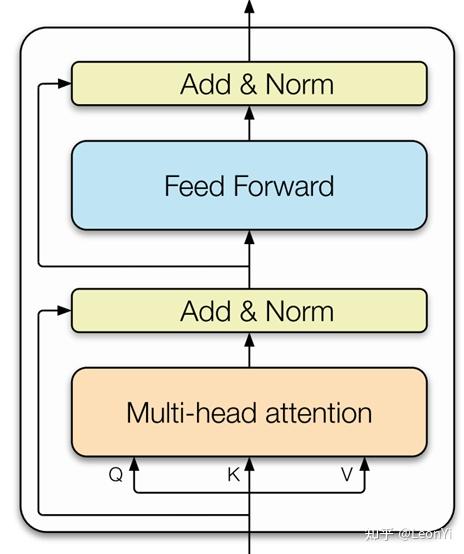 Basic Transformer block
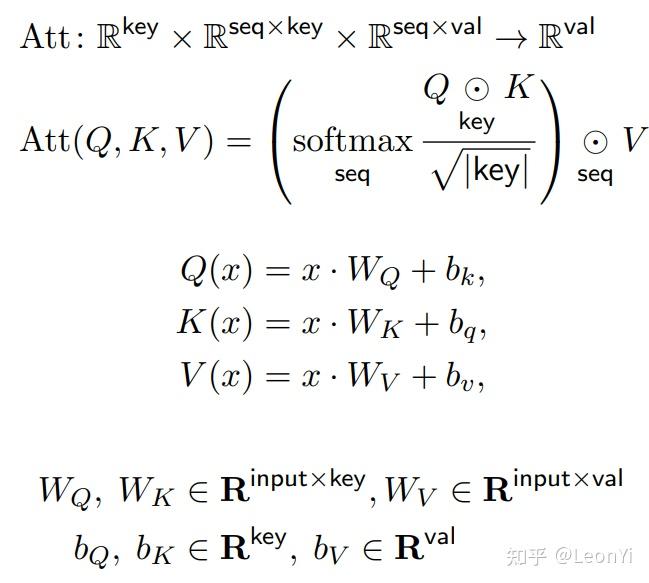 自注意力模块
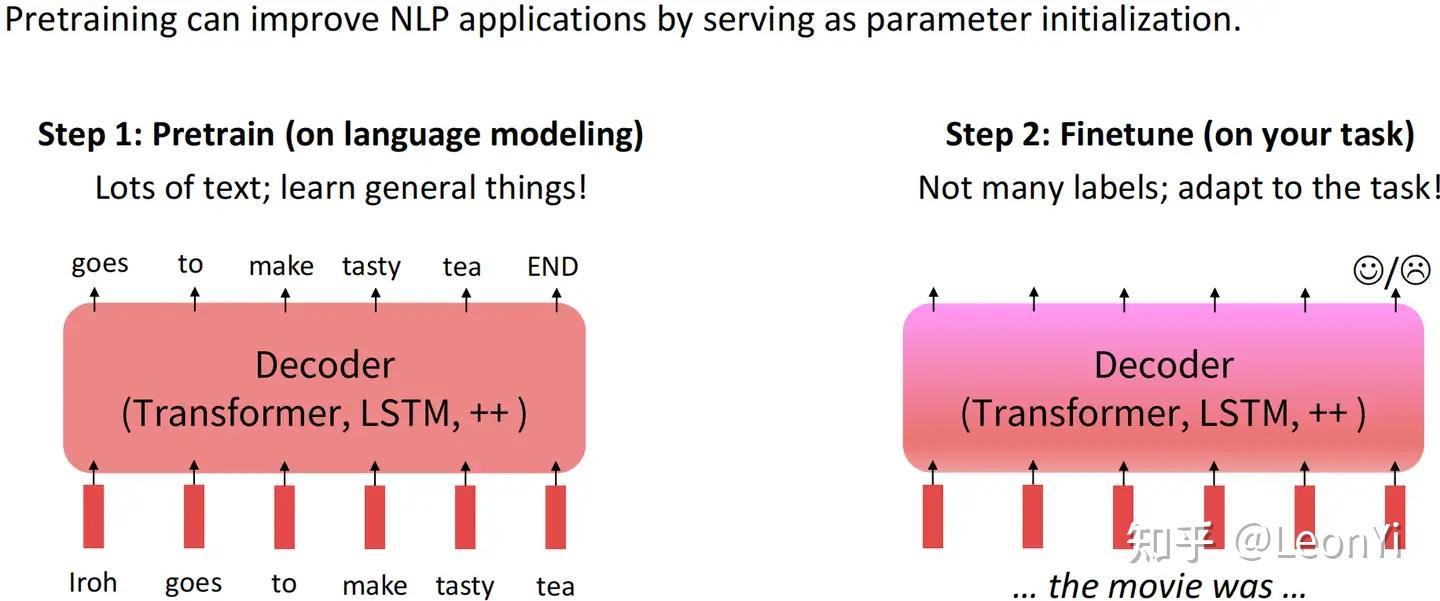 在大量通用数据上进行预训练语言模型训练,然后再针对特定下游任务进行微调,达到领域适应(迁移学习)的目的。是NLP目前的主流范式。
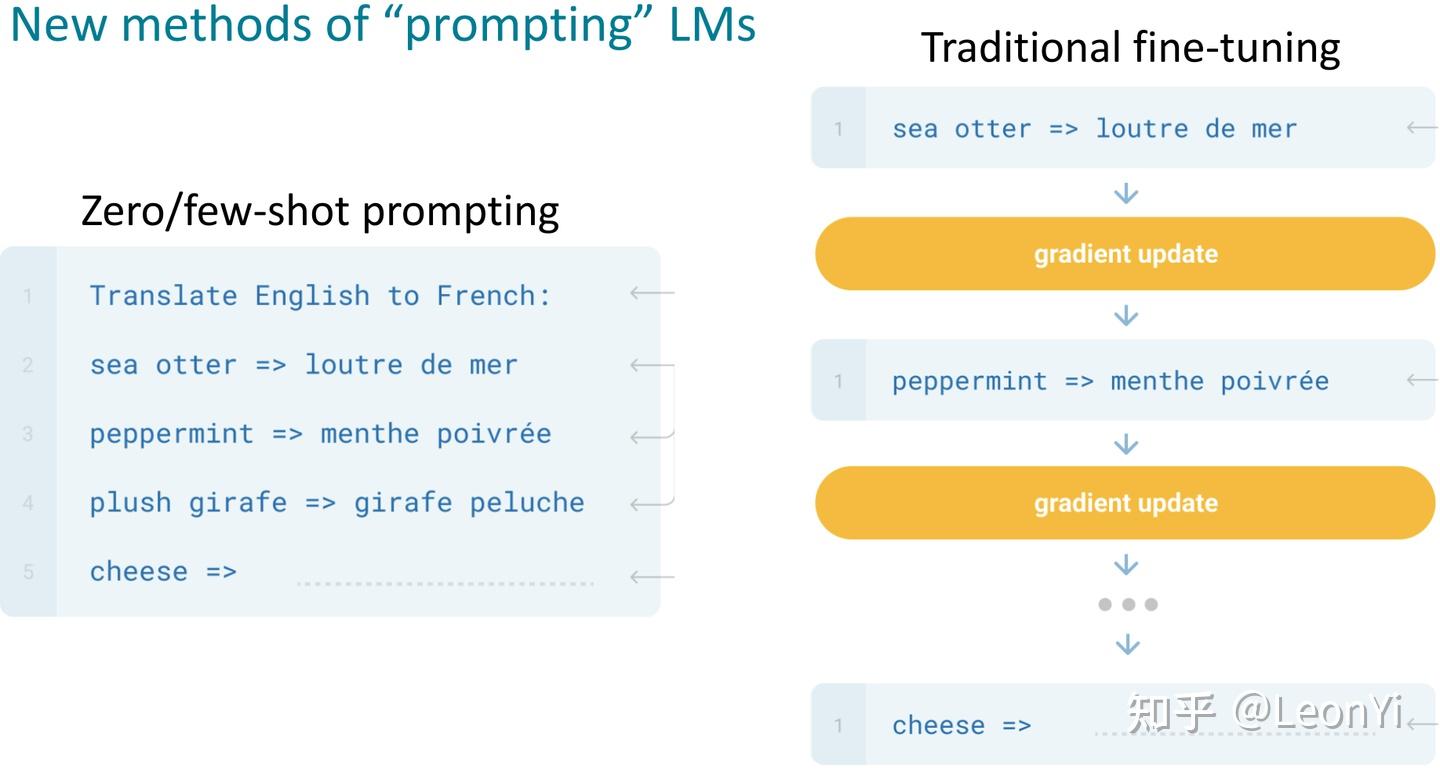 指令微调在预训练语言模型微调的基础进行优化,其目的是尽量让下游任务的形式尽量接近预训练任务。
从而减少下游任务和预训练任务之间的Gap, 实现预训练语言模型适应下游任务,而非下游任务去适应模型
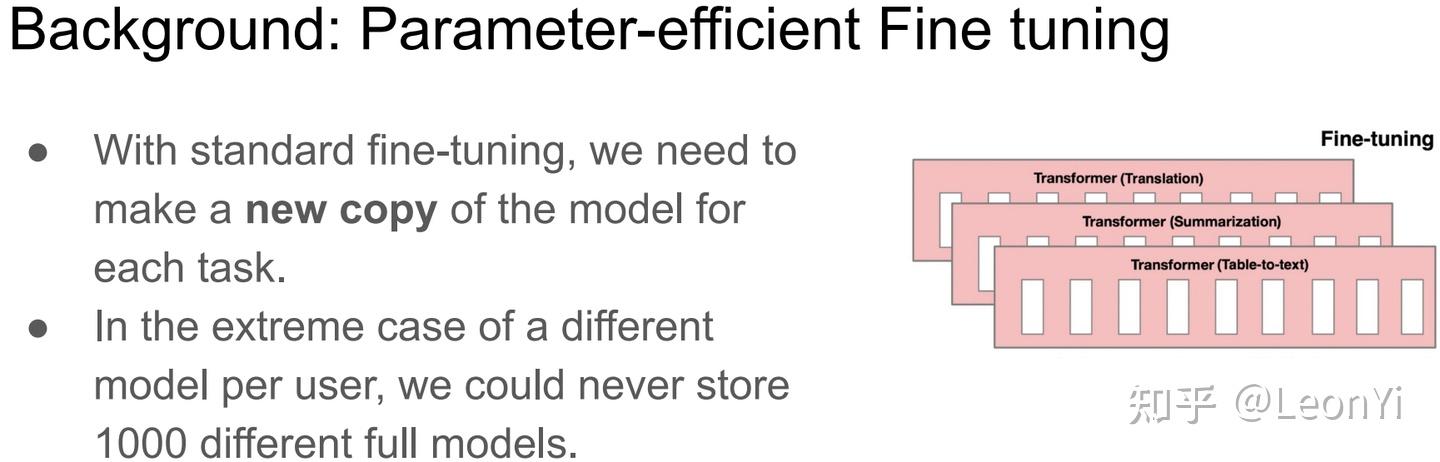
指令微调的效果要优于基于Zero/Few-shot的提示词工程的上下文学习。 但随着预训练语言模型进入LLM时代,其参数量愈发庞大。全量微调模型所有参数所需的显存早已水涨船高。 例如: 实测,使用transformers的trainer全参微调Qwen2-7B至少要1张80GB的A800,至少70GB显存 , 上下文和batch_size一涨,轻轻松松就2张A800
全参微调Qwen2-72B预估至少10张80GB的A800,至少80GB显存 而且,通常不同的下游任务还需要LLM的全量参数,对于算法服务部署来说简直是个灾难(当然,一种折衷做法就是全量微调后把增量参数进行SVD分解保存,推理时再合并参数 )。
为了寻求一个不更新LLM全部参数的廉价微调方案,之前一些预训练语言模型的高效微调(P arameter E fficientF ine-T uning, PEFT)工作,要么插入一些参数或学习外部模块来适应新的下游任务。
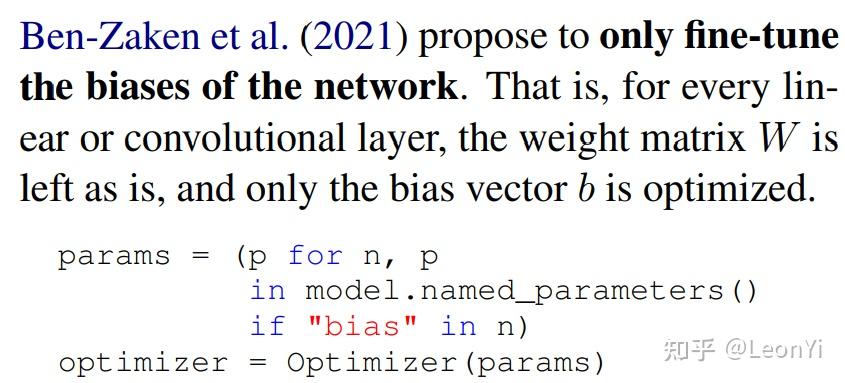
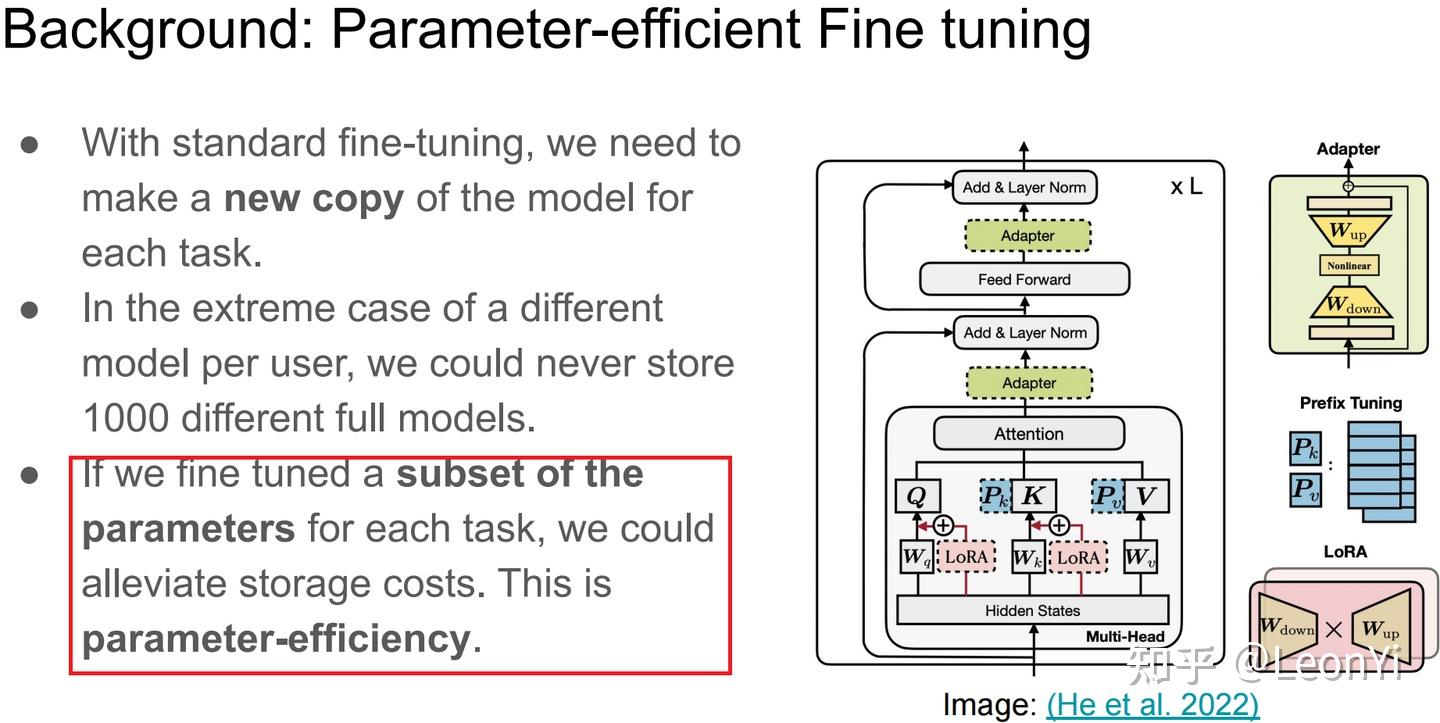 现有的微调方法旨在解决大型语言模型微调的效率问题。以下是一些相关研究的概述:
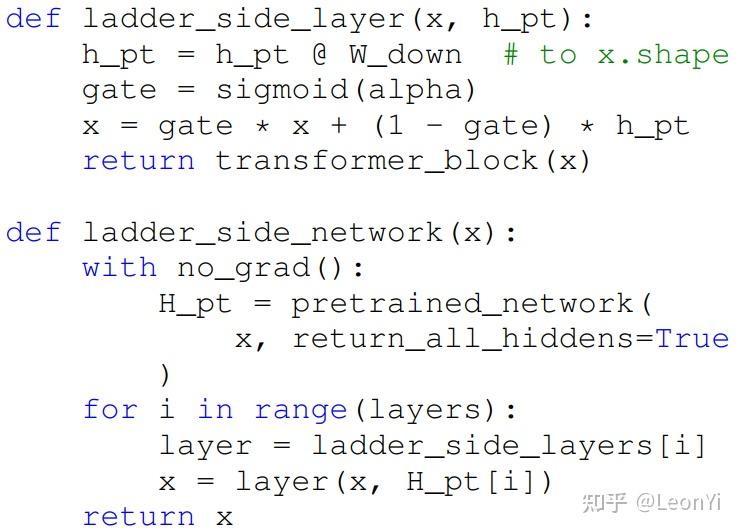 Ladder-Side Tuning伪代码
方法分类 :
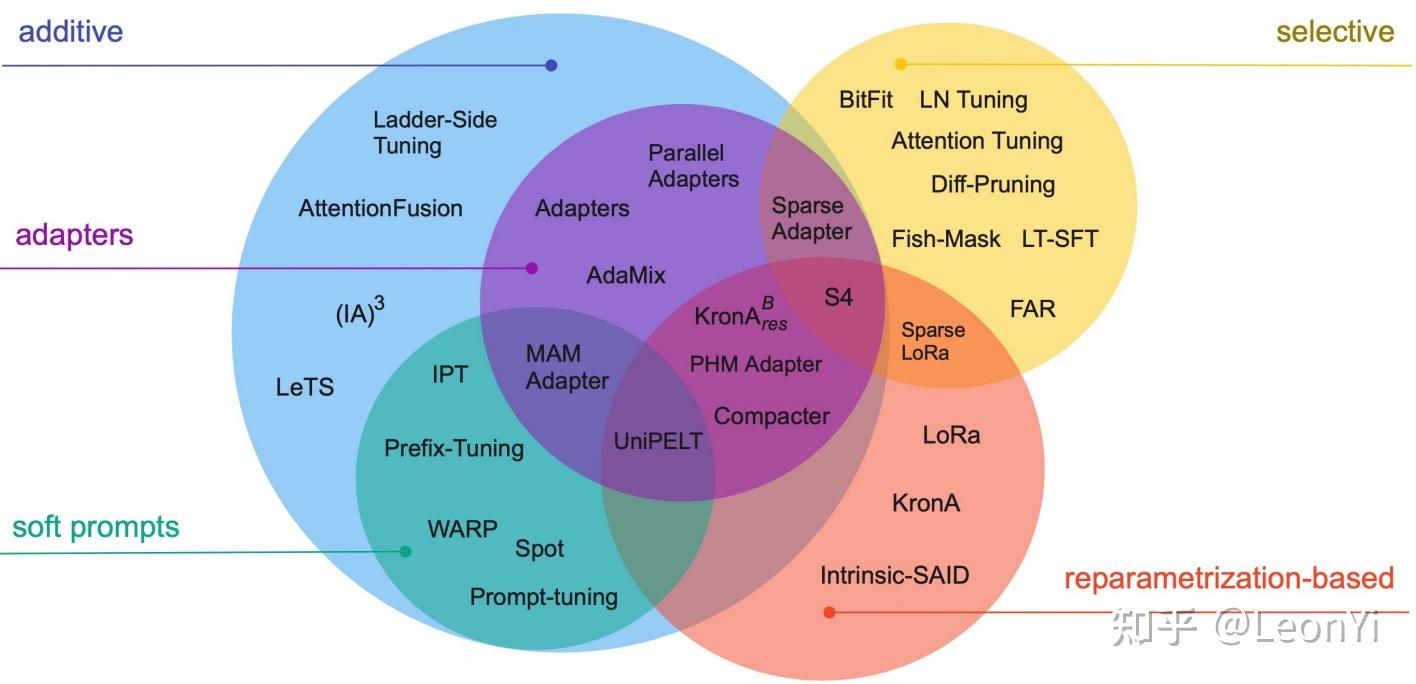 PEFT方法分类,主要分为3类: Addition-based, Selection-based和Reparametrization-based. 在additive methods中, 又进一步分出了两组: Adapter-like methods和Soft prompts
Additive methods : Augmenting the existing pre-trained model with extra parameters or layers and training only the newly added parameters.
Adapters : A type of additive PEFT method that involves introducing small fullyconnected networks after Transformer sub-layers.
Soft Prompts : A part of the model’s input embeddings is fine-tuned via gradient descent. Soft prompts can be trained for the input layer only or for all layers.
Selective methods: 早期的Selective PEFT仅仅微调网络的最后几层, 即freeze这种经典的迁移学习套路。 Modern approaches are usually based on the type of the layer or the internal structure, such as tuning only model biases or only particular rows. An extreme version of selective methods is sparse update methods which can completely ignore the structure of the model, and select parameters individually 。
Reparametrization-based methods: Reparametrization-based PEFT methods leverage low-rank representations to minimize the number of trainable parameters. 支撑就是empirical and theoretical analysis of dl证实neural networks有low dimensional representations。例如,LoRA employs a simple low-rank matrix decomposition to parametrize the weight update.
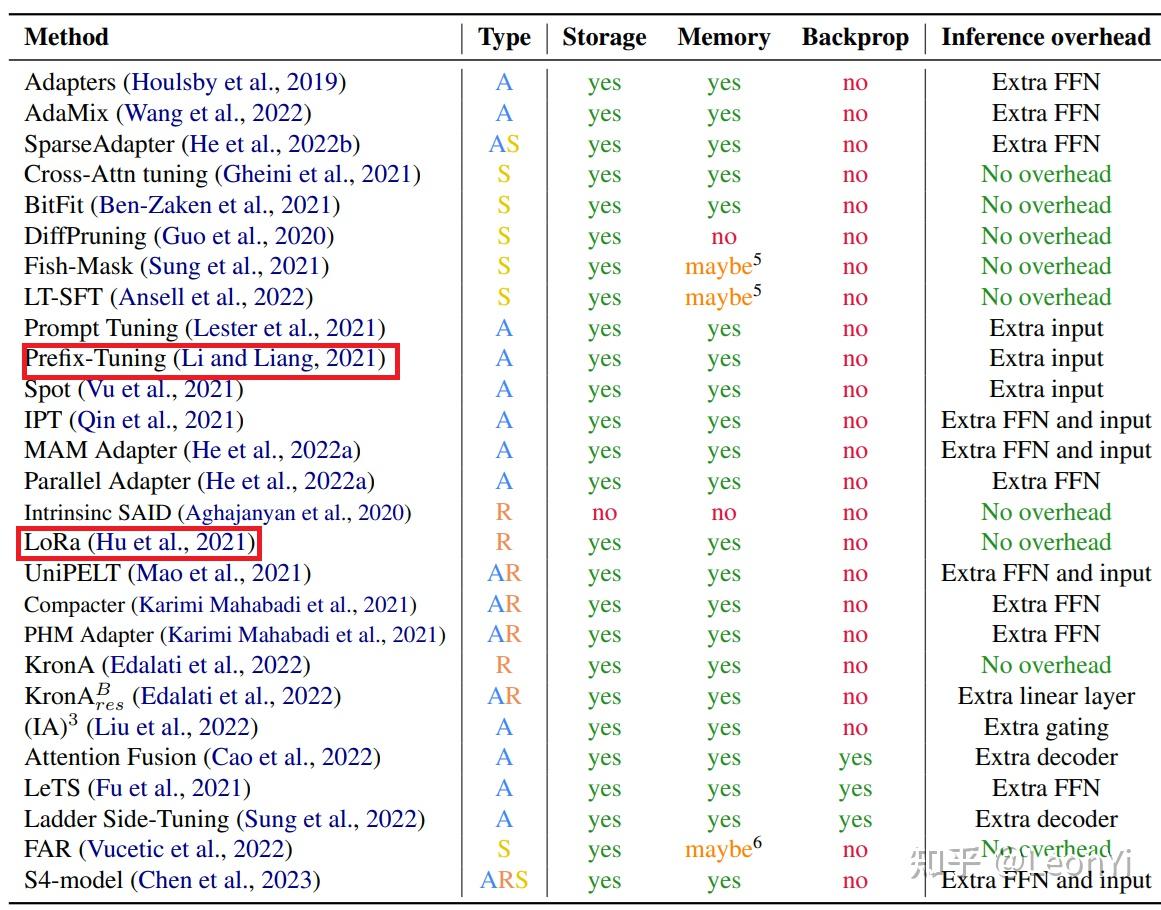 Comparing PEFT methods across storage efficiency, memory efficiency, and computational efficiency interms of reducing backpropagation costs and having inference overhead. Method types: A – additive, S – selective,R – reparametrization-based
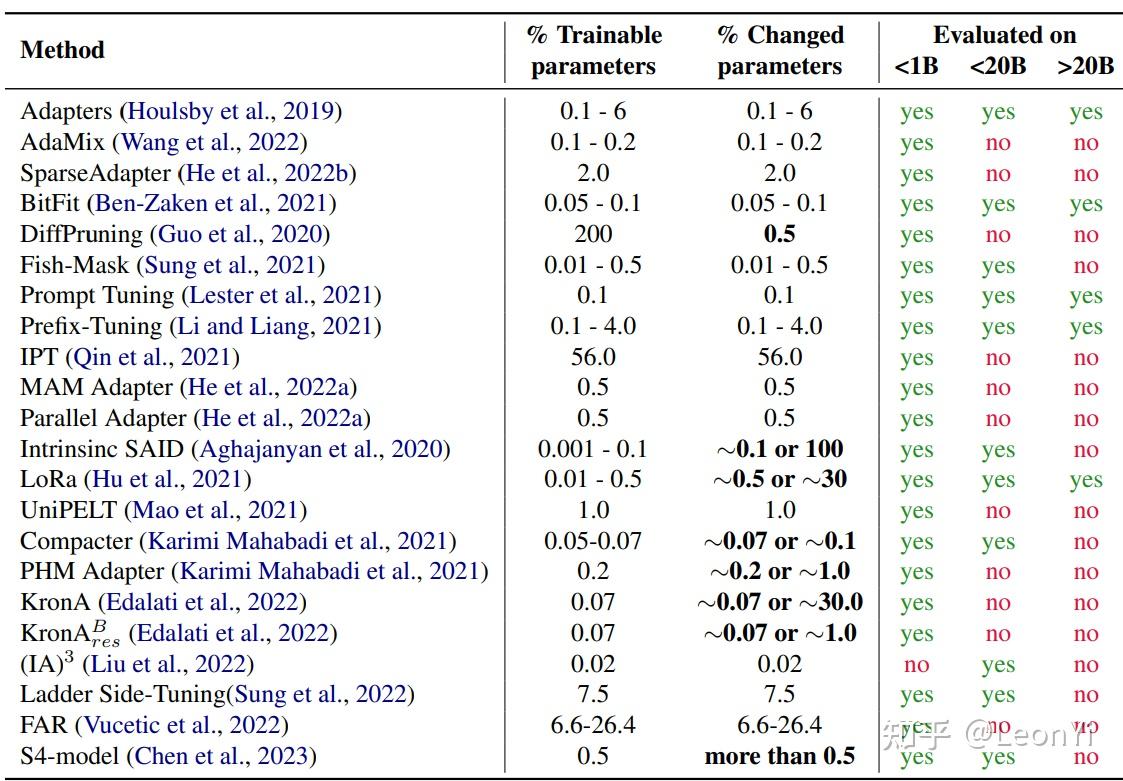 What model sizes PEFTmethods have been evaluated on and their typical amount of trainable parametersused in the papers. By trainable parameter count we specifically mean the number parameters that are updated bya gradient optimization algorithm, not the delta between the original
这一段主要基于:Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning
尽管提出了这么多方法,复杂的方法很少用,而实际使用的最多的可能就是LoRA,因为架构简单、效果不错,便于实现和推理。不然就是全参数微调了。毕竟宁愿加卡,也不愿去折腾奇奇怪怪的算法。
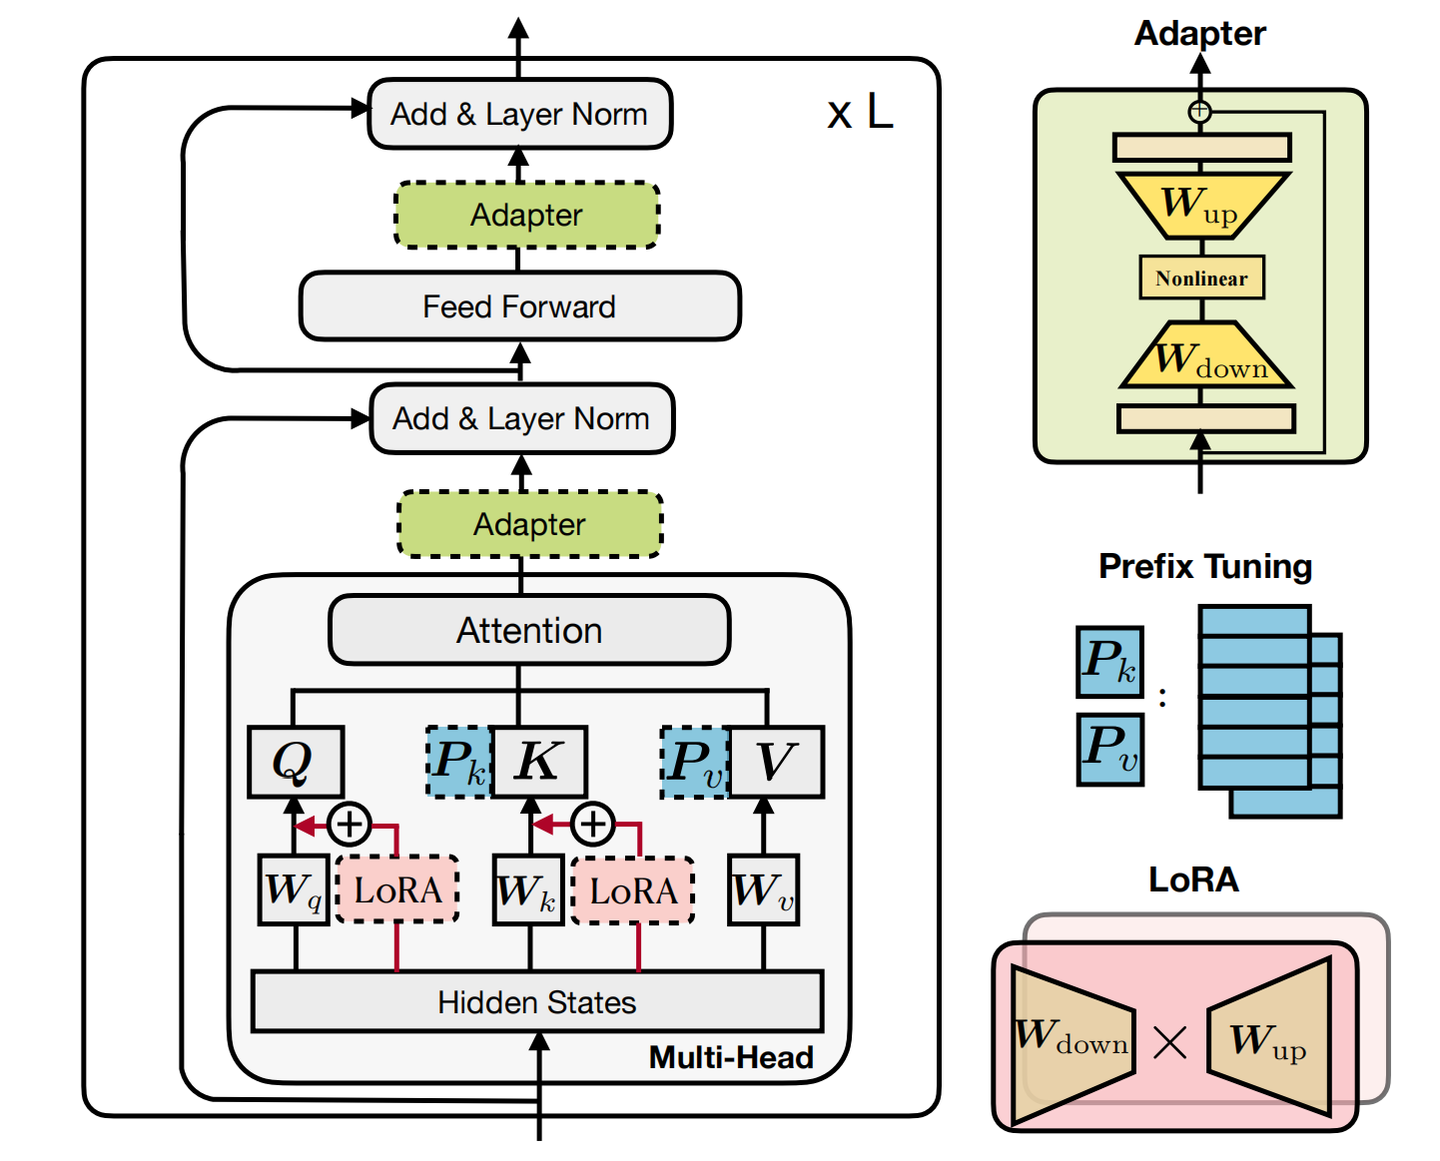
接下来将介绍如下4个PEFT方法 (重点是主流的LoRA):
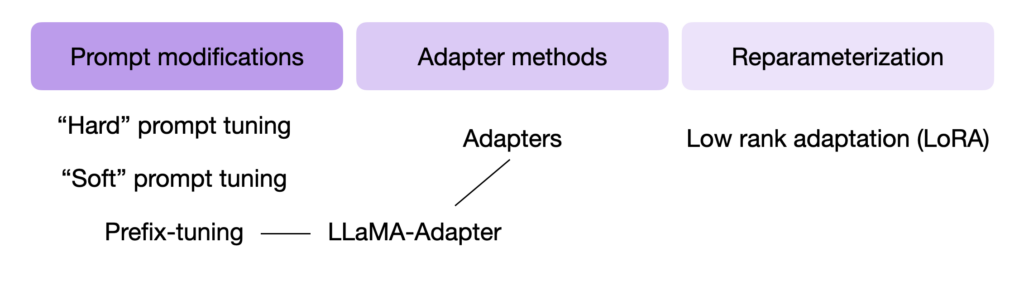
Adapter Tuning试图在Transformer Layer的Self-Attetion+FFN之后,插入一个先降维再升维的MLP(以及一层残差和LayerNormalization)来学习模型微调的知识。
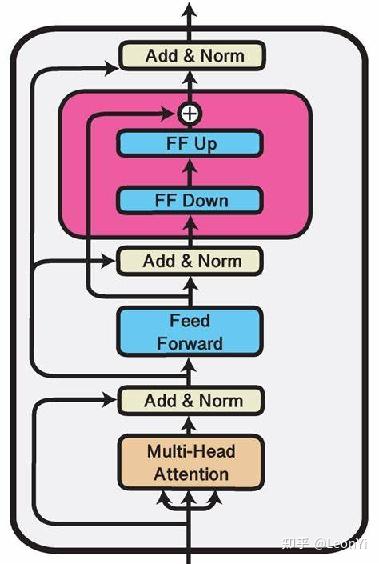 Adapter即插入的FF up + FF Down。
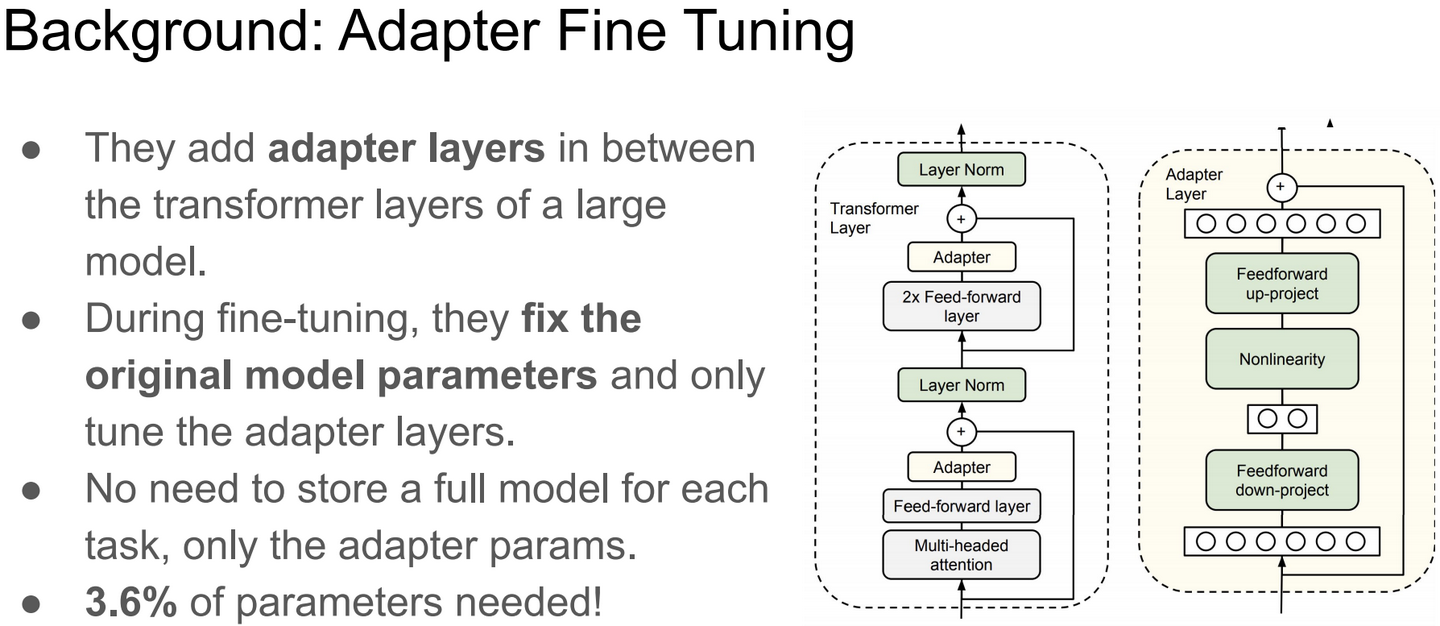 在微调时,Transformer Layer原有的所有参数冻结,反向传播后仅更新Adapter参数。
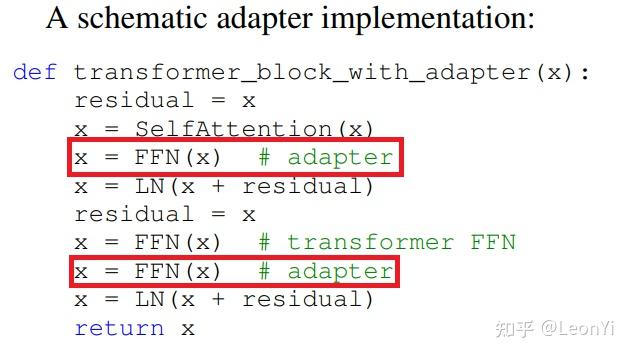 Adatper伪代码
缺点 :需要修改原有模型结构,同时还会增加模型参数量。
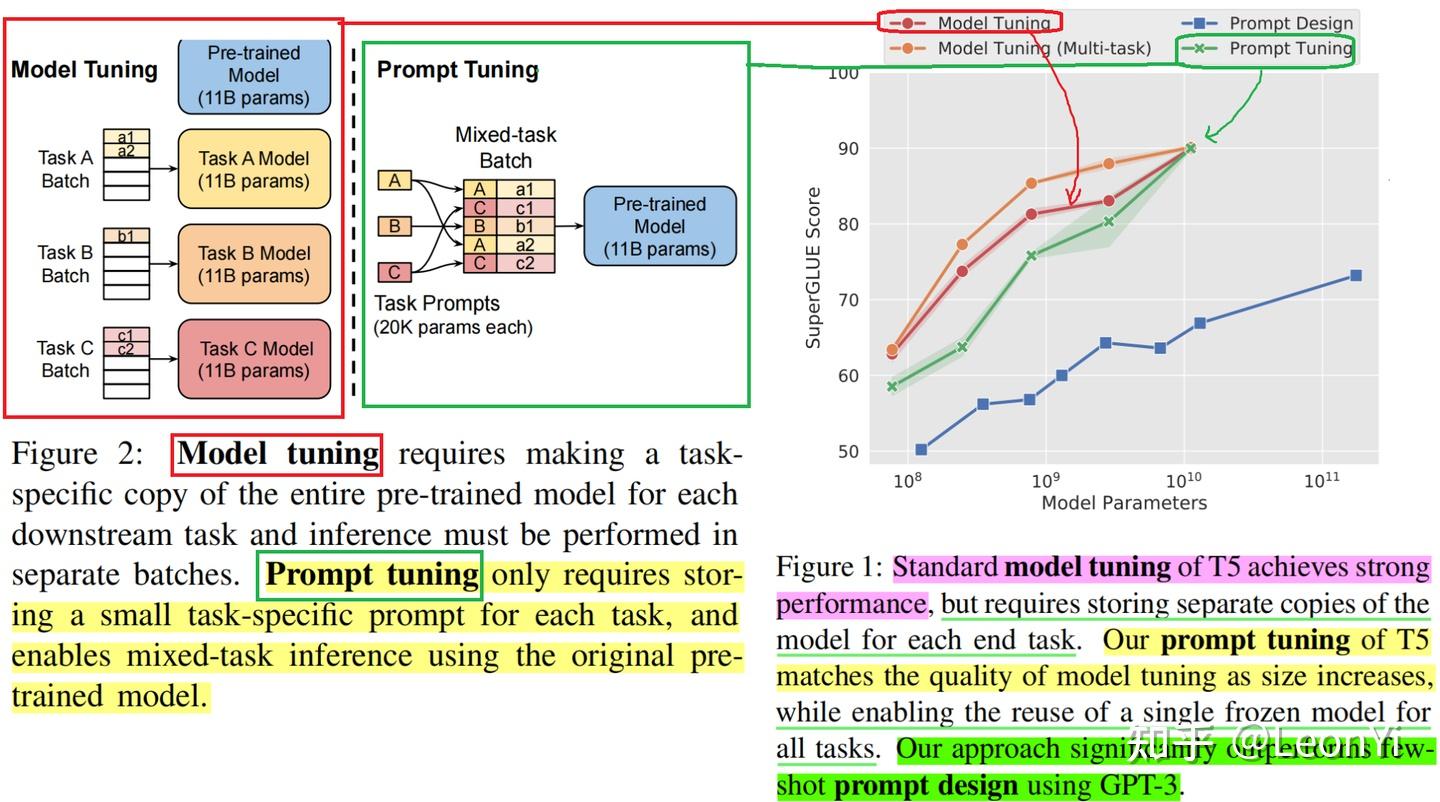
Prompt Tuning设计了一种prefix prompt方法,即在模型输入的token序列前添加前缀prompt token,而这个前缀prompt token的embedding是由网络学到。 Prompt Tuning可以看做token已经确定,但是embedding是可以学的。
它相当于仅用prompt token的embedding去适应下游任务,相比手工设计或挑选prompt,它是一种Soft的prompt(软提示) 给定n个token组成的输入序列 {{x}{1} , {x}{2}, \ldots,{x}{n}} ,其对应token embedding矩阵为 \mathbf{X}{e} \in \mathbb{R}^{n \times d},d代表嵌入维度。 Soft-prompts对应参数\mathbf{P}{e} \in \mathbb{R}^{p \times d},p代表prompt的长度。 然后,将prompt拼接到输入前面,就能得到完整的模型输入 [\mathbf{P}{e} ; \mathbf{X}{e}] \in \mathbb{R}^{(p+n) \times d} 。
这个新的输入将会送入模型f([\mathbf{P}; \mathbf{X}]; \Theta, \Theta{p}),以最大化交叉熵损失来最大化条件概率 Pr_{\Theta, \Theta_{p}}(\mathbf{Y} | [\mathbf{P}; \mathbf{X}]),以拟合其标签token序列 \mathbf{Y}。 在针对下游任务微调时,Prompt Tuning将冻结原始LLM的参数,只学习独立的prompt token参数 (参数化的prompt token加上输入的token送入模型进行前向传播,反向传播只更新prompt token embedding的参数)。 在针对不同的下游任务微调时,就可以分别学习不同的Task Specifical的Prompt Token参数。
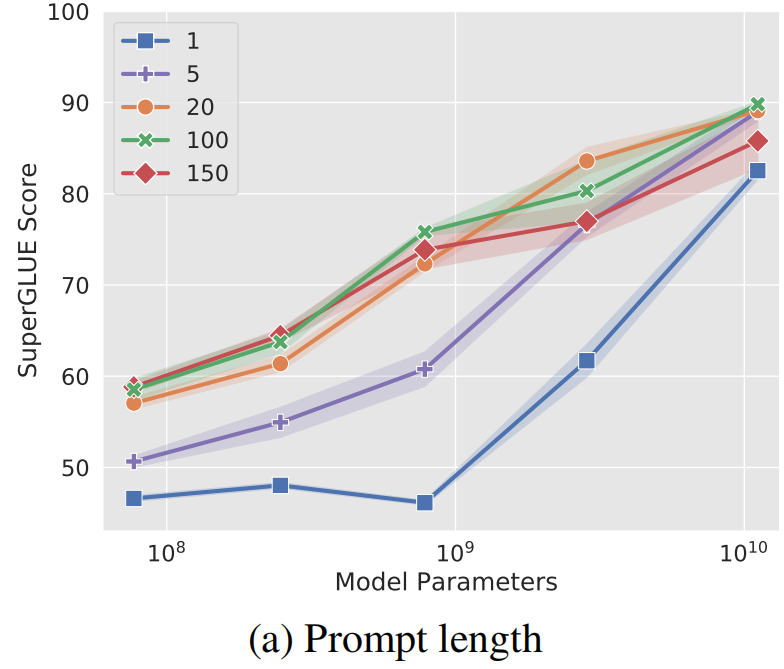 Promot Tuning方法的参数成本是ed,其中e是提示长度,d是token嵌入维度。
提示越短,必须调整的新参数就越少,那么调参的目标是就是找到表现仍然良好的最小prefix prompt长度。 Promot Tuning在输入序列前缀添加连续可微的软提示作为可训练参数,其缺点在于: 由于模型可接受的最大输入长度有限,随着软提示的参数量增多,实际输入序列的最大长度也会相应减小,影响模型性能。
Promot Tuning伪代码
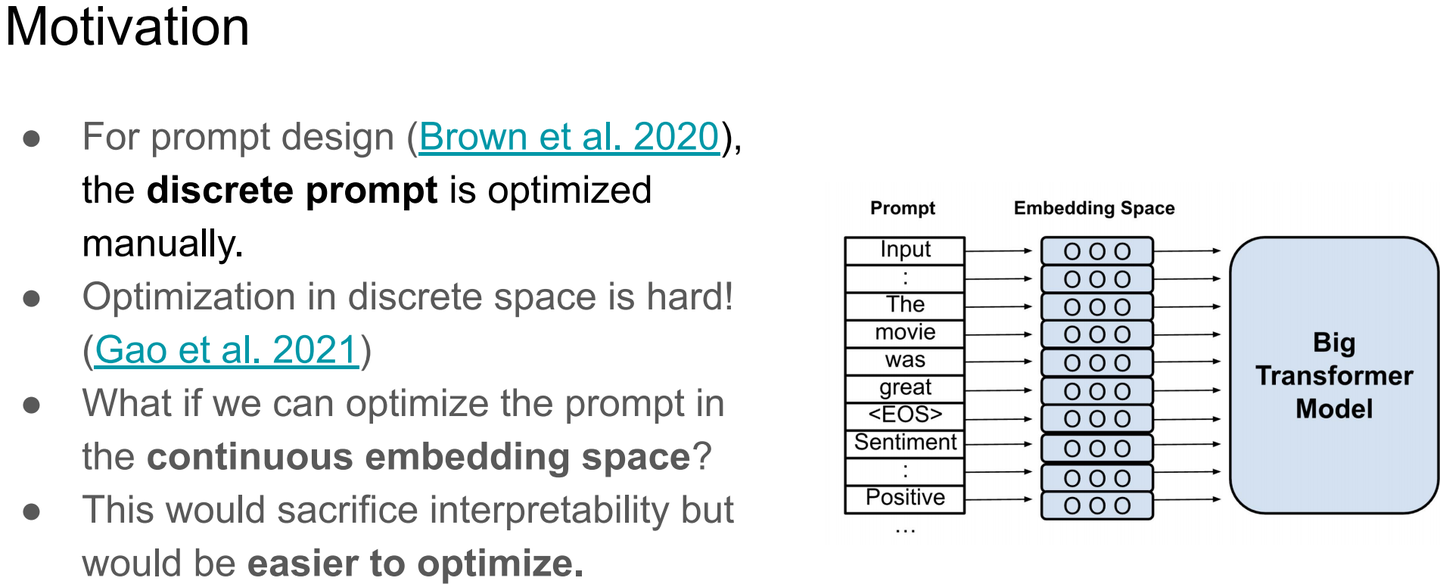 为了避免人为的离散Prompt选取优化,Prefix-Tuning提出可学习的Prefix Prompt。
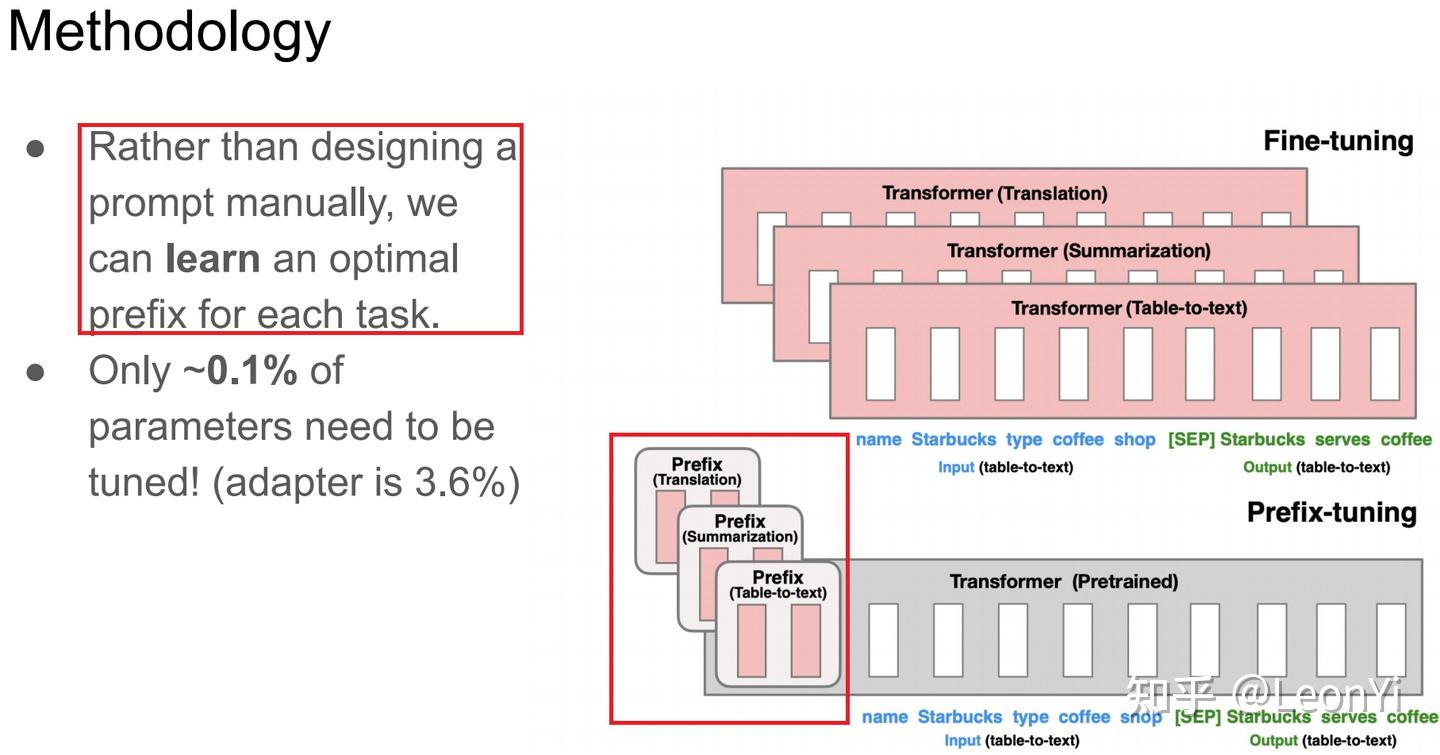
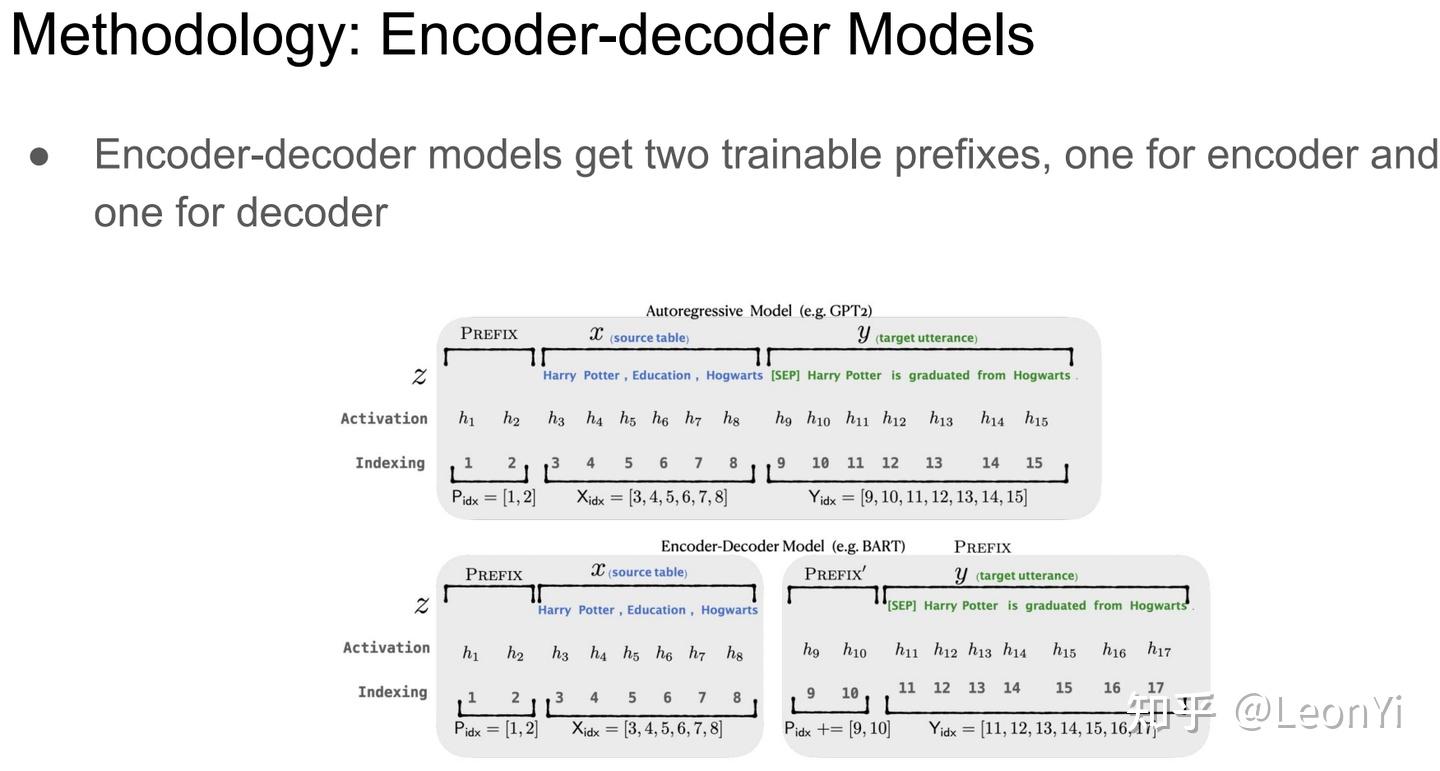 Prefix-Tuning提出可学习的Prompt,即:
learns a sequence of prefixes that are prepended at every transformer layer
Prefix tuning为l层的Transformer Layer的每层多头注意力的键和值都配置了可学习的prefix vectors. Two sets of prefix vectors \mathbf{P}{k}, \mathbf{P}{v} \in \mathbb{R}^{l\times d}are concatenated with the original key \mathbf{K} and value \mathbf{V}
Prefix tuning公式
看到这里可以知道,Prefix-Tuning可以算是Promot Tuning的一个特例(Promot Tuning只在输入侧加入可学习的Prefix Prompt Token,Prefix-Tuning推广到Transformer Layer每一层的K、V上)
Prefix-Tuning伪代码
LoRA(Low-Rank Adaptation of LLMs),即LLMs的低秩适应,被提出用于高效参数微调。 LoRA的核心思想,是假设LLM在下游任务上微调得到的增量参数矩阵\Delta \mathbf{W}是低秩的 ,即是存在冗余参数的高维矩阵,但实际有效矩阵是更低维度的。
相关论文表明训练学到的过度参数化的模型实际上存在于一个较低的内在维度上。类似于机器学习中的降维算法,假设高维数据实际是在低维的流形上一样。 Lora架构
左侧为全参数微调,右侧为Lora微调 全参数微调会优化LLM的所有参数。这相当于在LLM的原始权重 \mathbf{W}{0} \in \mathbb{R}^{d \times d}上,加上一个了微调增量参数\Delta \mathbf{W} \in \mathbb{R}^{d \times d} (相当于冻结原始权重,插入增量参数并仅对做优化)。 对于全参数微调后的LLM权重,给定输入\mathbf{x},其输出为下式: \mathbf{h} = (\mathbf{W}{0} + \Delta \mathbf{W} ) \mathbf{x} = \mathbf{W}_{0}\mathbf{x} + \Delta \mathbf{W}\mathbf{x}
既然,对增量参数矩阵 \Delta \mathbf{W}有**低秩假设 。**
那么在微调LLM时,完全可以对每一层的参数,加入参数\mathbf{B} 和 \mathbf{A}对增量参数 \Delta \mathbf{W}进行来低秩近似,同时只训练参数\mathbf{B} 和 \mathbf{A}。这就是上图右侧的Lora微调。
这样一来,在微调过程中,可训练的参数量大大减少 (使得微调参数量从 d \times d 降低至 2 r d , 有 r << d )
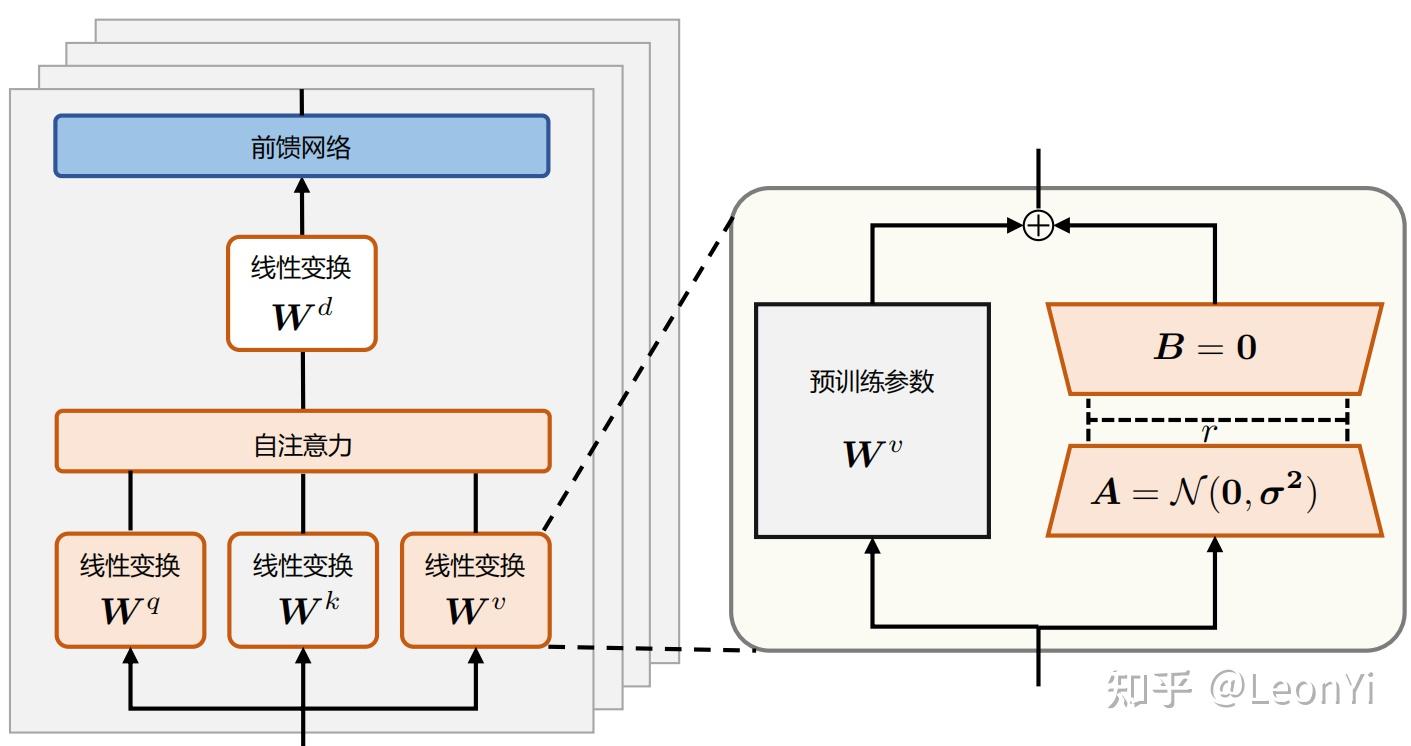 LoRA 方法的计算流程图
具体来说**,** LoRA将\Delta \mathbf{W} = \mathbf{B} \mathbf{A} \in \mathbb{R}^{d \times d} 用两个更小的参数矩阵进行低秩近似,其中 r 是LoRA的需要近似\Delta \mathbf{W}的秩的维度,\mathbf{B}\in \mathbb{R}^{d\times r}和\mathbf{A}\in \mathbb{R}^{r \times d}。
在LoRA微调时,冻结预训练的模型权重 \mathbf{W}{0} \in \mathbb{R}^{d \times d},并将可训练的LoRA低秩分解矩阵注入到LLM的每个Transformer Decoder层中。在训练时,只优化所有的 \mathbf{B} 和 \mathbf{A} 矩阵,从而大大减少了下游任务的可训练参数量。
对于该权重的输入\mathbf{x}来说,输出为下式:
\mathbf{h} = (\mathbf{W}{0} + \Delta \mathbf{W} ) \mathbf{x} = \mathbf{W}_{0}\mathbf{x} + \mathbf{B}\mathbf{A} \mathbf{x}
LoRA参数初始化时,矩阵\mathbf{A}通过高斯函数初始化。
矩阵\mathbf{B}为全零初始化,其目的是希望训练开始之前旁路对原模型不造成影响(带来噪声),即参数改变量为0。 对于使用LoRA的模型来说,由于可以将原权重与训练后权重合并,因此在推理时不存在额外的开销。LoRA伪代码
近来LLM主要是指,Decoder-Only架构的大规模预训练语言模型。
毕竟,同等参数规模和训练数据量,Encoder-Decoder架构的T5和Bart在生成任务上,相比Decoder-Only架构并不具备优势。更不用说,Encoder-Only架构的BERT了。 但是,所有使用Transformer架构的算法都可以使用上述PEFT方法。 针对主流的Decoder Only的生成式因果语言模型,其训练范式具体是:
图片源自:《大规模语言模型:从理论到实践》
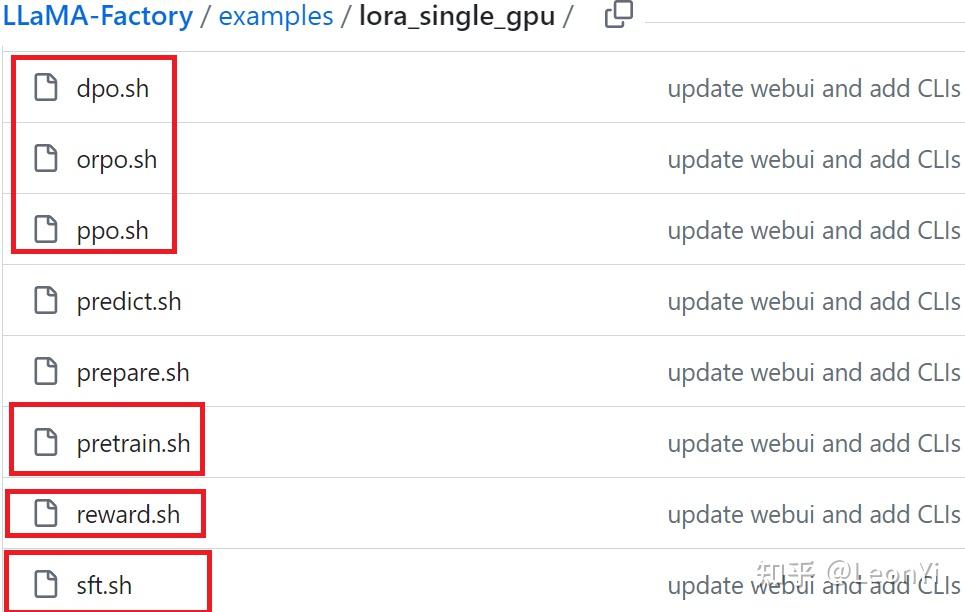
除了预训练,增量预训练、有监督微调、有监督微调、奖励建模、强化学习阶段都可以采用PEFT方式。
本文使用 Zhihu On VSCode 创作并发布
编辑于 2025-05-19 03:50・广东
大模型微调
参数高效微调
LLM(大型语言模型)
赞同 292 条评论50 5
分享
申请转载
 未登录用户
2 条评论
默认
最新
 AI生成未来
您好,我是公众号"AI生成未来"的运营人员,请问是否可以在公众号中转载您的文章《LLM高效微调详解-从Adpter、PrefixTuning到LoRA》,会标明来源作者出处的~非常期待您的回复,万分感谢~
2024-05-06 · 上海
回复喜欢
 LeonYi
作者
 可以
2024-05-06 · 广东
回复喜欢
关于作者
LeonYi
脚踏实地,拒绝纸上谈兵
四川大学 计算机技术硕士
回答 69 文章 41 关注者 4,293
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 大模型微调实践必看——一文看懂Deepspeed:用ZeRO训练大模型原理解析及参数含义解释 喜欢卷卷的瓦力
 [离线强化学习][ICML 2024] Q-value Regularized Transformer Charles # Deepseek R1/V3模型结构总览 此篇,会以四个章节,介绍整个Deepseek R1的模型结构,分为结构总览,MLA(Multi-Head Latent Attention)模块详细解析,MoE(Mixture of Experts)模块详细解析,MLP模块详细解析。 Deepseek R… 骑虎南下
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码