 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
LLM(26):从信息论的角度解释 scaling law
首发于从NLP到LLM
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
LLM(26):从信息论的角度解释 scaling law
首发于从NLP到LLM
切换模式
 紫气东来
 上海交通大学 工学硕士
收录于 · 从NLP到LLM
378 人赞同了该文章
目录
1943年,当亚欧大陆东西两端都陷入焦灼的战火时,远隔大洋的美国,有两个年轻人因为这场战争走到了一起,他们就是:31 岁的图灵(Alan Turing,1912-1954) 和 27 岁的香农(Claude Shannon,1916-2001)。这也许是人类最精彩的会面之一,彼时他们分别拿着“矛”和“盾”:当时图灵在当是破译了包括希特勒通话在内的多项德军秘密通讯的密码学破译专家,而香农当时的工作是通过数学方法证明“X系统”——这是美国总统罗斯福到英国首相丘吉尔之间的加密通讯系统。
尽管因为保密的原因,二人不能在密码学上进行讨论,但却可以对当时最前沿的话题,包括机器思维、信息科学、计算理论、智能等进行讨论,事实上这些问题至今仍然是最前沿的研究领域。在这次会面不久,二人就在各自的领域取得了巨大的成就:
时至今日,尽管模型、数据、算力都发生了翻天地覆的变化,人工智能和信息技术的发展仍然没有超越他们当年讨论的范畴。览前贤,思己任,希望在前辈们建立的大厦基础上,我辈能够薪尽火传,在自己的领域做出各自力所能及的贡献。
考虑生成式的语言模型,其概率估计 通常为每个token的概率的乘积,即
\begin{aligned} P_{\left(w_1, w_2, \ldots, w_n\right)} & =p\left(w_1\right) p\left(w_2 \mid w_1\right) p\left(w_3 \mid w_1, w_2\right) \ldots p\left(w_n \mid w_1, w_2, . ., w_{n-1}\right) \\ & =\prod_{i=1}^n p\left(w_i \mid w_1, \ldots, w_{i-1}\right) \end{aligned} \
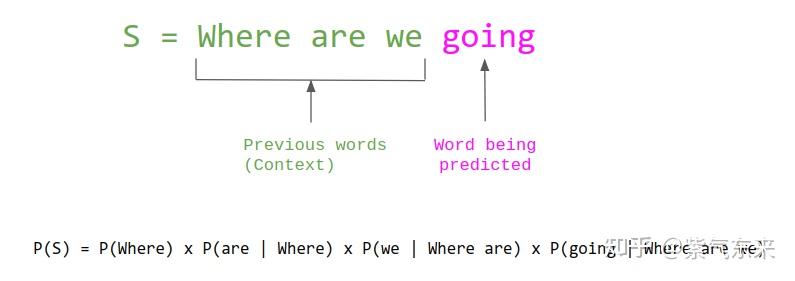 有了概率之后,便可以定义更多的量了。
假设随机变量 X 在属于集合 \mathcal{X} ,则 X 的熵定义为: \mathrm{H}(X)=-\sum_{x \in \mathcal{X}} p(x) \log p(x) \\
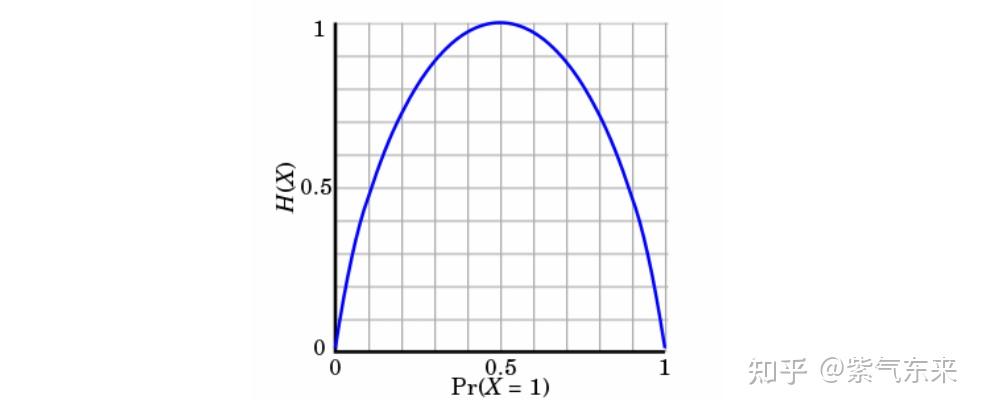 在自然语言领域,令 b_n = (w_1,w_2,...,w_n) ,则熵还可以进一步表示为:
\begin{aligned} F_N & =-\sum_{b_n} p\left(b_n\right) \log 2 p\left(w_n \mid b{n-1}\right) \\ & =-\sum_{b_n} p\left(b_n\right) \log 2 p\left(b_n\right)+\sum{b_{n-1}} p\left(b_{n-1}\right) \log 2 p\left(b{n-1}\right)\\ & =K_N-K_{N-1} \end{aligned}\
其中 K_N=-\sum_{b_n} p\left(b_n\right) \log _2 p\left(b_n\right)
当序列长度无限大的情况下,香农将其定义为该语言的熵,即: H=\lim _{N \rightarrow \infty} F_N
根据这个定义,熵是使用无限数量的符号来计算的。在实践中,只能从有限的文本样本中近似经验熵来近似任何语言的熵。
接下来分析一下语言的信息熵的边界问题。任何分布的最小可能熵为零,对于语言来说,当一种语言只有一个符号或者某个符号的概率为 1 时,该语言的熵才能为零,即
\min \mathrm{H}(\mathrm{P})=-1 * \log (1)=0 \
概率分布的熵在均匀分布时最大化,对于共享同一组符号(词汇)的所有语言,当其所有符号以相等概率出现的时候其熵最大,以 V 表示词表大小,则有: \mathrm{H}(\mathrm{P}) \leq-\mathrm{V} * \frac{1}{\mathrm{~V}} * \log \left(\frac{1}{\mathrm{~V}}\right)=-\log \left(\frac{1}{\mathrm{~V}}\right)=\log (\mathrm{V}) \\
这样我们就确定了语言的信息熵的上下界,接下来探究其单调性问题,假设来自于同一语言数据库(独立同分布)的长度不同的文本,则有:
\begin{aligned} F_N-F_{N+1} & =-\sum_{b_n} p\left(b_n\right) \log p\left(w_n \mid b_{n-1}\right)+\sum_{b_{n+1}} p\left(b_{n+1}\right) \log p\left(w_{n+1} \mid b_n\right) \\ & =\sum_{b_{n-1}}\left[\sum_{w_n, w_{n+1}} p\left(b_{n+1}\right) \log p\left(w_{n+1} \mid b_n\right)-\sum_{w_n} p\left(b_n\right) \log p\left(w_n \mid b_{n-1}\right)\right] \\ & \geq \sum_{b_{n-1}}\left[\sum_{w_n, w_{n+1}} p\left(b_{n+1}\right) \log p\left(w_{n+1} \mid b_{n-1}\right)-\sum_{w_n} p\left(b_n\right) \log p\left(w_n \mid b_{n-1}\right)\right] \\ & =\sum_{b_{n-1}}\left[\sum_{w_n, w_{n+1}} p\left(b_{n-1}, w_n, w_{n+1}\right) \log p\left(w_{n+1} \mid b_{n-1}\right)-\sum_{w_n} p\left(b_{n-1}, w_n\right) \log p\left(w_n \mid b_{n-1}\right)\right] \\ & =\sum_{b_{n-1}}\left[\sum_{w_{n+1}} \log p\left(w_{n+1} \mid b_{n-1}\right) \sum_{w_n} p\left(b_{n-1}, w_n, w_{n+1}\right)-\sum_{w_n} p\left(b_{n-1}, w_n\right) \log p\left(w_n \mid b_{n-1}\right)\right] \\ & =\sum_{b_{n-1}}\left[\sum_{w_{n+1}} \log p\left(w_{n+1} \mid b_{n-1}\right) p\left(b_{n-1}, w_{n+1}\right)-\sum_{w_n} p\left(b_{n-1}, w_n\right) \log p\left(w_n \mid b_{n-1}\right)\right] \\ & =0 \end{aligned} \
其中最为关键的一步是 \log p\left(w_{n+1} \mid b_n\right) \geq \log p\left(w_{n+1} \mid b_{n-1}\right) ,所表达的含义是随着前文长度的增加,预测的准确性会提高。因此则有:
\mathrm{F}_1 \geq \mathrm{F}_2 \geq \ldots \geq \lim _{N \rightarrow \infty} \mathrm{F}_N=H(P) \
这意味着随着数据量的增加,其理论上的经验熵值会逐渐减小,并逐步接近最真实的语言熵。
下表展示了几个主要数据集的经验熵,可以看到满足以上发现的规律,另外可以看到,大多数值仍然位于香农 1950 年估计的范围内,可见其超越时空的远见卓识。
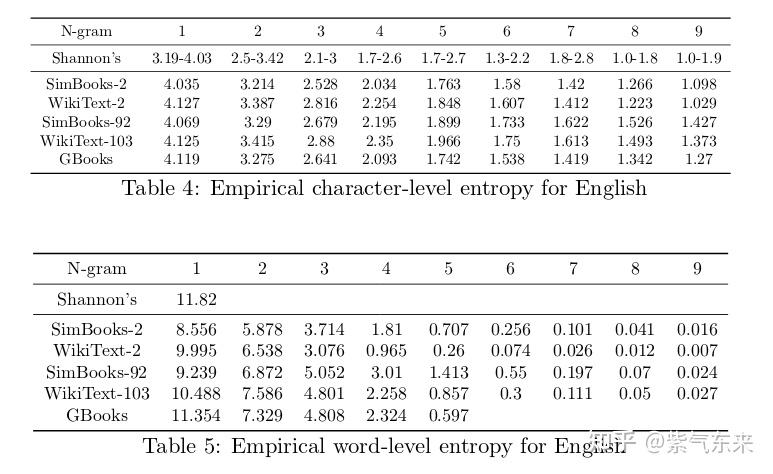
由于语言中缺乏无限数量的文本,该语言的真正分布是未知的。语言模型旨在从示例文本中学习接近语言经验分布的分布。为了测量两个分布的“接近度”,通常使用交叉熵,通常作为模型的 loss 。数学上,预测分布 Q 相对于真实分布 P 的交叉熵定义如下:
\begin{aligned} \mathrm{CE}(\mathrm{P}, \mathrm{Q}) & =-\sum_x P(x) \log Q(x) \\ & =-\sum_x P(x)[\log P(x)+\log Q(x)-\log P(x)] \\ & =-\sum_x P(x)\left[\log P(x)+\log \frac{Q(x)}{P(x)}\right] \\ & =-\sum_x P(x) \log P(x)-\sum_x P(x) \log \frac{Q(x)}{P(x)} \\ & =H(P)+D_{K L}(P | Q) \end{aligned} \
其中 D_{K L}(P | Q) 即 Q 对 P 的 KL 散度(亦称相对熵), 其表征了两个分布间的差异大小。下面来尝试解读一下上式的含义:
需要注意的是,由于经验熵 \mathrm{H}(\mathrm{P}) 是不可优化的,当我们以最小化交叉熵损失为目标来训练语言模型时,真正的目标是最小化分布的 KL 散度,这是语言模型从语言的经验分布学习到的。
Perplexity (PPL, 困惑度) 是衡量概率分布或概率模型对样本的预测程度。在数学上,语言模型的困惑度定义为: \operatorname{PPL}(P, Q)=2^{\mathrm{CE}(P, Q)} \
直观地说,困惑度可以理解为不确定性的度量。语言模型的困惑度可以看作是预测下一个符号时的困惑程度。考虑一个熵为 3 比特的语言模型,其中每个比特编码两种概率相等的可能结果。这意味着在预测下一个符号时,该语言模型必须在可能的 2^3 选项中做出选择。因此,我们可以认为这个语言模型的困惑度为 8。
Bits-per-character (BPC, 字符位数) 是最近语言模型中经常报告的另一个指标。它精确地测量它所命名的数量:对字符进行编码所需的平均位数。这也来源于香农对语言熵的解释:
if the language is translated into binary digits (0 or 1) in the most efficient way, the entropy is the average number of binary digits required per letter of the original language. 根据这个定义,熵是 BPC 的平均数。在实践中,如果每个人都使用不同的词表或模型,则很难比较不同模型的结果。为了保持一致性,使用 BPC 是一个比较好的选择。 实际上,BPC 建立了压缩的下限。如果文本的 BPC 为 1.2,则不能将其压缩到每个字符小于 1.2 位。例如,如果文本有 1000 个字符(如果每个字符使用 1 个字节表示,则大约 1000 个字节),则其压缩版本至少需要 1200 位或 150 个字节。 BPC 特定于字符级语言模型。当有单词级语言模型时,则通常采用 bits-per-word (BPW, 单词位数) ,即编码单词所需的平均比特数。关于二者的关系,Graves 提供了一个简单的转化公式:如果平均而言,一个单词需要 m 比特来编码,而一个单词包含 l 个字符,那么它应该需要平均 m/l 比特来编码一个字符。例如,一个单词在数据集中平均有 5.6 个字符,因此单词级别的困惑度计算公式为 2^{5.6*BPC} 。 因此,在讨论语言的熵或者困惑度时,应该要特别说明是单词(word)、字符(character)还是子单词(subword)级别的。
在信息论中,条件熵描述了在已知第二个随机变量 {\displaystyle X} 的值的前提下,随机变量 {\displaystyle Y} 的信息熵还有多少。基于
{\displaystyle X} 条件的 {\displaystyle Y} 的信息熵,用 {\displaystyle \mathrm {H} (Y|X)} 表示条件熵(Conditional entropy) 为:
\begin{aligned} H(Y | X)&=\sum_{x} p(x) H(Y | X=x)\\ &=- \sum_{x} p(x) \sum_{y} p(y | x) \log p(y | x)\&=-\sum_{x } \sum_{y} p(x, y) \log p(y | x) \&=-E \log p(Y | X) \end{aligned} \
另外,如果随机变量 (X, Y) \sim p(x, y) ,则其**联合熵(Joint entropy)**为:
H(X; Y)=-\sum_{x } \sum_{y} p(x, y) \log p(x, y)=-E \log p(X, Y)
联合熵与条件熵有如下关系成立: H(X; Y)=H(X)+H(Y | X) ,证明如下:
\begin{equation} \begin{aligned} H(X;Y) &=-\sum_{x} \sum_{y} p(x, y) \log p(x, y)=-\sum_{x} \sum_{y} p(x, y) \log p(x) p(y \mid x) \\ &=-\sum_{x} \sum_{y} p(x, y) \log p(x)-\sum_{x} \sum_{y} p(x, y) \log p(y \mid x) \\ &=-\sum_{x} p(x) \log p(x)+H(Y \mid X) \&=H(X)+H(Y \mid X) \end{aligned} \end{equation}
**互信息(Mutual information)**是一个随机变量包含另一个随机变量信息量的度量,也可以说是在给定一个随机变量的条件下,原随机变量的不确定性的减少量,根据熵的连锁规则,有:
\mathrm{H}(\mathrm{X};\mathrm{Y})=\mathrm{H}(\mathrm{X})+\mathrm{H}(\mathrm{Y} \mid \mathrm{X})=\mathrm{H}(\mathrm{Y})+\mathrm{H}(\mathrm{X} \mid \mathrm{Y})
据此定义互信息: I(X ; Y)=H(Y)-H(Y | X)=H(X)-H(X | Y)
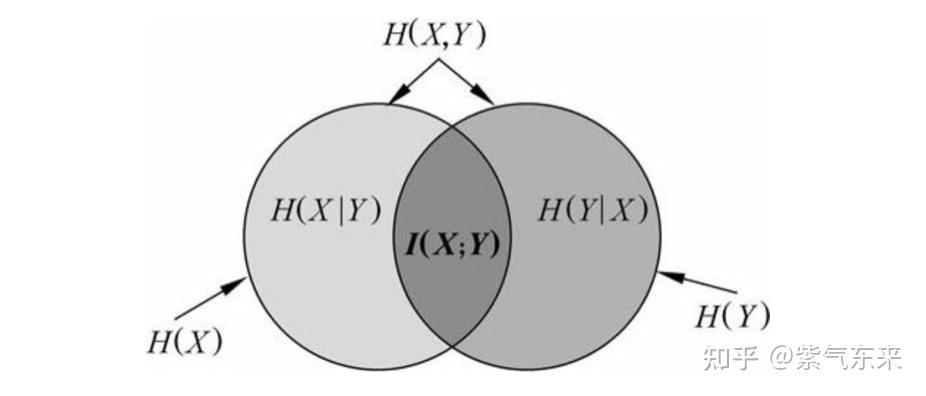 信息增益(Info Gain)指的是经验熵和经验条件熵的差值,经验熵和经验条件熵是通过样本进行极大似然估计得出来的,是一个估计值的差。信息增益是互信息的无偏估计。
在通信系统中,冗余度压缩编码以及信道编码,目的都是对信息进行可靠无差错的传输,信息熵没有变化,也就是是保熵的。但是在实际场景中,没有必要把信息的所有内容都保留下来的,即要进行有损压缩。
失真度量(失真函数)是这样一个映射: d: X \times \hat{X} \rightarrow R^{+}
它将源字母-恢复字母对映射到一个非负的实数,来代表失真多少。当原始字母集与映射的字母集是离散的,可以用一个矩阵来表示失真的大小,而在连续的情况下,这就是一个函数。失真函数永远都是非负的。如果失真是有限的,则函数为有界函数。
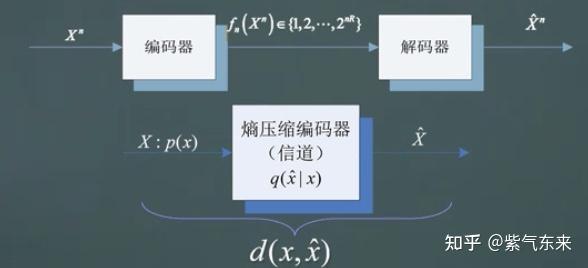 率失真编码器和解码器。编码器对序列进行编码。然后将编码序列馈送到输出序列的解码器。目的是最小化原始序列和重建序列之间的失真。
失真函数在输入输出联合空间中取统计平均为 D \triangleq \sum_{x_i, \hat{x}_j} p\left(x_i\right) q\left(\hat{x}_j \mid x_i\right) d\left(x_i, \hat{x}_j\right) \triangleq E[d(X, \hat{X})] \\ 在给定信源分布与转移概率分布时,上式为信道传输失真总体的平均度量。
现在想做的事情是, X 经过信道之后,得到 \hat{X} ,我们希望 I(X,\hat{X}) 尽可能小,以此来压缩比特的传输。如果互信息为0,则相当于不压缩。压缩下有个前提,就是对失真函数的约束。
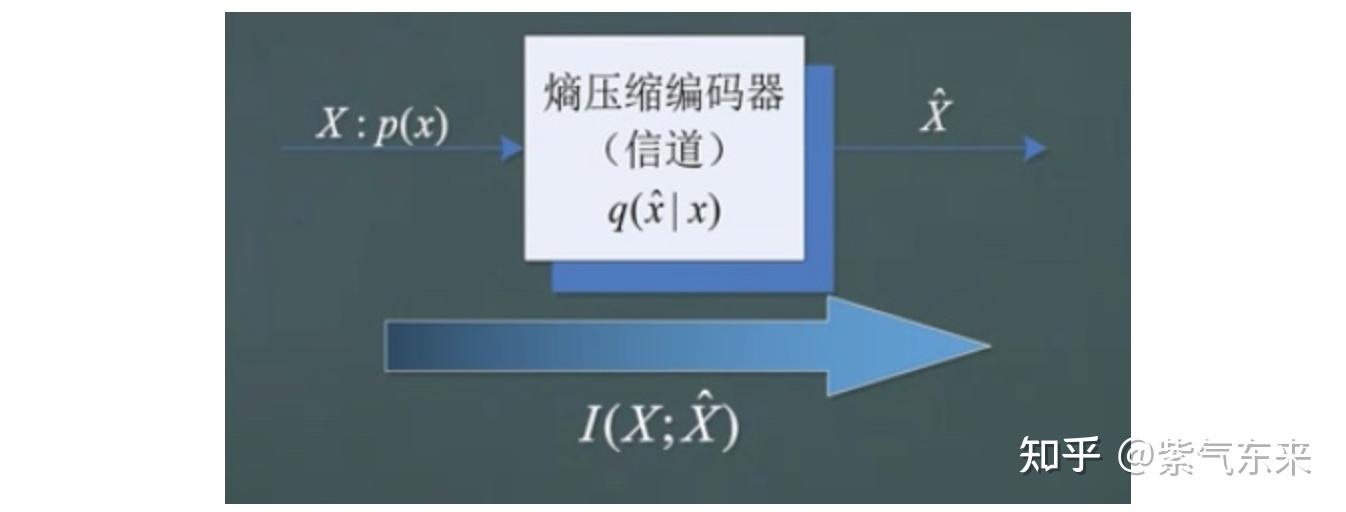 率失真函数的定义 :针对信源 X 和失真度量 d\left(x, \hat{x}\right) ,信息的率失真函数 R(D) 定义为: R(D)=\min {q(\hat{x} \mid x): \sum{x, \hat{x}} p(x) q(\hat{x} \mid x) d(x, \hat{x}) \leq D} I(X ; \hat{X})\\由于无法操作信源,能做的是最小化针对所有可能的条件分布 q(\hat{x}|x) ,并且使得联合分布满足要求的失真约束。这个函数求得的最小值,并不一定是可操作得到的,只是数学上的一个最小值。
在均方失真度量下,高斯信源的率失真函数是: R(D)=\left\{\begin{array}{cc} \frac{1}{2} \log \frac{\sigma^2}{D}, & 0 \leq D \leq \min \{p, 1-p\} \\ 0, & D>\min \{p, 1-p\} \end{array}\right. \\ 图像如下,这个结果告诉我们,“不存在在灰色区域之外运行的压缩系统”。实际压缩系统越接近红色(下限)边界,其性能就越好。作为一般规则,此边界只能通过增加编码块长度参数来实现。
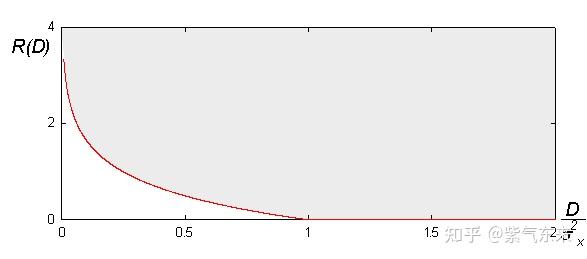 上式的证明过程如下: \begin{aligned} I(X ; \hat{X}) & =h(X)-h(X \mid \hat{X}) \\ & =\frac{1}{2} \log 2 \pi e \sigma^2-h(X-\hat{X} \mid \hat{X}) \\ & \geq \frac{1}{2} \log 2 \pi e \sigma^2-h(X-\hat{X}) \\ & \geq \frac{1}{2} \log 2 \pi e \sigma^2-h\left(N\left(0, E(X-\hat{X})^2\right)\right) \\ & \geq \frac{1}{2} \log 2 \pi e \sigma^2-\frac{1}{2} \log 2 \pi e D \\ & =\frac{1}{2} \log \frac{\sigma^2}{D} \end{aligned} \\
好了,在上一节不厌其烦地使用信息论对语言进行定义和分析后,本节讲尝试使用以上理论对 scaling law,由于 scaling law 的内涵比较深刻和复杂以及便于理解,本节将只在定性层面进行解释,更加严格的分析将放在最后一节。
scaling law 的最核心部分实际上是对于 loss 的估计和判断,即有如下经验公式:
\mathcal{L}=\mathcal{L}_0+\lambda Y^\gamma \\其中 \mathcal{L}0 表示无法通过训练减小的损失, Y 表示计算量, \lambda,\gamma 为系数。
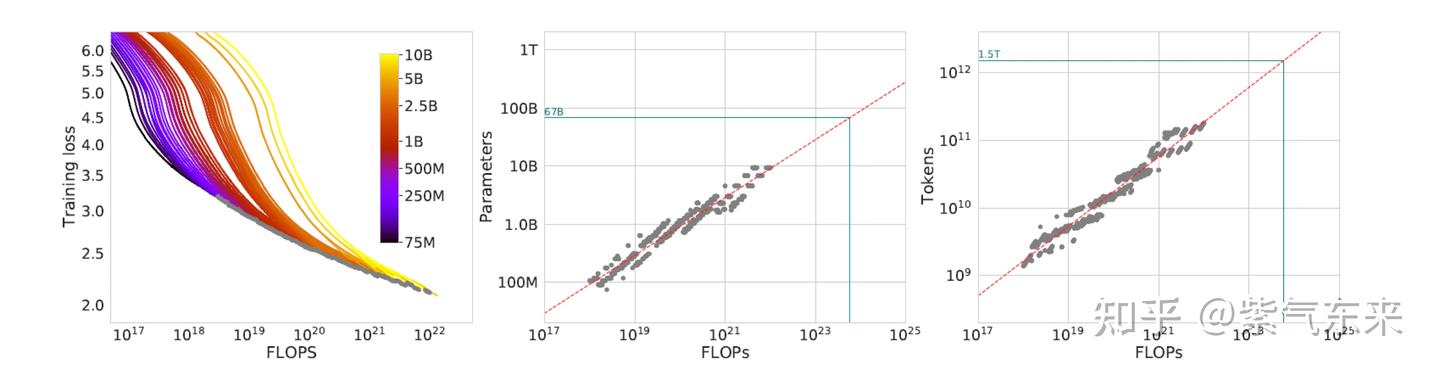 下边来使用上节的理论来解释以上经验公式,由于在当前模型训练都采用的是交叉熵损失,即
\mathcal{L}=\mathrm{CE}(\mathrm{P}, \mathrm{Q}) =H(P)+D{K L}(P | Q) \\ 然后我们可以不严谨地发现对应关系,即:
由此,比较定性地解释了 loss 的 scaling 的规律,实际上这种规律有更加准确的经验公式:
L(N, D)=E+\frac{A}{N^{0.34}}+\frac{B}{D^{0.28}}, \quad E=1.69, A=406.4, B=410.7 \
这里还可以顺便回答一些问题,
问题一: 为什么 scaling law 在 Transformer 模型上才起作用?为什么不是 LSTM,RWKV,Mamba 等 RNN 系的模型?
一个解释的角度就是,因为 Transformer 的 self-attention 结构可以有效捕获长文本之间的依赖关系,可以有效拟合语言的真实分布。而 RNN 系的模型,由于衰减因子的存在,无法在较长的范围内拟合语言的真实分布,即 RNN 系模型的 D_{K L}(P | Q) 更大。另一个原因则是工程上的,即 RNN 系模型无法实现高效的并行化训练,因此能够参与训练的数据量 D 更小,进一步导致了 D_{K L}(P | Q) 更大。
问题二: 为什么清洗数据很重要?
在一段正常的文本里加入一些乱码,会显著增加熵值(因为乱码是无法被准确预测的),即相当于增加了系统固定的 \mathrm{H}(\mathrm{P}) 。同时,噪声数据和重复数据也会使训练数据的分布偏离真实的语言分布,进而导致拟合过程的 D_{K L}(P | Q) 变大,由此会影响最终的训练效果。
问题三: 词表大小 (vocab size) 如何影响训练效果?
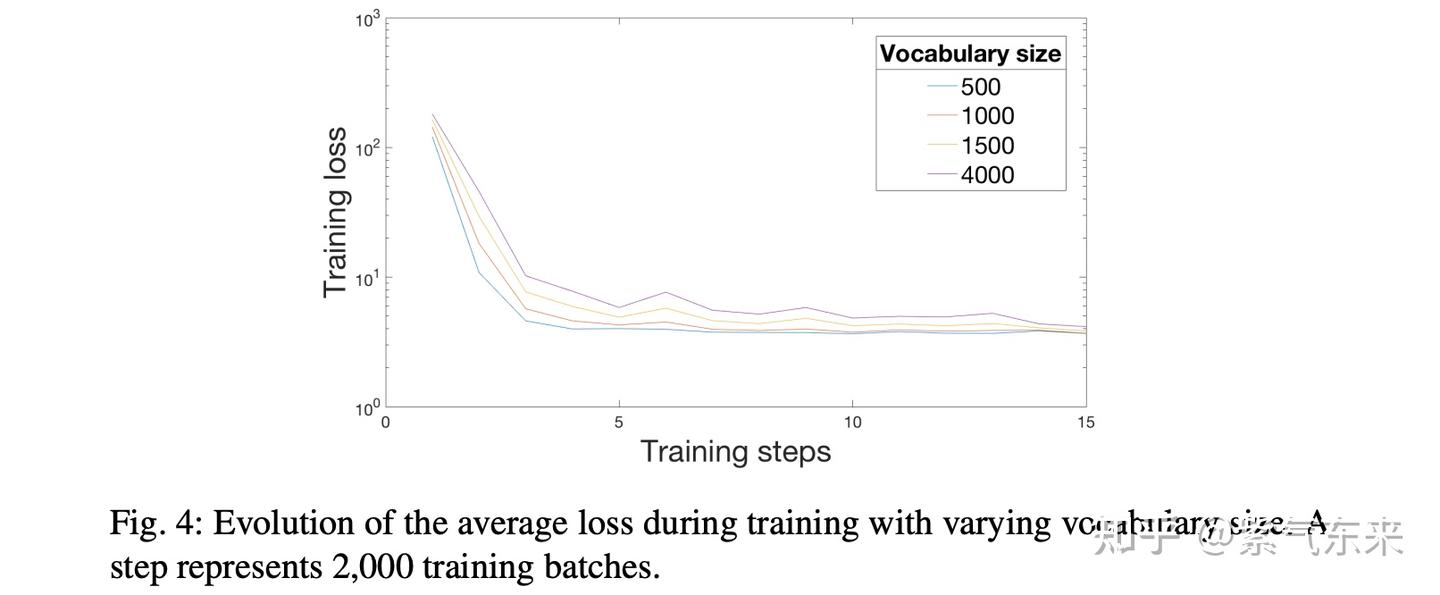
根据第一节的推导,词表大小决定了信息熵 \mathrm{H}(\mathrm{P}) 的上界。同时随着词表的增大,每个 token 出现的概率减小,即 \mathrm{H}(\mathrm{P}) 增大,这会导致 loss 的增大(如下图所示),但是增大词表又会提高编码效率,那么该如何进行取舍呢?
考虑影响 loss 的另一个因素 D_{K L}(P | Q) ,在模型规模不大时,即使增大词表,也有足够的数据使其训练充分,则大词表在一定范围内是有收益的。但是当模型规模过大时,增大词表时,达到同样拟合效果的数据需要更多,周期也更长,其开销将会大于收益。
在讨论数据量 D 和参数量 N 的关系之前,需要再回顾一下计算量 C 与二者的关系,即: C\approx 6ND \\ 该关系的由来笔者在之前的文章中进行过详细的推导,有兴趣可以查看,在此不予赘述。
事实上,上式的系数 6 在模型规模较大的时比较接近真实值,在模型较小时偏差较大,因此 Deepseek LLM 将该式描述为 C\approx MD ,其中典型 M,N 的计算方式如下:
\begin{aligned} 6 N_1 & =72 n_{\text {layer }} d_{\text {model }}^2 \\ 6 N_2 & =72 n_{\text {layer }} d_{\text {model }}^2+6 n_{\text {vocab }} d_{\text {model }} \\ M & =72 n_{\text {layer }} d_{\text {model }}^2+12 n_{\text {layer }} d_{\text {model }} l_{\text {seq }} \end{aligned} \\ 在不同模型规模下,其关系如下表所示: \begin{array}{cccc|ccc|cc} \hline n_{\text {layers }} & d_{\text {model }} & n_{\text {vocab }} & l_{\text {seq }} & N_1 & N_2 & M & \frac{6 N_1}{M} & \frac{6 N_2}{M} \\ \hline 8 & 512 & & & 25.2 \mathrm{M} & 77.6 \mathrm{M} & 352 \mathrm{M} & 0.43 & 1.32 \\ 12 & 768 & & & 84.9 \mathrm{M} & 164 \mathrm{M} & 963 \mathrm{M} & 0.53 & 1.02 \\ 24 & 1024 & & & 302 \mathrm{M} & 407 \mathrm{M} & 3.02 \mathrm{~B} & 0.60 & 0.81 \\ 24 & 2048 & 102400 & 4096 & 1.21 \mathrm{~B} & 1.42 \mathrm{~B} & 9.66 \mathrm{~B} & 0.75 & 0.88 \\ 32 & 4096 & & & 6.44 \mathrm{~B} & 6.86 \mathrm{~B} & 45.1 \mathrm{~B} & 0.85 & 0.91 \\ 40 & 5120 & & & 12.6 \mathrm{~B} & 13.1 \mathrm{~B} & 85.6 \mathrm{~B} & 0.88 & 0.92 \\ 80 & 8192 & & & 64.4 \mathrm{~B} & 65.3 \mathrm{~B} & 419 \mathrm{~B} & 0.92 & 0.94 \\ \hline \end{array} \\ 在弄清楚 C 与 N, D 的关系后,接下来就需要进一步研究 N,D 之间的关系,即分配关系。
在此不加证明地引用论文 An Information-Theoretic Analysis of Compute-Optimal Neural Scaling Laws 中使用信息论方法,所得到的简化后的 N,D 的优化解: N^* =\mathcal{O}\left(\frac{\sqrt{C}}{d\log \sqrt{\frac{C}{d^2 K^2}}}\right) \\D^=\mathcal{O}\left(\sqrt{C} \log \sqrt{\frac{C}{d^2 K^2}}\right)\\ 其中 K 是超参数,则 \frac{D^}{N^*} \sim \frac{\sqrt{C}}{K} ,在 Chichilla 论文里该比例的经验值是 20。
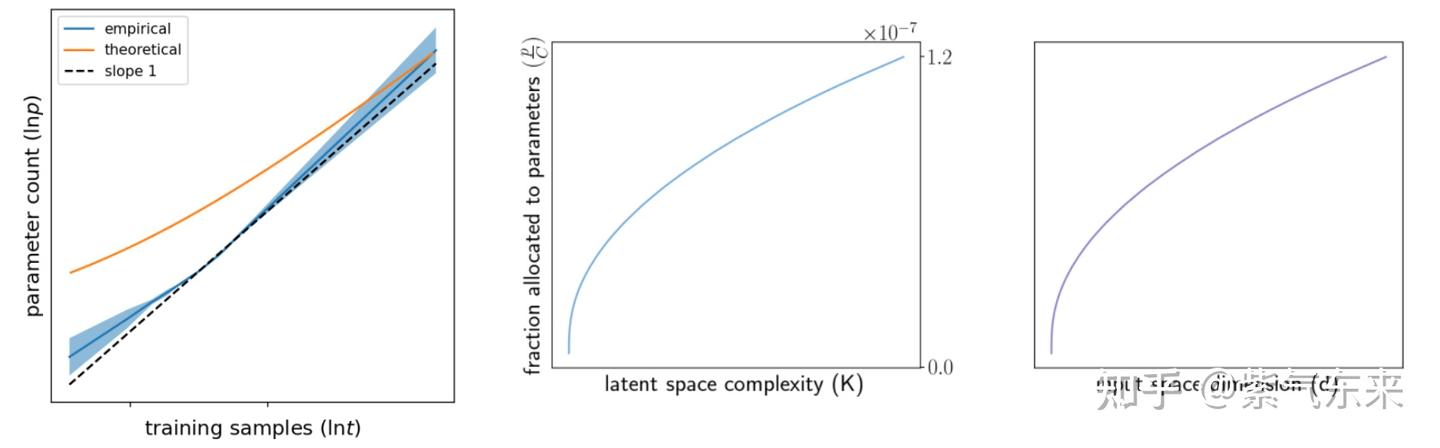
有了以上的结论之后,我们至少可以知道非常重要的几点信息,包括但不限于:
即使在完成以上两步之后还有一个重要工作要做,即:如何指导训练过程?其中和训练相关的最主要的两个参数就是 Batch size 和 Learning rate。
通常而言,在模型确定的情况下,增大 Batch size ,会使数据更加接近真实分布,进而使得梯度估计的噪声较小,因此可以允许更大的 Learning rate。这个关系在论文 An Empirical Model of Large-Batch Training 也得到了验证。
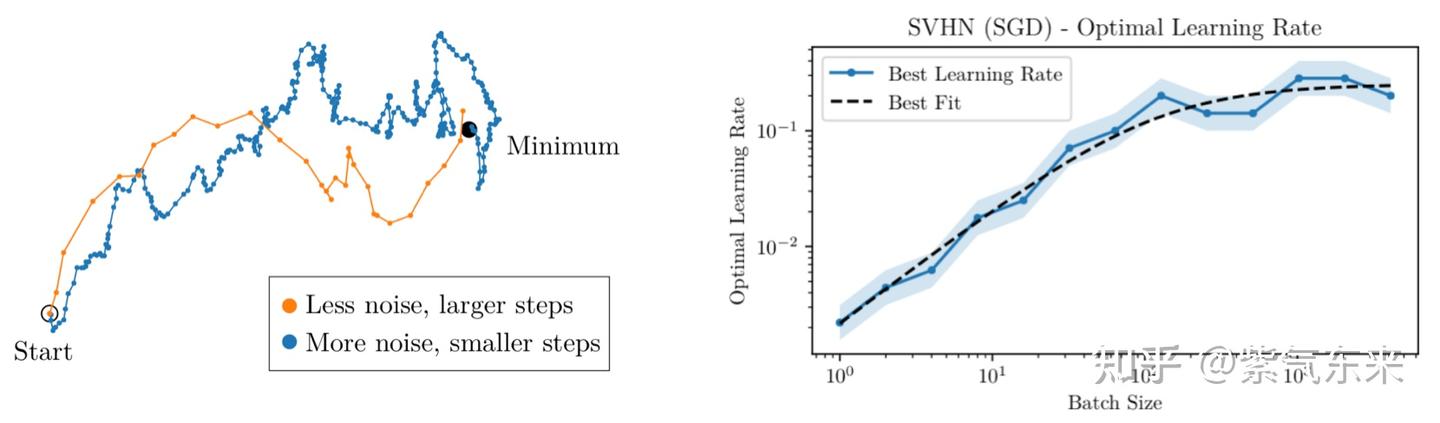 那么如果模型参数量增加了,Learning rate 应该怎么调整呢?通常应该调小,理由如下:
事实上,在 scaling law 中也有同样的经验的发现,以下是 Deepseek LLM 的经验值: \begin{aligned} \eta_{\mathrm{opt}} & =0.3118 \cdot C^{-0.1250} \\ B_{\mathrm{opt}} & =0.2920 \cdot C^{0.3271} \end{aligned}\
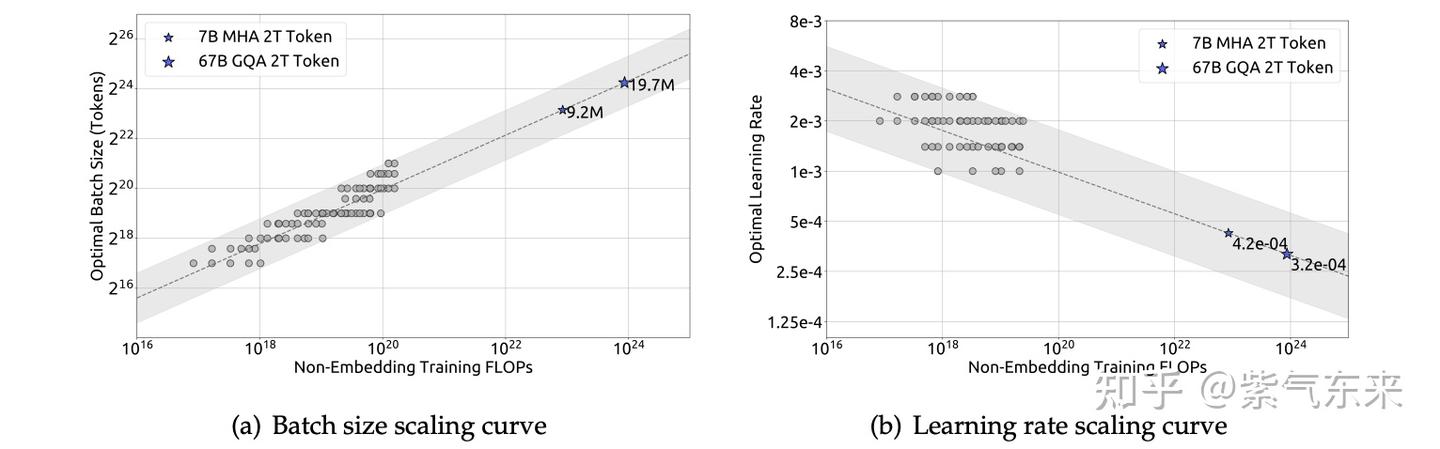 以上只是定性分析,那么是否有定量结果呢?此前,业界主要参考两套经典理论:
OpenAI 的成员 Jack Rae 曾在 Stanford MLSys Seminar 的访谈时进行了一个名为 Compression for AGI 的主题分享,其核心观点为:**AGI 基础模型的目标是实现对有效信息最大限度的无损压缩。**即 LLM = Compression (GPT 的 Next Token Prediction 本质上是对训练数据的无损压缩)。通过论证压缩即智能,GPT 的训练过程是对数据的无损压缩,从而证明了 GPT 拥有智能。下面通过有损信息压缩的角度一探究竟:
将一组向量 V=(v_1,v_2,\dots ,v_n) \in \mathbb{R}^{n\times d} 进行有损编码为二进制,然后在失真 \mathbb{E}\left[\left|v_i-\hat{v}i\right|^2\right] \leq \varepsilon^2 的范围内恢复成原向量。编码后的序列长度为 L(V): \mathbb{R}^{n \times d} \rightarrow \mathbb{Z}{+} 。
对于0 均值的高斯分布 \mathcal{N}(0, \Sigma) 的率失真的近似值(每个向量所需的平均比特数)为 R(V) \doteq \frac{1}{2} \log 2 \operatorname{det}\left(I+\frac{d}{\varepsilon^2 n} V V^T\right) \\ 其中 \hat\Sigma = \frac{1}{n} V V^T 表示协方差矩阵 \Sigma 的估计值。
对于 n 个向量,需要 nR(V) 比特,由于最优编码本对数据 V 是自适应的,我们还必须用额外的 dR(V) 比特来表示,因此总体编码长度为 L(V)=(n+d)R(V) = \frac{n+d}{2} \log \operatorname{det}\left(I+\frac{d}{\varepsilon^2 n} V V^T\right) \\根据第一节的介绍,熵 \mathrm{H}(X)=-\sum{x \in \mathcal{X}} p(x) \log p(x) ,但是在真实场景下,真实分布 p(x) 是很难获取的。另一方面,从概念上讲熵等同于无损编码数据所需的最小位数,因此可以使用最小无损编码长度来表示熵。而对于连续随机变量,无损编码是无法实现的,因此利用有损数据编码中的编码长度作为连续随机变量的熵。
假设 V 有r个大小相等的奇异值(r-子空间),则归一化熵可以计算如下 \frac{\mathrm{L}(V)}{\frac{d+n}{2} d \log \left(1+\frac{1}{\epsilon^2}\right)}=\left(\frac{r}{d} \log \left(1+\frac{\frac{1}{\epsilon^2}}{\frac{r}{d}}\right)\right) / \log \left(1+\frac{1}{\epsilon^2}\right) .\\ 根据Large Language Model Evaluation via Matrix Entropy 的研究, \frac{r}{d} 有一个很好的确定性估计,可以得到下面的图像关系,即大致满足“幂率”关系。
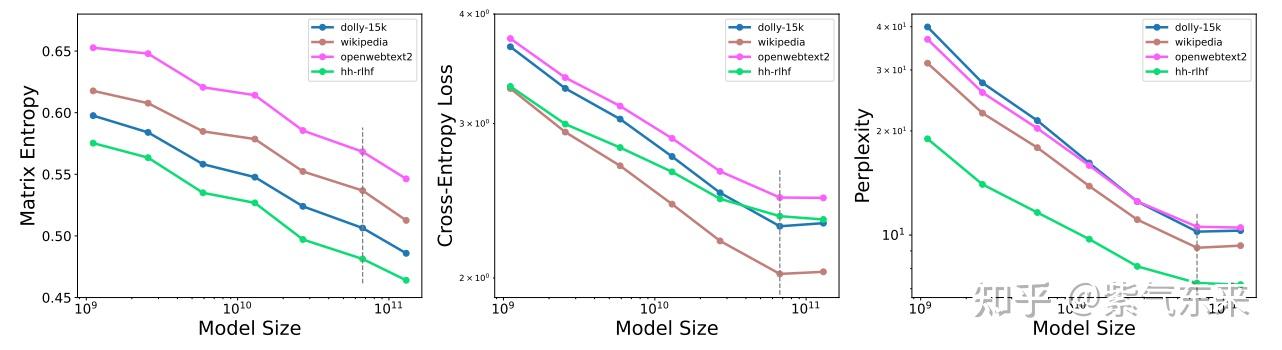
接下来将讨论如何从信息理论上推导出缩放定律。LLM 具有通过扩展句子片段生成完整句子的强大能力,假设预训练数据集为 \mathcal{D} ,然后以 \mathcal{D} 中的句子(段落)作为基本元素,并将其集合表示为 \mathcal{X} 。
假设任何语料库中都有 M 种可能理解的技能。假定语料库中的每个文本片段都会链接到所有相关的技能,这样就会形成一个双方图,即技能图。
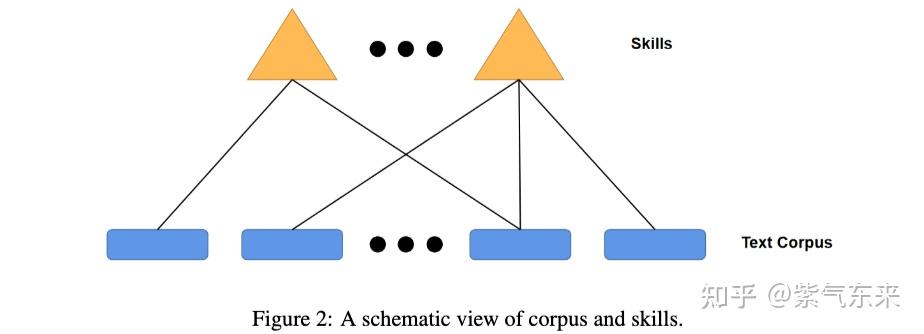 假设每种技能 y_k 的度数与 k^{-(\alpha +1)} 成正比,其中我们按照技能在双方图中的度数进行排序。因此,通过对度进行归一化处理,技能分布遵循幂律,即 p_{\text {skill }}\left(y_k\right)=\frac{k^{-(\alpha+1)}}{Z_\alpha}(\alpha>0)\\ 其中 Z_\alpha = \Sigma_{k=1}^{M}k^{-(\alpha+1)} 为定值。
既然我们希望 LLM 能够理解(学习)技能,那么理解技能意味着什么呢?直观地说,一个句子的描述将是一个(二进制)字符串,如果我们真的 "理解 "了它,那么它的长度应该尽可能短,即进行了充分地“压缩”。
在信息论中,代码 \mathcal{C} 是将 \mathcal{X} 映射到二进制字符串空间(码字空间)的函数,其中没有一个码字 \mathcal{C}(x) 是另一个码字 \mathcal{C}(x’) 的前缀。代码 \mathcal{C} 的期望码长是分布 {p(x)}{x\in \mathcal{X}} 下二进制符号的平均数量
l(\mathcal{C})=\sum{x \in \mathcal{X}} p(x)|\mathcal{C}(x)| \\ 根据信息论的标准结果,任何预期代码长度都大于 H(X) 。
假设密度函数为 X ∼ p_θ 。考虑 LLM 在训练过程中的行为,对于随机初始化模型, 假定所有技能的条件熵都是常数 B ,对于任何技能 y ,特定的 LLM p_θ 只有在 H(X|y) = C 时才能理解该技能,其中 C < B 。
对于所有技能,我们根据它们的出现概率来排列它们的“难度”。也就是说,对于任意的技能 y_1 和 y_2 ,如果 p_{skill}(y_1) \geq p_{skill}(y_2) ,我们称技能 y_1 比 y_2 更容易。假设模型从最简单到最难依次学习技能,只有它完全理解了一种技能,它才会学习下一种技能。
假设一个 LLM 掌握 n 种技能, X ∼ p_\theta,Y ∼ p_{skill} ,那么条件熵 H(X|Y ) 与 n 服从幂律关系 \begin{aligned} & \mathrm{H}(X \mid Y) \\ = & \sum_y p_{\text {skill }}(y) \mathrm{H}(X \mid y) \\ = & \sum_{i=1}^n p_{\text {skill }}\left(y_i\right) \mathrm{H}\left(X \mid y_i\right)+\sum_{i>n} p_{\text {skill }}\left(y_i\right) \mathrm{H}\left(X \mid y_i\right) \\ = & \sum_{i=1}^n p_{\text {skill }}\left(y_i\right) C+\sum_{i>n} p_{\text {skill }}\left(y_i\right) B \\ = & \sum_{i=1}^n p_{\text {skill }}\left(y_i\right) C+\sum_{i>n} p_{\text {skill }}\left(y_i\right) C-\sum_{i>n} p_{\text {skill }}\left(y_i\right) C+\sum_{i>n} p_{\text {skill }}\left(y_i\right) B \\ = & C+\sum_{i>n} p_{\text {skill }}\left(y_i\right)(B-C) \\ \sim & C+(B-C) \int_{y=n}^M \frac{y^{-\alpha-1}}{Z_\alpha} d y \\ \sim & O\left(n^{-\alpha}\right) . \end{aligned}\\ 参数的scaling law,假设每 r 个神经元都能理解一种技能。则 H(X|Y ) ∼ O(N^{-\alpha}) 。
接下来讨论 FLOPs 的 scaling law.
假设在开始理解每个技能时,每次浮点计算都会减少 ∆ 条件熵。假设每次浮点计算有概率 p_{skill}(y) 来学习到技能 y 。那么对于技能 y_i 则需要 \frac{B-C}{p_{\text {skill }}\left(y_i\right) \Delta} 次浮点计算才能够理解。由于技能是按顺序学习的,因此经过 S flops 后的优化模型可以学到的技能数如下: S=\sum_{i=1}^n \frac{B-C}{\Delta} \frac{1}{p_{\text {skill }}\left(y_i\right)} \sim \int_{y=1}^n y^{\alpha+1} d y \sim O\left(n^{\alpha+2}\right) .\\ 则有 H(X|Y ) ∼ O(S^{-\frac{\alpha}{\alpha+2}}) 。
以上说明了条件熵服从幂律关系,根据第一节的理论 H(X)=H(X|Y)+I(X;Y) ,由于信息压缩的过程即是对互信息的最小化的过程,即可以将 I(X;Y) 看作一个定值,则熵也服从幂律。
以上证明过程主要参考 The Information of Large Language Model Geometry,感兴趣可以参看原文。
[1] Evaluation Metrics for Language Modeling (thegradient.pub) [2] The Information of Large Language Model Geometry (arxiv.org) [3] 2212.01365.pdf (arxiv.org) [4] https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf [5] Generating Sequences With Recurrent Neural Networks [6] 基于量子化假设推导模型的尺度定律(Scaling Law) [7] Scaling Laws for Autoregressive Generative Modeling [8] Scaling Laws for Neural Language Models [9] Training Compute-Optimal Large Language Models [10] An Empirical Model of Large-Batch Training [11] DeepSeek LLM [12] GPT-4 Technical Report [13] https://www.researchgate.net/figure/Evolution-of-the-average-loss-during-training-with-varying-vocabulary-size-A-step_fig3_329276137 [14] Deep Learning and the Information Bottleneck Principle [15] Large Language Model Evaluation via Matrix Entropy [16] Self-Supervised Learning via Maximum Entropy Coding [17] Matrix Information Theory for Self-Supervised Learning [18] Segmentation of Multivariate Mixed Data via Lossy Data Coding and Compression [19] 信息论——信息速率失真函数与熵压缩编码(一) [20] https://www.cl.cam.ac.uk/teaching/1819/ForModLang/notes/Language_as_information_notes.pdf [21] https://aclanthology.org/2023.emnlp-main.762.pdf [22] https://mdpi-res.com/bookfiles/book/2614/Information_Theory_and_Language.pdf?v=1726102906 [23] https://www.researchgate.net/publication/381911126_Information-Theoretic_Foundations_for_Neural_Scaling_Laws [24] Information Theory, Scaling Laws and the Thermodynamics of Evolution [25] LLMZip: Lossless Text Compression using Large Language Models
笛声依约芦花里。白鸟成行忽惊起。别来闲整钓鱼竿。思入水云寒。 —— 潘阆 《酒泉子·长忆西湖》 编辑于 2026-01-12 12:22・北京 LLM 信息论 OpenAI 赞同 37821 条评论641 30 分享 申请转载
未登录用户
21 条评论
默认
最新
 微信用户
 你确定原分布的熵是对应scaling law那不可被优化的下界吗?现在nlp训练一般是把已有文本当作确定事件来看待,这意味着他的熵已经是0了吧。
2025-07-11 · 广东
回复1
 紫气东来
作者
 如果认为熵为0,实际上等价于可以以0bit传输这份数据,这是信息论本身的定义
2025-07-11 · 上海
回复喜欢
展开其他 1 条回复
 一念花开
除了解释,能否引入操作性呢?信息论的核心研究思路是通过可达性和逆定理证明bound,二者都成立,才能说明一个数学量具有操作意义。
具有了操作意义才有现实指导价值,大模型训练的bound到底是什么?如何用客观数学量形式化?我认为这是首先需要解决的问题
04-21 · 北京
回复喜欢
 INFAAA
太强了,先收藏着,看了一遍没怎么看懂
 2025-04-21 · 浙江
回复喜欢
 小飞机
大哥 为啥您可以看这么多东西 学这么多东西啊 tql 我跪了
2025-02-02 · 山东
回复喜欢
 icework
第一次看到关于"scaling law"的理论解释,太棒了!
大佬有没有针对视觉或者自动驾驶大模型的研究,期待ing!
2024-08-27 · 北京
回复喜欢
 马星宇
请问L0怎么计算,我想做其他模态的scaling,L0怎么确定呢
2024-05-01 · 四川
回复喜欢
 Goya
 请问1.1节那里,b_n的熵为啥不是K_n呀 > <
2024-04-17 · 北京
回复喜欢
 MING-X
好文章
 2024-04-09 · 湖北
回复喜欢
展开其他 3 条回复
 江左梅郎
好文章
2024-04-08 · 上海
回复喜欢
 巡星
还是不理解为什么F_N是递减的。最后的等式等于0意味着给定前面N-1个字符b_{N-1},w_{N+1}和w_{N}的条件熵是一样的,可是这不是显然的事情。如果我理解错了还请见谅。
2024-04-04 · 日本
回复喜欢
紫气东来
作者
你是不是没看到不等号
2024-04-08 · 上海
回复喜欢
展开其他 2 条回复
点击查看全部评论
未登录用户
关于作者
紫气东来
吾生也有涯,而知也无涯~
上海交通大学 工学硕士
回答 32 文章 114 关注者 24,445
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 强化学习之父:LLM主导只是暂时,扩展计算才是正解 量子位发表于量子位
 杨立昆再出“狂言”:LLM和机器人正走向死胡同,世界模型才是正解 DeepTech深科技
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码