 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
单卡 3 小时训练专属大模型 Agent:基于 LLaMA Factory 实战
首发于大模型的技术和应用
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
单卡 3 小时训练专属大模型 Agent:基于 LLaMA Factory 实战
首发于大模型的技术和应用
切换模式
 hiyouga
NLPer
收录于 · 大模型的技术和应用
452 人赞同了该文章
Agent(智能体)是当今 LLM(大模型)应用的热门话题[1],通过任务分解(task planning)、工具调用(tool using)和多智能体协作(multi-agent cooperation)等途径,LLM Agent 有望突破传统语言模型能力界限,体现出更强的智能水平。在这之中,调用外部工具 解决问题成为 LLM Agent 必不可缺的一项技能,模型根据用户问题从工具列表中选择恰当的工具,同时生成工具调用参数,综合工具返回结果和上下文信息总结出答案。通过调用外部工具,LLM 能够获取到实时、准确 的知识,大大降低了生成中的幻觉(hallucination)现象,使 LLM 的任务解决能力得到长足的提升。工具调用能力的获得离不开模型微调,尽管使用 ReAct 提示[2]或其他预训练模型也能实现类似效果,但对于定制化或更加广泛的工具,对模型做进一步微调能有效地提升工具使用能力。本文将会带领大家使用 LLaMA Factory 的 Agent Tuning 功能,使用单张 GPU 在 3 小时内训练出自己专属的 LLM Agent。
之前文章[3]已经讲到,LLaMA Factory 是一个涵盖预训练、指令微调到 RLHF 阶段的开源全栈大模型微调框架,具备高效、易用、可扩展 的优点,配备有零代码可视化的一站式网页微调界面 LLaMA Board。经过半年多的升级迭代,LLaMA Board 网页微调界面在原先的基础上,丰富了多种新的功能,包括:
读者可以在 HuggingFace Spaces 或 魔搭社区 预览 LLaMA Board 网页微调界面。
本次我们选用零一万物[4]发布的 Yi-6B 开源双语基座模型,该模型于 2023 年 11 月发布,拥有约 60 亿参数,通过在 3T 多语言语料上的预训练,取得了同等规模下优异的中英文 Benchmark 效果,且允许免费商用。由于 Yi-6B 是一个预训练基座模型,并不具备对话能力,因此我们选用多个开源数据集对模型做指令监督微调(SFT)。在这些数据集中最关键的是工具调用数据集 ,该数据集包含约十万条由 Glaive AI[5]生成的关于工具调用的对话样本,我们将数据集处理为多角色的多轮对话样本 ,包含用户(human)、模型(gpt)、工具调用(function_call)和工具返回结果(observation)四种不同角色,同时还有一个工具列表(tools)字段,以 OpenAI 的格式[6]定义了可选工具。下面是数据集中的一个样本示例:
{
  "conversations": [
    {
      "from": "human",
      "value": "I saw a dress that I liked. It was originally priced at $200 but it's on sale for 20% off. Can you tell me how much it will cost after the discount?"
    },
    {
      "from": "function_call",
      "value": "{\"name\": \"calculate_discount\", \"arguments\": {\"original_price\": 200, \"discount_percentage\": 20}}"
    },
    {
      "from": "observation",
      "value": "{\"discounted_price\": 160}"
    },
    {
      "from": "gpt",
      "value": "The dress will cost you $160 after the 20% discount."
    }
  ],
  "tools": "[{\"name\": \"calculate_discount\", \"description\": \"Calculate the discounted price\", \"parameters\": {\"type\": \"object\", \"properties\": {\"original_price\": {\"type\": \"number\", \"description\": \"The original price of the item\"}, \"discount_percentage\": {\"type\": \"number\", \"description\": \"The percentage of discount\"}}, \"required\": [\"original_price\", \"discount_percentage\"]}}]"
}
如果读者想要加入自定义工具,只需要按照上述格式组织数据集即可。除此之外,我们也在本次训练中加入 Alpaca-GPT-4 数据集[7]和 Open-Assistant 数据集[8]以提升模型的通用对话能力。
文章默认读者有至少不弱于 RTX 3090 24GB 的显卡和足够的系统内存,且安装了 CUDA 11.1-12.3 任一版本,关于 CUDA 环境的配置此处不予赘述。 我们已经将所有的程序打包,您可以选择自己的 Anaconda 环境,运行以下命令安装 LLaMA Factory。
pip install llmtuner==0.5.1
接着从 GitHub 下载数据集文件,这里以 Linux 命令行方法为示例,您也可以选择从 GitHub 网页下载,下载后切换到新的文件目录,运行 ls 命令应当显示同一级目录中存在 data 文件夹 。
git clone[](https://zhida.zhihu.com/search?content_id=239016335&content_type=Article&match_order=1&q=clone&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNTUsInEiOiJjbG9uZSIsInpoaWRhX3NvdXJjZSI6ImVudGl0eSIsImNvbnRlbnRfaWQiOjIzOTAxNjMzNSwiY29udGVudF90eXBlIjoiQXJ0aWNsZSIsIm1hdGNoX29yZGVyIjoxLCJ6ZF90b2tlbiI6bnVsbH0.Cld852rFNlvHrIdDmSdqUG7IQsqDwxV45aTLyV8O9JA&zhida_source=entity) https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory
ls # data src tests ...
由于 LLaMA Board 网页微调界面仅支持单卡训练,需要设置环境变量指定使用的显卡序号。此外可以选择模型下载源,这里推荐国内用户使用魔搭社区下载渠道。
export CUDA_VISIBLE_DEVICES=0 # 使用第一块 GPU
export USE_MODELSCOPE_HUB=1 # 使用魔搭社区下载渠道
如果您使用的是 Windows 系统,同样需要配置相关环境变量。
set CUDA_VISIBLE_DEVICES=0
set USE_MODELSCOPE_HUB=1
然后使用下述命令启动 LLaMA Board 网页微调界面。
unset http_proxy https_proxy all_proxy # 关闭代理
python -m llmtuner.webui.interface
① 打开浏览器,在地址栏输入 localhost:7860 进入 LLaMA Board,可以看到以下界面,点击左上角的 lang 选项中将界面语言切换为中文。
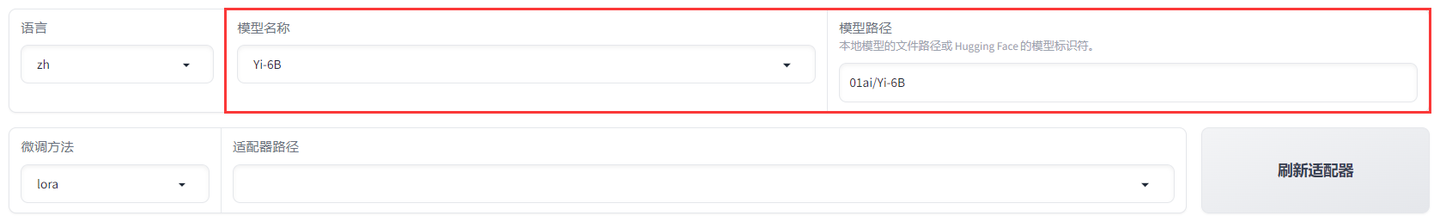
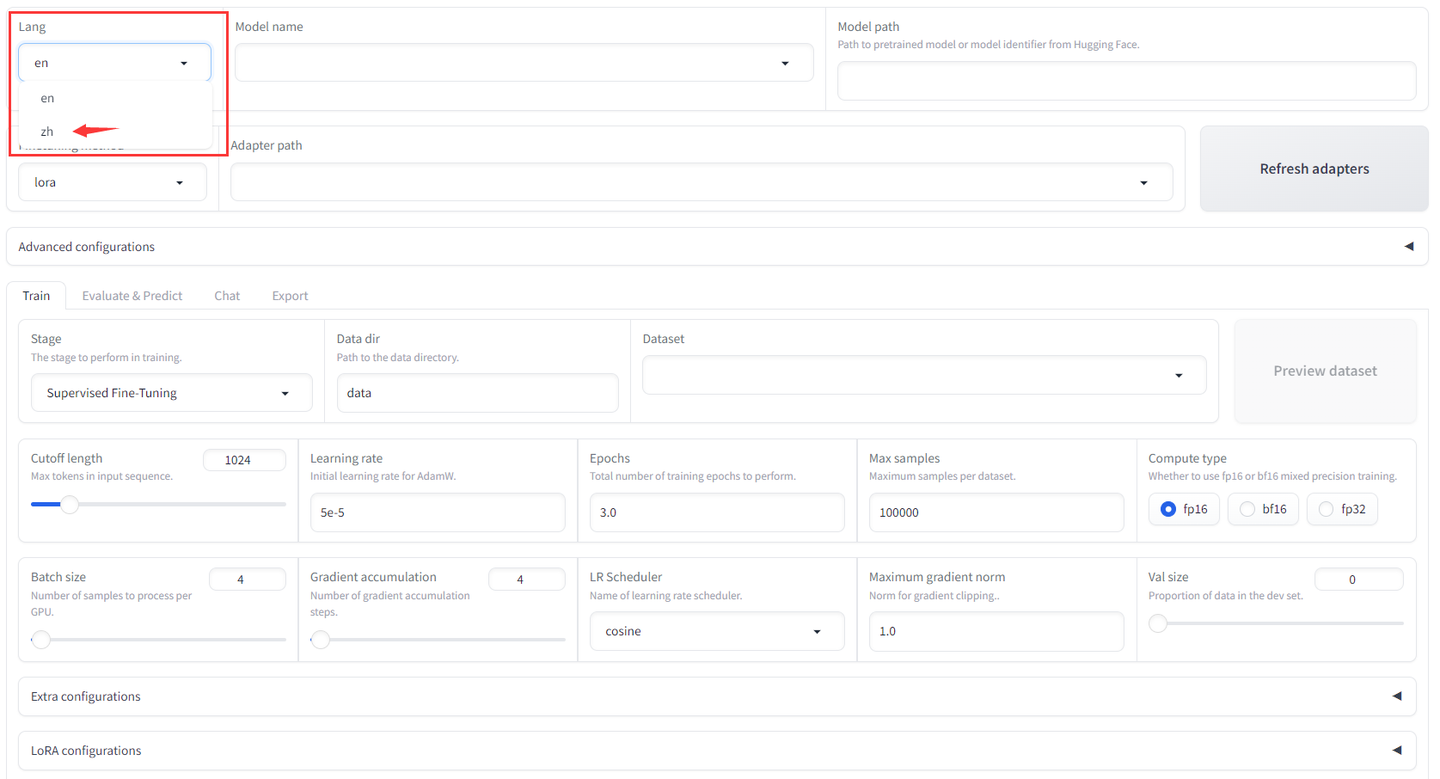 ② 点击模型名称 ,选择 Yi-6B 模型,此时**模型路径** 默认会显示远程模型地址,如果您已经将模型文件全部下载至本地,可以手动将其修改为本地文件夹路径。
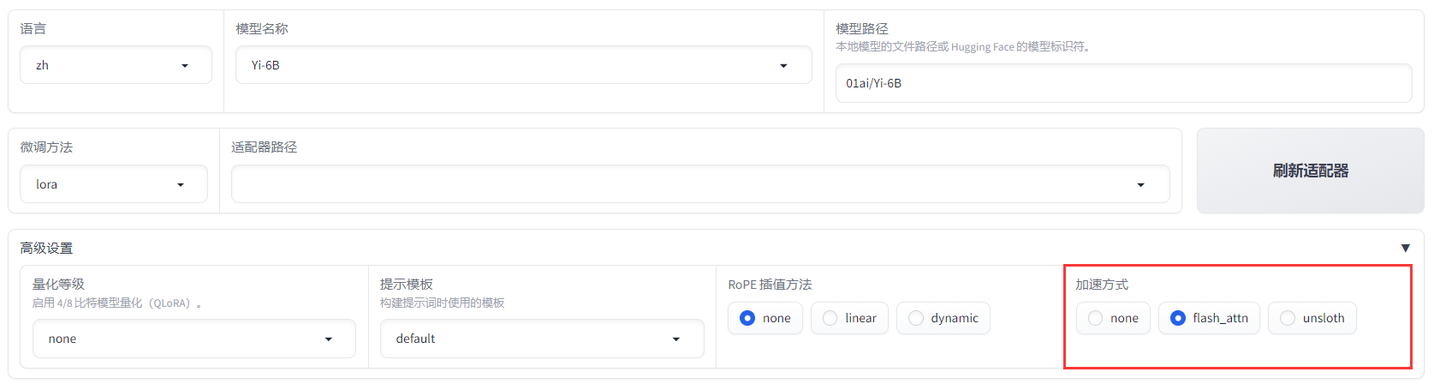
 ③ 如果您已经安装过 Flash Attention-2 或 Unsloth,可以点击高级设置-加速方式 提升训练速度,其中 Flash Attention-2[9]可提升至 120% 左右的速度,Unsloth[10]可提升至 170% 左右的速度。此处我们略过安装过程,请各位读者自行查阅参考文献中的 GitHub 仓库安装,如果两者均未安装,请保持加速方式为 None。
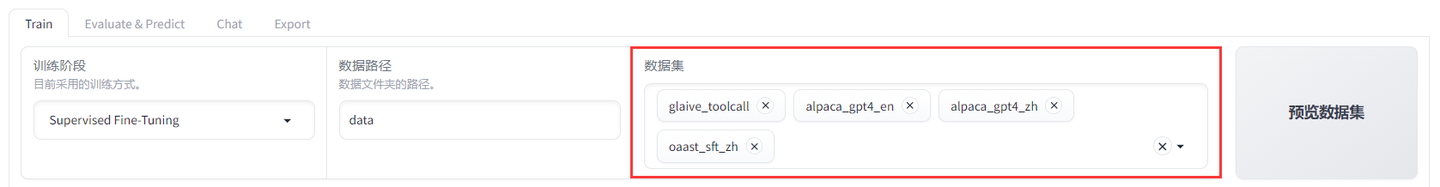
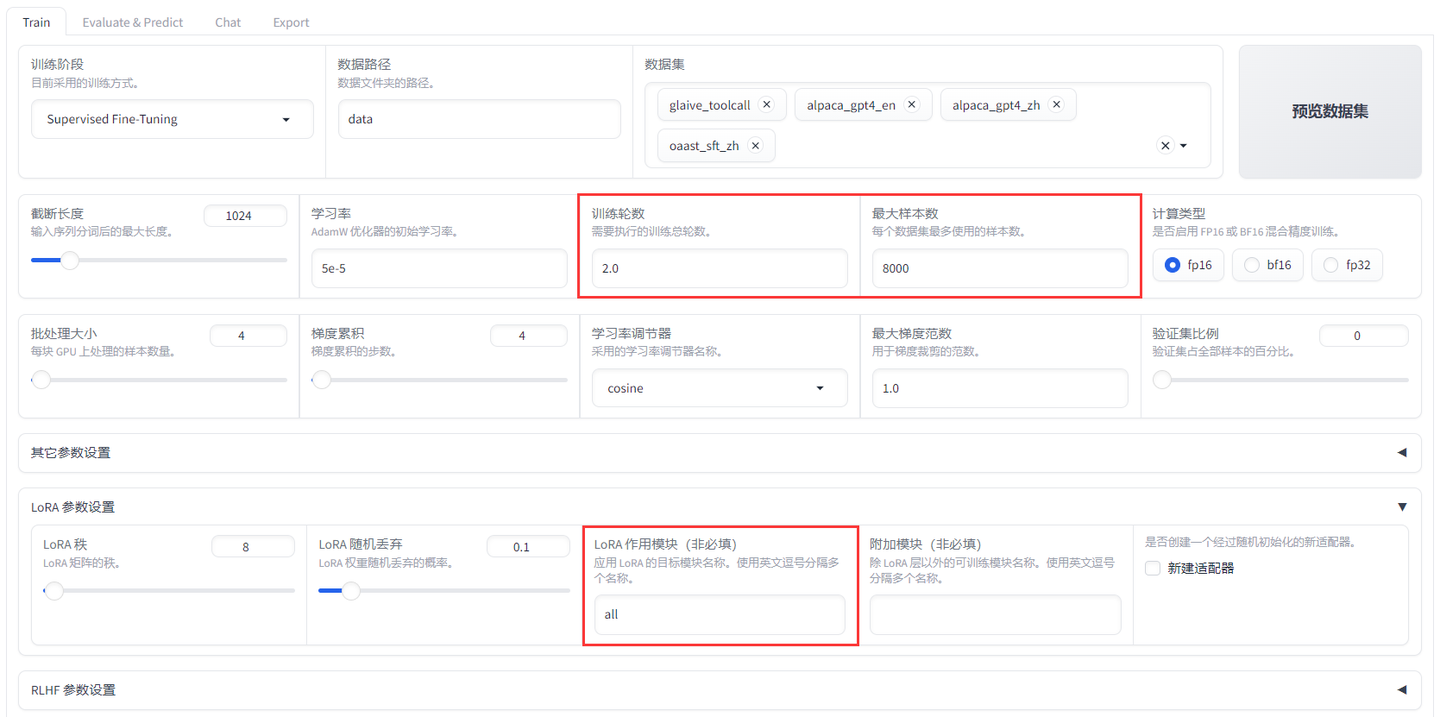
 ④ 点击数据集 ,选择我们此次要使用的四个数据集 glaive_toolcall、alpaca_gpt4_en、alpaca_gpt4_zh 和 oaast_sft_zh,如果数据集下拉框为空白,请检查数据路径 是否正确。选择后点击预览数据集 按钮可预览数据集。
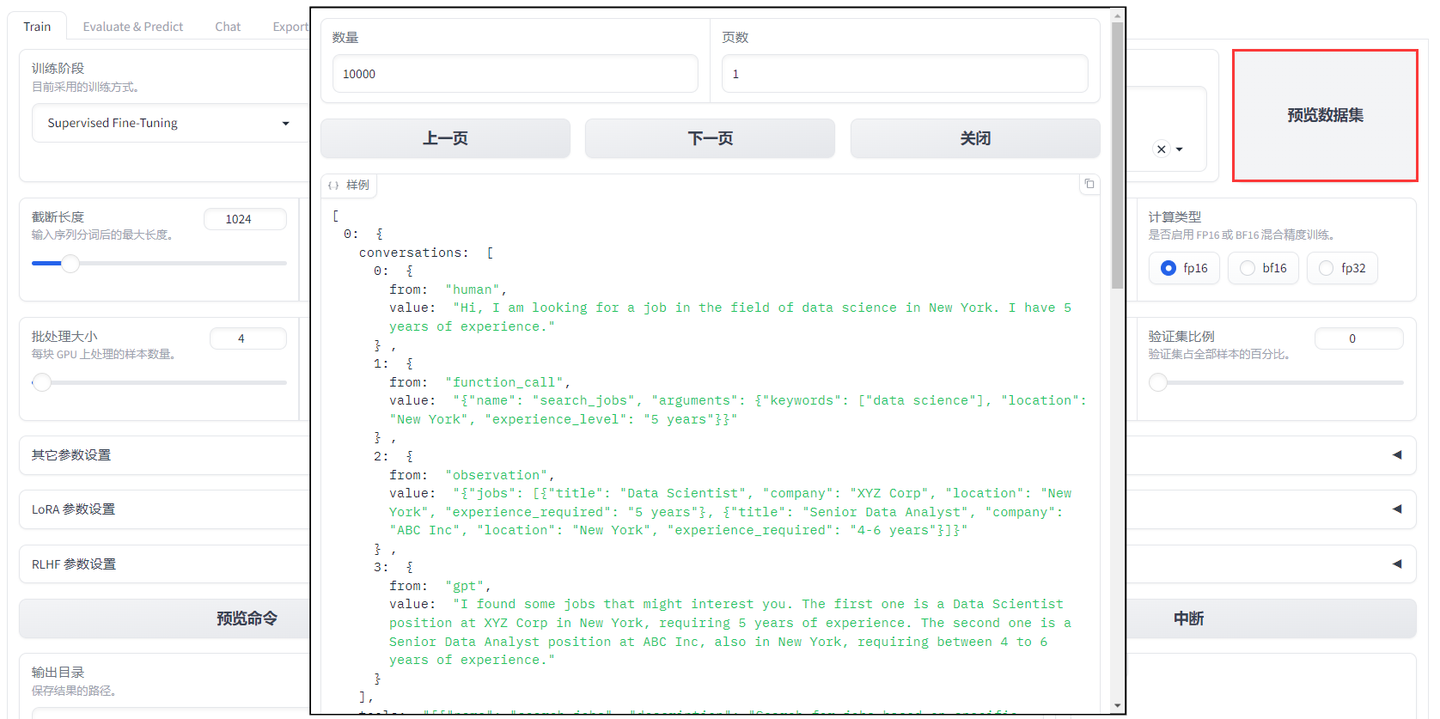 ⑤ 训练参数中与显存占用有紧密关联的是**截断长度** 和批处理大小 选项,我们暂时保持默认。这里仅将训练轮数 设置为 2.0,最大样本数 设置为 8000,LoRA 参数设置-LoRA 作用模块 设置为 all。
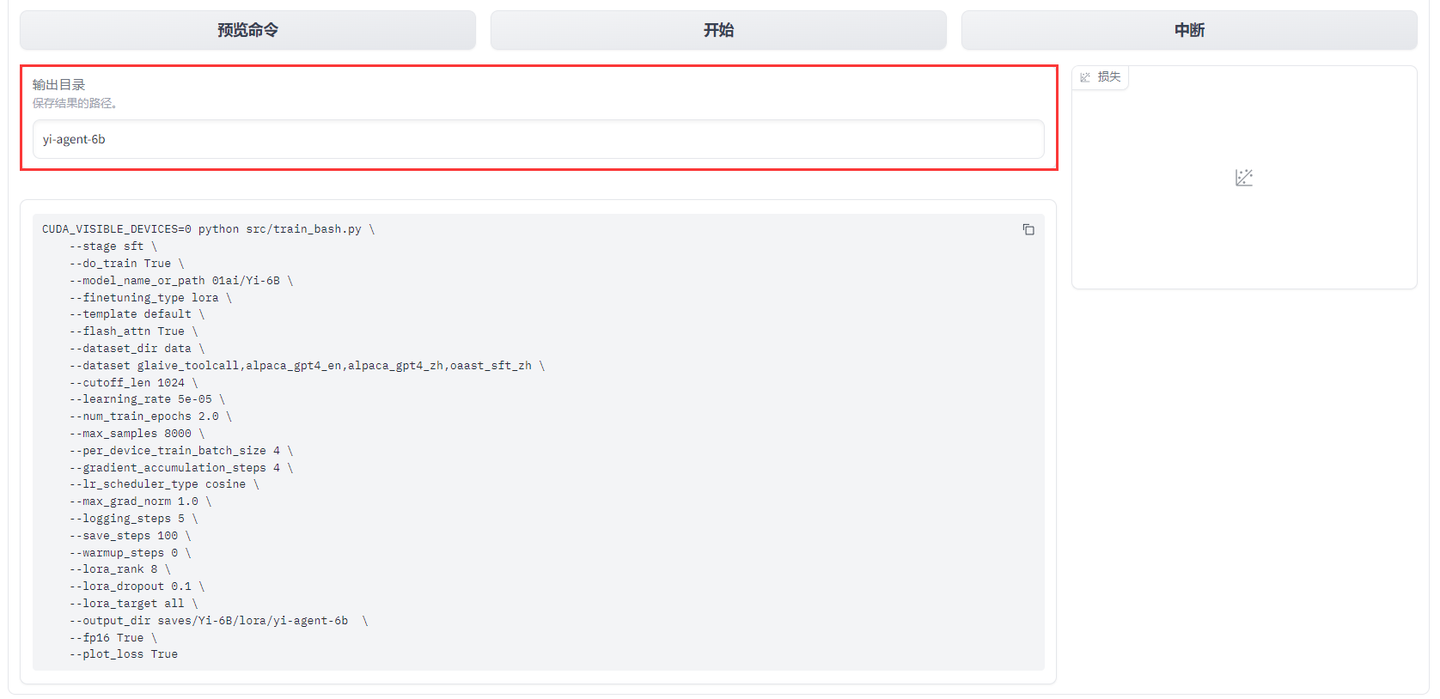
 ⑥ 将页面翻到底部,将输出目录 设置为 yi-agent-6b,训练后的模型文件会保存在 saves/Yi-6B/lora/yi-agent-6b 中。点击预览命令 按钮可以看到当前配置对应的命令行脚本,如果您想使用多卡训练,可以参考下述命令来编写多卡训练脚本。
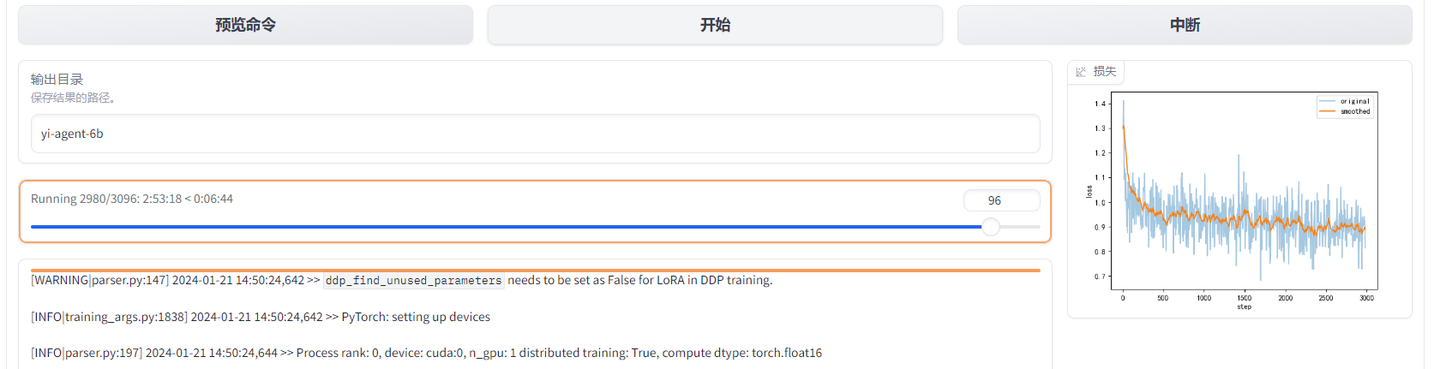
 ⑦ 点击开始 按钮启动模型训练,训练日志和损失变化图会实时展现在页面中,此时可以自由关闭或刷新网页,在本文的测试环境(A100 40GB * 1)下,约 3 小时即可完成模型训练。
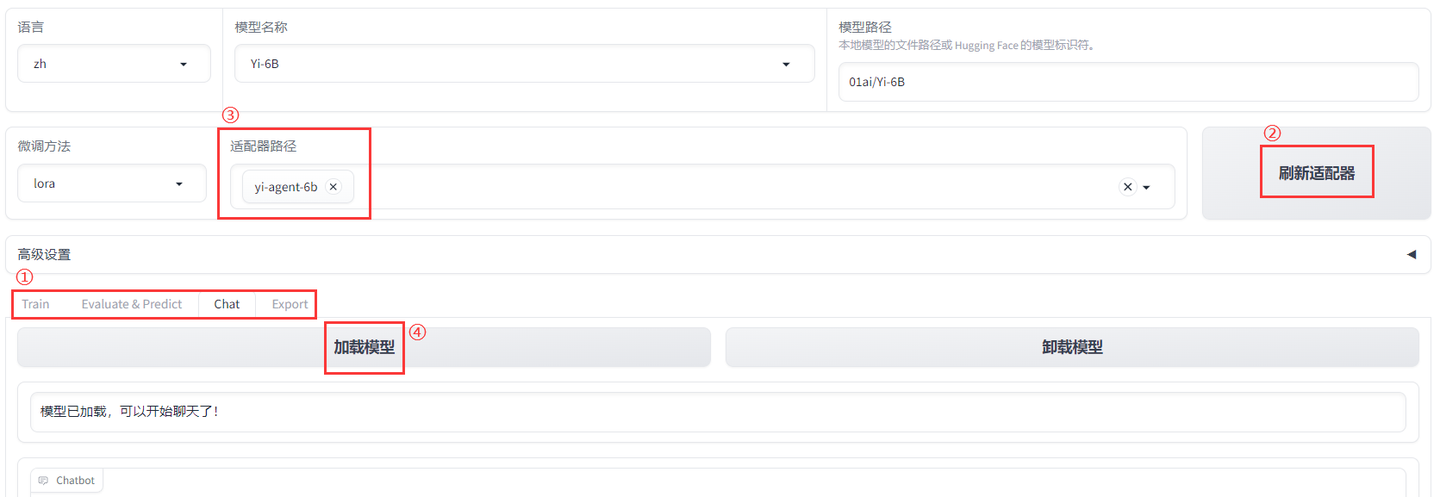
 ⑧ 训练结束后,我们切换到 Chat 栏,点击刷新适配器 按钮,将适配器路径 切换至 yi-agent-6b,点击加载模型 按钮载入刚刚训练好的模型。
 如果模型可以正常加载,那么恭喜你!仅花费一部电影的时间,就成功训练出了自己专属的 LLM Agent。
① 基本对话
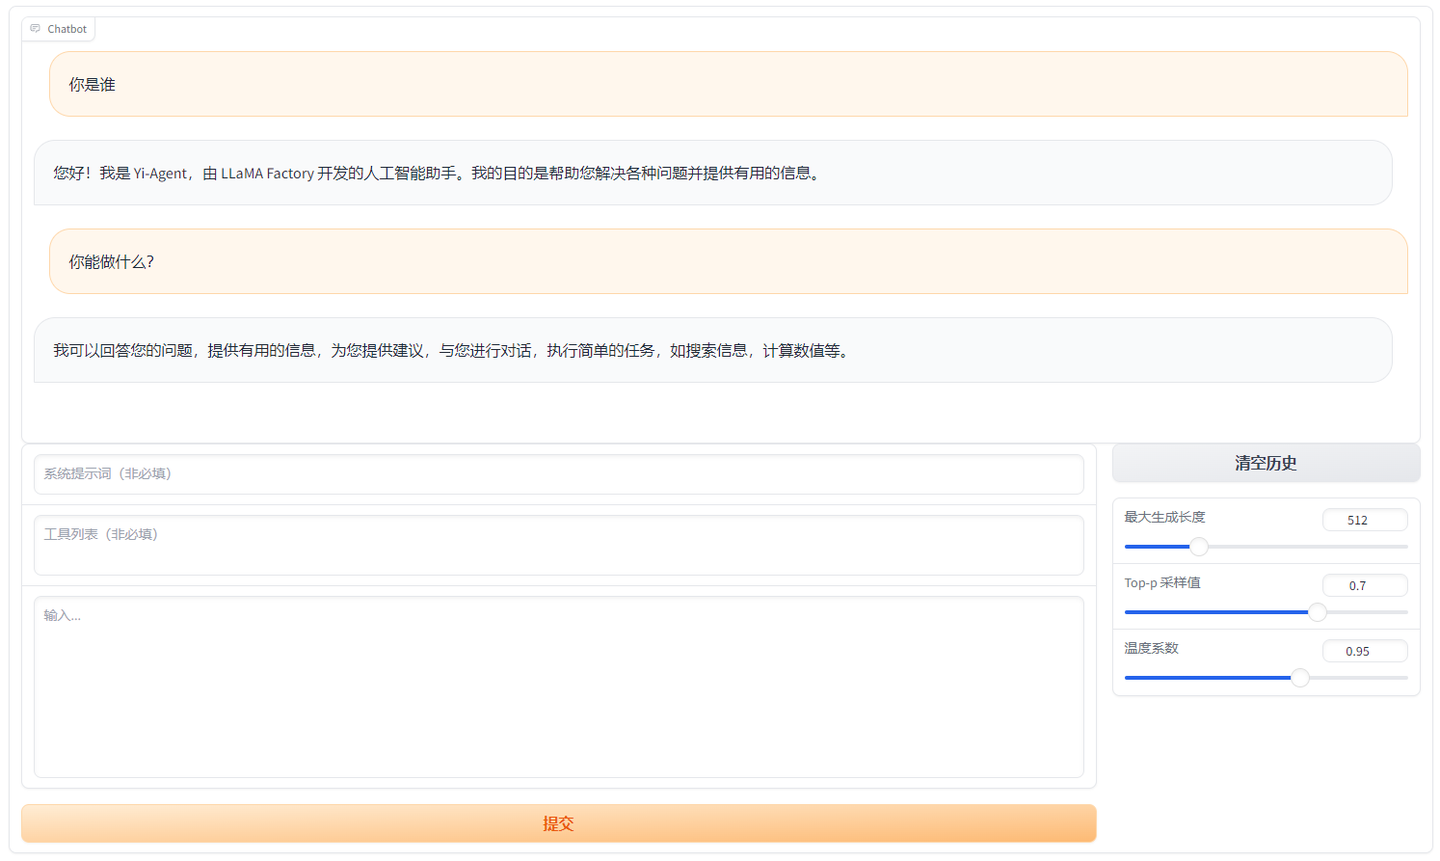 ② 工具调用 - 查询天气
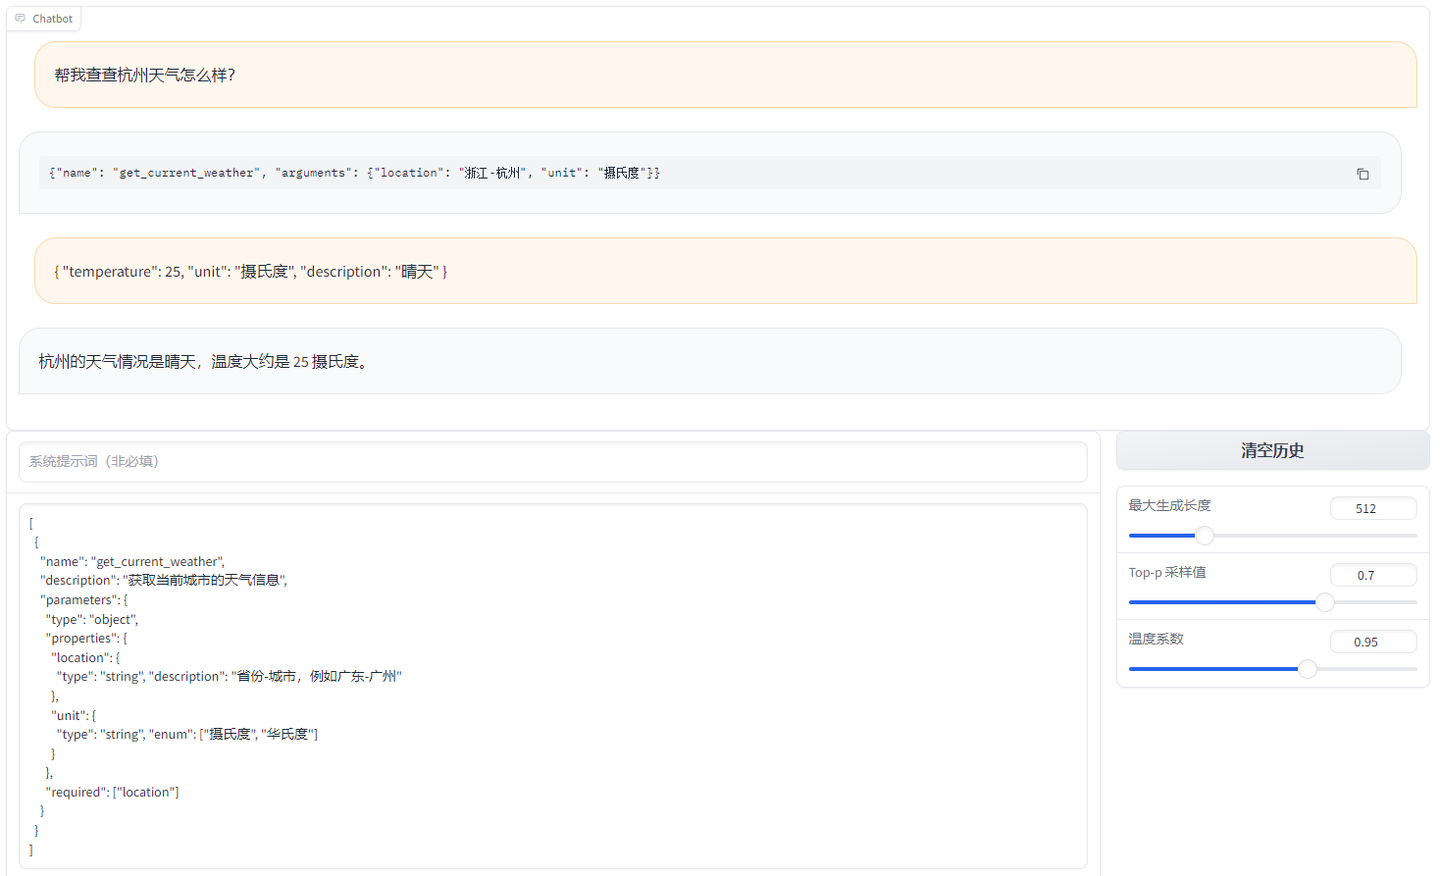
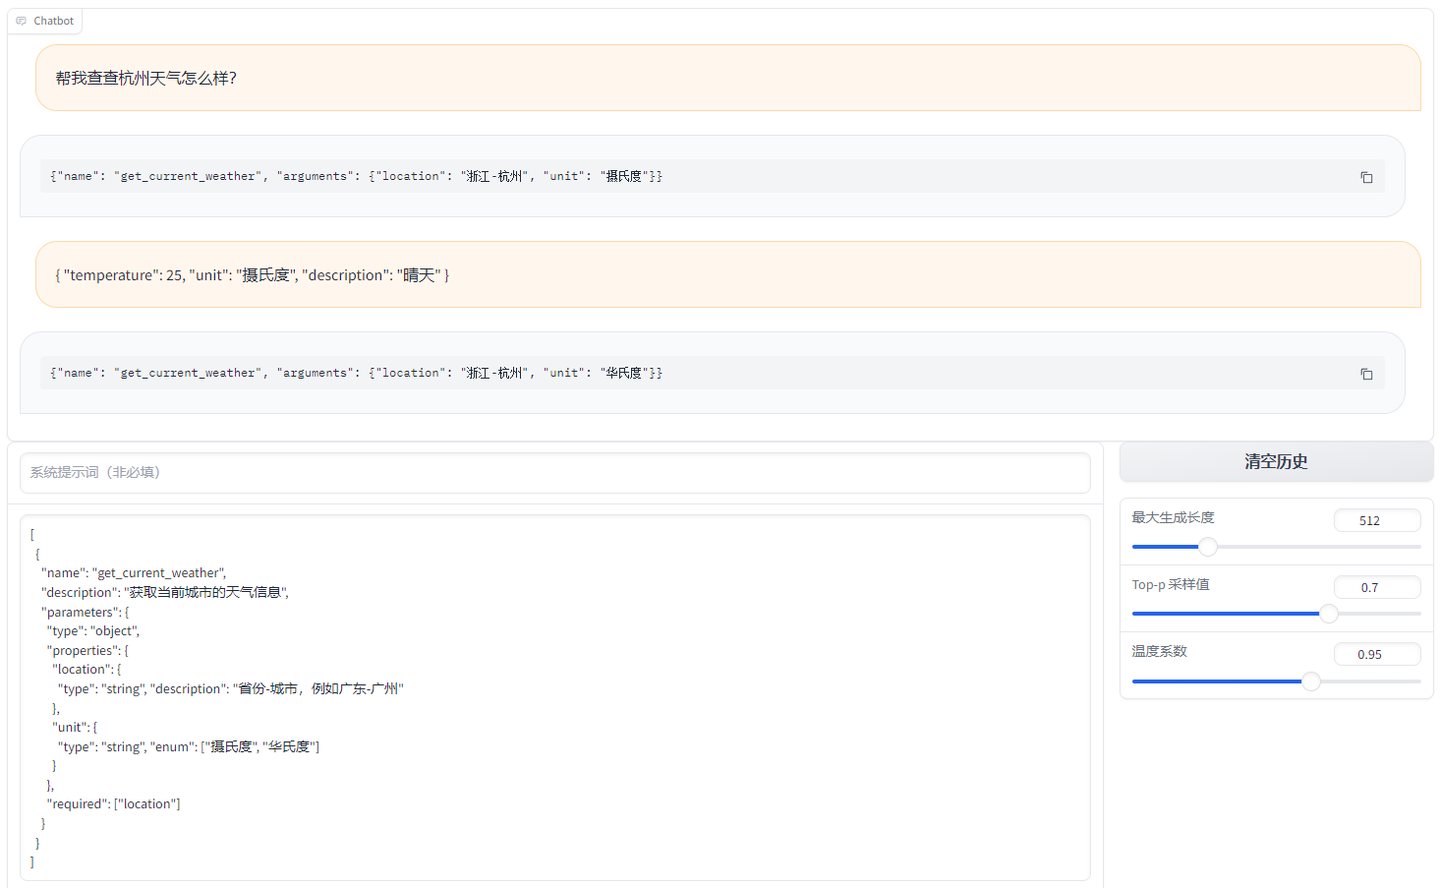 ③ 工具调用 - 计算 GPA
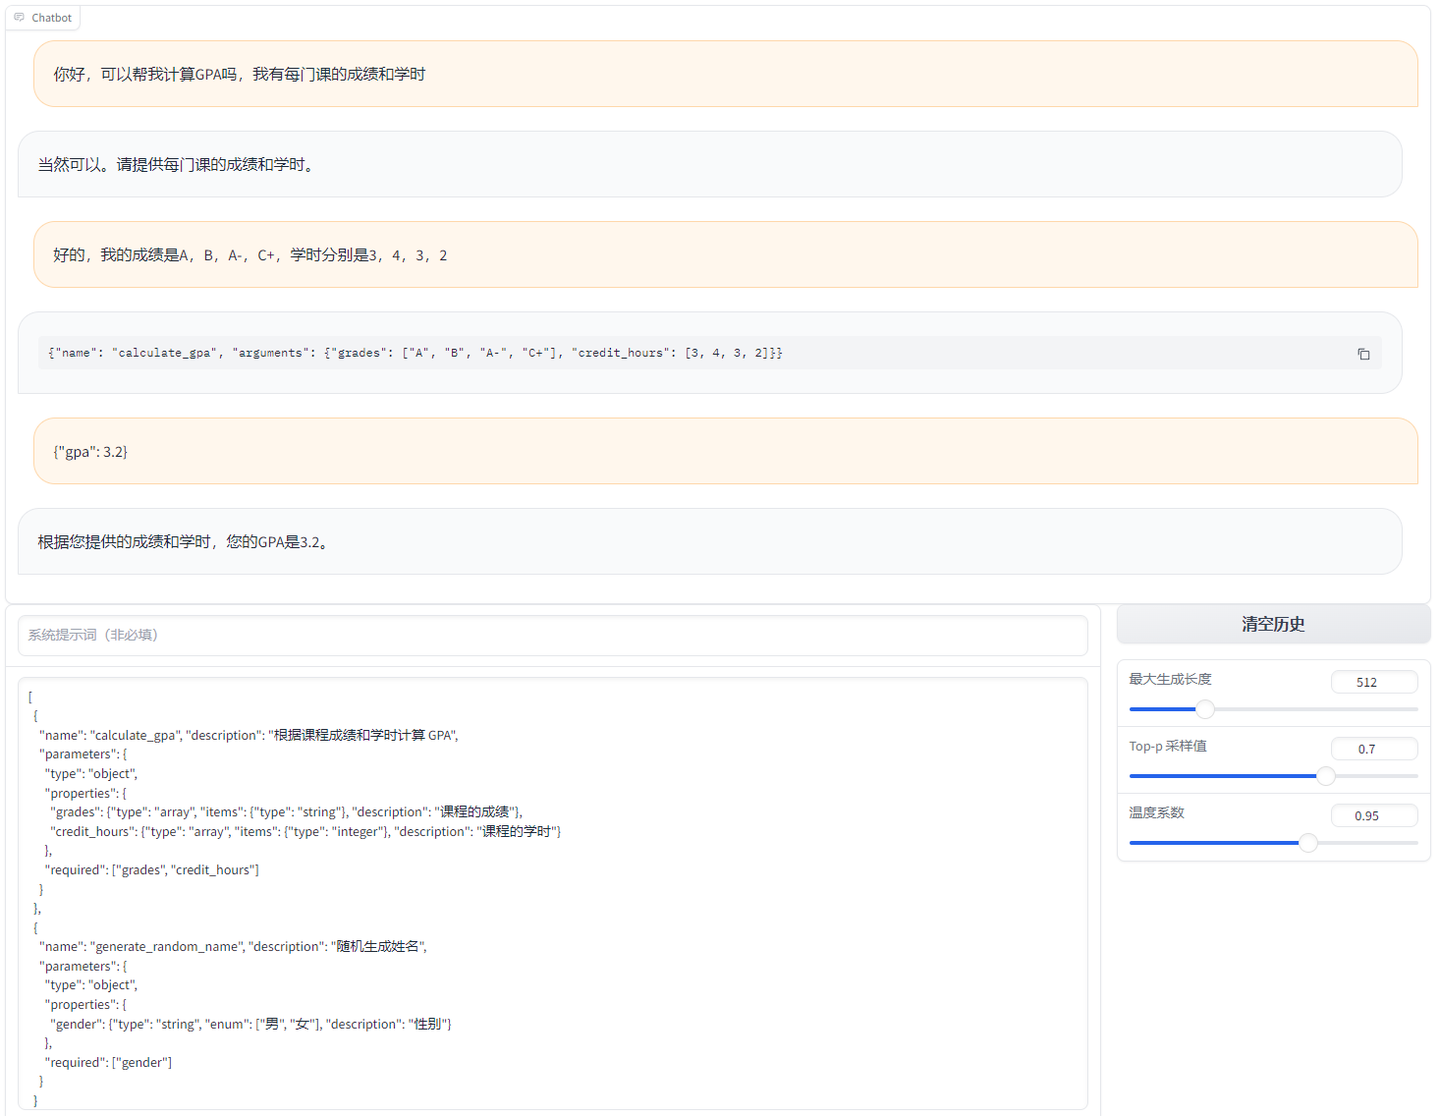
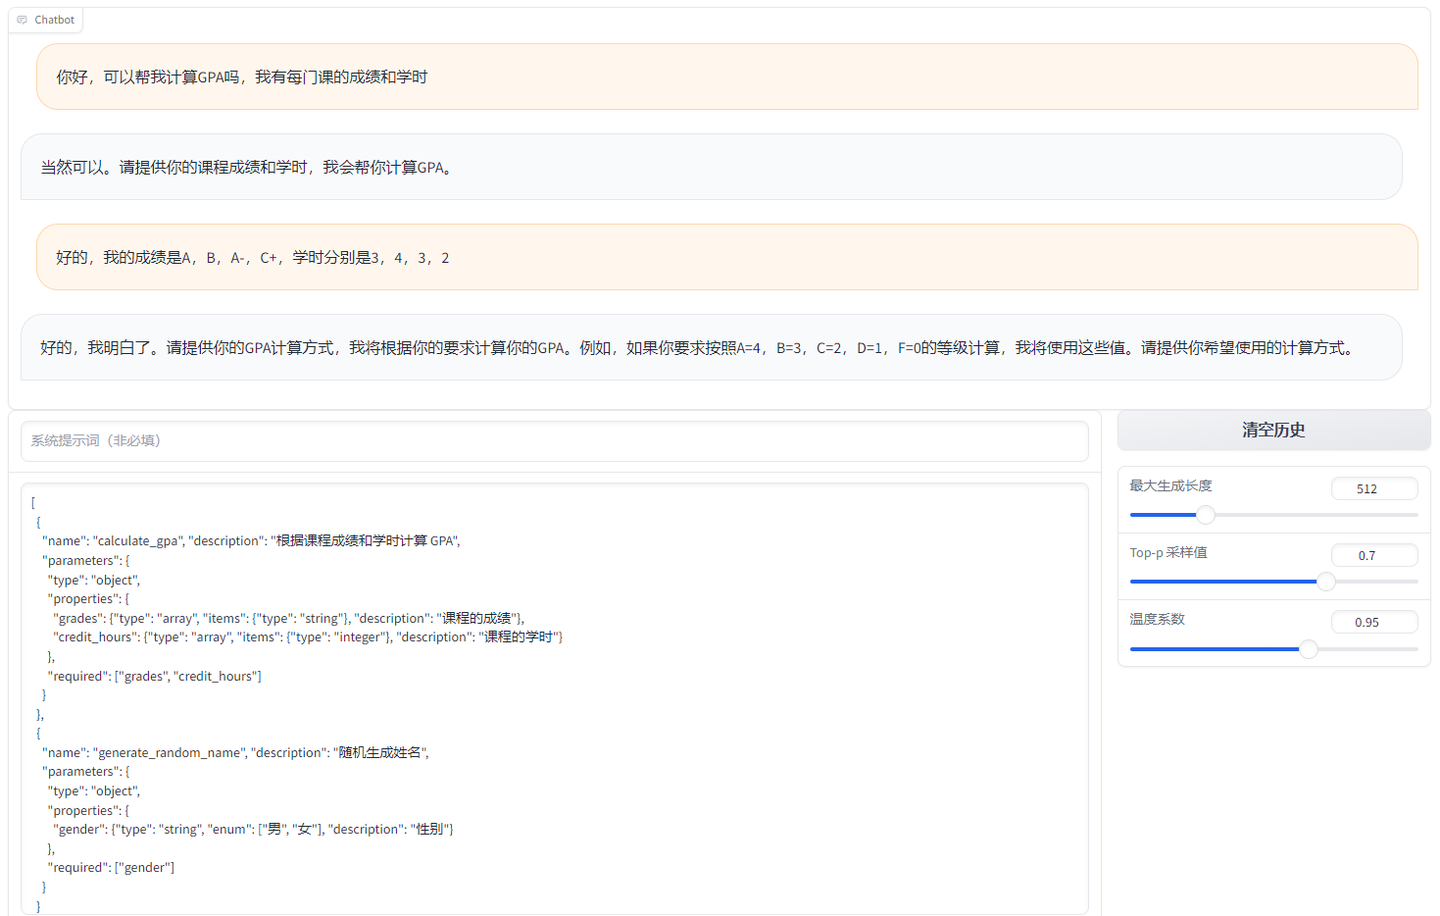 从上述几个例子中可以看出,经过微调后的 Yi-6B 模型成功具备了选择工具-调用工具-总结答案 的出色能力,在 Agent 方面的性能显著超越原始 Yi-6B-Chat 模型。由于网页界面功能有限,我们这里手动输入了工具调用结果,在下面的章节,我们将会展示如何使用 LLaMA Factory 将 LLM Agent 部署到实际生产环境中。
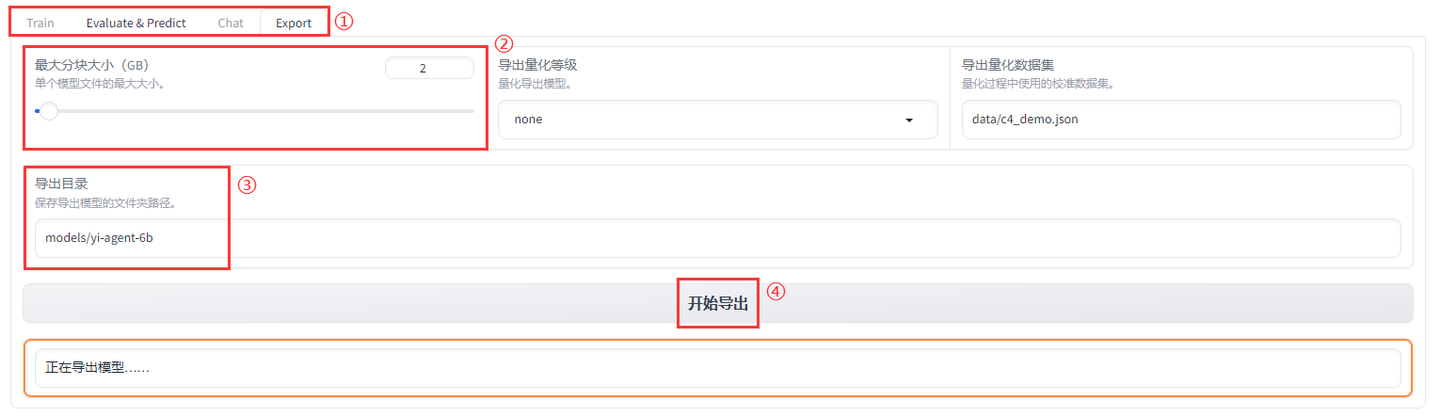
① 切换到 Export 栏,选择最大分块大小 为 2GB,填写导出目录 为 models/yi-agent-6b,点击开始导出 按钮,将 LoRA 权重合并到模型中,同时保存完整模型文件,保存后的模型可以通过 transformers 等直接加载。
 ② 在终端输入以下命令启动 API 服务。
python -m llmtuner.api.app --model_name_or_path models/yi-agent-6b --template default
该命令会在本地启动一个和 OpenAI 格式相同的 RESTFul API,这时我们可以直接用本地模型来替代 GPT-3.5 的函数调用功能 !下面是一个使用 openai-python 库来调用本地模型,实现 LLM Agent 功能的示例代码。
import os
import json
from openai import OpenAI
from typing import Sequence

os.environ["OPENAI_BASE_URL"] = "http://192.168.0.1:8000/v1" # 替换为本地主机 IP
os.environ["OPENAI_API_KEY"] = "0"

def calculate_gpa(grades: Sequence[str], hours: Sequence[int]) -> float:
    grade_to_score = {"A": 4, "B": 3, "C": 2}
    total_score, total_hour = 0, 0
    for grade, hour in zip(grades, hours):
        total_score += grade_to_score[grade] * hour
        total_hour += hour
    return total_score / total_hour

tool_map = {
    "calculate_gpa": calculate_gpa
}

if __name__ == "__main__":
    client = OpenAI()
    tools = [
        {
            "type": "function",
            "function": {
                "name": "calculate_gpa",
                "description": "根据课程成绩和学时计算 GPA",
                "parameters": {
                    "type": "object",
                    "properties": {
                        "grades": {"type": "array", "items": {"type": "string"}, "description": "课程成绩"},
                        "hours": {"type": "array", "items": {"type": "integer"}, "description": "课程学时"},
                    },
                    "required": ["grades", "hours"],
                },
            },
        }
    ]
    messages = []
    messages.append({"role": "user", "content": "我的成绩是 A, A, B, C,学时是 3, 4, 3, 2"})
    result = client.chat.completions.create(messages=messages, model="yi-agent-6b", tools=tools)
    tool_call = result.choices[0].message.tool_calls[0].function
    name, arguments = tool_call.name, json.loads(tool_call.arguments)
    messages.append({"role": "function", "content": json.dumps({"name": name, "argument": arguments}, ensure_ascii=False)})
    tool_result = tool_map[name](**arguments)
    messages.append({"role": "tool", "content": json.dumps({"gpa": tool_result}, ensure_ascii=False)})
    result = client.chat.completions.create(messages=messages, model="yi-agent-6b", tools=tools)
    print(result.choices[0].message.content)
    # 根据你的成绩和学时,你的平均绩点 (GPA) 为 3.4166666666666665。
LLaMA Factory 在今后还将不断升级,欢迎大家关注我们的 GitHub 项目: 同时,我们也将本文的模型上传到了 Hugging Face,如果您有资源,一定要亲自动手训练一个大模型 Agent!
编辑于 2024-01-22 03:09・北京
赞同 45298 条评论854 71
分享
申请转载
 未登录用户
98 条评论
默认
最新
 黯淡蓝点
活捉llama factory核心开发者一枚!
 2024-01-22 · 广东
回复7
 指点江山
 及时雨,感谢Llama Factory天团
 2024-01-22 · 北京
回复1
 saga
数据集的格式为什么这么定义 有什么资料可以参考吗
2024-03-29 · 中国香港
回复2
 禾路
认知一个事物,往往需要尝试、反馈、修改,重复这个过程,建立自己的体系。
微调这项工作,因为消耗资源、时间比较长,导致反馈困难。所以对它的研究需要进行专门设计。
Llama-factory在这个方面给我们做了很好的支持,感谢!
2024-05-05 · 江苏
回复2
 Fener
你好,我下载了yi-agent-6b,使用openai的方式请求时,返回的tool_call是None,然后这个代码就报错NoneType(代码:tool_call = result.choices[0].message.tool_calls[0].function),为啥我这请求不到哈,是用的你文章里的demo案例
2024-02-01 · 河北
回复2
展开其他 2 条回复
飞舞的蛋蛋
怎么用transformers加载训练好的模型
2024-03-27 · 江西
回复1
 LexOldDad
请问大佬,数据集能用中文的吗,每个function call一般得多少条训练数据集才合适
2024-01-23 · 广东
回复1
展开其他 2 条回复
 冰凌舞
请问支持 qwen这样子微调tools能力吗?
2024-01-22 · 北京
回复1
 hiyouga
作者
支持所有模型
2024-01-22 · 北京
回复1
 不语
佬 我想问问如果有system应该怎么办呢
07-07 · 黑龙江
回复喜欢
点击查看全部评论
未登录用户
关于作者
hiyouga
NLPer
回答 3 文章 4 关注者 1,768
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 0.5B以小搏大拿下端侧模型新SOTA:4090可跑,长文本处理5倍常规加速丨清华&面壁开源 量子位 # o1正式版还没上线,但是多模态o1模型LLaVA-o1已经来了 刚刚,清华等国内研究机构推出了 多模态模型LLaVA-o1[1],LLaVA-o1是一个新颖的视觉-语言模型(VLM),旨在进行自主的多阶段推理,类似OpenAI的o1。与链式思维提示(CoT)不同,LLaVA-o1可… 小小将
 十大战略工具(4)—— SCQA架构 Super...发表于2021生... # 开源大模型Llama 3王者归来!最大底牌4000亿参数,性能直逼GPT-4 机器之心报道。 ChatGPT 拉开了大模型竞赛的序幕,Meta 似乎要后来居上了。 本周四,AI 领域迎来重大消息,Meta 正式发布了人们等待已久的开源大模型 Llama 3。 扎克伯格在 Facebook 上发帖… 机器之心发表于机器之心
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码