 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
【VALSE 2023】走向计算机视觉的通用人工智能:GPT和大语言模型带来的启发
首发于CVer计算机视觉
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
【VALSE 2023】走向计算机视觉的通用人工智能:GPT和大语言模型带来的启发
首发于CVer计算机视觉
切换模式
 谢凌曦
 新知答主
编辑推荐
收录于 · 计算机视觉论文速递
638 人赞同了该文章
目录
距离上次的长篇大论,已经过去了半年有余。这段时间,对于AI业界甚至整个世界,都是惊心动魄的。在这段时间里,最令人印象深刻的大事莫过于ChatGPT和GPT-4的发布。毫无疑问,GPT-4是有史以来最为强大的AI程序。在随后发表的一篇论文[1]中,学者们将GPT-4称为通用人工智能(AGI)诞生的火花。诚然,每个人对于AGI的定义不尽相同,现阶段的GPT也尚未真正解决AI领域的所有难题;然而,基于大模型的技术,确实已经接近完成NLP领域的大一统,甚至让人隐约看到了AGI的曙光。或许,在3-5年内,我们就能够看到冯诺伊曼架构基础之上的AGI计算架构;倘若如此,大模型将在其中占据核心位置。
除了GPT系列外,计算机视觉领域也好不热闹,几个前沿方向都出现了令人惊叹的进展。对于公众来说,感受最深的莫过于AI绘画了。Stable Diffusion[2]和ControlNet[3]等技术的出现,大幅降低了训练和应用扩散模型的门槛。在Midjourney等社区中,AI绘画的发展速度可谓一日千里,许多技术困难(如AI不会画手、不会数数等)也得到了初步改善。如今,只要有一块入门级GPU或者交一点订阅费用,每个人都可以创作出自己的AI作品来。就连一段时间以来颇为平淡的视觉感知领域,也被一个叫做SAM[4]的方法搅动起来:虽然SAM还存在诸多缺陷(如语义识别能力有限),但它让人看到了视觉基础模型的更多可能性。根据Google scholar的统计,仅仅两个月的时间里,SAM就得到了超过200次引用,足见关注程度之高、研究之内卷。
面对如此冲击,包括我在内的许多研究者都会感到迷茫。很显然,在NLP的引领下,发展大一统的任务和体系,将成为未来3-5年整个CV领域的核心课题。然而,CV是否已经做好实现这个宏伟目标的准备?当前的视觉基础模型(包括最近的SAM)究竟做到了什么、没有做到什么?这篇断断续续写了两个月的文章,就是我对于这些问题的思考。
文章的部分内容,也被我整理成一篇微型survey,并与VALSE上报告的PPT一起,放在以下地址:
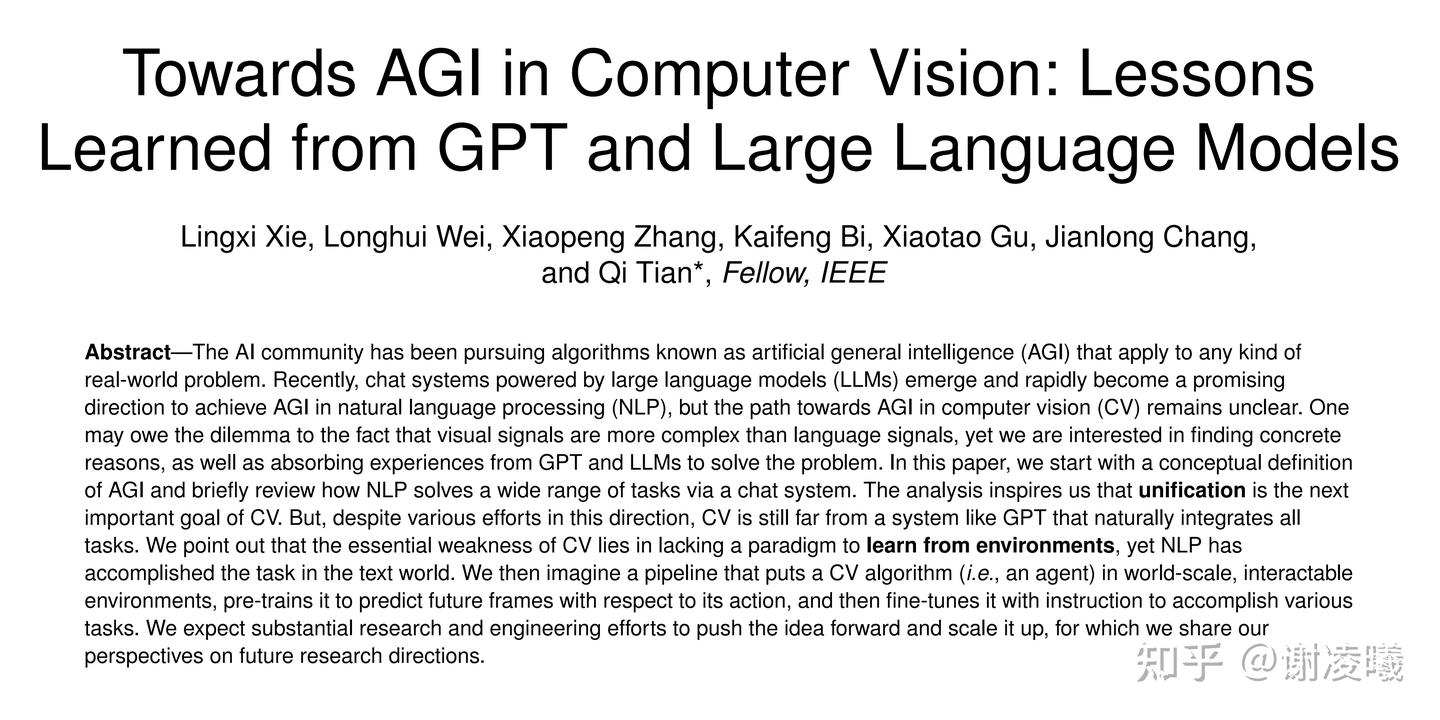 图1:调研报告首页截图。
arXiv链接如下:
在这篇文章中,我将从AGI的定义说起。随后,我将简要回顾NLP领域所经历的变革。基于大语言模型的GPT系列,为自然语言处理带来了划时代的改变,点燃了AGI的火花。接着,我将进入CV领域的讨论。作为AGI的下一个重要战场,CV领域正在走向大一统模型,但是面临的困难还很大。我将回顾现有工作,分析本质困难,并且在GPT的启发下提出一种新的研究范式。最后,我还将分享一些个人观点。
今天的人们,对于人工智能 (AI)一词并不陌生。现代意义上的AI诞生于1956年的达特茅斯会议,随后经历了几十年的发展,几经兴衰。AI的根本目标,在于使用数学方法复现人类智能。近年来,在深度学习的带动下,AI领域取得了长足进步,也深刻地改变了人们的生产生活方式。 通用人工智能 (AGI),是AI发展的最高目标。关于AGI的定义有很多,其中最通俗的一种,即AGI是能够具有任何人类和动物所具有能力的算法。从早期的图灵测试(早于达特茅斯会议)开始,关于AGI的追求和争论从未停止。深度学习的出现,大大加快了AGI的进程;而近期的GPT系列,则被学者们认为是点燃了AGI的火花[1]。深度学习本身提供了一种通用的方法论,使得人们可以在确定输入和输出形式的情况下,使用统计学习方法,构建神经网络(一种层次化的数学函数)来近似输入和输出之间的关系。只要有足够多的数据,深度学习就能够应用于CV、NLP、强化学习等诸多AI子领域。 关于AGI的形式化定义,则可以借鉴2007年出版的《通用人工智能》一书[5]的观点。将智能体放在一个环境 中,当它观察到一系列状态 \mathbb{S}=\{\mathbf{s}_1,\ldots,\mathbf{s}_T\} 时,可以从某个集合 \mathcal{A}=\{\mathbf{a}_1,\ldots,\mathbf{a}_M\} 里选择相应的行动,并且得到相应的奖励 r(\mathbf{s}_t,\mathbf{a}m) 。AGI的目标是学习一种映射 \pi:\mathbb{S}\mapsto\mathcal{A} ,使得其在环境中行动时,得到的累计奖励 R=\sum{t=1}^Tr(\mathbf{s}_t,\pi(\mathbf{s}_t)) 最大化。AGI的定义虽然很简单,但是实现起来却非常难,主要困难包括但不限于:实际数据具有很高的维度、人类智能具有复杂特性、神经和认知科学的理论缺失,等。
发布以来,GPT系列刷新了无数纪录,其中就包括2个月内达到1亿用户的神迹。这个纪录的重要性在于,它表明了AI算法已经具备面向普通用户(to consumers,即2C)的能力,这在历史上还是第一次。为了做到2C,AI算法必须具备极强的通用能力,能够满足用户的绝大部分要求。令人吃惊的是,GPT做到了这一点。GPT基本上解决了NLP领域的常见问题。在许多问题(如编写代码)上,GPT的能力甚至超越了专门设计的算法。也就是说,GPT实现了NLP领域的大一统:原先看似孤立的各个任务,都可以在多轮对话任务下统一起来。诚然,GPT还不完美,也会在许多问题上犯错或者胡言乱语,但是在可预见的范围内,NLP的研究范式不会再发生大的变革了。这场旷日持久(从达特茅斯会议算起,已有近70年)的NLP战争已经分出胜负,接下来就是些打扫战场的工作,比如解决垂直领域问题、逻辑推理、提高用户体验,等等。 关于GPT的能力展示,此处不再赘述,大家可以参考互联网上浩如烟海的资料,或者“AGI火花”一文里系统详尽的分析[1]。我只想引述GPT-4官方新闻的一句话:
As a result, our GPT-4 training run was (for us at least!) unprecedentedly stable, becoming our first large model whose training performance we were able to accurately predict ahead of time.
结果表明,GPT-4的训练过程(至少对我们来说)前所未有地稳定,它也成为我们训练过的第一个能够提前准确预测效果的大模型。 换句话说,GPT-4的本质是个神经网络,是个概率模型;但是它表现出来的行为(不论是训练还是测试),已经稳定得不像个概率模型了。这着实是一次了不起的技术突破! 关于GPT系列的实现原理,许多优秀的文章已经做过分析,此处我不再赘述。简单地说,GPT训练分为两个阶段。第一阶段被称为**生成式预训练** ,主要在无标注的通用语料库中进行。大规模语言模型通过预测下一单词,拟合通用文本的数据分布,并获得in-context learning能力,能够通过少量示例来适应新任务。第二阶段被称为指令微调 ,主要在有标注的对话数据库中进行。在此过程中,大规模语言模型将通用文本分布对齐到问答数据中,显著提升了针对性解决问题的能力。同时,模型还可以从人类用户的反馈中学习奖励函数,从而进一步增强其满足用户偏好的能力。如果对更具体的分析感兴趣,可以自行搜索ChatGPT的实现原理。
由于人类通过多种模态来理解世界,因此真正的AGI必须结合CV和NLP来实现。然而,在CV中实现AGI,比在NLP中实现AGI的难度大很多。根据前面的定义,真正的AGI应该具有即解决通用问题、与环境互动的能力,而不仅仅是完成万物识别和多模态对话等初级任务。然而如图2所示(示例图源:UberNet[6]),相比于利用统一对话系统来解决所有问题的GPT,当前CV的常用方法论还比较初步,大多局限于使用独立的模型甚至算法来解决不同的问题,包括图像分类、物体检测、实例分割、注意力检测、图像描述、以文生图等。
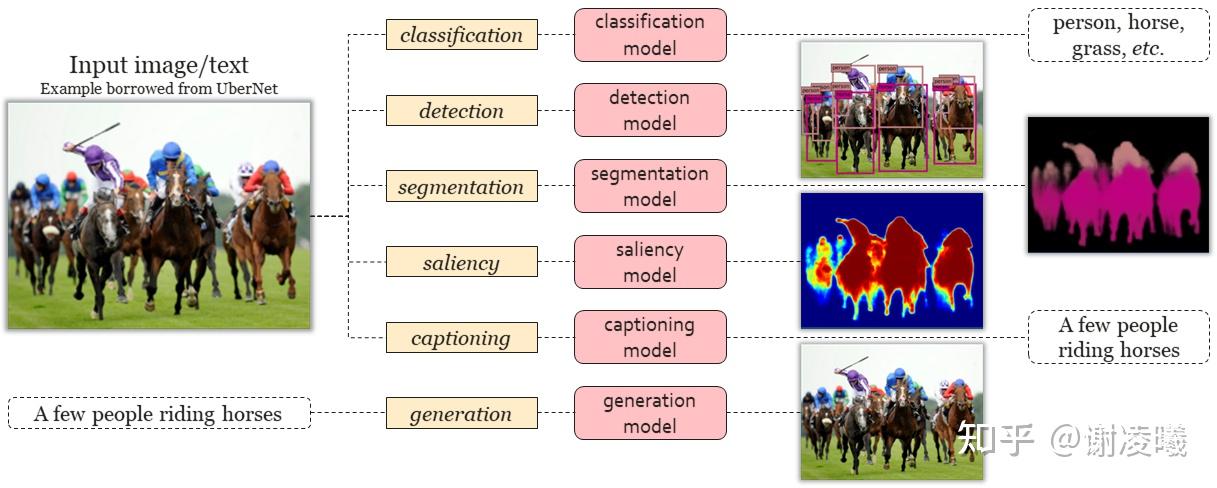 图2:当前CV主要使用独立的算法解决问题。
为了接近GPT的水平,CV必须走向大一统,也就是使用一套系统,解决各种视觉问题。近来,业界出现了不少此类尝试,我们将其分为五个主要方向。其中前三个方向主要解决任务形式的统一、第四个方向主要解决视觉任务逻辑的统一、最后一个方向主要解决视觉和语言交互的统一。以下我们简要综述每个方向的代表性工作,并且分析它们的优缺点。
以上几个方向的研究,将CV领域带到了新的高度。以当前进展看,CV算法能够在一定条件下完成视觉识别,也能够进行初步的多模态对话,但是距离大一统模型、距离通用的任务解决还有很远。而后者正是AGI所需要的能力。 于是我们不禁要问:为什么在CV中完成大一统如此困难? 这个问题的答案,还要从NLP中去找。
我们尝试从另一个视角来理解GPT所完成的事情。我们不妨想象自己像GPT一样,生活在一个纯文本的世界里。在这样的世界里,多轮对话任务是充分且必要的 :一方面,我们只能通过文字与其他智能体交流;另一方面,我们可以通过多轮对话去完成所有任务。也就是说,在NLP领域,学习环境是完备的:我们通过多轮对话来训练算法,而算法也只需要掌握多轮对话,就是一个能够完成所有任务的AGI。我将这个性质成为“所训即所需 ”——这个词是模仿“所见即所得”造出来的。 这样看来,GPT所定义的对话任务,比起GPT的实现方法更加重要! 这种定义使得AI算法能够通过与环境互动来学习,恰好符合AGI的定义:与环境互动,并且最大化奖励。相较而言,CV就没有形成清晰的路线:既没有环境用于预训练,各种算法也并不能在实际环境中解决问题。显然,这背离了CV和AGI的基本原则。事实上,早在1970年代,计算机视觉的先驱大卫·马尔就提出:视觉算法必须构建真实世界的模型,并且从交互中学习[17];随后也不乏其他学者指出交互的重要性。然而如今,大部分视觉算法并非研究如何与环境交互,而是研究如何在各种任务上提升精度。 这是为什么呢?当然是环境构建的难度太大!
要想构建场景用于CV任务,主要有两种方法:
除此之外,对环境中其他智能体行为的模拟也很重要,这决定了CV算法在真实应用场景中的适应能力。如果希望环境与智能体互动(例如在现实世界中放置一个真实的机器人),则收集数据的成本还会显著上升。另一方面,环境中的智能体的行动模式往往比较单一,难以模拟真实世界中丰富而开放(open-domain)的行为。
总的来说,目前所构建的场景,还不足以满足大规模训练CV算法的需要。在无法模拟环境情况下,人们只能退而求其次,不直接与环境互动,而从真实环境中采样 大量的数据,并且将与环境互动可能需要 的能力定义为一系列代理任务 (即通过完成任务,接近最终的目标),如物体识别、追踪等。人们假设,通过提升这些代理任务的精度,就能够让CV算法更接近AGI。
可问题是,这个假设对吗?
图3表达了我们的观点。在深度学习出现之前,CV的算法还比较弱,代理任务的精度也不高。当时,对于代理任务的追求,很大程度上推进了AGI的发展。然而过去十年,随着深度学习的发展,各项代理任务都已经高度饱和。在ImageNet-1K数据集上,top-1分类精度已经从前深度学习时代的50%以下提升到了90%以上。此时,继续提升代理任务的精度,有可能无法逼近AGI,甚至与之背道而驰。GPT的出现,进一步印证了这个观点:在接近AGI的模型出现后,原本孤立的NLP代理任务,如翻译和命名实体抽取,就变得不再重要了。
代理将死!
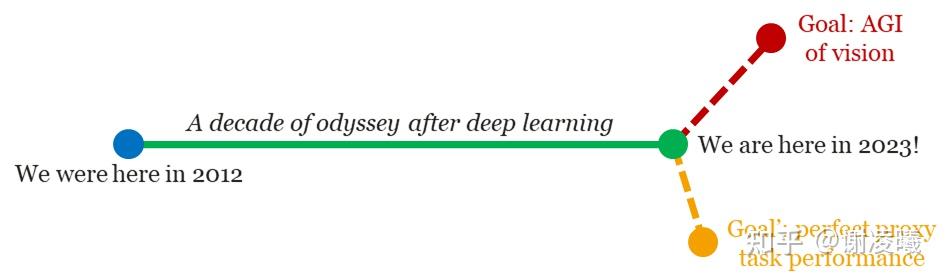 图3:CV的代理任务正在失去意义,甚至使我们远离AGI。
我们设想的学习流程如图4(图源:Habitat[18]和ProcTHOR[19])所示,分为如下阶段:
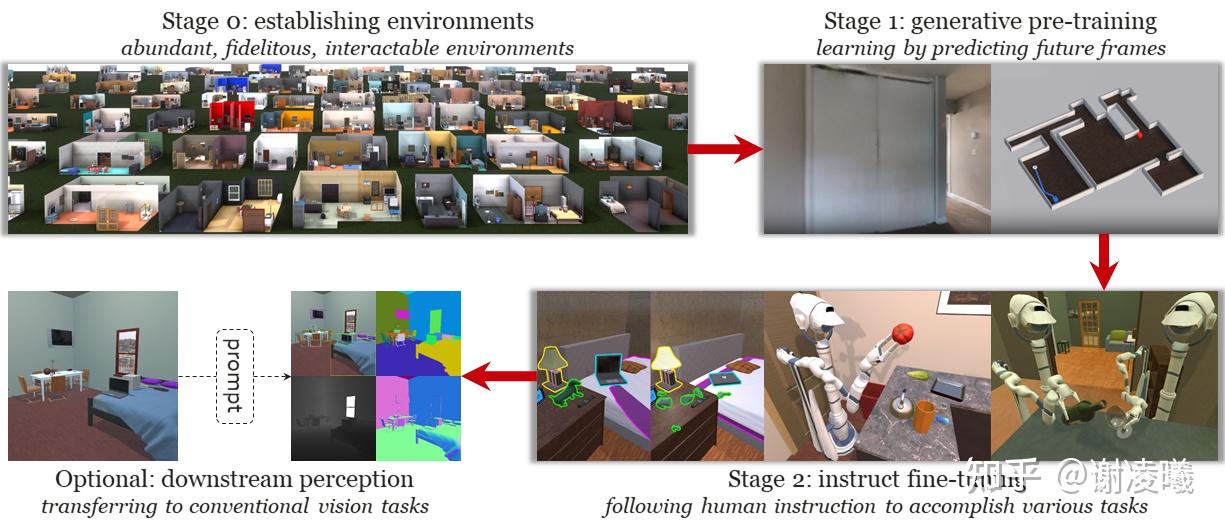 图4:设想中的未来CV训练流程,在环境探索、完成任务,并迁移到下游感知任务。
需要注意的是,在这样一个流程中,代理任务只是算法在通用任务上训练过后,“顺手”习得的能力。而现在的大部分CV研究,却将代理任务作为唯一的追求,属实是本末倒置了。
要想实现上述流程,面临的困难有很多。我们从三个阶段来分析。
最近,我们关注到一些令人欣喜的工作。其中一个工作是PaLM-E[21],它使用跨模态基础模型来指导具身视觉算法,增强其能力。另一个不如PaLM-E有名,但却更让人振奋的工作则是ENTL[22],它将环境建模和指令学习都建模为序列预测的形式,实现了上述框架的雏形。这些工作照亮了在环境中学习的道路;在此基础上,伴随着系统设计和工程优化,我们将会看到CV大一统的光明未来。
在达特茅斯会议的提议书中,AI的先驱者们写下了一个看似平凡,却无比困难的问题:如何让计算机学会使用人类语言?经过几十年的努力,研究者们终于在NLP领域看到了AGI的曙光,但是CV领域距离这个目标还有很远。造成CV当前困境的本质原因,在于CV领域没有构建起“从环境中学习”的范式,因而只能采样环境、设计代理任务,无法形成系统层面的闭环。未来,为了实现CV的大一统,我们必须抛弃现有框架,设计全新的具身范式,让CV算法在与环境的交互中增强能力,不断进化。
最近一段时间,我看到了许多稍显浮躁的论调。其中最为常见的,莫过于AI将要革新一切,甚至消灭大部分AI从业者,最终达到共同失业(划掉最后一句)。作为理智的从业人员,我知道CV算法的能力还比较有限,硬骨头还有很多。不过有一点是确定的:大规模语言模型(LLM)已经具备了强大的意图理解和初步的逻辑推理能力,因而达到了成为AI与人类沟通的“中枢系统”的条件。一旦如此,这条技术路线就会固化下来,在未来3-5年甚至更长的时间内,业界要做的事情只有两件:继续强化中枢系统(增强LLM或者构建其多模态的变种、以模块化的形式完善其各项能力),并且将这种范式复刻到CV领域里去。如今,再讨论大模型是否是未来已经没有意义,我们要做的,就是为CV真正用上大模型做好铺垫和准备。 目前看来,大模型很可能会成为与深度学习本身相媲美的革命性技术,我们很可能正在经历一场技术革命。在大模型定义的新时代里,我们每个人都是初学者。以代理任务为代表的旧时代遗存,将很快失去价值;而不能勇敢地拥抱新方法的人,也将随着代理任务一并消亡。
以下文字,是对上述观点的补充,也是一些暂时还没有形成体系的思考。
在去年的那篇文章里,我阐述了CV的三大根本困难,即信息稀疏性、域间差异性、无限粒度性,并且指出它们正是采样+代理任务 的范式所带来的副作用。文章链接如下: 其中的关键段落摘抄如下:
从根本上说,自然语言是人类创造出来,用于存储知识和交流信息的载体,所以必然具有高效和信息密度高的特性;而图像则是人类通过各种传感器捕捉的光学信号,它能够客观地反映真实情况,但相应地就不具有强语义,且信息密度可能很低。从另一个角度看,图像空间比文本空间要大得多,空间的结构也要复杂得多。这就意味着,如果希望在空间中采样大量样本,并且用这些数据来表征整个空间的分布,采样的图像数据就要比采样的文本数据大许多个数量级。顺带一提,这也是为什么自然语言预训练模型比视觉预训练模型用得更好的本质原因——我们在后面还会提到这一点。 根据上述分析,我们已经通过CV和NLP的差别,引出了CV的第一个基本困难,即语义稀疏性 。而另外两个困难,域间差异性和无限粒度性,也多少与上述本质差别相关。正是由于图像采样时没有考虑到语义,因而在采样不同域(即不同分布,如白天和黑夜、晴天和雨天等场景)时,采样结果(即图像像素)与域特性强相关,导致了域间差异性 。同时,由于图像的基本语义单元很难定义(而文本很容易定义),且图像所表达的信息丰富多样,使得人类能够从图像中获取近乎无限精细的语义信息,远远超出当前CV领域任何一种评价指标所定义的能力,这就是无限粒度性[23]。 进一步分析,我们就会得到一个有趣的结论:CV的本质困难在于人类对视觉信号的理解十分有限。人类从来就没有真正掌握视觉信号的结构,乃至为其定义某种专用语言,而只能通过自然语言来指代和表示视觉信号。许多明显的证据都能够表达这一点:大部分人在没有经过训练的情况下,很难画出具有真实感的图像(这表明人类没有掌握图像的数据分布);同时,大部分人很难通过语言交流,向另外一个人准确地表达图像上的意思——即使两人在语音通话,且看着电脑上的同一张图,要想通过纯语言交流指代图中的某些细节元素,也未必总是容易的。 如果重新审视CV的三大根本困难,就会发现它们可以统一起来,体现为视觉信号的表征粒度具有主观性和不确定性 ,或者追求客观的视觉信号与追求简洁的语义信号之间的矛盾 。当表征粒度较大(即追求语义信号的简洁性)时,人类可以用较为简洁的方式表达视觉信息,于是认为视觉信号具有语义稀疏性;当表征粒度较小(即追求视觉信号的客观性)时,人类又能够识别出图像中丰富的视觉信息,于是认为视觉信号具有无限粒度性;当表征粒度不确定时,人类很难将连续变化的视觉信号与离散的语义空间对应起来,于是在视觉信号改变而语义不变的范围内,就产生了域间差异性[24]。 此外需要特别指出的是,信息稀疏性和无限粒度性之间的矛盾,主要体现在传统的代理任务中。此时,如果追求表征的高效性(如使用信息压缩作为指标),就难以保证识别的细粒度和准确率。为了规避这样的矛盾,唯一的方案是构建真实的交互环境,允许智能体根据任务来调整视觉信号的粒度。 再次对比CV和NLP,就会发现,NLP很好地避免了粒度不确定的问题。由于NLP处理的文本信号是人为创造的,它的粒度就是文字本身的粒度。虽然这个粒度可变(例如用语言描述一个物体或者场景时,既可以描述得很精确,也可以描述得很粗略),但人类确定了这个粒度,并且保证它与实际需求相吻合。 既然NLP的粒度比较明确,是否可以帮助CV完成任务?我们发现,以往几乎所有CV方法,都使用NLP的方式来定义粒度。其中典型的例子有两个:基于分类的任务以及语言指代的任务。这两种方式各自存在的缺陷,我在之前的文章中也分析过,摘录如下。 基于分类的方法:这包括传统意义上的分类、检测、分割等方法,其基本特点是给图像中的每个基本语义单元(图像、box、mask、keypoint等)赋予一个类别标签。这种方法的致命缺陷在于,当识别的粒度增加时,识别的确定性必然下降,也就是说,粒度和确定性是冲突的。举例说,在ImageNet中,存在着“家具”和“电器”两个大类;显然“椅子”属于“家具”,而“电视机”属于“家电”,但是“按摩椅”属于“家具”还是“家电”,就很难判断——这就是语义粒度的增加引发的确定性的下降。如果照片里有一个分辨率很小的“人”,强行标注这个“人”的“头部”甚至“眼睛”,那么不同标注者的判断可能会不同;但是此时,即使是一两个像素的偏差,也会大大影响IoU等指标——这就是空间粒度的增加引发的确定性的下降。 语言驱动的方法:这包括CLIP带动的视觉prompt类方法,以及存在更长时间的visual grounding问题等,其基本特点是利用语言来指代图像中的语义信息并加以识别。语言的引入,确实增强了识别的灵活性,并带来了天然的开放域性质。然而语言本身的指代能力有限(想象一下,在一个具有上百人的场景中指代某个特定个体),无法满足无限细粒度视觉识别的需要。归根结底,在视觉识别领域,语言应当起到辅助视觉的作用,而已有的视觉prompt方法多少有些喧宾夺主的感觉。 说了这么多,还是回到开始的那个根本症结:视觉没有定义好自己的语言。当前可见的方法,都是用NLP的方式来定义CV。这些方法可以解决CV的初级问题,但要深入探索下去,就要碰得头破血流!
很显然,GPT范式在NLP领域的大获成功,让CV研究者有些心痒难耐。遵循NLP的发展路径看,NLP在GPT-1阶段构建了大模型,在GPT-3阶段观察到了能力涌现,进而在ChatGPT阶段采用了指令学习来解决具体任务。 于是一个很重要的问题是:当前的CV研究,到底发展到了什么阶段? 4月底,我参加了一次VALSE线上研讨会的panel环节,其中一个问题就是:SAM是否解决了计算机视觉问题,或者是否达到了GPT-3的水平(以致于可以在此基础上构建强大的CV算法)。我给出的结论很悲观:SAM没有达到GPT-3的水平,甚至离GPT-1还很远。其中最重要的原因,就是CV没有构建合适的学习环境。前面说到,NLP构建了对话环境,并且针对对话任务,设计了完形填空配合指令微调的学习范式。如果CV要仿照这套流程,就应当也构建交互任务,并且设计相应的预训练和微调任务。很显然,当前的CV学习范式并没有做到这一点,因此我们总感觉CV的上下游任务是脱节的:即使当前效果最好的MIM方法,似乎也和下游任务关系不大。要解决这个问题,很可能要从源头下手,构建起真正的学习环境来。 接着我们讨论能力涌现的问题。关于NLP的大模型为什么能够观察到能力涌现,业界似乎还存有疑问。我自己有一个大胆的假说:能力涌现的前提,是预训练数据已经覆盖了现实世界的一定比例。在这种情况下,预训练模型不必担心过拟合,因为它的任务就是记忆数据分布,某种意义上就是过拟合——这个假说也同时揭示了为什么NLP可以追求大模型:因为在不担心过拟合的情况下,大模型的拟合能力要更强。在这里,NLP的特征空间小、数据形态简单的优势就体现出来,而CV要想达到这样的状态,还需要更多的数据和更大的算力。 我有一个不严格的类比:NLP好比国际象棋,CV好比围棋。1996年,超级计算机深蓝通过启发式搜索的方式,在国际象棋中战胜了人类世界冠军,但是相似的方法无法在围棋中复现,因为围棋的状态空间要远远超过国际象棋。后来,在深度学习的帮助下,围棋的启发式函数得到了非平凡的改进,终于能够支撑起更复杂的状态空间的探索。如果没有深度学习,也许人类要再过几十年,才能够通过超大计算量的堆砌,达成同样的成就。深度学习的出现极大地加速了这个过程。 回到CV的发展上来。诚然,按照当前数据收集和计算量提升的速度,或许再过足够长的时间,CV也能够跌跌撞撞地达到当前NLP的水平。不过我相信,在此之前,一定会有某项技术突破,加速CV赶超NLP的过程。而我们CV研究者的使命,就是找到这项技术,或者至少找对正确的方向。
经过上面的讨论,未来CV的pipeline已经有了雏形:基于交互环境的生成式预训练和指令微调方法。这未必是唯一的路线 ,只是在NLP的启发下催生出来的最有可能的路线。实现它的困难有很多,但只要认准了方向,当前的困难恰恰对应于最有前景的研究方向。 退一步说,如果上述pipeline在短期内难以实现,那么CV就应当尽可能吸收NLP的能力,以期提升通用能力。很显然,纯粹基于图像信号的CV研究将越来越少,融合语言的跨模态研究将成为绝对主流:只要使用了CLIP或者类似的多模态基础模型用于特征抽取,就相当于接受了跨模态的思想。在这条路线上,最重要的研究方向可以概括为“找到图像与自然语言的交互方式”,或者更进一步地说,“找到图像本身的语言”:这一点对于交互类任务也是至关重要的。 一些重要的研究方向包括:
编辑于 2023-06-16 01:54・广东
计算机视觉
人工智能
赞同 63839 条评论593 105
分享
申请转载
 未登录用户
39 条评论
默认
最新
 Keyu Tian
深表同感
 个人再提供一个另外的视角:环境模拟在RL和robotics里面可以说是长久以来未被解决的硬骨头,vision要从这件事情做到“智能涌现”可能还是太理想而太困难了;个人感觉目前比较可行的,是video数据,因为video在时间维上构成了高级认知语义,涉及逻辑和推理,而非单图内部的低级感知语义,因此autoregressive这种生成训练很有希望挖掘出“智能”,且数据规模(论bits计算)应该不比NLP corpus少
2023-06-16 · 北京
回复13
 谢凌曦
作者
 视频虽然提供了更高维的信号,但还是比不上真正能够交互的环境,当然我理解模拟的困难。我之前甚至想过,模拟环境甚至等价于AGI本身,只不过是另一种呈现形式罢了。
2023-06-18 · 北京
回复7
展开其他 1 条回复
 MasterBin
感谢笔者高屋建瓴的分享,深受启发!关于“CV大统一之路”中“通用视觉编码”部分想做一点补充:CVPR2023的工作UNINEXT将10项主流的实例级别感知任务(检测、分割、跟踪、视觉&语言)统一成了一种“提示词引导的物体发现与检索范式”,用一套统一的参数在20个具有挑战性的数据集上取得了优异的性能。论文:https://arxiv.org/abs/2303.06674
2023-06-16 · 瑞士
回复11
谢凌曦
作者
感谢分享,我会在下一个版本的survey里加上。
2023-06-18 · 北京
回复1
 吨吨
 CV很难构建合适的学习环境。前面说到,NLP构建了对话环境,并且针对对话任务,设计了完形填空配合指令微调的学习范式。lm这一训练模式的构建和人类做阅读理解,写作业评分的成长(训练)过程很类似。cv如何模拟人对现实视觉世界的理解?我的理解是得和lm结合起来。人本质是在学习概念,lm也是哈(斯坦福有篇文章在简化为马尔科夫模型后证明过),我觉得不应该孤立地做cv,应该是cv拥抱lm,在训练中理解概念。大概如此。这么说吧,现在lm就是盲人从小学习理解世界,尤其是文字世界。现在cv的大模型训练就是普通人如何使用脑子、文字去生成对视觉环境的概念并优化。
2023-06-15 · 云南
回复4
 谢凌曦
作者
这些说法稍微有些抽象,我并没有完全理解。不过有一点是确定的:CV一定不能依靠单独的图像信号,需要和语言等其他模态结合起来。
2023-06-18 · 北京
回复2
展开其他 4 条回复
 王云峰
 写得太好了,颠覆了对cv任务的视角
2023-06-15 · 浙江
回复1
 不抽烟老大哥
VALSE现场听了报告,很受震撼
 2023-06-16 · 安徽
回复2
 越丰
AGI定义那段 累计误差 笔误了吧 累计奖励
2023-06-15 · 浙江
回复2
 谢凌曦
作者
谢谢!
2023-06-15 · 广东
回复2
 长空雁
CV虚拟环境是否可以先用游戏环境尝试,目前很多3D游戏的逼真度,场景丰富度已经非常高了,游戏空间里的操作指令集也相对固定,如果能训练出纯基于视觉的游戏ai,完成下一时间场景画面预测,很好完成游戏任务目标,就能证明这条路是正确的
2023-06-17 · 广东
回复1
谢凌曦
作者
部分同意,这很可能是下一步研究方向。不过,真实度不仅体现在静态观感上,还有其他智能体的行为模式,这一点目前还跟实际环境差别很大。
2023-06-18 · 北京
回复2
展开其他 3 条回复
 小鱼在刷牙
以prompt形式统一各种类型的视觉任务,使得同一套计算模型能够适应尽可能多的任务。请问这是类似于SEEM这种类型的工作吗
2023-12-27 · 北京
回复喜欢
 书理书外
很好的文章,难得有人将CV的研究讲得如此明白,感谢分享
 2023-09-06 · 北京
回复喜欢
 启茗芯
关于更复杂的数据结构我有些疑惑,人通过人眼做2维感知,通过人脑做3维认知。如果是实现类人AI的话,也应该是类似的,那么现在的CMOS做视觉感知,是不是就已经是人类水平了?还是在眼球感知的光学数据和CMOS感知的光学数据目前还没有对齐?如果已经对齐,那么通过相机采集到的丰富的数据,是不是就能够向下构建类似人的认知层,也许还需要触觉这样的监督信息?我的观念其实是“什么样的传感决定什么样的智能”,即便是简单的数据结构也是可行的
2023-07-28 · 陕西
回复喜欢
点击查看全部评论
未登录用户
关于作者
谢凌曦
探索未知,传承已知
清华大学 工学博士
回答 113 文章 18 关注者 43,963
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 如果我们有了人工通用智能(AGI),还有什么东西值得学? Jarre...发表于助记媒介 ...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码