 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
“别挡我,我要C位出道!”谈谈深度学习目标检测中的遮挡问题
首发于Winsty的技术碎碎念
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
“别挡我,我要C位出道!”谈谈深度学习目标检测中的遮挡问题
首发于Winsty的技术碎碎念
切换模式
 Naiyan Wang
 机器学习等 3 个话题下的优秀答主
收录于 · Winsty的技术碎碎念
594 人赞同了该文章
今天给大家介绍的两篇工作的目的都是试图解决目标检测中最为棘手的遮挡问题。两篇文章的作者分别从loss设计和two stage detector中最关键的操作ROI Pooling/Align出发来针对遮挡问题进行针对性设计,从而减轻遮挡问题对于检测结果的影响。
在开始介绍这两篇文章具体的工作之前,我先来和大家回顾一下为什么遮挡会对检测结果造成很大影响。其实遮挡本身也可以分为两种类型,一种是由于非目标造成的遮挡,一种是由于也是需要检测的目标造成的遮挡。这两种遮挡在[1]中分别被叫做occlusion和crowded。对于前一种类型遮挡,很难有针对性的办法去解决,最好的办法也就是使用更多的数据和更强的feature。但是对于后一种类型的遮挡,现在的pipeline其实并没有很好充分利用信息,例如下面示意的这个情况,两个黑色的框代表的是两个Ground Truth,红色和绿色分别是被assign到1号的GT上的anchor或者proposal。
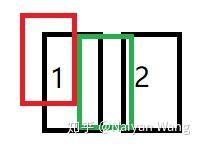 虽然这两个proposal和左面GT的IoU一样,但是显然绿色的更容易受到2号GT的影响,从而远离它真实的目标,这也是为什么crowded的情况中,误检经常出现在两个真正GT中间的原因。但是我们为了抑制这样的误检,又不能一味提升NMS的阈值,否则会对于真正靠近的情况错误抑制。
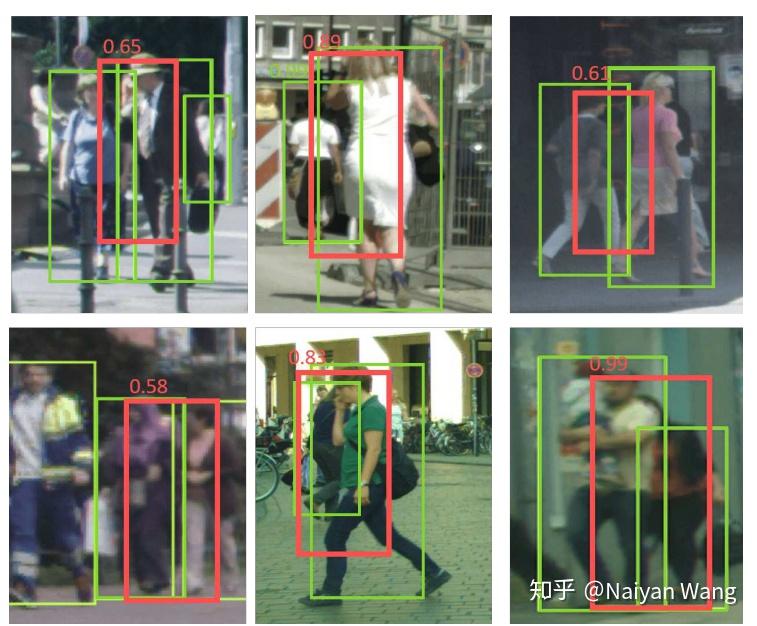
下图是在真实数据中的一些误检情况:
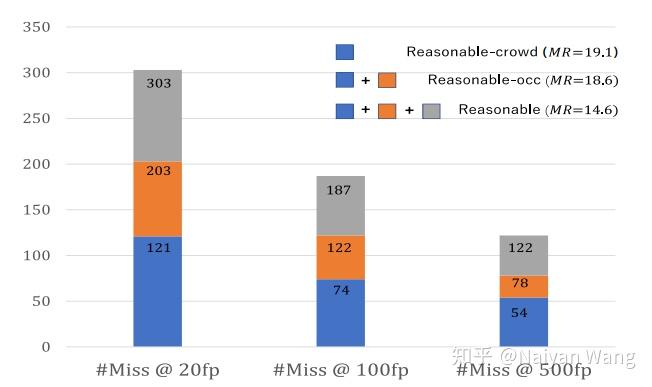 在[1]中,作者还在CityPersons数据集上分别做了定量统计,可以看到在不同的误检率下,有这两种遮挡导致的漏检基本都占到了2/3之多。所以很有必要针对这两个问题进行一些针对性设计。
 在[1]中,作者提出了两个针对这个问题的loss,除了常用的smooth L1使回归目标与GT接近之外,这两个loss一个的目标是使proposal和要尽量远离和它overlap的第二大的GT,另一个目标是要上被assign到不同GT的proposal之间尽量远离。通过这两个loss,不仅仅使得proposal可以向正确的目标靠近,也可以使其远离错误的目标,从而减少NMS时候的误检。在具体实现方面,作者大量使用了之前的IoU loss[3]的工作,可以直接对IoU进行优化。两者的loss function分别如下所示,具体严谨的符号定义可参见原文[1]:
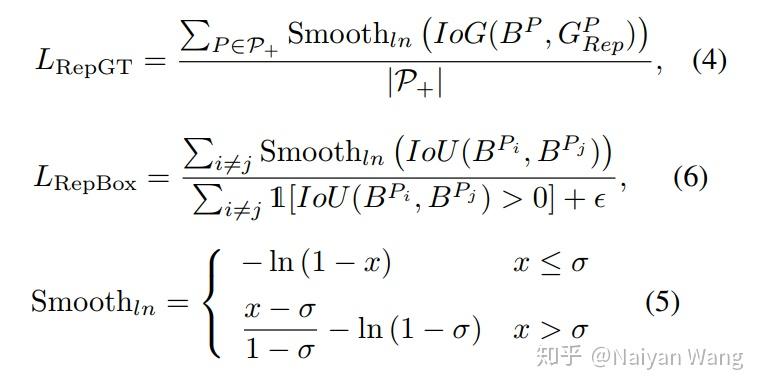 注意,第一个loss中作者使用了Intersection over GT而不是传统的IoU,原因在于GT无法改变,如果使用IoU则网络可以通过放大proposal的方式来降低loss,这并不是我们所期望的。如果直接使用IoG,分母是GT的面积无法改变,从而规避了这样的问题。
其中这个Smooth_ln是针对0到1的输入变量设计的一个robust function,具体形状如下所示:
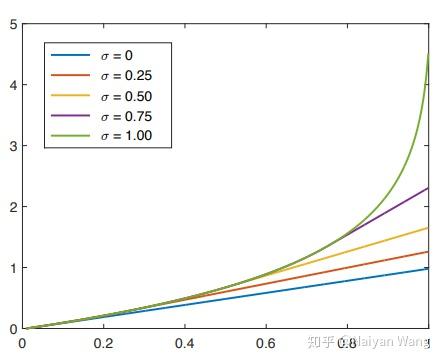 可以看到,正如Smooth_l1不会对特别大的偏差给予过大的penalty,Smooth_ln对于很小接近于1的输入也不会像原始的ln函数一样给予负无穷那么大的loss,从而可以稳定训练过程,而且对抗一些outlier。
在[2]中,作者分别从loss和two stage detector中核心的ROI Pooling操作出发改善遮挡物体的检测问题。在loss方面,想法与[1]类似,但是采用了一个更简单更容易实现的形式,即被assign到同一个GT的proposal要接近于这些proposal本身的均值。由于优化目标只是接近,而不需要远离,所以可以不需要[1]中的IoU和Smooth_ln从而简化了实现。
除此之外,作者还对行人这个特殊的物体进行了针对性的设计:作者将行人分为5个独立的区域,分别对这5个区域加上整个的ROI进行ROI Pooling/Align,除此之外,还对这5个局部分别预测了一个0到1之间的遮挡score,代表这5个局部区域是不是被遮挡。这部分可以认为是一个简略版的mask。而后使用这5个visibility score分别和对应区域的feature相乘后相加,得到最终的ROI feature。
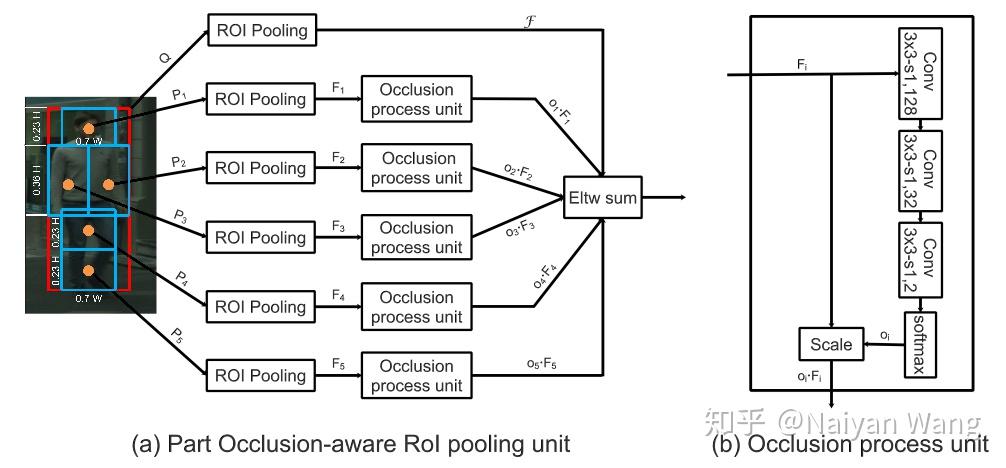 这里不太明确的是将不同part的feature和全局feature直接相加得到的表示究竟是什么,直接相加看上去多少有点不太合理。另外就是这个设计是专门针对行人的,对于其他任务而言,并不通用。
在实验中,两篇文章都在大规模的行人数据集上进行了测试,两者性能接近,都可以达到目前的最好的行人检测结果。两者分别在Caltech-USA Reasonable set上取得了4.0和4.1的MR-2。在其他数据集上的趋势也是类似,具体有兴趣的读者可以查阅原文。
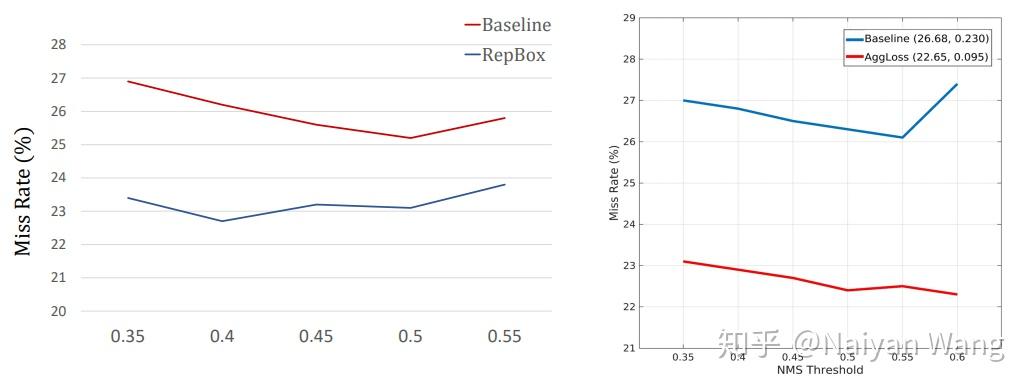
除此之外,两篇文章中都做了一个很有意思的ablation analysis,分别变化了NMS时候的threshold来看对于最终结果的影响。可以看到一个有意思的趋势是原始的baseline,NMS threshold从0.35增长到0.5的过程中结果会一直改进,但是超过0.5后结果会急剧上升。这符合我们文中最前分析的结果。分别使用了[1][2]提出的方法后,各个threshold下结果都有提升,尤其是[2],threshold超过0.5后继续提升也不会对结果产生反作用,一方面证明了对这样一个超参数的稳定性,也是从一个侧面印证了所提出的方法确实可以提升定位框的准确性。
 总结以上,虽然基于deep learning的top-down detection这座大厦基本已经建成,但是针对一些特定问题的设计仍然大有可为,例如遮挡,例如小物体。这些问题都需要大量的实践经验,分析提炼和思考,虽然技术实现上可能很简单,但是背后都蕴含着对问题的理解。
[1] Wang, X., Xiao, T., Jiang, Y., Shao, S., Sun, J., & Shen, C. (2017). Repulsion Loss: Detecting Pedestrians in a Crowd. arXivpreprint arXiv:1711.07752.
[2] Zhang, S., Wen, L., Bian, X., Lei, Z., & Li, S. Z. (2018). Occlusion-aware R-CNN: Detecting Pedestrians in a Crowd. arXiv preprint arXiv:1807.08407.
[3] Yu, J., Jiang, Y., Wang, Z., Cao, Z., & Huang, T. (2016, October). Unitbox: An advanced object detection network. In Proceedings of the 2016ACM on Multimedia Conference (pp. 516-520). ACM.
发布于 2018-09-03 12:07
机器学习
计算机视觉
深度学习(Deep Learning)
赞同 59422 条评论1006 11
分享
申请转载
 未登录用户
22 条评论
默认
最新
 a刘灏
从实际上来说,框总是落到两个gt中间最主要是因为anchor不够密吧,yolov2一直出这种智障框,但是v3就基本没有了。anchor够密,中间候选框的分数很少超过两边框的。
2018-09-04
回复喜欢
 Naiyan Wang
作者
不尽然,可以动手试试就知道了哈
2018-09-04
回复喜欢
 光子重构
请问,“又不能一味提升NMS的阈值,否则会对于真正靠近的情况错误抑制”这一句不太理解,觉得应该是降低?
2018-09-03
回复5
 Naiyan Wang
作者
嗯。。是的,多谢!
2018-09-03
回复喜欢
 尼箍纳斯凯奇
shifeng的作品都蛮不错的(^∇^)
2018-09-03
回复3
 知乎用户n4lWfz
膜拜一下
2018-09-03
回复2
 正文小z
挺好的,就是不知道为什么图不清啊???
2019-05-20
回复1
 压缩即智能
 repulsion loss文章的fig 8,在fppi 10^-2~10^-3附近及更低的地方,miss rate比baseline低了非常非常多,只有fppi比较大的时候才比baseline好一点点(纵轴貌似是对数坐标)。感觉不太实用?
2019-02-16
回复喜欢
展开其他 2 条回复
 赵明明
eltw sum是不是可以这样理解? Eltw Product其实就是矩阵的点积,还有sum的形式就是求和。这里就是eltwsum(F,alpha1F,alpha2F),具体点积的维度应该是最后1维,因为要保证结果跟F的shape一样
2018-09-07
回复喜欢
Naiyan Wang
作者
不太可以吧,不同区域的feature为什么可以加?加出来这个意义不明啊
2018-09-07
回复1
展开其他 3 条回复
 Kevin
请问两篇文章的题目分别是什么呀?
2018-09-05
回复喜欢
Naiyan Wang
作者
看最后reference
2018-09-05
回复喜欢
展开其他 1 条回复
 Penguin Whisper
”如果使用IoU则网络可以通过放大proposal的方式来降低loss“ 这个意思是说proposal增大了有助于降低loss, 但是这个proposal放大了但是还是在两个gtboxes中间,而我们的初衷是要让proposal尽量远离和它overlap的第二大的GT,所以使用IOU“不是我们想要的”。 ------------这样理解对么?
2018-09-03
回复喜欢
Naiyan Wang
作者
嗯,是的
2018-09-03
回复喜欢
 过去的是现在
eltw sum应该是从dssd上挪用过来的吧
2018-09-03
回复喜欢
展开其他 1 条回复
未登录用户
关于作者
Naiyan Wang
CS PhD, 机器学习与计算机视觉
机器学习、人工智能、深度学习(Deep Learning) 话题的优秀答主
回答 130 文章 46 关注者 82,159
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 完整学习目标检测中的 Recalls, Precisions, AP, mAP 算法 Part2 史蒂芬方 # 详细解析目标检测中的TP、FP、FN、TN、AP与mAP,逐步计算,不可能看不懂的。 1基础概念1.1目标检测任务输入图像,输出图像中目标的类别Classification并进行定位Localisation确定目标的边界框bounding box。 所以实际上包含 两个子任务,一个预测目标边界框,一个是预… 柏拉图爱唠叨
 目标检测中的非极大值抑制(NMS)算法 一天到晚潜...发表于深度学习与...
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码