保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[ ](javascript:void(0))
 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
数据为王:大模型预训练中的数据处理及思考—The RefinedWeb Dataset for Falcon LLM论文解读
首发于算法联盟
切换模式
数据为王:大模型预训练中的数据处理及思考—The RefinedWeb Dataset for Falcon LLM论文解读
 赵亮
NLPer
收录于 · 算法联盟
355 人赞同了该文章
带着问题读论文,阅读本文你将了解以下内容:
- 大模型预训练数据从哪里获取?主要都是什么?
- 只用网上爬取的数据是否可以训练一个足够好的大模型?
- 大模型预训练中数据重要吗?是怎么影响模型性能的?
- 数据如何清洗过滤?数据清洗是如何影响模型效果的?
- 训练大模型时,数据是训练一个epoch好,还是多训练几个epoch好?
- 大模型训练 数据的天花板在哪?又决定了模型的天花板在哪?
- 为什么模型会有Scaling law?是否和训练数据有关?
- 如何突破模型训练的Scaling law?
前言
大模型预训练需要从海量的文本数据中学习到充分的知识存储在其模型参数中。预训练所用的数据可以分为两类。一类是网页数据(web data),这类数据的获取最为方便,各个数据相关的公司比如百度、谷歌等每天都会爬取大量的网页存储起来。其特点是量级非常大,比如非盈利性机构构建的CommonCrawl数据集是一个海量的、非结构化的、多语言的网页数据集。它包含了超过 8 年的网络爬虫数据集,包含原始网页数据(WARC)、元数据(WAT)和文本提取(WET),包含数百亿网页,数据量级在PB级规模,可从 Amazon S3 上免费获取。第二类称之为专有数据(curated high-quality corpora),为某一个领域、语言、行业的特有数据。比如对话、书籍、代码、技术报告、论文考试等数据。
在OpenAI的GPT3,4模型以及谷歌的PaLM系列模型训练中,大量用到了专有数据,如2TB的高质量书籍数据(Books – 2TB)和社交媒体对话数据(Social media conversations)等。这些专业数据是不对公众开放的,就拿高质量的book书籍数据来说,在网上能直接获取到数据来自The pile中的Book3,量级也才85GB左右,和这些巨头所用数据量级相差数十倍。因此现在有一种普遍观点认为“GPT、PaLM等模型的成功很大程度源自于其他模型难以企及的大量的、高质量的专有数据”。比如LLaMA论文中就提到,自己所用的高质量数据只有177GB所以在MMLU等知识性推理任务上和PaLM相差了十几个点(:如果能给LLaMA更多更好的数据,LLaMA说我还能更强)。
但事实真的如此么?我们是否能仅用web data通过更好的清洗过滤策略就能训练出一个强大的模型呢?来自阿联酋阿布扎比技术创新研究所(TII)的团队就这一问题展开了研究,论文题目为The RefinedWeb Dataset for Falcon LLM: Outperforming Curated Corpora with Web Data, and Web Data Only。下面是论文的解读以及笔者自己的一些思考。
动机
为啥作者要执着证明网页数据好于专有数据呢?作者有以下三大理由:
- 网页数据的量级比公开数据大的多,仅用专有数据模型模型训练不到最佳效果 :GPT3 论文中说自己模型参数是175B,使用了大约300B的token数量进行模型训练,但根据scaling law我们得知,训练175B的模型,想要获得最有效果数据量应该是3500B tokens,这几乎是现有最大训练数据库的两倍,是现有公开训练数据的10倍。
- 专有数据处理起来很麻烦 :网页数据有固定的格式,我们可以根据html上面的标签进行处理,而专有数据因为来源很杂,格式不统一等原因,甚至需要一份数据,一种处理方式很费时间。
- 大部分专有数据其实在网页数据中也能找到 :比如书籍数据,也可能在某些盗版书网站上就有网页版本的。
所有作者认为要想模型训练的大、耗费的人力少就不得不重新将网页数据精细化利用起来。
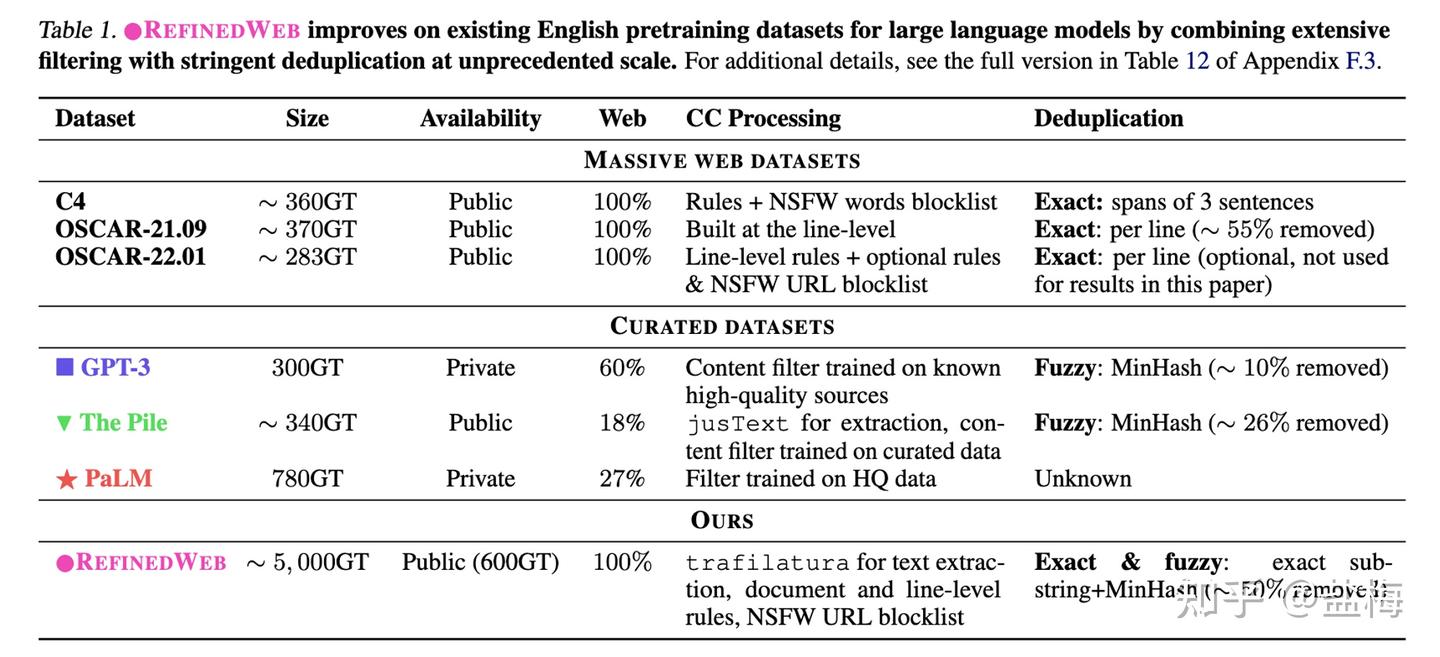 数据规模
先看结论
- 仅仅用CommonCrawl的网页数据中构建训练数据,训练了了Falcon-40B模型,并取得了不错的效果(huggingcase的大模型开源大模型排行榜OpenLLM Leaderboard上排名第一,但实测应该是不如LLaMA-65B的)。
- 作者通过自己的过滤清洗策略从CommonCrawl上清理出来大约5TB的数据,并公开了其中大约600G的数据。
- 作者证明了仅用web数据如果经过恰当的清洗和过滤,可以获得超过使用了专有数据模型的效果。
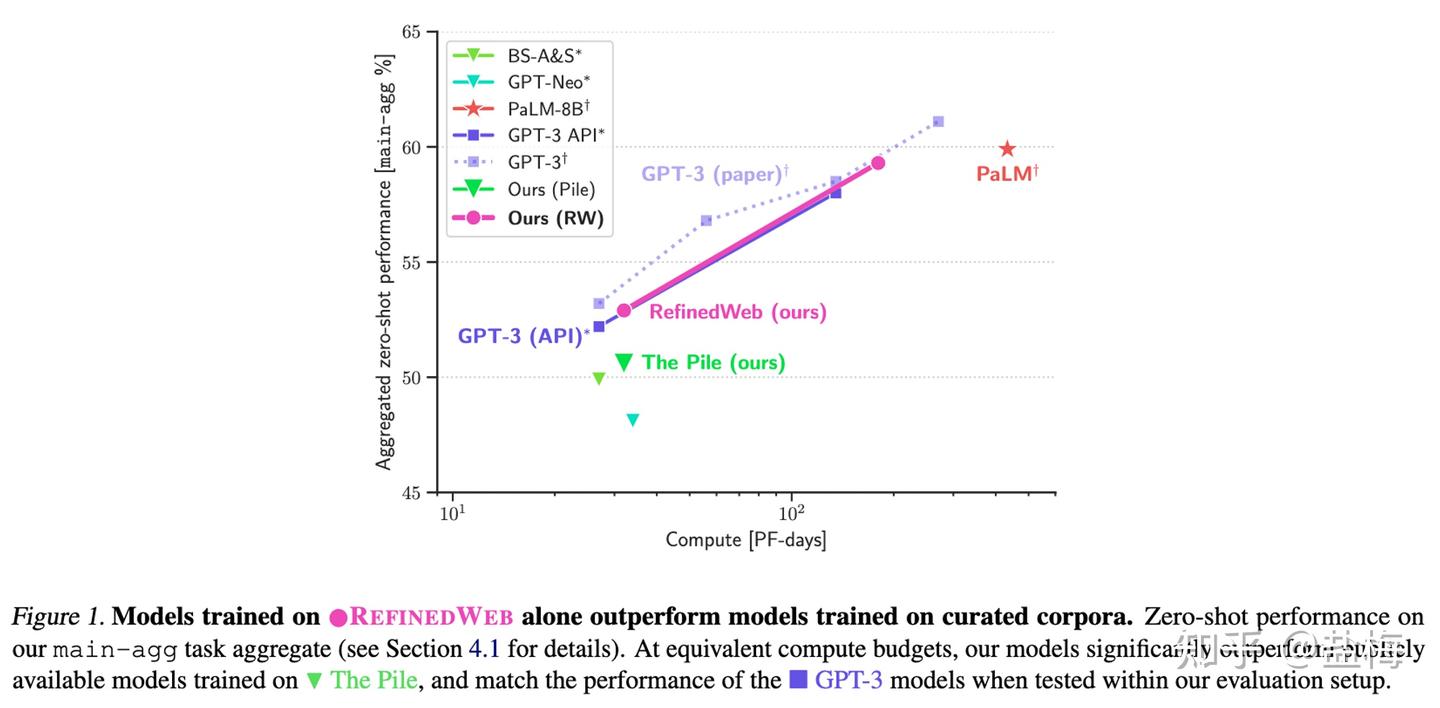 The pile是一个高质量数据集,作者在构建的RefinedWeb数据集上训练模型超过了在The pile数据集上训练的效果
网页数据处理方法
CommonCrawl数据特点
- 很脏:有大量的情色、暴力、诈骗以及机器生成的垃圾信息。
- 很大:百亿级别网页,PB级别数据量,因此一些深度学习的处理方法可能太慢了,更多的还是需要先用启发式规则过滤下。
- 有原始HTML网页格式WARC(raw HTML response) ,和仅包含内容文本的WET (preprocessed to only include plain text)两种格式。虽然WET类似进行了文本提取,但WET格式没有将文本清洗干净,很多广告信息,导航信息等也当成内容文本存储起来的。为了避免这些信息影响模型效果,作者使用WARC格式的数据重新进行清洗。
URL过滤
首先需要从CommonCrawl中过滤出我们需要的网站再进行内容提取。
- 作者整理了一个4.6 Million的URL黑名单,黑名单中的域名过滤掉,其中大部分是色情网站。
- 作者也训练了一个根据关键词过滤URL的工具,但发现很多嘻哈文化网站、医疗网站等被过滤了,怕可能引起bias,所以设计了一套比较复杂的规则,来尽可能的减少false positive误判样本。
- 为了证明单纯的网页数据也能有很好的训练效果,作者过滤了wikipeida、arxiv等高质量网站。
文本内容提取
需要特别注意,网页内容仅仅保留正文!URL、导航栏文本、标题、脚注、广告文本等和正文无关的信息要去除干净。作者使用trafilatura库用于从网页中提取正文。
文本处理Pipeline
- 目标语言识别 :将你需要的目标语言网页保留,这时候用到的模型是比较快的n-gram模型,比如fastTexts。
- 规则过滤 :将有一些包含禁用词的网页,标点符号过多的行去掉。这个要非常注意,如果过滤关键词范围很大的话,模型可能会有bias,举个栗子:如果将情色相关作为关键词进行过滤,那么很多医疗相关网页也会被过滤掉。
- 通过机器学习方法过滤出高质量语料库:比如将wikipedia链接到的网页(注意是链接到的,而不仅仅是wikipedia网页)作为正样本,随机采样作为负样本训练模型,将模型打分高于一定阈值的网页保留。不过这种机器学习算法也可能引入额外的bais,也要尽量少的采用。因此在情色内容过滤这块,作者仅使用URL进行过滤。
- 去重(Deduplication) :去除重复的段落和文档。去重有两种方案一种是绝对匹配(exact match)去重,就是完全一致的才叫重复,直接字符串匹配就好。一种是近似匹配(Approximate matches,也叫fuzzy duplicates)去重,就是将文档进行嵌入,通过哈希的方法进行去重,比如局部敏感哈希MinHash、SimHash等方法去重。
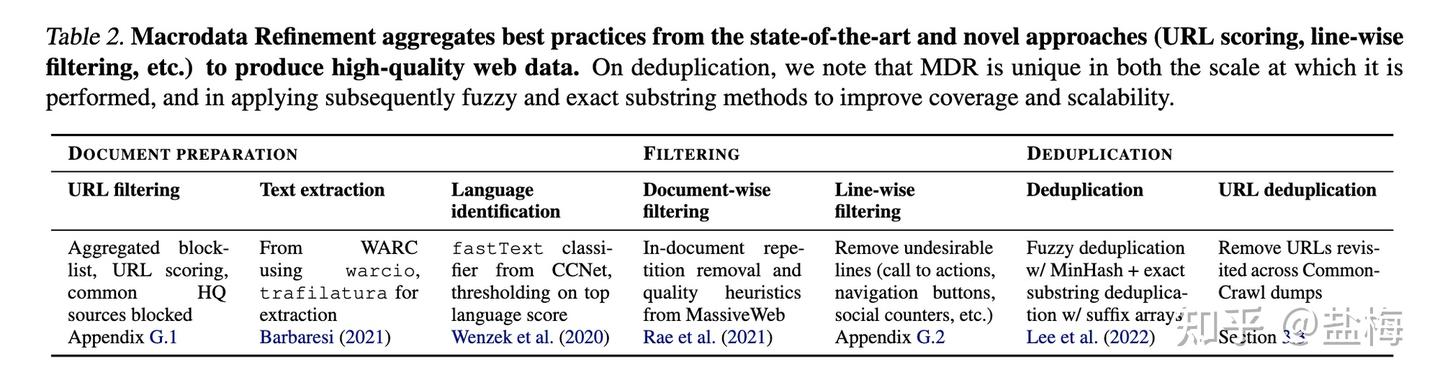 整体Pipeline
语言识别 Language identification
使用fastText 语言分类器 CCNet对文档进行分类,这个模型是一个训练好的n-gram模型,根据wikipedia训练的,支持176种语言。可以按照所需比如仅将英文页面拿出来。作者进行了这一步后52%的非英文网页被过滤掉了。
过滤 filtering
- 重复移除(Repetition removal):将文档中有太长的行,段落,或者n-gram repetitions的文章移除,这些很可能是机器生成的。
- 文档级别过滤(Document-wise filtering):如果文档的长度过长,或者某些单词在文档中的占比过高,那么这些文章也有可能是机器或者模板生成。
- 行级别过滤(Line-wise filtering):比如一些社交媒体正文中有点赞数量,导航跳转按钮之类的在正文里面的需要过滤的东西。并且如果一个文档中5%的行都被过滤了之后,那么整个文档也不要了。
去重 Deduplication
- 去重非常重要,如果去重做的不好,模型在这样的语料上进行学习后就会更倾向于记忆,导致泛化能力差。
- 近似去重(fuzzy deduplication) :提取文档的骨架,比如可以是词袋模型n-gram模型,主题模型等进行文档嵌入,然后使用MinHash进行去重。因为文档实在是太多了,过滤后也有十亿级别的文档,MinHash也不太容易去重,作者采用分20个桶,先计算5-gram,将相似的文档放到一个桶里面,然后桶内计算hash相似度进行去重,每个文档里面哈希位数是450,将哈希位数overlap过高的文档进行去重。作者也表示The pile数据集之所以效果表现不好,很可能是哈希位数太少了只有10位,并且过滤设定条件不严刚,很多重复文章并没有过滤掉,从而影响了在其上训练模型的效果。
- 绝对匹配去重(Exact deduplication) :进行句子级别绝对匹配去重,如果连续50个tokens和之前的文档有重复,那么移除掉。同时作者也验证了,直接移除还是在loss上进行mask,不计算重复部分的损失两种方案那种更好,但zero-shot泛化能力方面并没有明显的差别。
- URL去重 :作者表示Web页面实在太大了,直接进行上述的去重还是有些费力,提出的方案是将网页数据切成100份,然后100份内部各自去重,然后每一份也能共享其他部分发现的重复的部分,从而加快去重速度。此外commoncrawl中还有大量网页是转存其他网页的,因此每处理一个URL就要将其他转储的页面去掉。
清洗步骤,灰色的每一步中去除页面比例,因为语言不是英语去除了50.66%的页面,因为质量不达标去处了24%的页面,因为重复去掉了12%的页面。
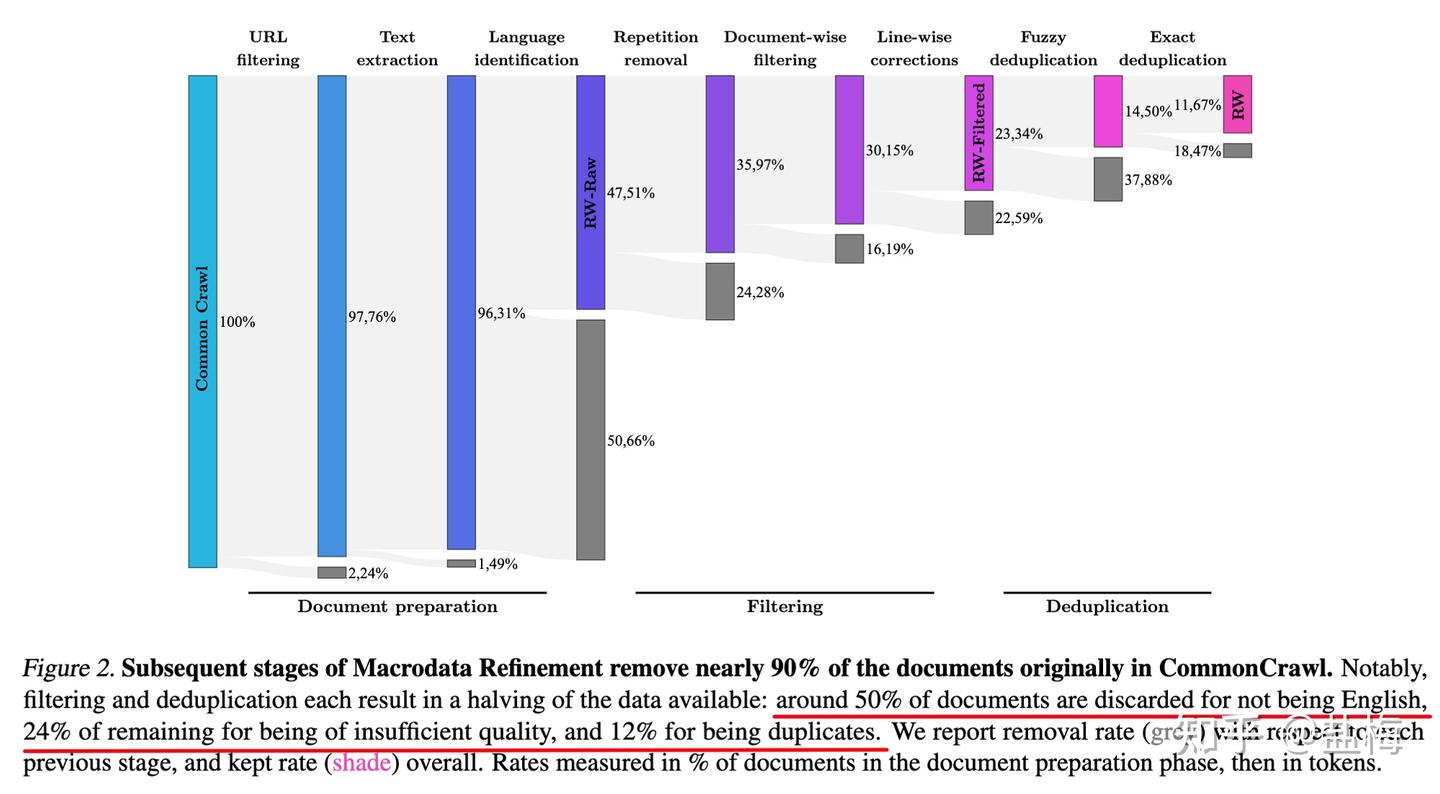 处理结果
实验&结论
作者主要比的是大模型zero-shot泛化能力。
- 可以看到OSCAR-22.01数据集上训练的模型,zero-shot能力显著低于其他模型,因为其没有去重。
- 作者做的RefinedWeb数据集则显著好于之前的网页数据集C4(T5的训练数据),以及The Pile(Bloom的训练数据),说明仅仅用web数据好好清洗,也能战胜专有数据。其中The pile数据集作者在上文中也提到,其虽然有过滤和去重,但门槛太低了,导致很多重复的内容其实并没有很好的被过滤。
- 去重非常影响最终的模型效果,并且去重比例越高,最后的效果越好(Deduplication delivers a steady boost across all datasets, and removal rates are better correlated with changes in performance)。
- 如果网页提取文本哪一步就没提取干净,最后的结果也不会很好。
- 如果网页数据训练多个Epoch,会减弱模型的泛化能力,训练的epoch越多,模型泛化能力越差。(但其他研究表明,专有数据比如code和arxiv等数据训练多个epoch反而会提升模型的推理能力)并且模型超过100B后,模型会对训练数据中的重复,以及训练多个epoch非常敏感,如果数据质量不高,则会非常影响模型的泛化能力。
- 在高质量专有数据集上训练多个epoch,并不比在web数据上充分训练一个epoch的效果好。
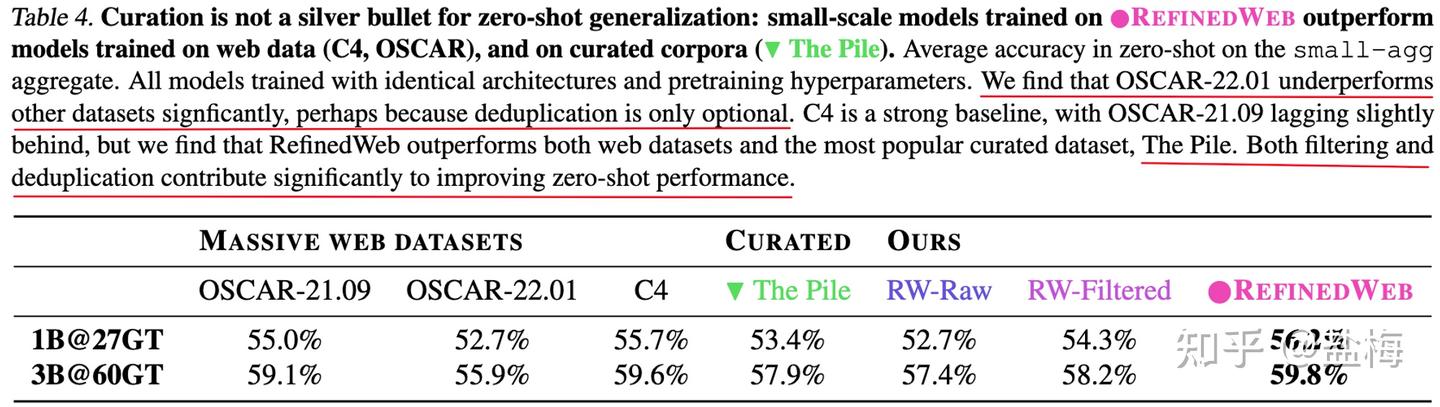 实验结果
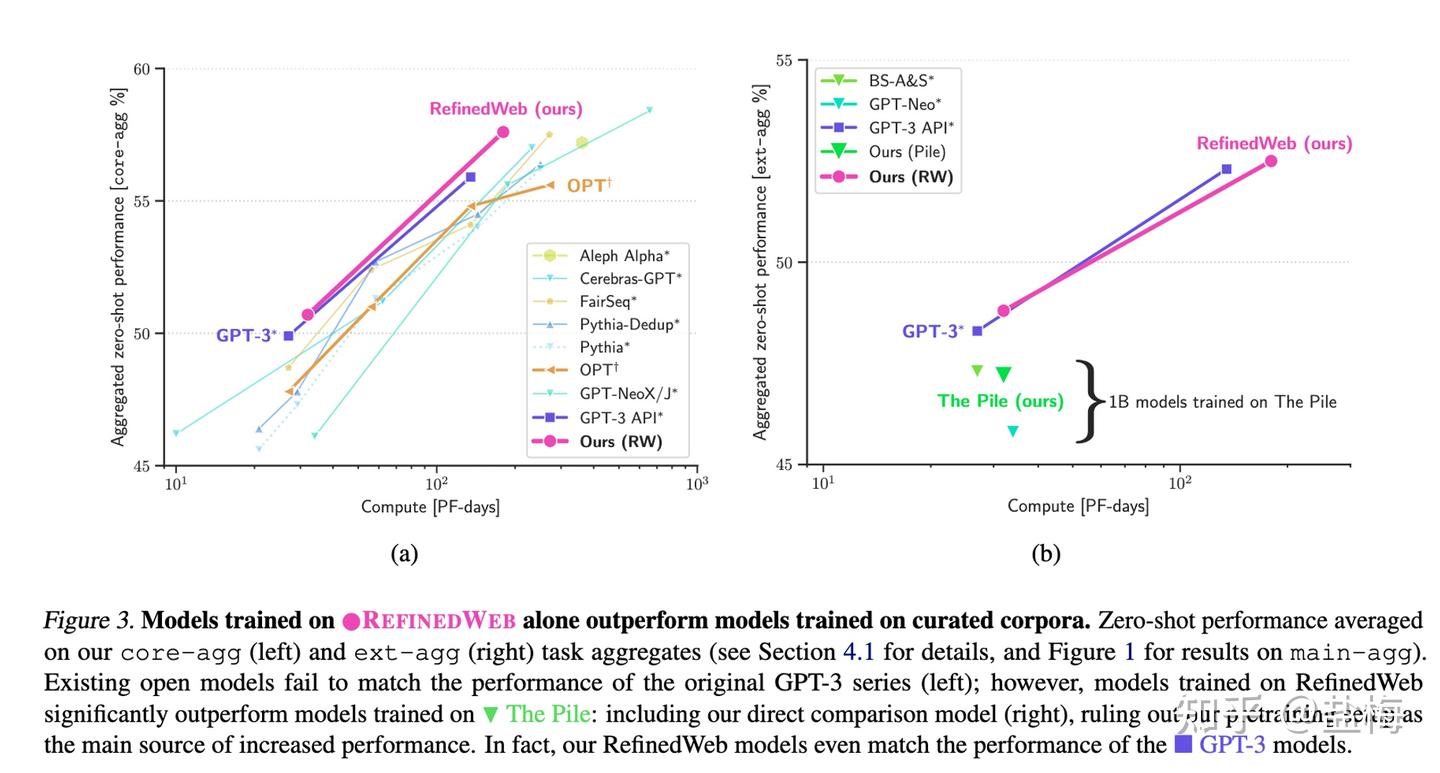 不同数据集训练模型的比较
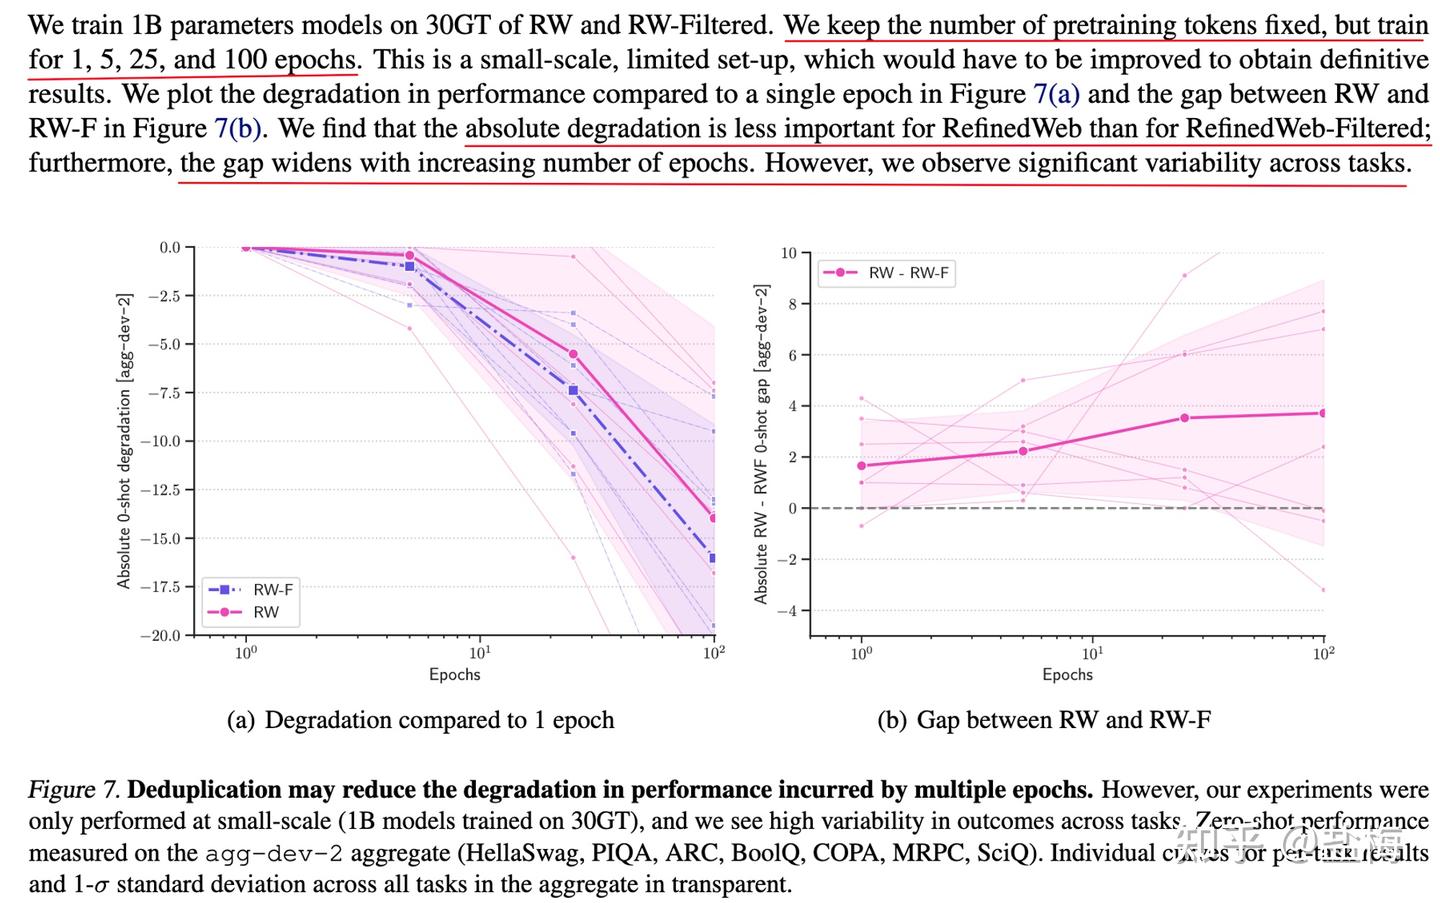 训练多个epoch会降低泛化能力
除过web数据我们还有那些常见的非Web高质量数据呢?
非Web数据
高质量专有数据 The Pile
-
网络数据
- Pile-CC: 使用 jusText提取 Common Crawl。过滤实现使用针对 OpenWebText2 数据集进行训练的 fasttext 分类器。仅处理可用 Common Crawl 数据的一小部分;我们将 2013 年至 2020 年的 url 列表分成 3679 个块,然后处理 22 个随机块。
- OpenWebText2⭐️:是 Pile 提出的信数据集,从所有截至2020年4月的 Reddit 提交中提取了URL及其相关的元数据。URL进行了去重,每个唯一的URL都具有相关提交元数据列表和聚合分数。聚合分数小于 3 的 URL 被删除。然后使用 Newspaper 对链接进行了爬取和处理。使用 DataSketch 库的内存 MinHashLSH 在文档级别执行了去重操作。生成了过滤后和原始版本,原始版本仅通过URL进行了去重。过滤版本包含了17103059个文档的65。86GB未压缩文本。原始版本更大,包含了69547149个文档的193.89GB未压缩文本。
- Stack Exchange⭐️:来自问答网站 stackexchange,每个问题只保留回答点赞数大于三的前三个回答,并组织成 QA 问答对的形式,最终得到 365 个类别下的15622475篇文档。
- Wikipedia (English): 英文 wiki 数据集,使用TensorFlow数据集中的wikipedia/20200301.en数据集。在每篇文章的正文前加上标题,中间用两个换行符隔开。
-
学术数据
- PubMed Central⭐️:PubMed Central(PMC)是美国国家生物技术信息中心(NCBI)运营的生物医学文章在线存储库PubMed的子集,为近500万篇出版物提供开放的全文访问。
- ArXiv⭐️:通过arXiv的S3批量源文件访问下载了截至2020年7月的所有论文的TEX源代码,并使用pandoc 1.19.2.4将这些源文件转换为Markdown。在转换过程中出现错误的论文被丢弃。这一过程产生了总共1,264,405篇论文。
- FreeLaw ⭐️: 法院意见数据。
- USPTO Backgrounds⭐️:专利相关的数据集。
- PubMed Abstracts⭐️: 生物医学领域的标题和摘要。
- PhilPapers⭐️: 哲学相关的论文。
- NIH Grand ABstracts: ExPORTER⭐️: 美国国立卫生研究院(NIH)经费数据库。
-
书籍数据
- Books3:Books3是一个图书数据集,包含有小说和非小说,相比于 BookCorpus2 大了一个数量级。
- Project Gutenberg: 西方古典文学的数据集,风格与线代文学很不同。
- BookCorpus2⭐️: 是 BookCorpus 的扩充,有 17868 本书,由于 BookCorpus2 的都是没出版的,因此不会跟 Books3 和 Project Gutenberg 的重叠。
-
对话数据
- OpenSubtitles: 电视和电影的英文字幕。
- Ubuntu IRC⭐️: Ubuntu IRC 数据集是从 Freenode IRC 聊天服务器上所有 Ubuntu 相关频道的公开聊天记录中派生出来的。聊天记录数据6提供了一个建模实时人类交互的机会,这种交互具有其他社交媒体模式通常不具备的自发性。
- EuroParl: 一个多语言平行语料库,最初是为了机器翻译而引入的。
- YouTube Subtitles⭐️: YouTube字幕数据集是从YouTube上人工生成的封闭字幕中收集的文本平行语料库。除了提供多语言数据外,YouTube字幕还是教育内容、流行文化和自然对话的来源。
- Hacker News⭐️: 用户提交的文章被定义为“满足一个人的知识好奇心的任何事物”,但提交的文章往往集中在计算机科学和创业主题上。用户可以评论提交的故事,导致评论树讨论和批评提交的故事。我们会抓取、解析和包含这些评论树,因为作者相信它们提供了高质量的讨论和辩论的细分主题。
-
其它数据
- Github⭐️:github 的代码数据,用两步进行收集1. 收集所需仓库和其元数据的列表 2. 从每个仓库中提取用于语言建模的所有文本数据。
- DeepMind Mathematics: 由代数、算术、微积分、数论和概率等主题的数学问题集合组成。
- Enron Emails: 电子邮件数据集。
代码数据 The stack
下载链接:https://huggingface.co/datasets/bigcode/the-stack-dedup
The Stack数据集,这是一个具有3.1TB的合法开源代码语料,拥有30种编程语言(注:最新版The Stack v1.1已经拓展到了308种语言,6TB数据);去重后有3TB的数据
跨语言数据集 ROOTS
NeurIPS 2022,BLOOM 的训练语料
下载 URL: https://huggingface.co/bigscience-data
清洗 URL: https://github.com/bigscience-workshop/data-preparation
the Responsible Open-science Open-collaboration Text Sources (ROOTS)
一个1.6TB的数据集跨越了59种语言(46种自然语言,13种编程语言),用于训练拥有1760亿个参数的BigScience大型公开科学多语言开放访问(BLOOM)语言模型。(BigScience Workshop, 2022)
62%的文本来自社区选择和记录的语言数据源列表,另外38%的文本来自经过预处理的网络爬取数据集OSCAR, 并通过母语人士的帮助进行了过滤
- 62% 通过社区收集得到 主要包括三个来源:
- 已整理好的数据集,如一些已有的 NLP 数据集等
- 伪爬虫数据集,部分志愿者提交的网站,但还没包括内容,这时要利用 url 去 Common Crawl 的快照中解析对应的内容
- GitHub Code
三部分得到后要做一个融合和去重。后面还接了一些手工的提升方法以提高数据集的质量。
- 38% 从OSCAR 清洗得到
- 数据清洗和过滤
- 太高的字符重复或单词重复作为重复内容的度量标准。
- 过高的特殊字符比例以去除页面代码或爬行工件。
- 关闭类单词的比率不足以过滤出SEO页面。
- 过高的标志词比例以过滤出色情垃圾。我们要求贡献者根据这个标准量身定制他们语言中的单词列表(而不是与性有关的通用术语),并偏向于高精度。
- 过高的困惑度值以过滤非自然语言。
- 单词数量不足,因为LLM训练需要广泛的上下文大小。
- 去重:采用 simhash 去重,对长文本进行特殊处理
- 去除个人信息
对话数据
音视频模态转化文本数据
- The pile中有部分YouTube字幕数据,尚未发现大规模开放数据。
中文数据 WuDaoCorpora
完整版:3TB training data and 1.08T trillion Chinese characters,包含有 822 million Web pages
- 有‘content’字段
- 有’index’字段:which field it belongs
base 版:200G & 72 billion Chinese characters
悟道使用30亿个网页作为原始数据源,并从中提取高文本密度的文本内容。提取的文本包含许多额外的字符,损害内容的完整性和流畅性,例如网页标识符、异常符号和乱码。此外,从某些网页提取的文本内容中存在敏感信息和个人隐私信息,这可能会导致训练模型中出现不良趋势和信息泄露问题。为了解决这些问题,在数据清理过程中,作者开发了一套处理流程,以提高语料库的质量。
以下是数据清理的具体步骤:
- 在文本提取之前,会评估每个数据源的质量,并忽略文本密度低于70%的网页。
- 由于网页文本转载现象普遍存在,使用simhash算法删除重复内容。
- 少量文字的网页通常意味着它们不包含有意义的句子。这些网页不适合用于训练语言模型。如果一个网页包含少于10个汉字,会忽略它。
- 脏话、煽动性评论和其他非法内容等敏感信息会对建设和谐、积极的社会环境产生不利影响。排除包含上述内容的网页。
- 为了最大程度地保护每个人的隐私安全,使用正则表达式匹配私人信息(如身份证号码、电话号码、QQ号码、电子邮件地址等),并从数据集中删除它们。
- 不完整的句子在模型训练中可能会出现问题。使用标点符号(如句号、感叹号、问号、省略号)来分隔提取出的文本,并删除最后一段,有时最后一段可能是不完整的。
- 由于某些网页违反了W3C标准,从这些网页提取的文本可能会乱码。为了排除语料库中的乱码内容,我们过滤掉高频乱码词汇的网页,并使用解码测试进行二次检查。
- 由于简体和繁体中都有汉字,将这些繁体汉字转换为简体汉字,以使的语料库中字符格式统一。
- 为了保证提取的文本流畅,从网页中删除那些异常符号(如表情符号、标志等)。
- 为了避免的数据集中存在过长的非中文内容,我们排除那些包含超过十个连续非中文字符的网页。
- 由于网页标识符(如HTML、层叠样式表(CSS)和Javascript)对语言模型训练没有帮助,从提取的文本中删除它们。
- 由于用空格分隔两个汉字是不必要的,删除每个句子中的所有空格,以规范化的语料库。
文本大模型训练的上界在哪?
目前的问题并不是数据不够了,还是训练速度太慢了,很多大模型只用到了CommonCrawl的一小部分数据。比如 CommonCrawl 有88个快照,每个快照大概能清洗出来200B的中英文高质量语料,则我们可以清洗出大约18TB tokens的高质量数据,如果加上专有数据则可以突破24TB tokens,这几乎是现有最大开源模型LLaMA-65B训练数据1.2TB tokens的20倍。而根据Scaling law,24TB高质量数据可以充分训练1300B的模型,并且所需训练量是目前训练LLaMA-65B的400倍。LLaMA-65B大概是在2000张80G显存N卡上训练了21天, 大概耗费400万刀,如果这个规模再扩大400倍则训练一次成本160,000万刀则是任何大厂都难以承受的。并且训练还好,只是一次性成本,后面的推断成本更是现在的机器资源无法承受。
但好在硬件方面Nvidia最近也在放大招,DGX GH200 可以插256个GH200,可以理解为相比原来的DGX A100显存直接扩大了500倍,意味着单层模型可以到更大的DGX Node,模型可以更大了。(Compared to a single NVIDIA DGX A100 320 GB system, NVIDIA DGX GH200 provides nearly 500x more memory to the GPU shared memory programming model over NVLink, forming a giant data center-sized GPU. NVIDIA DGX GH200 is the first supercomputer to break the 100-terabyte barrier for memory accessible to GPUs over NVLink.DGX GH200, which can utilize the combined power of 256 GH200 chips to perform as a single GPU, providing 1 exaflop of performance and 144 terabytes of shared memory.)
同时训练速度也扩大了三百倍。This machine gives you 1e18 FLOPs per second vs 单卡A100 FP16下的 312 T Flops(3e15)。
因此可以断定,大规模预训还没有到头,数据&模型只训练了1/20,算力只用了1/400。
但同时随着机器生成的内容越来越多,清洗也会越来越麻烦,因为太多的机器生成的文本需要仔细过滤。
如何突破文本训练的Scaling law
为什么会有Scaling law的猜想
大模型训练的scaling law可以是因为信息在文本中的的分布也呈现指数分布。简单来说就是低频的信息在文本中存在极少,模型需要指数级别训练才能线性级别获取新的有用的信息,线性级别降低loss提升效果。
因为scaling law的存在,模型所需算力=O(C^N),其中N是模型效果(1/测试集loss),C是一个常数。这个效率就太低了,如果能优化到O(N*logN)那么需要的算力会大大降低,效果的上限也更高。
多模态训练
人在获取信息的时候并不需要那么多数据,在看过一张苹果的照片,吃过一个苹果后,我们立刻明白文字中描述的,颜色红,味甘甜是什么意思,而不用阅读数百篇苹果的文字介绍但还是不知其所指。因此笔者认为多模态知识的加入可以降低文本数据的使用,突破Scaling law。
数据更好的利用
在模型已经表现很好的数据上可以降低训练。过滤和去重也是一个思路,对数据进行精炼后模型的训练效率会大大提高,因为信息密度更高了,突破了信息的scaling law。在数据方面一些比较好的尝试是:
- Textbooks are all you need. 证明了小数据也能有大威力。
- InternLM: A Multilingual Language Model with Progressively Enhanced Capabilities. 证明了训练数据可以分成多个阶段,进行课程学习也能提升效果。
- Scaling Language Models: Methods, Analysis & Insights from Training Gopher. DeepMind证明了提升模型规模和提升数据质量同样重要,仅仅是大模型也做不好推理任务,但如果数据处理的好的话,模型的推理能力能大幅提升。(这篇论文也是数据处理的经典之作,介绍的很详细)
编辑于 2023-07-11 09:15・北京
LLM
ChatGPT
多模态大模型
赞同 35511 条评论745 56
分享
申请转载
 未登录用户
11 条评论
默认
最新
 蓝色史莱姆
数据清洗的作用我是认同的,但是你提到的“专有数据处理起来很麻烦”这点我就无法认同了,以电子书为例,用Python处理起来只需要几行代码就够了。技术上,主流电子书格式epub和mobi本质上就是个压缩包,解压出来的XHTML文件也完全遵循HTML规范,而且电子书是为阅读设计的,其上下文更长,排版比绝大多数网站简洁、干净,既没有js干扰,也不会进行混淆和加密,一般还会有目录可用,连几行代码也不想写的话用calibre直接转成txt就是了。专有数据实用性很强,格式不会太复杂,处理起来很简单,也基本不用清洗数据。网站数据一千个网站可以有一千种排版,写过爬虫的都知道,你后面介绍的复杂的数据清洗过程其实正是网页数据处理困难的体现。
2023-08-30 · 北京
回复10
查看全部 6 条回复
 李熠
"但其他研究表明,专有数据比如code和arxiv等数据训练多个epoch反而会提升模型的推理能力"请问这个出处是哪里呢?
2025-01-06 · 浙江
回复喜欢
 建议大二暑假实习
求代码
 2024-03-29 · 浙江
回复喜欢
 天天睡觉不摸鱼
“作者使用trafilatura提取正文” 这句话是否有误,trafilatura应该是只能用来提取文本把,本身并没有去除导航栏、脚注、cookie警告等信息的功能
2023-11-09 · 北京
回复喜欢
 Cooper
很不错了,但是作者如果可以多给一些论文的介绍,做个对比
 ,那会更好
2023-09-11 · 广东
回复喜欢
关于作者
赵亮
NLPer
回答 4 文章 6 关注者 1,315
关注发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
推荐阅读
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码
 清华做了个大模型使用工具的数据集:ToolLLM论文解读 HanXYZ
 七爪源码:Python 中的数据预处理:准备好数据集的 4 个基本步骤 七爪网 # 大Batch训练大语言模型的探索与实践 前言 最近在训练 language model 的时候发现了一个问题,在有很多卡的情况下,最有效提高训练效率的办法就是提高数据并行不论是提高 batch size 本身,还是通过梯度累计的方法)。本文转载… CV技术指南