 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
LLM(23):LLM 中的长文本问题
首发于从NLP到LLM
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
LLM(23):LLM 中的长文本问题
首发于从NLP到LLM
切换模式
 紫气东来
 上海交通大学 工学硕士
收录于 · 从NLP到LLM
443 人赞同了该文章
目录
近期,随着大模型技术的发展,长文本问题逐渐成为热门且关键的问题,不妨简单梳理一下近期出现的典型的长文本模型:
实际上,随着文本长度的提高,模型能够处理问题的边界也大大提高,因此研究并解决长文本问题就显得非常必要。本文将从长文本问题的本质出发,逐步分析和研究长文本实现的问题及解决办法。
要研究清楚长文本的问题,首先应该搞清楚文本长度在模型中的地位与影响。那么我们便以 Decoder-base 的模型为例来进行分析
1.1.1 模型参数量
Decoder-base 的模型主要包括 3 个部分:embedding, decoder-layer, head。
其中最主要部分是decoder-layer,其由 l 个层组成,每个层又分为两部分:self-attention 和 MLP。
self-attention 的模型参数有 Q、K、V 的权重矩阵 W_Q、W_K、W_V 及bias,输出矩阵 W_O 及bias,4个权重矩阵的形状为 [h,h] ( h 表示 hidden_size),4个bias的形状为 [h] 。则 self- attention 的参数量为 4h^2+4h 。
MLP 由2个线性层组成,一般地,第一个线性层是先将维度从 h 映射到 4h ,第二个线性层再将维度从4h映射到h。第一个线性层的权重矩阵 W_1 的形状为 [h,4h] ,偏置的形状为 [4h] 。第二个线性层权重矩阵 W_2 的形状为 [4h,h] ,偏置形状为 [h] 。则 MLP 的参数量为 8h^2+5h 。
self-attention 和 MLP 各有一个layer normalization,包含了2个可训练模型参数:缩放参数 \gamma 和平移参数 \beta ,形状都是 [h] 。2个layer normalization的参数量为 4h 。
由此,每个 Decoder 层的参数量为12h^2+13h。
此外,embedding 和 head 的参数量相同,与词表相关,为Vh(如果是 Tied embedding,则二者共用同一个参数)。由于位置编码多样,且参数量小,故忽略此部分。
综上,l 层模型的可训练模型参数量为 l(12h^2+13h)+2Vh。当 h较大时,可以忽略一次项,模型参数量近似为12lh^2。
1.1.2 计算量估计
如果说参数量是模型的固有属性,那么计算量便是由模型和输入共同决定,下面分析这一过程。
假设输入文本经过分词器后的 input_ids数据的形状为 [b,s ] ( b 表示 batch_size, s 表示 sequence_length),然后经过 embedding 层后 x形状变为 [b,s,h ] ,由于仅仅是查表操作,计算量为 bsh 。
先分析 Decoder 中 self-attention 的计算量,计算公式如下:
Q=xW_Q,K=xW_K,V=xW_V\\x_{out}=softmax(\frac{QK^{T}}{\sqrt{h}})\cdot V\cdot W_o + x\
1. 计算 Q,K,V :矩阵乘法的输入和输出形状为 [b,s,h] \times [h,h]\rightarrow [b,s,h] 。计算量为 32bsh^2=6bsh^2 。
2. QK^{T} 矩阵乘法的输入和输出形状为 [b, n\_head, s,head\_dim]\times [b,n\_head,head\_dim,s]\rightarrow [b,n\_head,s,s] 。计算量为 2bs^2h 。
3. 计算在 V 上的加权 score\cdot V ,矩阵乘法的输入和输出形状为 [b,n\_head,s,s]\times[b,n\_head,s,head\dim]\rightarrow[b,n\head,s,head\dim] 。计算量为 2bs^2h 。
4. attention后的线性映射,矩阵乘法的输入和输出形状为 [b,s,h]\times[h,h]\rightarrow [b,s,h] 。计算量为 2bsh^2 。
接下来分析MLP块的计算,计算公式如下 :
x=f{gelu}(x{out}W_1)W_2+x{out}\
1. 第一个线性层,矩阵乘法的输入和输出形状为 [b,s,h]\times[h,4h]\rightarrow[b,s,4h] 。计算量为 8bsh^2 。
2. 第二个线性层,矩阵乘法的输入和输出形状为 [b,s,4h]\times[4h,h]\rightarrow[b,s,h] 。计算量为 8bsh^2 。
将上述计算量相加,得到每个Decoder层的计算量大约为 24bsh^2+4bs^2h 。
此外,另一个计算量的大头是logits的计算,将隐藏向量映射为词表大小。矩阵乘法的输入和输出形状为 [b,s,h]\times[h,V]\rightarrow [b,s,V] ,计算量为 2bshV 。
因此,对于一个 l 层的模型,输入数据形状为 [b,s] 的情况下,一次前向计算的计算量为 l(24bsh^2+4bs^2h)+2bshV 。
1.1.3 文本长度与计算量、参数量、显存的关系
忽略低次项,一次输入的tokens数为bs, 则计算量与参数量的关系为 \frac{l(24bsh^2+4bs^2h)}{bs12lh^2} = \frac{6h+s}{3h} ,在实际中通常 s<h (在长文本情况下,可能会出现 s>h 的情况,但影响不是决定性的),因此该项可近似认为约等于 2。即在一次前向传递中,对于每个token,每个模型参数,需要进行2次浮点数运算(一次乘法法运算和一次加法运算)。考虑到后向传递的计算量是前向传递的2倍。因此一次训练迭代中,对于每个 token,每个模型参数,需要进行23=6次浮点数运算。
通过以上分析,我们可以得到结论:计算量主要和模型参数和 token 数相关,在 token 总数不变时,文本长度增加并不会显著增加计算量 。那么这就引出另一个问题:文本长度与显存的关系。
除了模型参数、梯度、优化器状态外,占用显存的大头就是前向传递过程中计算得到的中间激活值。这里的激活(activations)* 指的是:前向传递过程中计算得到的,并在后向传递过程中需要用到的所有张量。
先分析 Decoder layer 中 self-attention 的中间激活:
1. 对于 Q,K,V ,需要保存它们共同的输入 x ,这就是中间激活。输入 x 的形状为 [b,s,h] ,元素个数为 bsh ,占用显存大小为 2bsh=2bsh 。
2. 对于 QK^T 矩阵乘法,需要保存中间激活 Q,K ,两个张量的形状都是 [b,s,h] ,占用显存大小合计为 22*bsh=4bsh 。
3. 对于 softmax() 函数,需要保存函数的输入 QK^T ,占用显存大小为 2bs^2a ,这里的 a 表示注意力头数。
4. 计算完 softmax() 函数后,会进行dropout操作。需要保存一个mask矩阵,mask矩阵的形状与 QK^T 相同,占用显存大小为 bs^2a 。
5. 计算在 V 上的attention,即 score\cdot V ,需要保存 score ,大小为 2bs^2a ;以及 V ,大小为 2bsh 。二者占用显存大小合计为 2bs^2a+2bsh 。
6. 计算输出映射以及一个dropout操作。输入映射需要保存其输入,大小为 2bsh ;dropout需要保存mask矩阵,大小为 bsh 。二者占用显存大小合计为 3bsh 。
因此,将上述中间激活相加得到,self-attention 的中间激活占用显存大小为 11bsh+5bs^2a 。
接下来分析分析 Decoder layer 中 MLP 的中间激活:
1. 第一个线性层需要保存其输入,占用显存大小为 2bsh 。
2. 激活函数需要保存其输入,占用显存大小为 8bsh 。
3. 第二个线性层需要保存其输入,占用显存大小为 8bsh 。
4. 最后有一个dropout操作,需要保存mask矩阵,占用显存大小为 bsh 。
对于MLP块,需要保存的中间激活值为 19bsh 。
另外,self-attention块和MLP块分别对应了一个layer normalization。每个layer norm需要保存其输入,大小为 2bsh 。2个layer norm需要保存的中间激活为 4bsh 。
综上,每个层需要保存的中间激活占用显存大小为 34bsh+5bs^2a 。对于 l 层transformer模型,还有embedding层、最后的输出层。embedding层不需要中间激活。总的而言,当隐藏维度 h 比较大,层数 l 较深时,这部分的中间激活是很少的,可以忽略。因此,对于 l 层模型,中间激活占用的显存大小可以近似为 (34bsh+5bs^2a)*l ,这个结果与文本长度关系密切。
下面以GPT3-175B为例,对比下文本长度对模型参数与中间激活的显存大小的影响。假设数据类型为 FP16 。
| 模型名 | 参数量 | 层数 | 隐藏维度 | 注意力头数 |
| --- | --- | --- | --- | --- |
| GPT3 | 175B | 96 | 12288 | 96 |
GPT3的模型参数量为175B,占用的显存大小为 2\times 175\times 10^9bytes=350GB 。GPT3 模型需要占用350GB的显存。
假设 GPT3 输入的 b=1 。对比不同的文本长度下占用的中间激活:
当 s=2048 时,中间激活占用显存为 (34bsh+5bs^2a)*l=275,414,777,856bytes\approx275GB ,大约是模型参数显存的0.79倍;
当 s=4096 时,中间激活占用显存为 (34bsh+5bs^2a)*l=937,376,612,352 bytes \approx 937GB ,大约是模型参数显存的2.68倍。
可以看到长度仅仅到 4K,显存占用就出现了剧烈增加,同时 GPU 的 onchip memory 就显得更加捉襟见肘(因此也就出现了 FlashAttention 这类算法)。因此如何解决长文本带来的巨量显存开销成为关键及核心问题。
当前,为了实现更长文本的支持,解决思路主要可以分为两个阶段:
为实现这一阶段目标,通常采用并行化 (parallelism) 方法将显存占用分摊到多个 device,或者改造 attention 结构,避免显存占用与文本长度成二次关系。
为实现这一阶段目标,通常也是需要在两个方面进行考虑: * 对位置编码进行外推 * 优化 Attention 机制
本文接下来的部分将尽可能详细深入地进行这些问题的研究。为了便于理解和接受,下文将从易到难,先介绍第二阶段的技术,然后再介绍第一阶段(同时也是考虑到直接使用开源模型者,不需要第一阶段的情况)。
在 Transformer 结构的模型中,Attention模块的值与顺序无关,因此需要加入位置编码以确定不同位置的 token。典型的位置编码方式有两类:
随着文本长度的增加,位置编码也会发生相应的变化,因此处理好位置编码问题是解决长文本问题的重要环节。
一般来说,绝对位置编码会加到输入中:在输入的第 k 个输入向量 x_k 中加入位置向量 p_k 得到 x_k+p_k ,其中 p_k 仅依赖于位置 k 。
如下图所示,以二维向量为例来形象说明,图左中黑色剪头为输入向量 x_k ,蓝色箭头为位置向量 p_k(不同方法的长度与角度不同),其相加的结果为绿色箭头。在 Attention 结构中, q=(x_k+p_k)W_q, k=(x_k+p_k)W_k 即相当于同时对输入向量 x_k 和位置向量 p_k 进行线性变换,那么 attention 值则是 q 和 k 的点积,如下图右中 q_{u+k} 和 k_{u+2k} 的注意力即黄色夹角区域。
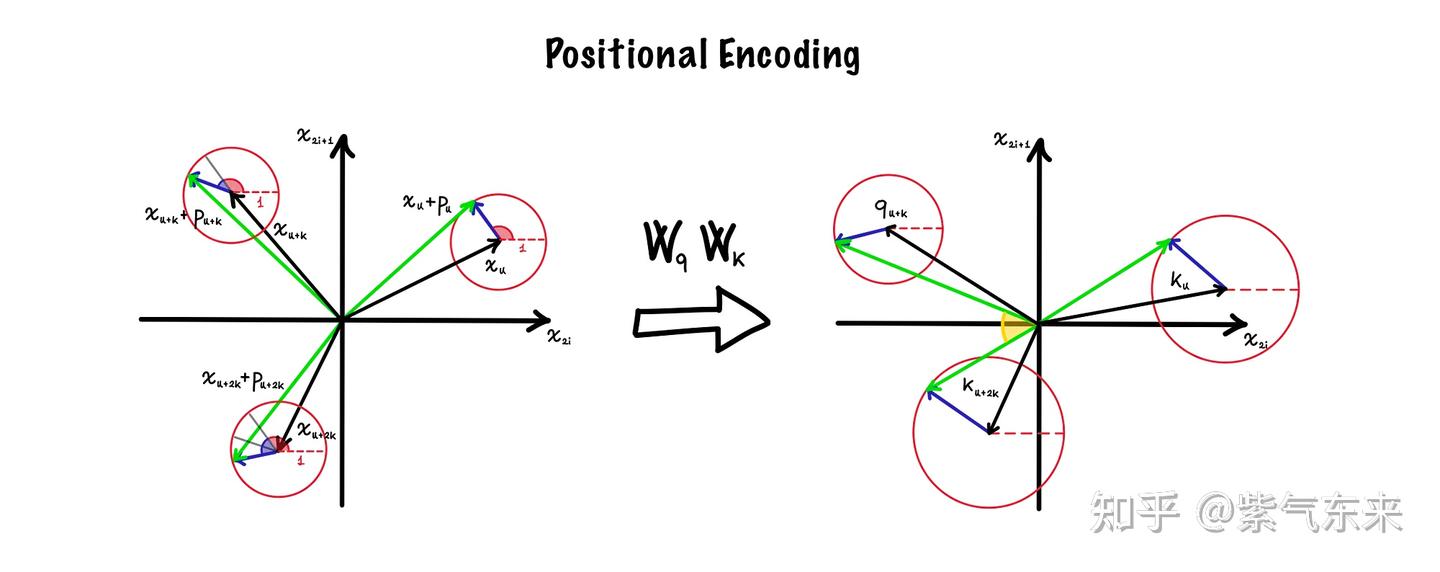 由于绝对位置编码由两部分组成,且两部分相互独立,因此无法计算相对距离。下面介绍几种典型的绝对位置编码:
2.1.1 训练式编码
这种方式最为简单直接,即把位置当做词表一样,训练一个 [max\length, hidden\size] 位置向量矩阵。这种训练式的绝对位置编码,一般的认为它没有外推性,但是苏剑林大神提出过一个层次分解的拓展方法。
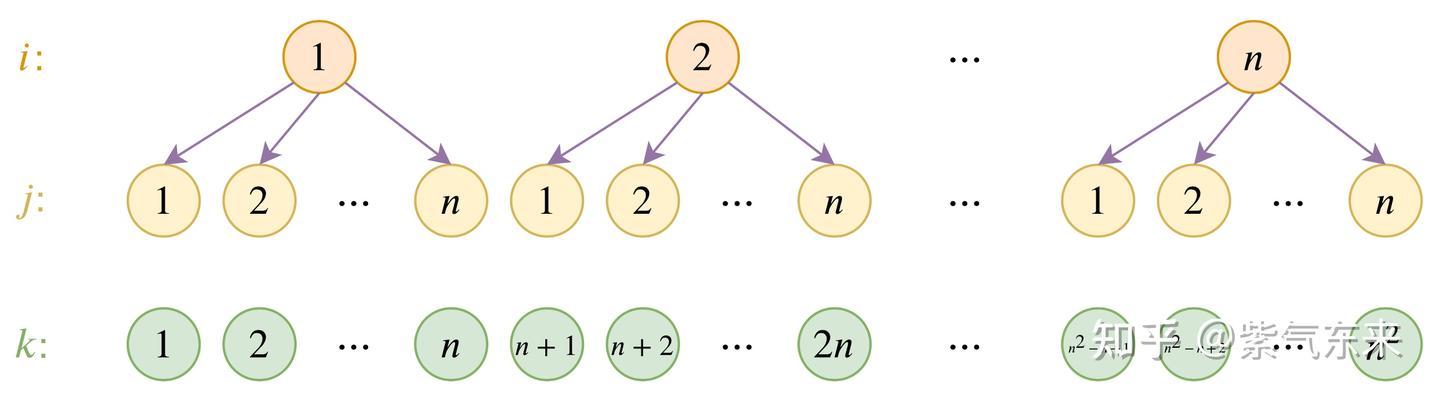 假设已经训练好的绝对位置编码向量为 p_1, p_2, \dots, p_n ,希望能在此基础上构造一套新的编码向量p_1, p_2, \dots, p_m ,其中 m>n 。为此,设
\boldsymbol{q}{(\mathrm{i}-1) \times n+j}=\alpha\boldsymbol{u}{\mathrm{i}}+(1-\alpha) \boldsymbol{u}{\mathrm{j}} \
其中超参 \alpha \in (0,0.5)\cup (0.5,1) , \boldsymbol{u}{\mathrm{1}}, \boldsymbol{u}{\mathrm{2}}, \dots , \boldsymbol{u}{\mathrm{n}} 是该套位置编码的“基底”。为了保障 \boldsymbol{q}1=\boldsymbol{p}1, \boldsymbol{q}2=\boldsymbol{p}2, \cdots, \boldsymbol{q}{\mathrm{n}}=\boldsymbol{p}{\mathrm{n}} ,这样就能反推出各个 \boldsymbol{u}{\mathrm{i}} :
\boldsymbol{u}{\mathrm{i}}=\frac{\boldsymbol{p}{\mathrm{i}}-\alpha \boldsymbol{p}1}{1-\alpha}, \quad \mathrm{i}=1,2, \cdots, \mathrm{n} \\ 这样就最大可以表示出 n^2 个位置的编码,并且前 n 个位置编码跟原来模型是相容的。下图反映了经过finetune其准确率在延长的位置编码在MLM任务上是行之有效的。
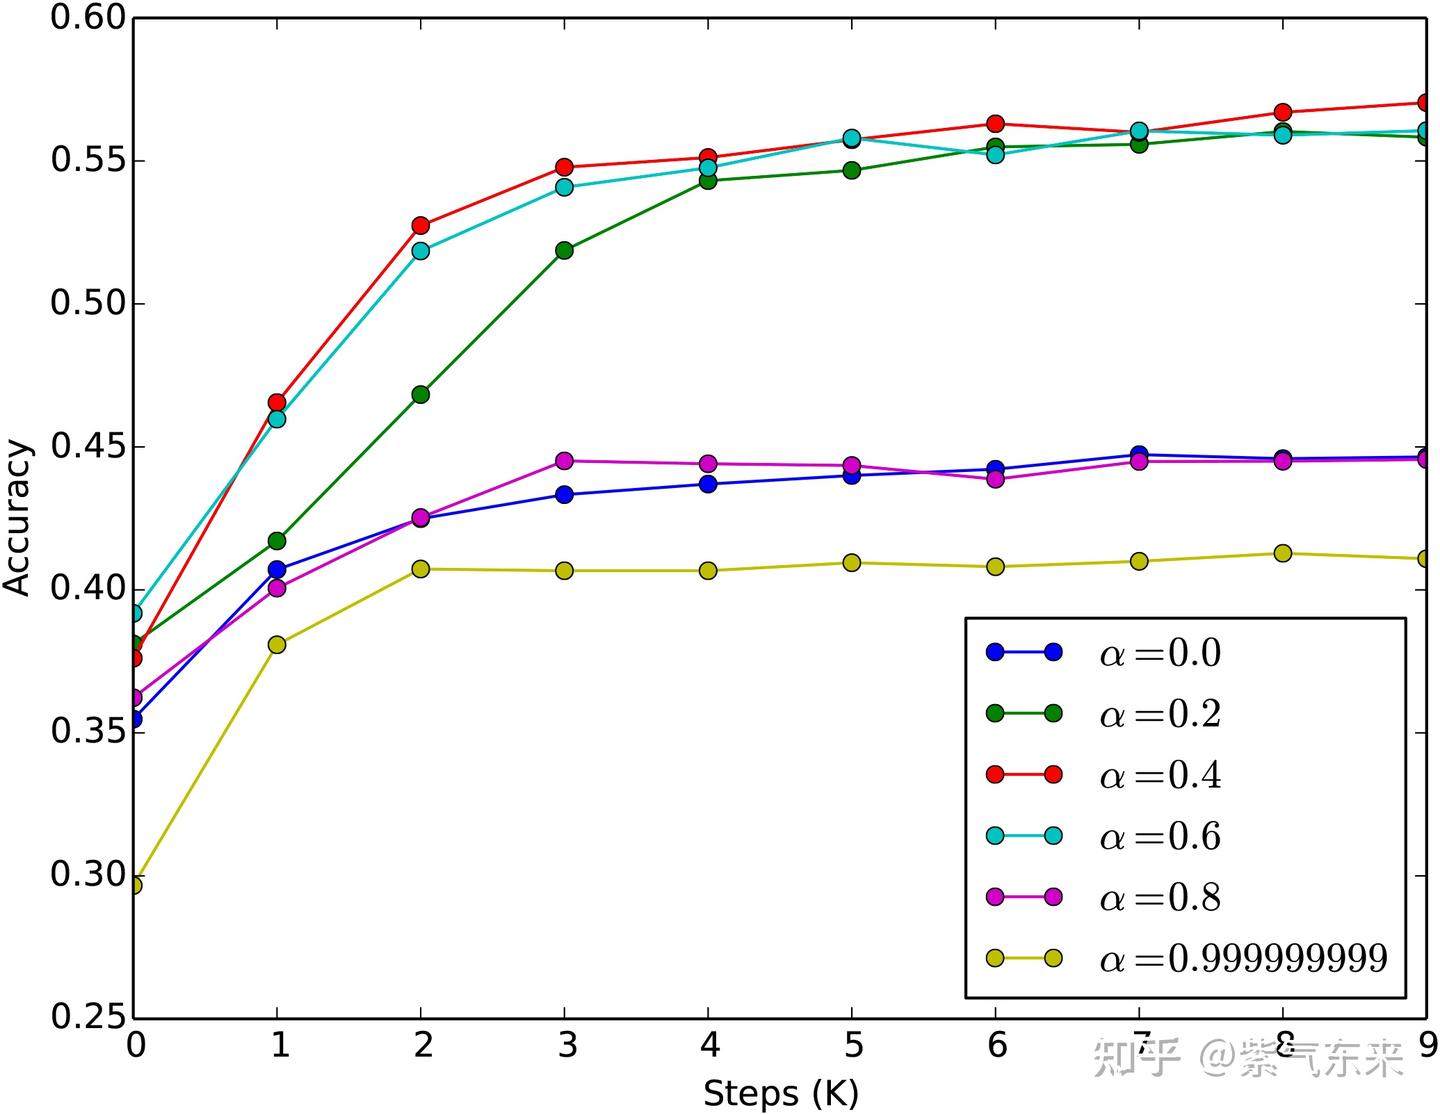 不同alpha下BERT MLM的训练准确率
需要说明的是,这种矩阵式的位置编码方式在当前的大模型中已经比较少采用了,仅有 GPT2 等早期模型中采用了这种方式。
2.1.2Sinusoidal 位置编码
这种方案也是Attention Is All You Need 中提出的方法 \left\{\begin{array}{l} \boldsymbol{p}{\mathrm{k}, 2 \mathrm{i}}=\sin \left(\mathrm{k} / 10000^{2 \mathrm{i} / \mathrm{d}}\right) \\ \boldsymbol{p}{\mathrm{k}, 2 \mathrm{i}+1}=\cos \left(\mathrm{k} / 10000^{2 \mathrm{i} / \mathrm{d}}\right) \end{array}\right. \\其中 \boldsymbol{p}{\mathrm{k}, 2 \mathrm{i}}, \boldsymbol{p}{\mathrm{k}, 2 \mathrm{i+1}} 分别是位置 k 的编码向量的第 2i,2i+1 个分量, d 是位置向量的维度。
根据以上定义,我们可以非常简单计算得到Sinusoidal位置编码的值,并绘制图像研究其规律。整体位置编码如下图所示:
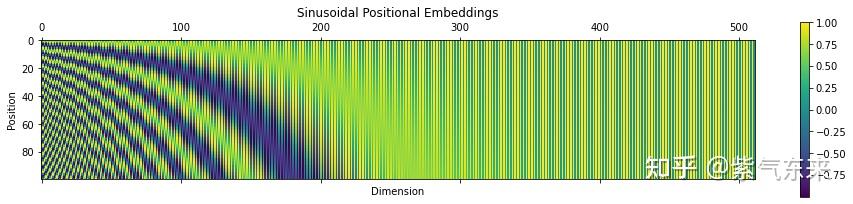 首先研究 Sinusoidal 位置编码与位置 之间的关系,绘制不同维度下,函数值与位置的关系。其曲线如下图所示, 可以从图中得到几点结论:
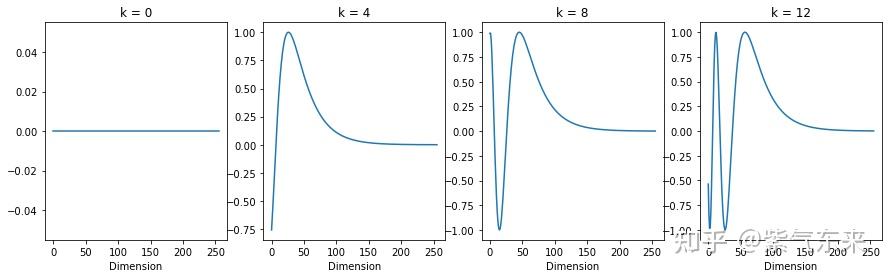 位置编码值在维度偶分量下与位置的关系
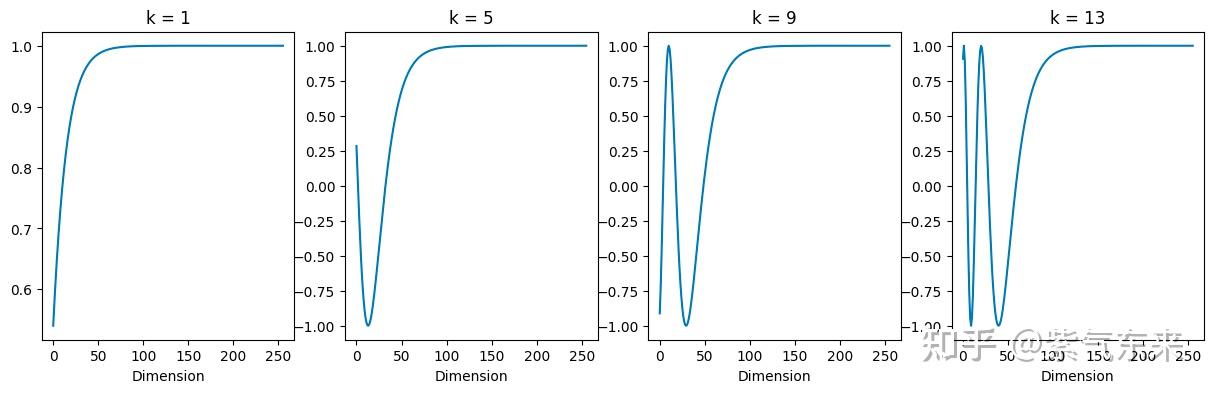 位置编码值在维度奇分量与位置的关系
研究 Sinusoidal 位置编码与维度分量 之间的关系,绘制不同维度分量 i 下,函数值与位置的的关系。Sinusoidal位置编码与维度分量的关系如下图所示,可以发现结论如下:
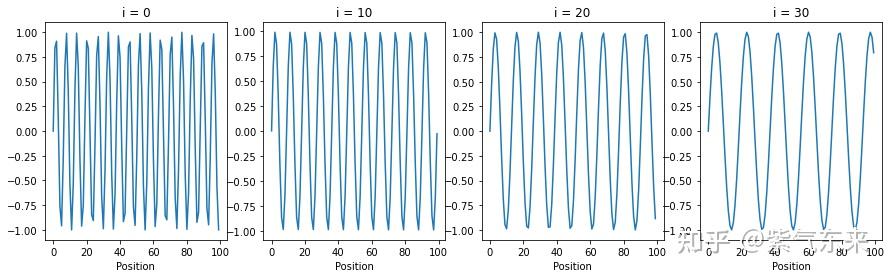 了解了这些基本的特性后,接下来就需要讨论更加深层次的问题:
问题一:为什么用包含各频率的正弦和余弦对?
位置编码存储的是一个包含各频率的正弦和余弦对,这样做有两个好处:
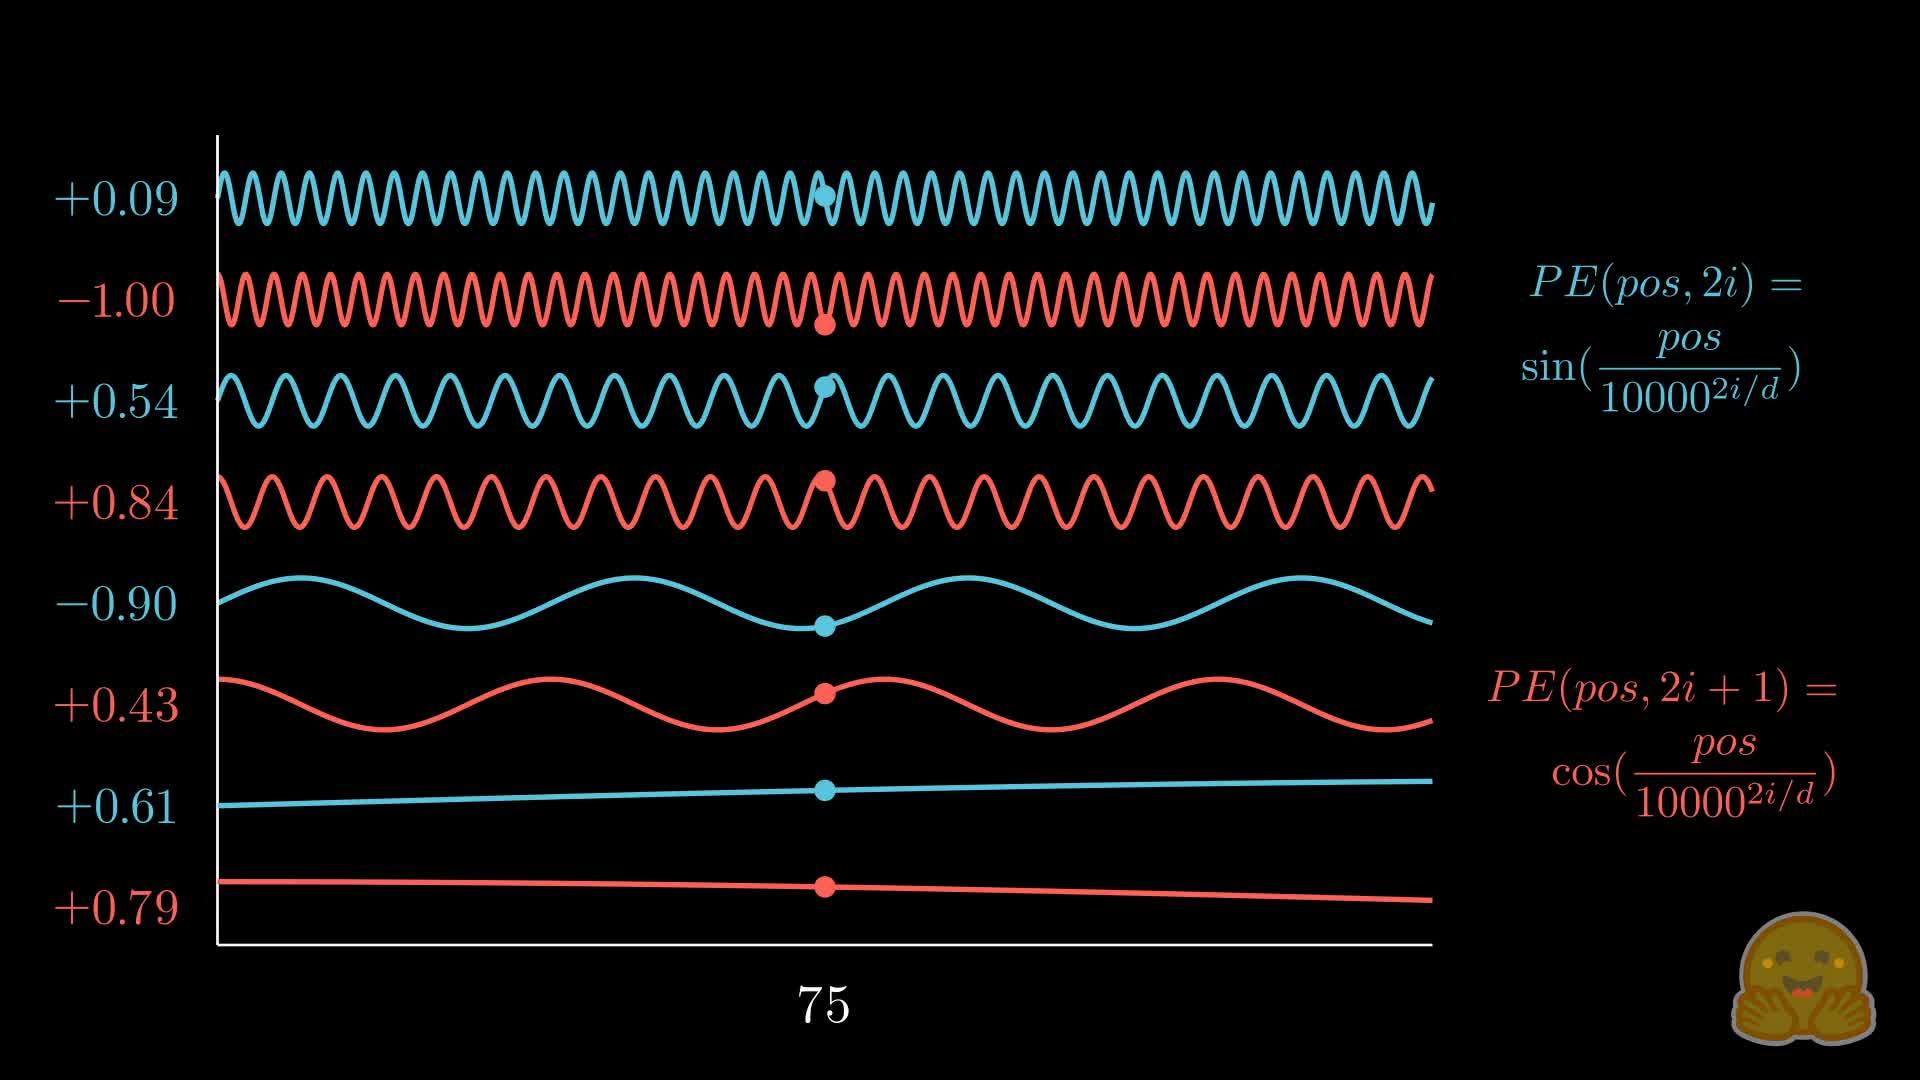 00:11
问题二:底数对结果的影响是什么?
底数越大,位置向量能表示的序列就越长,这是大底数的好处。但是,底数大,意味着在-1到+1的范围内向量的取值越密集,造成两个位置的向量距离越近,这对后续的Self-Attention模块来说是不利的,因为它需要经历更多的训练次数才能准确地找到每个位置的信息,或者说,才能准确地区分不同的位置。长序列需要长编码。但这样又会增加计算量,特别是长编码会影响模型的训练时间。所以,那个底数并非是越大越好。
问题三:Sinusoidal 位置编码如何外推
三角函数式位置编码的特点是有显式的生成规律,因此可以期望于它有一定的外推性。另外一个使用它的理由是:由于 \sin (\alpha+\beta)=\sin \alpha \cos \beta+\cos \alpha \sin \beta \\ \cos (\alpha+\beta)=\cos \alpha \cos \beta-\sin \alpha \sin \beta \\ 这表明位置 \alpha + \beta 的向量可以表示成位置 \alpha 和位置 \beta 的向量组合,这提供了位置拓展的可能性。
2.1.3 其他的绝对位置编码
如递归式(如 FLOATER)和相乘式(如PENG Bo:中文语言模型研究:(1) 乘性位置编码),因使用较少,在此不予赘述。
相对位置并没有完整建模每个输入的位置信息,而是在算Attention的时候考虑当前位置与被Attention的位置的相对距离,由于自然语言一般更依赖于相对位置,所以相对位置编码通常也有着更好的表现,灵活性也更大。
2.2.1 旋转位置编码 RoPE
实际上 RoPE 的诸多思想来源于 Sinusoidal 位置编码,区别在于 Sinusoidal 位置编码采用和 word embedding 相加的形式,RoPE 则采用了矩阵相乘的形式。
在正式介绍之前,我们需要回顾一下经典的欧拉公式
e^{i \theta}=\cos \theta+i \sin \theta \
其矩阵形式为 \left[\begin{array}{cc} \cos \theta & -\sin \theta \\ \sin \theta & \cos \theta \end{array}\right] 即旋转矩阵 R(\theta) ,这三种表现形式表达了同样的信息,即将二维向量逆时针旋转角度 \theta 。
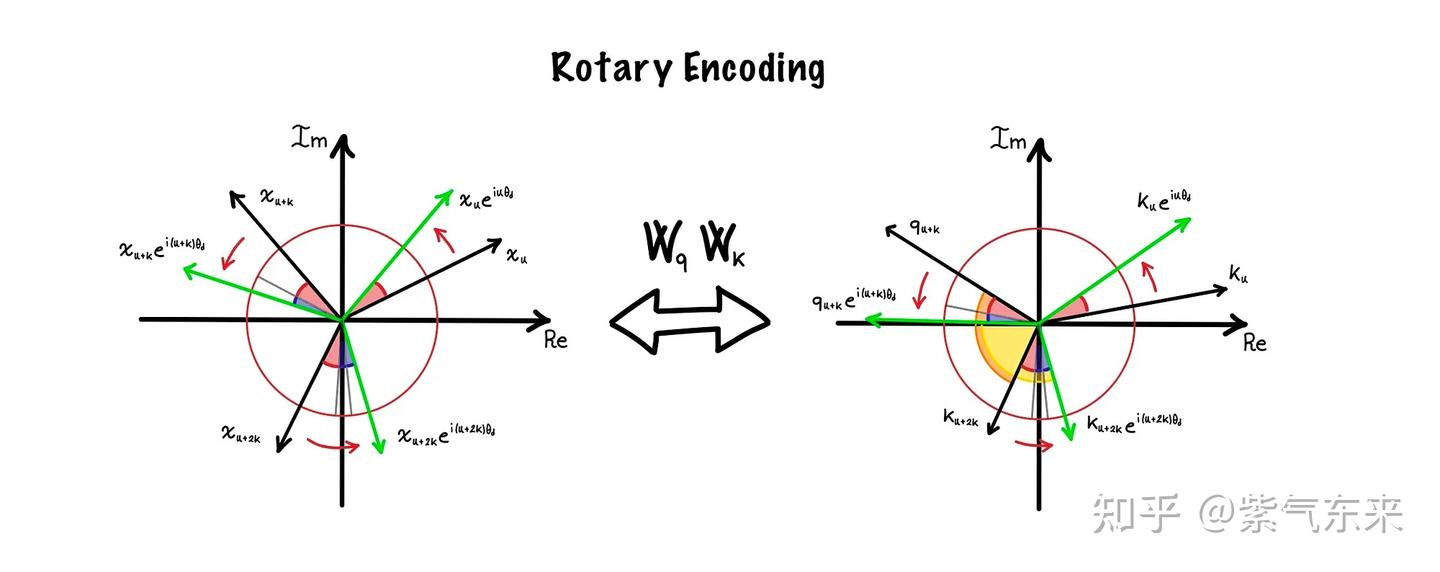 接下来我们直接看 RoPE 的表达式,对于位置为 m 的 q 向量,其表达式为
f(q, m)=R_m q=\left(\begin{array}{cc} \cos m \theta & -\sin m \theta \\ \sin m \theta & \cos m \theta \end{array}\right)\left(\begin{array}{l} q_0 \\ q_1 \end{array}\right) \\即逆时针旋转了 m \theta 度,如上图右所示。同理,位置为 n 的 k 向量的表达式为
f(k, n)=R_n k=\left(\begin{array}{cc} \cos n \theta & -\sin n \theta \\ \sin n \theta & \cos n \theta \end{array}\right)\left(\begin{array}{l} k_0 \\ k_1 \end{array}\right) \
那么便可以通过点积,计算二者的 attention 值
\begin{aligned} & q_m \cdot k_n=f(q, m) \cdot f(k, n)=\left(R_m q\right)^T *\left(R_n k\right)=q^T R_m^T * R_n k \\ & =q^T\left[\begin{array}{cc} \cos m \theta & -\sin m \theta \\ \sin m \theta & \cos m \theta \end{array}\right]^T *\left[\begin{array}{cc} \cos n \theta & -\sin n \theta \\ \sin n \theta & \cos n \theta \end{array}\right] k \\ & =q^T\left[\begin{array}{cc} \cos m \theta & \sin m \theta \\ -\sin m \theta & \cos m \theta \end{array}\right] *\left[\begin{array}{cc} \cos n \theta & -\sin n \theta \\ \sin n \theta & \cos n \theta \end{array}\right] k \\ & =q^T\left[\begin{array}{cc} \cos n \theta \cos m \theta+\sin n \theta \sin m \theta & \sin m \theta \cos n \theta-\sin n \theta \cos m \theta \\ \sin n \theta \cos m \theta-\sin m \theta \cos n \theta & \cos n \theta \cos m \theta+\sin n \theta \sin m \theta \end{array}\right] k \\ & =q^T\left[\begin{array}{cc} \cos (n-m) \theta & -\sin (n-m) \theta \\ \sin (n-m) \theta & \cos (n-m) \theta \end{array}\right] k \\ & =q^T R_{n-m} k \end{aligned}\\ 在极坐标表示下,可以更简单推导出以上结果,即 \begin{aligned} q_m \cdot k_n &=f(q, m) \cdot f(k, n)=\left(R_m q\right)^T *\left(R_n k\right) \\ &=q^T R_m^T * R_n k \\ &= q^T e^{-im\theta_d} * e^{in\theta_d}R_n k\\ &=q^T e^{i(n-m)\theta_d}R_n k\\ & =q^T R_{n-m} k \end{aligned}\\ 即证明了相对位置关系,即旋转前的 attention 值与旋转后的 attention 值的差值仅与相对位置有关。这一点也可以从上图右中看出来,即旋转前 q_{u+k}, k_{u+2k} 的夹角(橙色区域) 与旋转后 q_{u+k}e^{i(u+k)\theta d}, k{u+2k}e^{i(u+2k)\theta d} 的夹角(黄色区域) 相同,即内积也相同。
这时我们就可以写出位置为 m 的 q 的完整的变换矩阵,即
\left(\begin{array}{ccccccc} \cos m \theta_0 & -\sin m \theta_0 & 0 & 0 & \cdots & 0 & 0 \\ \sin m \theta_0 & \cos m \theta_0 & 0 & 0 & \cdots & 0 & 0 \\ 0 & 0 & \cos m \theta_1 & -\sin m \theta_1 & \cdots & 0 & 0 \\ 0 & 0 & \sin m \theta_1 & \cos m \theta_1 & \cdots & 0 & 0 \\ \vdots & \vdots & \vdots & \vdots & \ddots & \vdots & \vdots \\ 0 & 0 & 0 & 0 & \cdots & \cos m \theta{d / 2-1} & -\sin m \theta_{d / 2-1} \\ 0 & 0 & 0 & 0 & \cdots & \sin m \theta_{d / 2-1} & \cos m \theta_{d / 2-1 }\end{array}\right)\left(\begin{array}{c} q_0 \\ q_1 \\ q_2 \\ q_3 \\ \vdots \\ q_{d-2} \\ q_{d-1} \end{array}\right)
从改变换矩阵也能看出,随着维度增加,旋转角度也在指数级减小,如下图所示。RoPE 的这一功能使模型可以通过从低维度到更高维度,将嵌入中编码的信息类型从低频(close)转变为高频(far)。
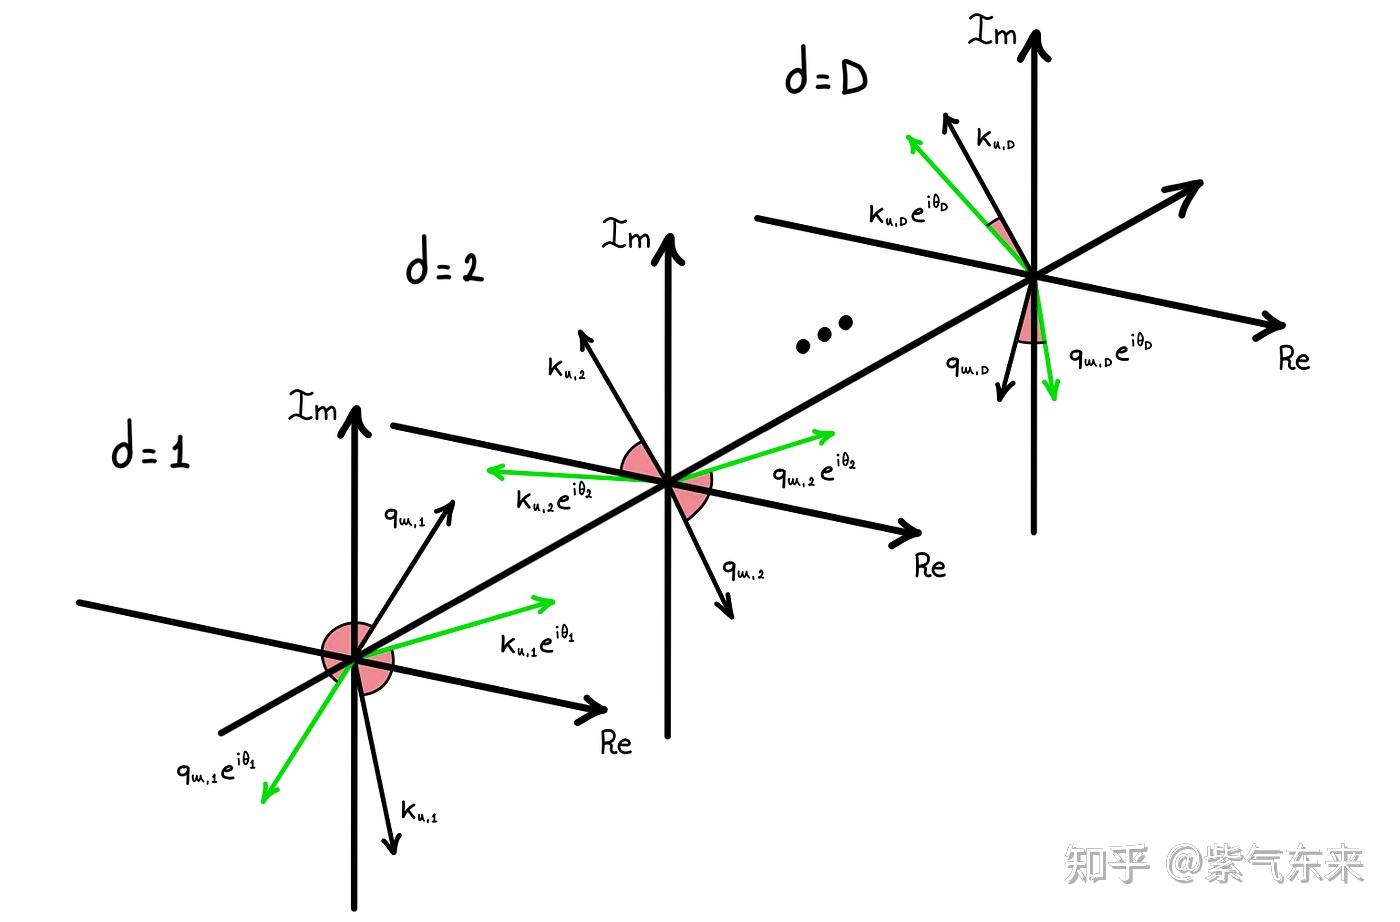 旋转角度随维度的变化
2.2.2 远程衰减问题
由于 RoPE 中的 attention 值除了 q,k 本身外,仅和 R_{n-m} 因子相关,那么下面考察 R_{n-m} 因子的特点
\begin{aligned} \left\langle\boldsymbol{p}{\mathrm{m}}, \boldsymbol{p}{\mathrm{n}}\right\rangle & =\operatorname{Re}\left[\mathrm{e}^{\mathrm{i}(\mathrm{m}-\mathrm{n}) \theta_0}+\mathrm{e}^{\mathrm{i}(\mathrm{m}-\mathrm{n}) \theta_1}+\cdots+\mathrm{e}^{\mathrm{i}(\mathrm{m}-\mathrm{n}) \theta_{\mathrm{d} / 2-1}}\right] \\ & =\frac{\mathrm{d}}{2} \cdot \operatorname{Re}\left[\sum_{\mathrm{i}=0}^{\mathrm{d} / 2-1} \mathrm{e}^{\mathrm{i}(\mathrm{m}-\mathrm{n}) 10000^{-\mathrm{i} / \mathrm{d} / 2)}} \frac{1}{\mathrm{~d} / 2}\right] \\ & \approx \frac{\mathrm{d}}{2} \cdot \operatorname{Re}\left[\int_0^1 \mathrm{e}^{\mathrm{i}(\mathrm{m}-\mathrm{n}) \cdot 10000^{-\mathrm{t}} \mathrm{dt}}\right] \end{aligned} \\ 那么问题就变成了积分 \int_0^1 \mathrm{e}^{\mathrm{i}(\mathrm{m}-\mathrm{n}) \cdot 10000^{-\mathrm{t}} }\mathrm{dt} 的渐进估计问题,通过一下函数计算积分值与位置距离的关系,并分析不同 base 值的影响。
下图展示了不同距离尺度上不同 base 值的积分结果,可以得到以下结论:
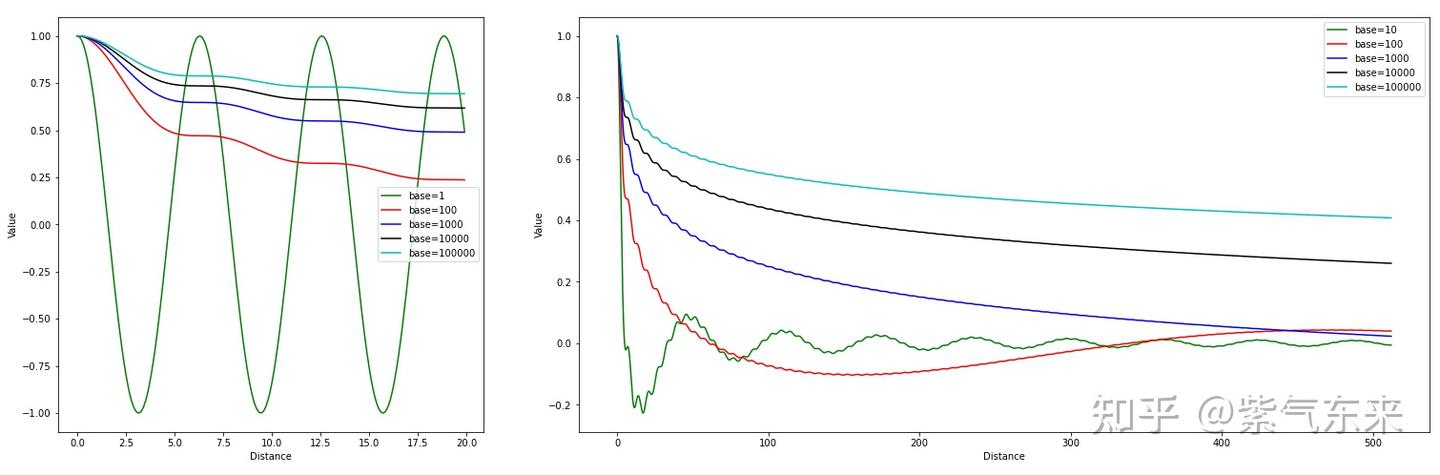 不同距离尺度上的积分结果
2.2.3 RoPE 长度的内插与外推
长度外推性是一个训练和预测的长度不一致的问题。提现有两点:
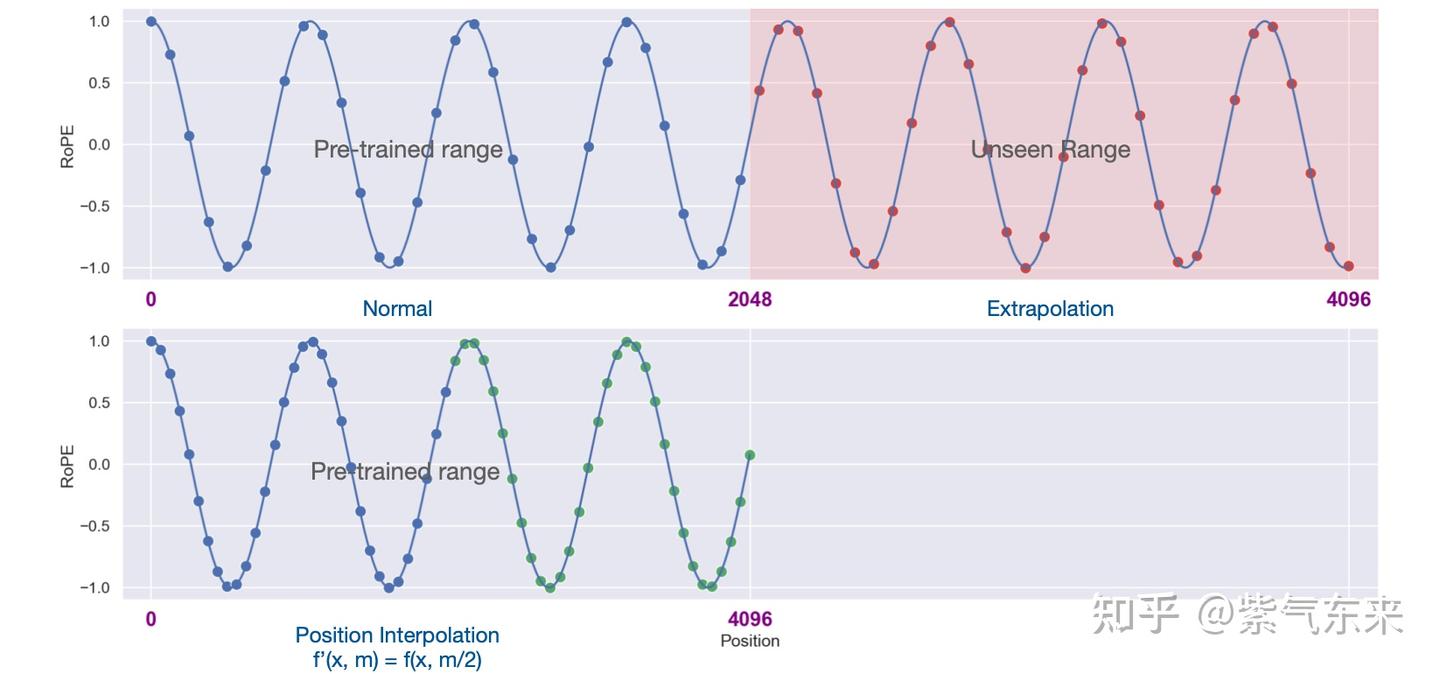
一旦我们在模型中有效地整合了相对位置信息,增加 LLM 上下文窗口的最直接方法就是通过位置插值 (position interpolation,PI) 进行微调。
这种方法实现很简单,如果希望将预训练阶段的位置向量范围[0,2048] 外推到[0,4096],只需要将对应位置缩放到原先支持的区间([0,2048])内:计算公式如下,L为原先支持的长度(如2048),L^{'}为需要扩展的长度(如4096):
f^{'}(x,m)=f(x, \frac{mL}{L^{'}}) \
其过程如下图所示:
 下面分析一下以上操作的本质,经过这种放缩操作后,位置为 m 的 维度为 i 的旋转角变为 \frac{mL}{L^{'}}* base^{-2 \mathrm{i} / \mathrm{d}} ,即线性减小了旋转弧度,如下图第一列的上图所示(横轴为位置编码,纵轴为旋转弧度)。通过这种方式插值后,向量旋转速度变慢,周期变大,频率变慢。
除了上述的这种差值方式外,还有以下改进方式可以实现外推:
这种方式把旋转角修改为 m* (base*\alpha)^{-2 \mathrm{i} / \mathrm{d}} ,其中 \alpha 表示 base 的缩放因子,在 codellama 中取值为 100 。其修改的方式如下图第二列下图所示(横轴为维度,纵轴为旋转角),在不同维度上修改的程度不同。这种方式保留了高频信息,即
这是因为靠前的维度,在训练中见过非常多完整的旋转周期,位置信息得到了充分的训练,所以具有较强的外推能力。靠后的维度,在训练中无法见到完整的旋转周期,或者见到的旋转周期非常少,训练不够充分,外推性能弱,需要进行位置插值。
该方法是基于 NTK-Aware 的优化,其核心思想是:不改变高频部分,仅缩小低频部分的旋转弧度 。即不改变小维度的旋转弧度,仅减小大维度的旋转弧度,这就是by-patrs的含义。
第 i 个维度的旋转周期为: \lambda_i=\frac{2 \pi}{\theta_i}=2 \pi * {ba s e} ^{2 i / d}
其在训练长度内旋转的周期个数如下: r_i=\frac{L}{\lambda_i}
引入超参数 \alpha,\beta ,表示旋转周期个数的约束条件,定义斜坡函数
\gamma(r_i)= \begin{cases}0, & \text { if } r_i<\alpha \\ 1, & \text { if } r_i>\beta \\ \frac{r_i-\alpha}{\beta-\alpha}, & \text { otherwise }\end{cases} \
当 r_i < \alpha ,旋转周期数量少,则为低频分组,仅进行线性插值。
当 \alpha \leq r_i \leq \beta , 选择周期介于二者之间,类似于“NTK-aware”插值
当 r_i > \beta ,旋转周期数量足够多,则认为该维度为高频部分,无需改变。
综合以上条件,调整后的旋转角可以表示为 h\left(\theta_i\right)=(1-\gamma(r_i)) \frac{\theta_i}{s}+\gamma(r_i) \theta_i
其中 s=\frac{L'}{L} , 超参数的经验取值为 \alpha=1,\beta=32
这是是一种动态插值的方法:当推理长度小于等于训练长度时,不进行插值;推理长度大于训练长度时,每一步都通过NTK-Aware Interpolation动态放大base。
l 表示当前的序列长度, L 表示模型训练长度,
当 l\leq L 时,不调整旋转角
当 l> L 时,旋转角调整为 m* (base*\alpha)^{-2 \mathrm{i} / \mathrm{d}} ,其中 \alpha = (\frac{l}{L})^{d/(d-2)}
需要说明的是下图最后一列下图的粗线表示一个范围,未体现出与长度的动态联动。
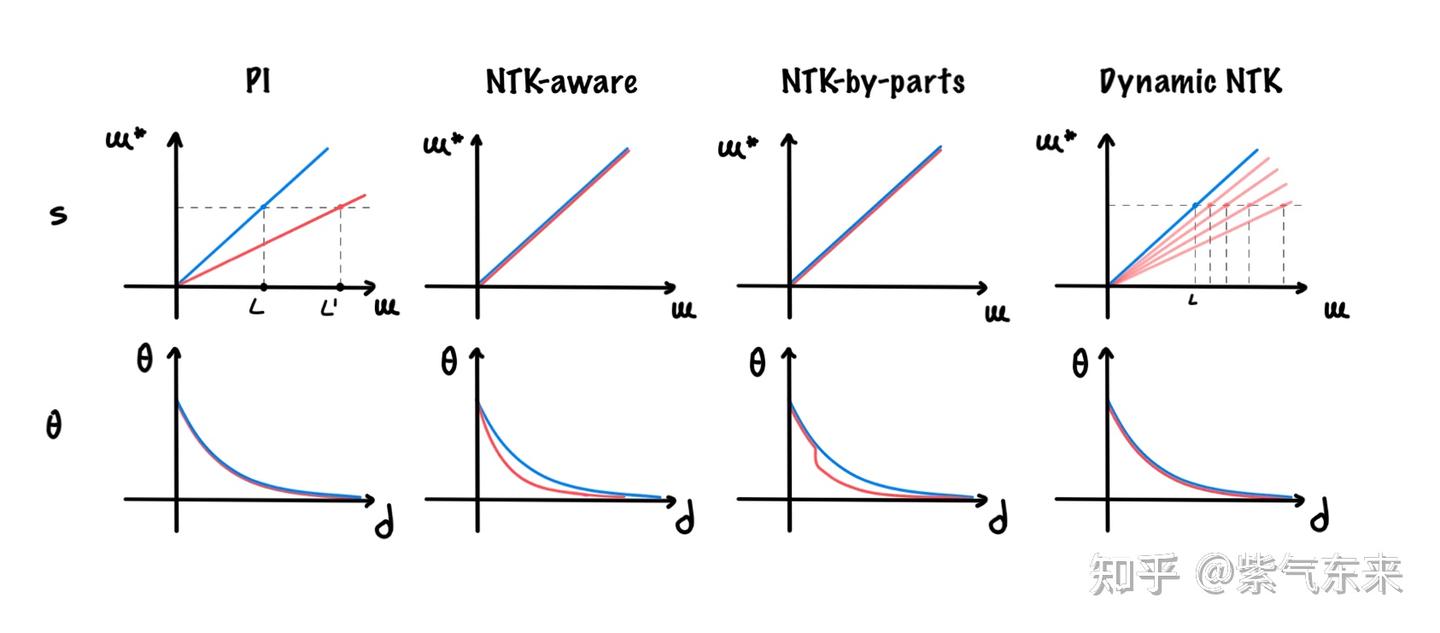 PI 及其改进方案
无论是PI还是NTK类方法,本质都是通过减小旋转弧度,降低旋转速度,来达到长度扩展的目的。这将导致位置之间的旋转弧度差距变小,词向量之间的距离变得比原来更近,词向量之间的点乘变大,破坏模型原始的注意力分布。所以经过插值之后,模型在原来的训练长度内的困惑度均有所提升,性能受损。
YaRN本质上是NTK-by-parts Interpolation与注意力分布修正策略的结合,仅缩小低频部分的旋转弧度,且通过温度系数修正注意力分布。只需将原来的注意力分数除以温度 t 即可。\frac{\mathbf{q}_m^T \mathbf{k}_n}{\sqrt{|d|}} \rightarrow \frac{\mathbf{q}_m^T \mathbf{k}_n}{t \sqrt{|d|}},~~~~~where ~~\sqrt{\frac{1}{t}}=0.1*\mathrm{ln}\left(\frac{L^{'}}{L}\right)+1 \
以LLaMA为例,当长度从2048扩展至16384时,长度扩展为原来的8倍,代入公式,计算得到t=0.6853。回顾温度系数对注意力分布的影响,当t变大,注意力分布更加平滑,方差更小;当t变小,注意力分布更加尖锐,区分度变大,方差变大。t=0.6853 意味着缓解注意力分布过于平滑的问题,让注意力分布方差更大。
需要说明的是,论文 Scaling Laws of RoPE-based Extrapolation 中深入研究了 RoPE 位置编码的特性,其结论就是:RoPE 中 base 的放大和缩小都能获得很好的外推效果(base=10K 效果最差)。原因在于:
2.2.4 其他形式的编码方式及其外推
在苏神的文章Transformer升级之路:12、无限外推的ReRoPE?中指出:RoPE 形式上是一种绝对位置编码,但实际上给 Attention 带来的是相对位置信息,即如下的Toeplitz矩阵:
\left(\begin{array}{ccccccccc} 0 & & & & & & & & \\ 1 & 0 & & & & & & & \\ 2 & 1 & 0 & & & & & & \\ 3 & 2 & 1 & 0 & & & & & \\ \ddots & 3 & 2 & 1 & 0 & & & & \\ \ddots & \ddots & 3 & 2 & 1 & 0 & & & \\ \ddots & \ddots & \ddots & \ddots & \ddots & \ddots & \ddots & & \\ L-2 & \ddots & \ddots & \ddots & \ddots & \ddots & \ddots & \ddots & \\ L-1 & L-2 & \ddots & \ddots & \ddots & 3 & 2 & 1 & 0 \end{array}\right) \\ 这么这种形式的 bias 似乎有种似曾相识的感觉,没错,就是 ALiBi 编码。严格来说,ALiBi 并不算位置编码,因为它并没有作用在 embedding 上,而是直接作用在了 Attention 上,通过这种构造方式既实现了远程衰减,又实现了位置的相对关系。
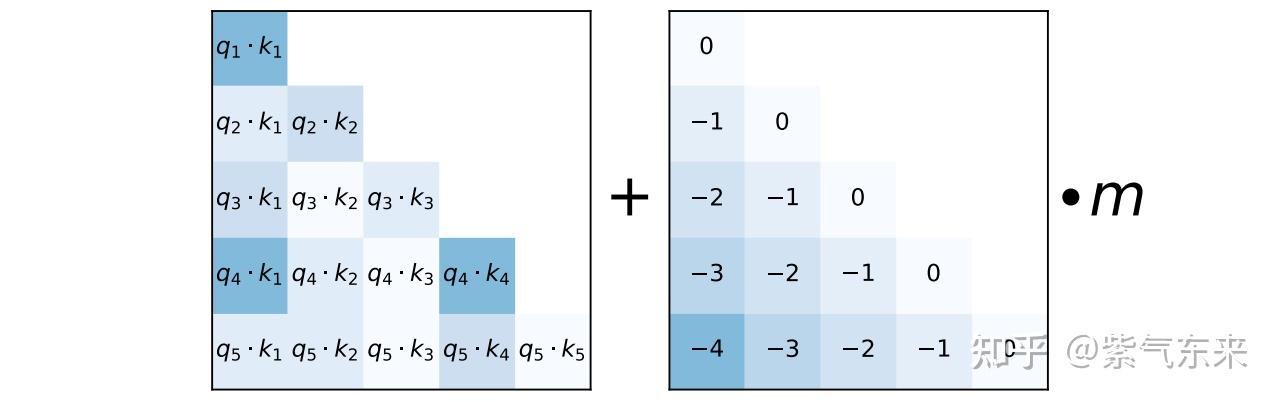 ALiBi 的作用原理
对于外推特性,ALiBi 与前文所述的方法也是不同的,体现在:
Attention 机制也是制约长文本实现的重要因素,以下是几种典型的 Attention 的 方式:
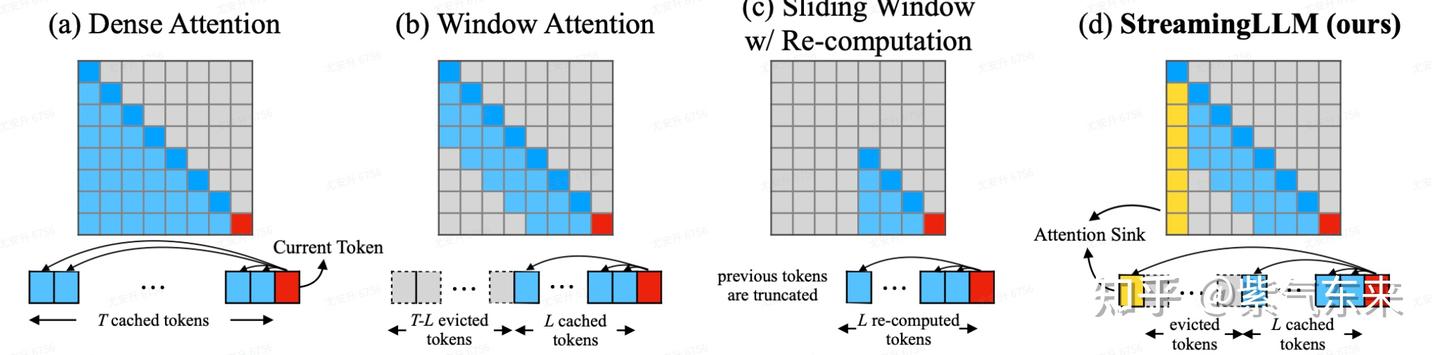 关于 Attention 机制改进的更多类型和细节,笔者在之前的文章中已经有所讨论,可参考:
在此主要想介绍一个方案 —— LongLora 。
回顾第一节中研究的结论,长文本影响最大的就是 self-attention 中的,随长度二次变化的显存占用和计算复杂度。为解决这个问题,LongLora 的原则是,虽然在推理过程中需要密集的全局注意力,但通过稀疏的局部注意力可以有效且高效地微调模型。
LongLora 在微调期间延长上下文长度,同时使用 Lora 方法保持高性能和低复杂性。其中最关键的是提出了转移短注意力(S2-Attn) 方案。下面简要介绍这一方案:
S2-Attn 在微调阶段使用局部注意力而不是全局注意力。即将输入文档分解为几个不同的组,并在每个组中分别应用注意力机制(Pattern 1)。尽管这种方式能够在资源占用不多的情况下拓展长度,由于不同组之间缺乏信息交换,随着上下文长度的增加,会导致混乱增加。
为了解决上述问题,S2-Attn 引入了组大小一半的移位操作,确保相邻组之间顺利的信息交换(Pattern 2)。这种做法有助于模型在文本开头和结尾之间顺利交换信息,从而提高模型稳定性。
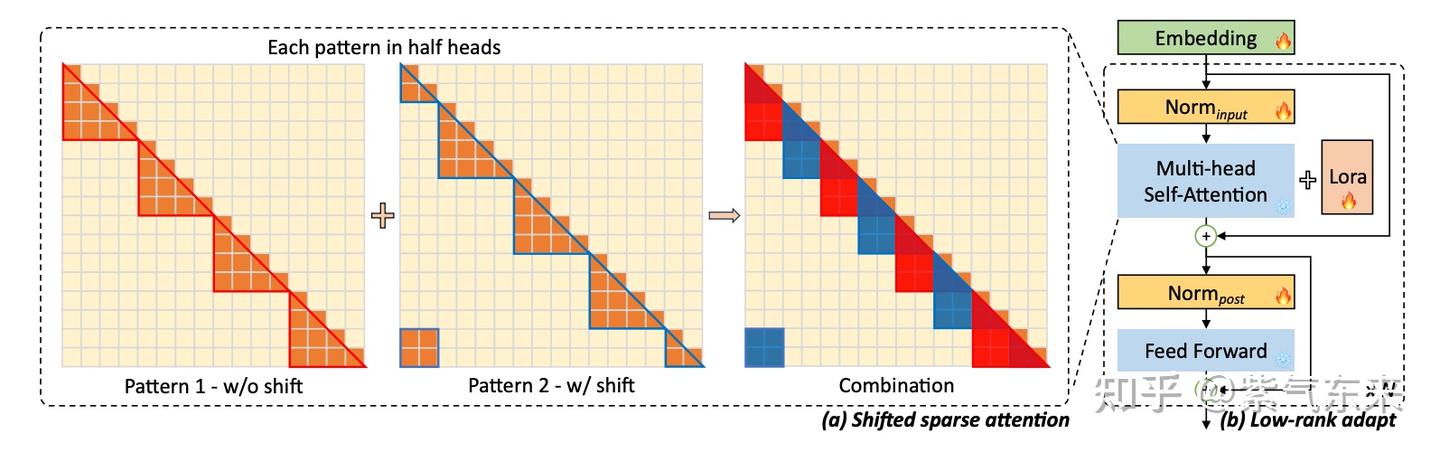 LongLora 整体框架
而本文提出的 shift short attention 有一半的 head 会被做 shift,如下图所示,然后每个 group 内作 self-attention,从而使信息可以在不同 group 间传递。这种做法实际上将 Pattern 1 和 Pattern 2 结合起来,而没有引入额外的计算开销,使其非常适合高效处理长序列文本。
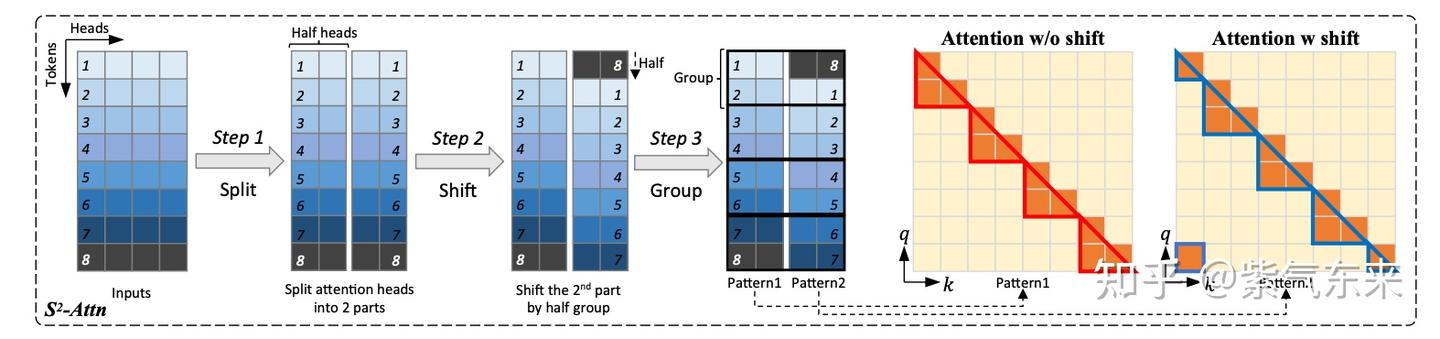 shift short attention 原理
此外,LongLoRA相比于Lora还可以微调embedding层和normalization层。尽管这两项内容占的参数量很小(以Llama 2-7B为例,embedding层只占1.94%,normalization层更是不到十万分之四),对结果也起到了重要作用。
上两节主要介绍了如何在位置编码和 attention 机制方面进行文本长度的有效拓展,这两个方面都是“经济适用性”的,即只需要简单微调或者直接外推即可,接下来将是最困难,也是成本最高的部分,即讨论如何在预训练阶段提高文本长度。 为解决预训练过程中的长文本问题,思路主要有以下几个方面:
由于笔者精力有限,下面仅选取其中部分方法加以介绍。
在并行化算法大行其道的今天,使用改思想来解决长文本问题变得自然而言,实际上 SP 已逐渐成为 3D(DP, PP, TP)并行之外的第 4 个维度了。关于序列并行,笔者在以下文中进行过详细讨论
在此仅介绍最简单的一种做法,SP 就是将一段完整的文本拆分到多个设备上进行计算,设备在适当的时候进行通信和信息交互,如下图(c) 所示。
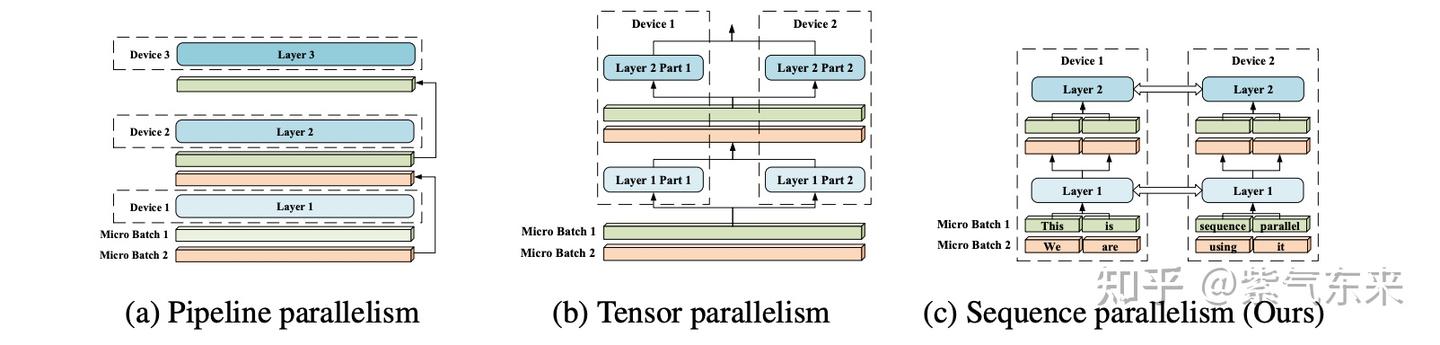 在实现层面,借鉴了 Ring-Allreduce 的思想,将输入序列分割成多个块,并将每个块输入到其相应的设备中。为了计算注意力输出,将环状通信与自注意力计算相结合,实现了环自注意力(RSA),如下图所示。
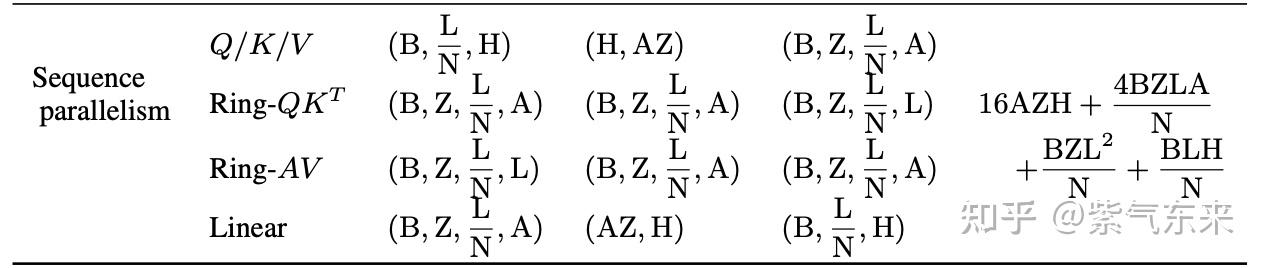
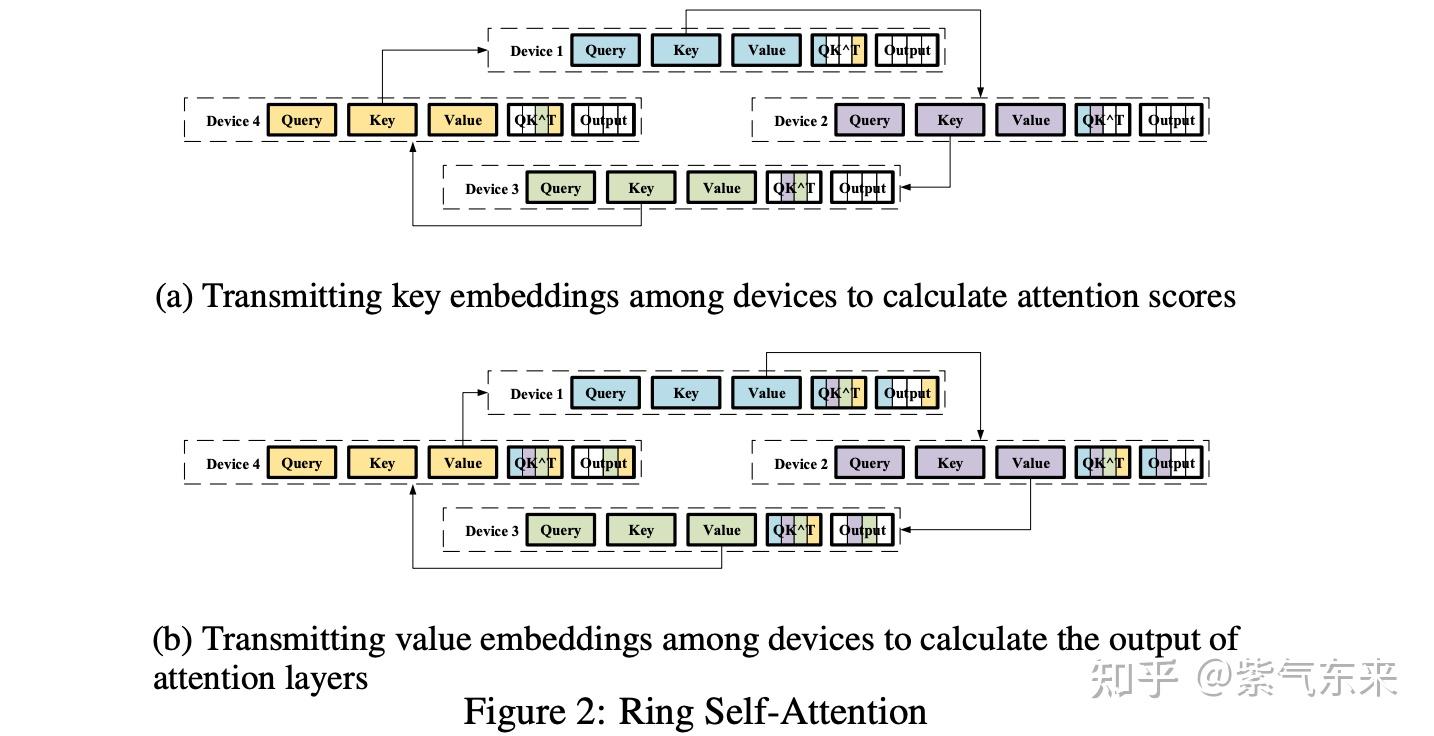 下面我们来深度理解一下这个过程,论文中的符号表示为
对于 Ring-Q K^\top :[B,Z,\frac{L}{N},A] \times [B,Z,A,\frac{L}{N}] \rightarrow (all-gather)[B,Z,\frac{L}{N},L] ,
切分后的每一个小块 \frac{L}{N} ,在和 k^{T} 矩阵乘后得到 [\frac{L}{N}, \frac{L}{N}] 需要在切分维度做补全才可以得到每一个小块 \frac{L}{N} 的完整结果,在后续进行 softmax 操作。故需要做 ring 操作达到一个 concat 的操作。
对于 Ring-AV : B,Z,\frac{L}{N},L \times [B,Z,\frac{L}{N},A] \rightarrow [B,Z,\frac{L}{N},A] ,
需要完整对 softmax 结果进行 value 查询,需要对 [B,Z,\frac{L}{N},L] 根据序列并行度进行分块,用对应的块在对应的 value 上查询并求和,故也需要做 ring 操作。
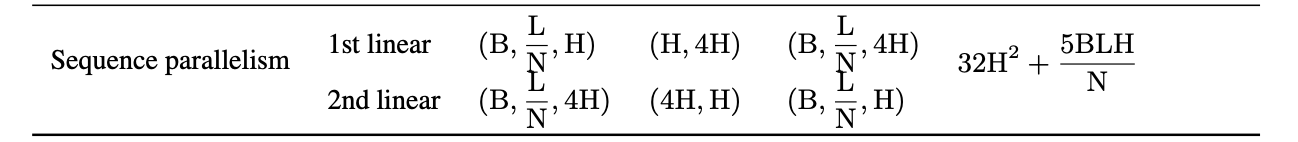
 MLP 部分的计算就更简单了,如下所示:
LongLLaMA 通过引入 Focused Transformer(FOT)方法,在保持性能的同时,将 LLaMA 的上下文长度扩展到100k!在长文本的情况下,除了第一节所研究的显存和计算量的问题外,这篇论文还提出了一个分心问题(Distraction Issue),即随着文本长度的增加,其中相关的 tokens 对不相关 tokens 的比例会减少,从而导致与不相关 value 相关的 key 和与相关 value 相关的 key 发生重叠,致使模型需要额外区分不同语义的 key 。
为此文章提出了 Focused Transformer (FOT)解决方案,其中主要使用了 Memory Attention Layers 以及 CrossBatch 技术,在 Inference 的过程中,绿色的 Memory Attention Layers 使用 kNN 对外部的 Memory 进行查询,从而有效延长了上下文长度,而 Memory Attention Layers 则主要使用 CrossBatch 进行训练。
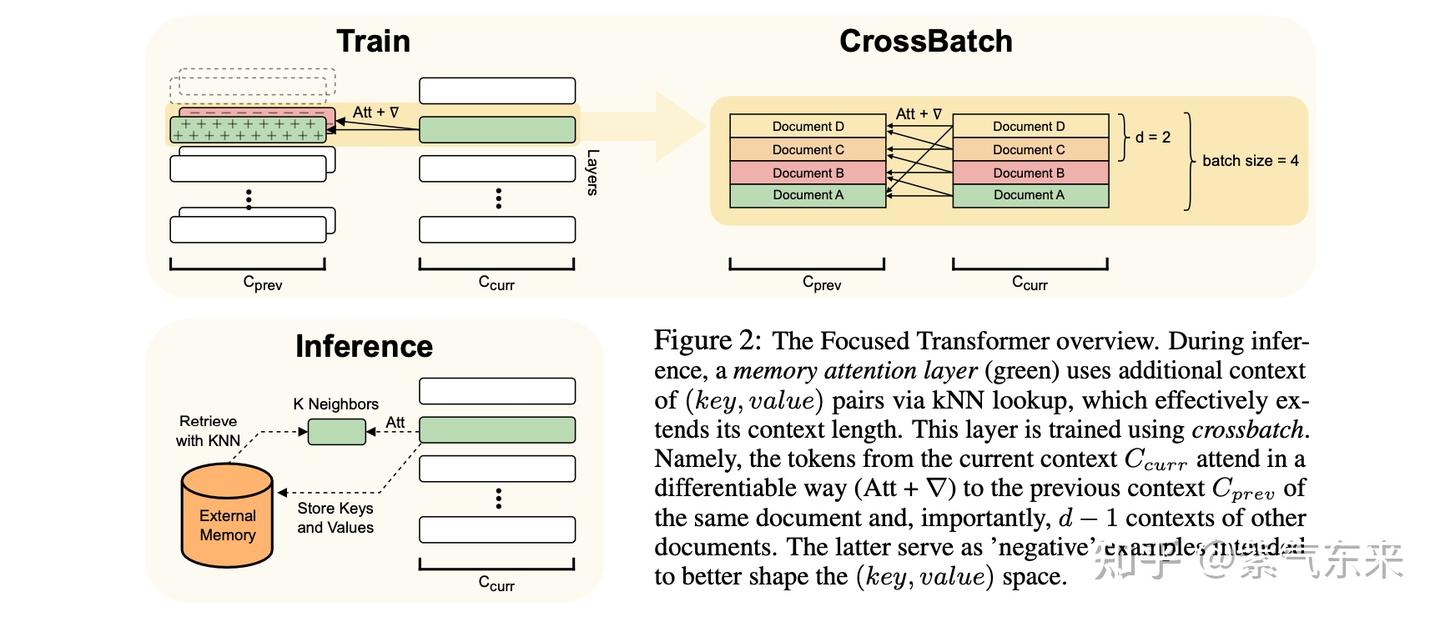 具体而言,Memory Attention Layers 中的每个 query 在 \in 中会关注局部的上下文以及 Memory 中使用 kNN 计算出的最匹配的 k 个key,而整个 Memory 则根据 之前处理的 key,value 进行填充。而 CrossBatch 则期望使得 Memory Attention Layers 更加关注长文本之中的“相关 value 的 key” ,CrossBatch 的处理借鉴了对比学习的思想,以相关文档之中的 d-1 个上下文作为正样本,以不相关文档之中的 d-1 个上下文作为负样本,通过对比学习的方式使得 Memory Attention Layers 可以更好的分辨相关与无关的 key-value。
与标准的 Transformer 相比,一般的 Transformer 的训练过程中,相关与不相关文档没有被得到有效区分(正负样本分散均匀),当文档数量扩展时,注意力变得越来越分散,而 Focused Transformer 则通过 CrossBatch 的训练目标使得模型有效的关注与区分的长文本下的相关与无关的 key-value 的空间结构,从而解决了分心的问题。
对于 LLM 来说,其效果通常是通过生成连贯且上下文相关的文本的能力来衡量的。为了量化和衡量这一指标,困惑度 (Perplexity, PPL) 便成了最常见的指标。 PPL 是一种衡量标准,反映模型根据前面的上下文预测下一个单词的能力。PPL 分数越低,模型准确预测下一个单词的能力就越好。 PPL 是使用平均交叉熵计算的,而平均交叉熵又是使用数据集中的单词数量和根据前面的上下文预测的单词(目标单词)的概率来计算的。前面的上下文通常由目标单词之前的固定长度单词序列表示。其公式如下: PPL = e^H 其中H是平均交叉熵, H=-\frac{1}{N} \sum_{i=1}^N \log 2\left(P\left(w_i \mid w_1, w_2, \ldots, w{i-1}\right)\right) PPL 作为一种客观的评估指标被广泛用来进行 LLM 的评估。但是其也存在一些问题和不足:
实际上,StreamingLLM 就很好地证明了 PPL 的局限性,因为尽管 StreamingLLM 的 PPL 值较低,但是由于其损失了大量中间信息,因此无法在“大海捞针”等测试方法中有较好的表现。
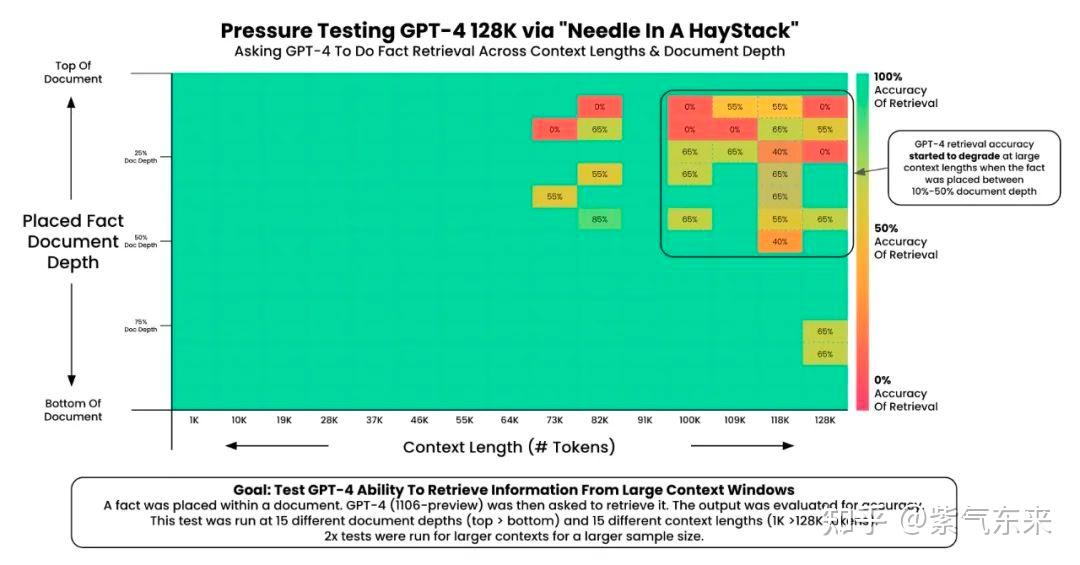
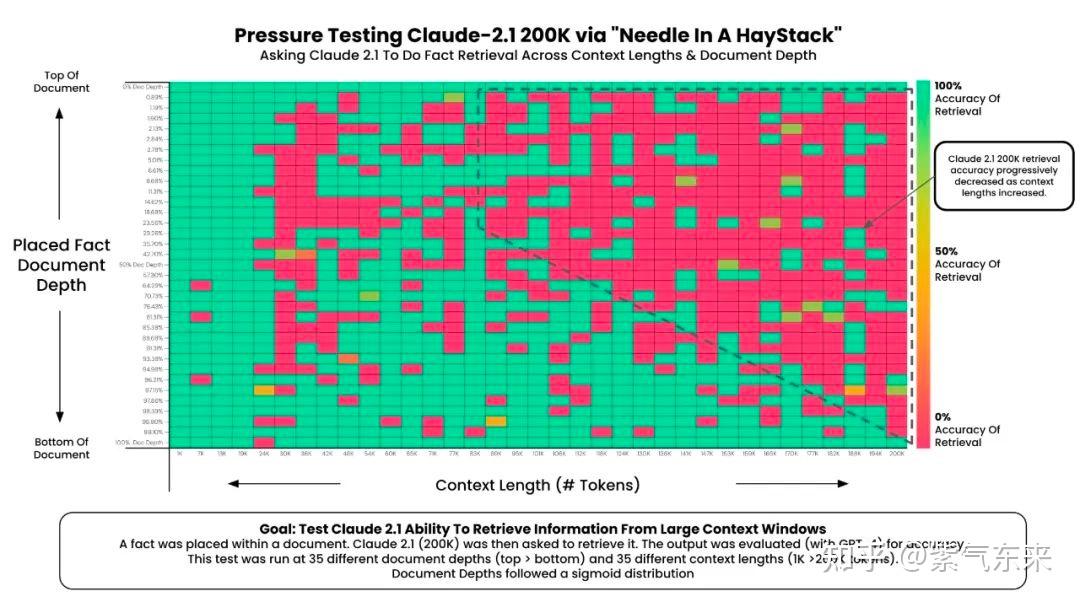
“大海捞针” 由 Greg Kamradt 提出的大模型长文本性能测试方法,其做法是在文本语料中藏入一个与文本语料不相关的句子,然后看大模型能不能通过自然语言提问的方式(Prompt)把这句话准确地提取出来。Greg Kamradt 的“大海捞针”实验简述:
“大海”:Paul Graham 的文章合集作为语料
“针”:“The best thing to do in San Francisco is eat a sandwich and sit in Dolores Park on a sunny day.”
提问:"What is the most fun thing to do in San Francisco based on my context? Don't give information outside the document"
期待模型输出的正确答案:
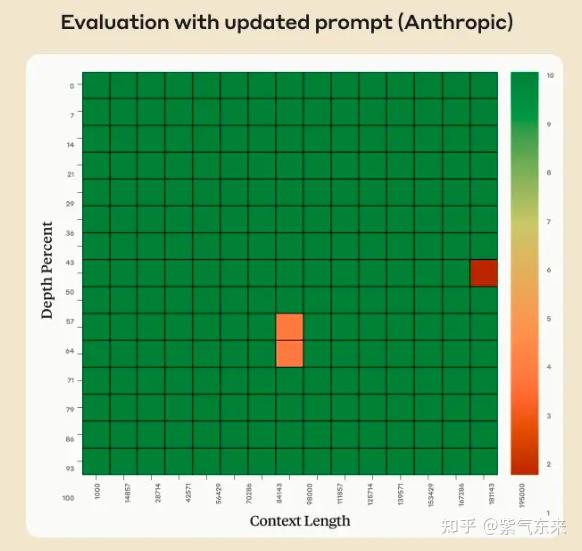
The best thing to do in San Francisco is eat a sandwich and sit in Dolores Park on a sunny day. Greg Kamradt 公布了他对 GPT-4 Turbo(128K)和 Claude 2.1 的测试结果:
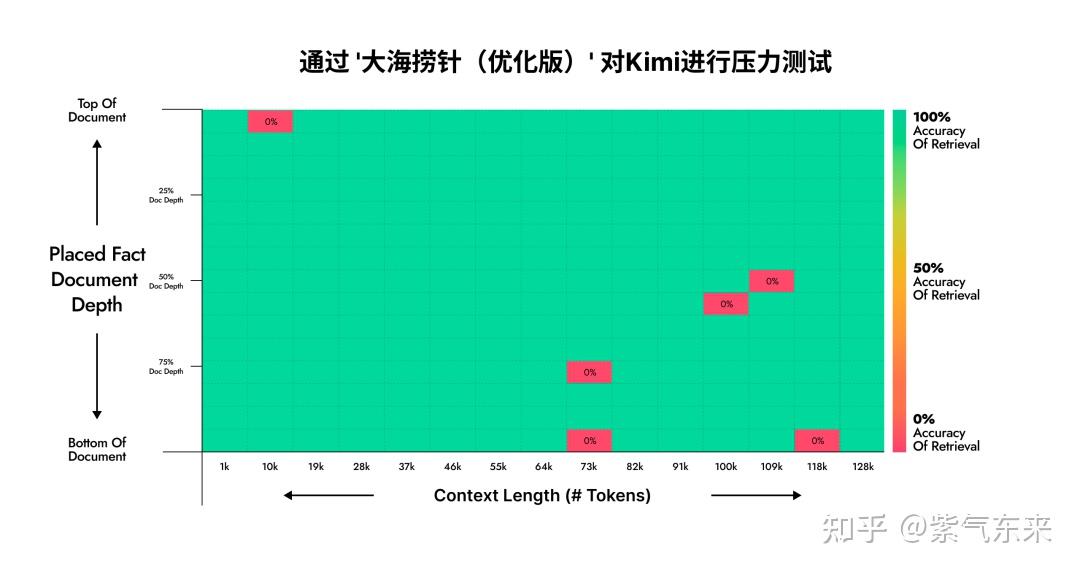
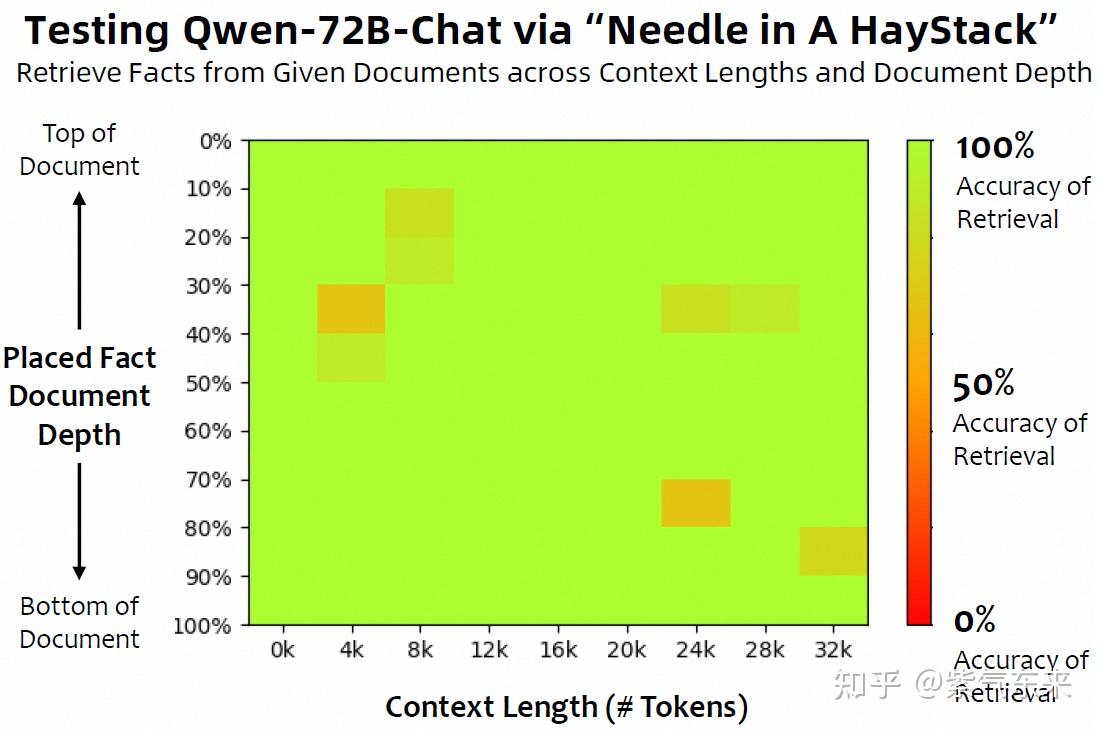
[1] Kimi Chat 公布“大海捞针”长文本压测结果,也搞清楚了这项测试的精髓 (qq.com) [2] 分析transformer模型的参数量、计算量、中间激活、KV cache - 知乎 (zhihu.com) [3] https://medium.com/@ddxzzx/why-and-how-to-achieve-longer-context-windows-for-llms-5f76f8656ea9 [4] 图解RoPE旋转位置编码及其特性 [5] RoPE外推的缩放法则 —— 尝试外推RoPE至1M上下文 - 知乎 (zhihu.com) [6] Transformer升级之路:1、Sinusoidal位置编码追根溯源 - 科学空间|Scientific Spaces [7] 让研究人员绞尽脑汁的Transformer位置编码 - 科学空间|Scientific Spaces [8] 层次分解位置编码,让BERT可以处理超长文本 [9] 理解Transformer的位置编码_51CTO博客_transformer的位置编码 [10] NTK-Aware Scaled RoPE allows LLaMA models to have extended (8k+) context size without any fine-tuning and minimal perplexity degradation. : r/LocalLLaMA (reddit.com) [11] EXTENDING CONTEXT WINDOW OF LARGE LANGUAGE MODELS VIA POSITION INTERPOLATION [12] 详解基于调整RoPE旋转角度的大模型长度外推方法 (qq.com) [13] Transformer升级之路:15、Key归一化助力长度外推 - 科学空间|Scientific Spaces [14] 2309.12307.pdf (arxiv.org) [15] GitHub - dvlab-research/LongLoRA: Code and documents of LongLoRA and LongAlpaca [16] 大模型分布式训练并行技术(五)-序列并行 (qq.com) [17] 羊驼再度进化,“长颈鹿版”LongLLaMA 来啦,上下文长度冲向 100K ,性能不减 [18] https://twitter.com/GregKamradt/status/1727018183608193393 [19] LLaMA长度外推高性价比trick:线性插值法及相关改进源码阅读及相关记录 [20] Length Extrapolation of Transformers: A Survey from the Perspective of Position Encoding
况属高风晚,山山黄叶飞。 —— 王勃《山中》 编辑于 2025-06-22 06:08・上海 LLM GPT-4 Llama 2 赞同 44328 条评论715 63 分享 申请转载
未登录用户
28 条评论
默认
最新
 余沾
计算量跟token数相关,不就等于跟文本长度相关吗,为什么说跟文本长度不相关呢
2024-04-04 · 广东
回复5
 紫气东来
作者
 这个非决定性影响是针对计算预算而言的哈
2024-04-04 · 上海
回复喜欢
展开其他 1 条回复
 WhatABurger
你好 想请教一下:统计计算量的部分 第一步计算QKV为什么不用考虑词表大小呢? 第二、三步的矩阵维度变换可以再稍微解释下吗? 另外后向计算量是前向的两倍,是因为adam引入两个额外参数的原因吗?感谢🙏
2023-12-29 · 北京
回复2
 紫气东来
作者
1.词表大小与QKV 的计算无关,相关的只是 hidden_size
2.关于反向和前向的计算量的关系可参考回旋托马斯x:浅谈后向传递的计算量大约是前向传递的两倍
2024-01-10 · 上海
回复2
 可爱啊
算QKV激活值时,显存怎么还*2了
2025-06-02 · 北京
回复喜欢
展开其他 1 条回复
 深度眸
 写的很好
2024-11-02 · 上海
回复喜欢
jack
问题二:底数对结果的影响是什么? 这里的底数是指哪个?
2024-07-26 · 北京
回复喜欢
紫气东来
作者
base
2024-07-26 · 上海
回复喜欢
 jack
如下图第一列的上图所示....这是个什么图?
2024-07-25 · 辽宁
回复喜欢
 HERODING23
“高频分量旋转速度降幅低,低频分量旋转速度降幅高”是不是写反了?
2024-05-21 · 上海
回复喜欢
紫气东来
作者
没写反哈,你可以结合 NTK-by-part 再理解一下
2024-05-21 · 上海
回复喜欢
展开其他 2 条回复
 Xi Wang
1.1.2里面为啥都要乘2
2024-05-11 · 广东
回复喜欢
紫气东来
作者
矩阵运算包含乘、加两部分哈,更多可参考 紫气东来:CUDA(三):通用矩阵乘法:从入门到熟练
2024-05-21 · 上海
回复1
展开其他 1 条回复
 易二三
请问2.2.3节的f'(x, m)公式体现在代码中是如何改呢,比如LlamaRotaryEmbedding,原始max_position_embeddings=2048,我想扩展到16k,只把这个参数改成16k然后准备相应的数据进行微调就算是通过位置插值(PI)在增加 LLM 上下文窗口吗?
2024-01-08 · 北京
回复喜欢
 紫气东来
作者
线性插值的代码实现可以参考以下代码哈:
class LlamaLinearScaledRotaryEmbedding(torch.nn.Module):
def init(self, dim, max_position_embeddings=2048, base=10000, scale=1, device=None):
super().init()
self.scale = scale
inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float().to(device) / dim))
self.register_buffer("inv_freq", inv_freq)
torch.jit.trace work.self.max_seq_len_cached = max_position_embeddings
t = torch.arange(self.max_seq_len_cached, device=self.inv_freq.device, dtype=self.inv_freq.dtype)
t /= self.scale
freqs = torch.einsum("i,j->ij", t, self.inv_freq)
emb = torch.cat((freqs, freqs), dim=-1)
dtype = torch.get_default_dtype()
self.register_buffer("cos_cached", emb.cos()[None, None, :, :].to(dtype), persistent=False)
self.register_buffer("sin_cached", emb.sin()[None, None, :, :].to(dtype), persistent=False)
def forward(self, x, seq_len=None):
if block is unlikely to be run after we build sin/cos in __init__. Keep the logic here just in case.if seq_len > self.max_seq_len_cached:
self.max_seq_len_cached = seq_len
t = torch.arange(self.max_seq_len_cached, device=x.device, dtype=self.inv_freq.dtype)
t /= self.scale
freqs = torch.einsum("i,j->ij", t, self.inv_freq)
emb = torch.cat((freqs, freqs), dim=-1).to(x.device)
self.register_buffer("cos_cached", emb.cos()[None, None, :, :].to(x.dtype), persistent=False)
self.register_buffer("sin_cached", emb.sin()[None, None, :, :].to(x.dtype), persistent=False)
return (
self.cos_cached[:, :, :seq_len, ...].to(dtype=x.dtype),
self.sin_cached[:, :, :seq_len, ...].to(dtype=x.dtype),
)
2024-01-08 · 上海
回复1
展开其他 1 条回复
 藏鸿涧
很棒
 不过2.1里三角函数关于位置和维度的图像是不是反了?
2023-12-21 · 北京
回复喜欢
紫气东来
作者
没有反哈,绘图具体实现在https://github.com/ifromeast/AI_analysis/blob/main/sinusoidal_position.ipynb
2024-05-21 · 上海
回复喜欢
点击查看全部评论
未登录用户
关于作者
紫气东来
吾生也有涯,而知也无涯~
上海交通大学 工学硕士
回答 32 文章 114 关注者 24,445
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 可控细节的长文档摘要,探索开源LLM工具与实践 魔搭社区 # 集成LLM构建一个PDF长文本解读应用 PDF长文档解读,特别是论文解读,由于的确能够辅助读者有效提高文章阅读速度,可以使读者在较短时间内掌握要点,各大LLM厂商在推出在线聊天应用的同时基本都包含PDF长文档解读这一应用。 这… 智永
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码