 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
图像语义分割综述
首发于图像语义分割
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
图像语义分割综述
首发于图像语义分割
切换模式
 stone
收藏之前点个赞呗
收录于 · 图像语义分割
666 人赞同了该文章
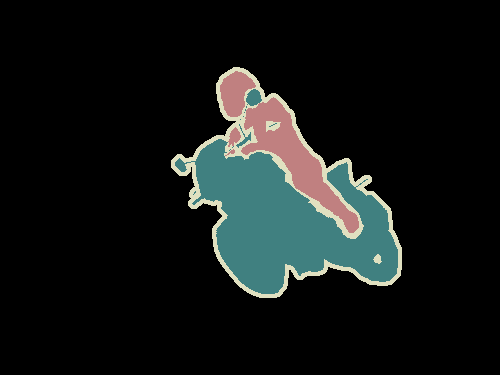
语义分割是在像素级别上的分类,属于同一类的像素都要被归为一类,因此语义分割是从像素级别来理解图像的。比如说如下的照片,属于人的像素都要分成一类,属于摩托车的像素也要分成一类,除此之外还有背景像素也被分为一类。注意语义分割不同于实例分割,举例来说,如果一张照片中有多个人,对于语义分割来说,只要将所由人的像素都归为一类,但是实例分割还要将不同人的像素归为不同的类。也就是说实例分割比语义分割更进一步。
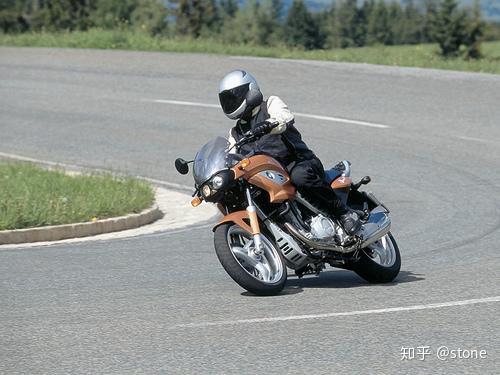 图1(a). 原图
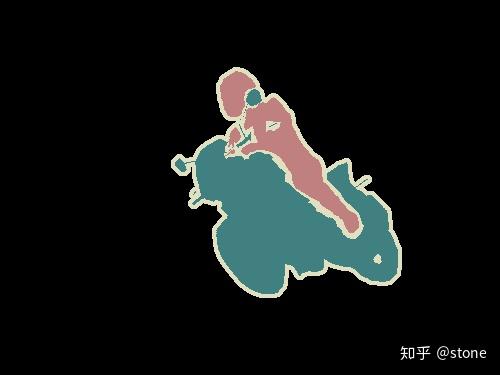 图1(b). 分割结果
在深度学习方法流行之前,TextonForest和基于随机森林分类器等语义分割方法是用得比较多的方法。不过在深度卷积网络流行之后,深度学习方法比传统方法提升了很多,所以这里就不详细讲传统方法了。
深度学习方法在语义分割上得到了巨大成功,深度学习方法解决语义分割问题可以概括为几种思路。下面进行详细介绍。
1.Patch classification
最初的深度学习方法应用于图像分割就是Patch classification。Patch classification方法,顾名思义,图像是切成块喂给深度模型的,然后对像素进行分类。使用图像块的主要原因是因为全连接层需要固定大小的图像。
2.全卷积方法
2014年,全卷积网络(FCN)横空出世,FCN将网络全连接层用卷积取代,因此使任意图像大小的输入都变成可能,而且速度比Patch classification方法快很多。
尽管移除了全连接层,但是CNN模型用于语义分割还存在一个问题,就是下采样操作(比如,pooling)。pooling操作可以扩大感受野因而能够很好地整合上下文信息(context中文称为语境或者上下文,通俗的理解就是综合了更多的信息来进行决策),对high-level的任务(比如分类),这是很有效的。但同时,由于pooling下采样操作,使得分辨率降低,因此削弱了位置信息,而语义分割中需要score map和原图对齐,因此需要丰富的位置信息。
3.encoder-decoder架构
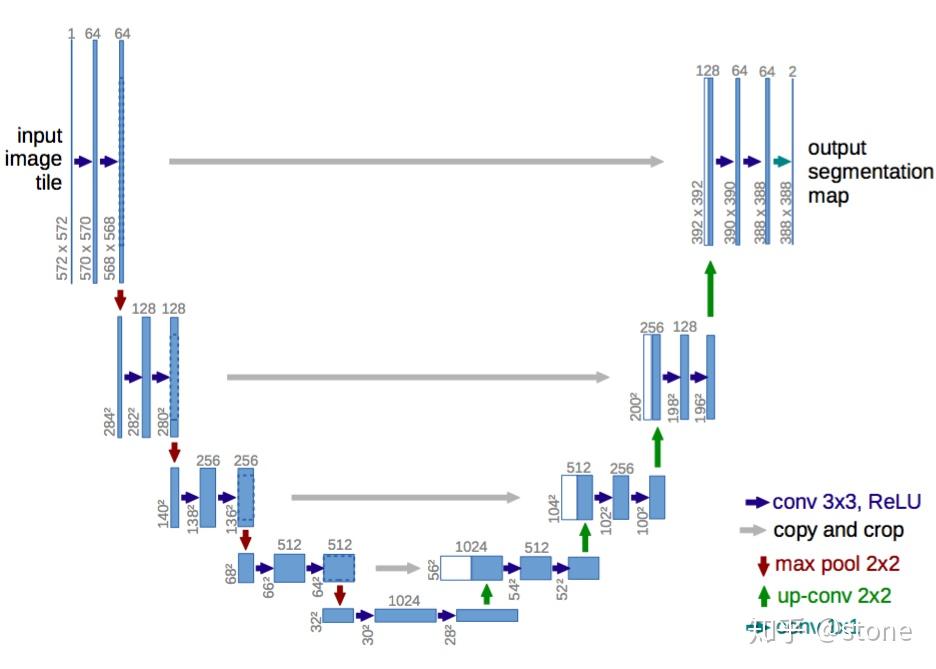
encoder-decoder是基于FCN的架构。encoder由于pooling逐渐减少空间维度,而decoder逐渐恢复空间维度和细节信息。通常从encoder到decoder还有shortcut connetction(捷径连接,也就是跨层连接)。其中U-net就是这种架构很流行的一种,如下图:
 4.空洞卷积
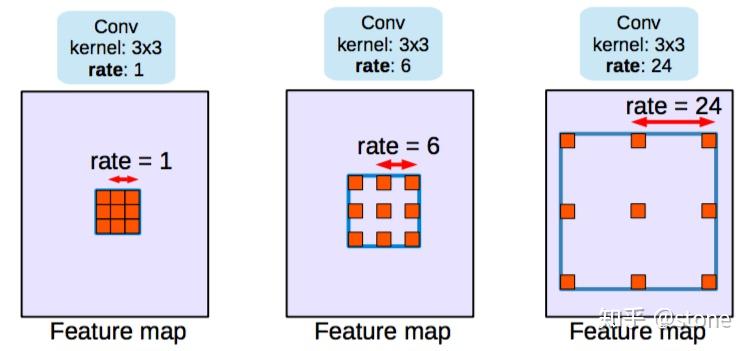
dilated/atrous (空洞卷积)架构,这种结构代替了pooling,一方面它可以保持空间分辨率,另外一方面它由于可以扩大感受野因而可以很好地整合上下文信息。如下图:
 5.条件随机场
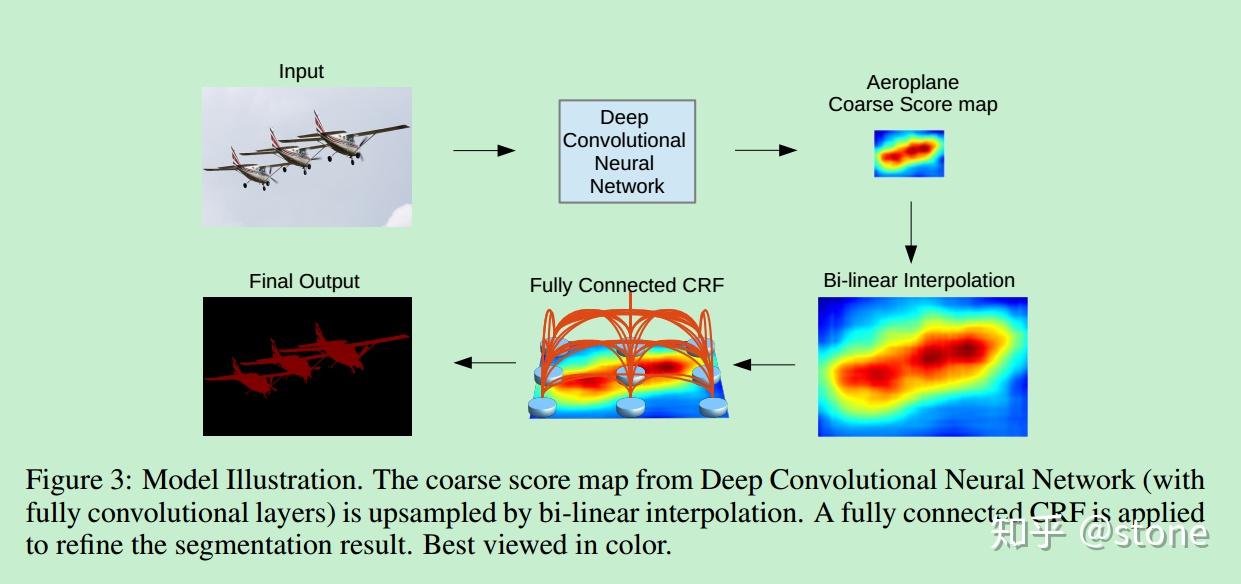
除了以上思路,还有一种对分割结果进行后处理的方法,那就是条件随机场(Conditional Random Fields (CRFs))后处理用来改善分割效果。DeepLab系列文章基本都采用这种后处理方法,可以较好地改善分割结果,如下图:
现在的深度学习语义分割模型基本上都是基于FCN发展而来的,它是开山鼻祖,一张图概括FCN的延伸方法:
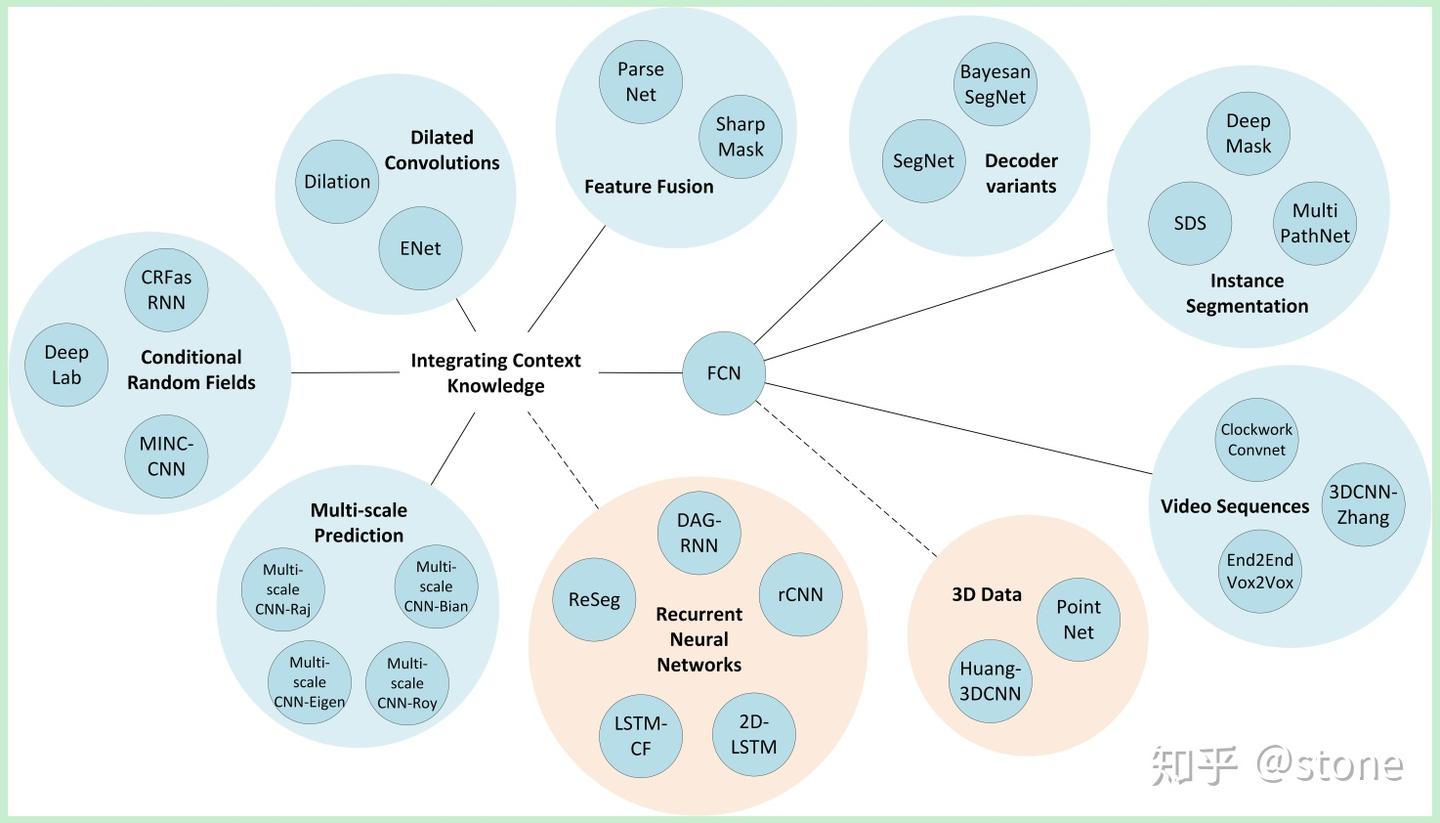
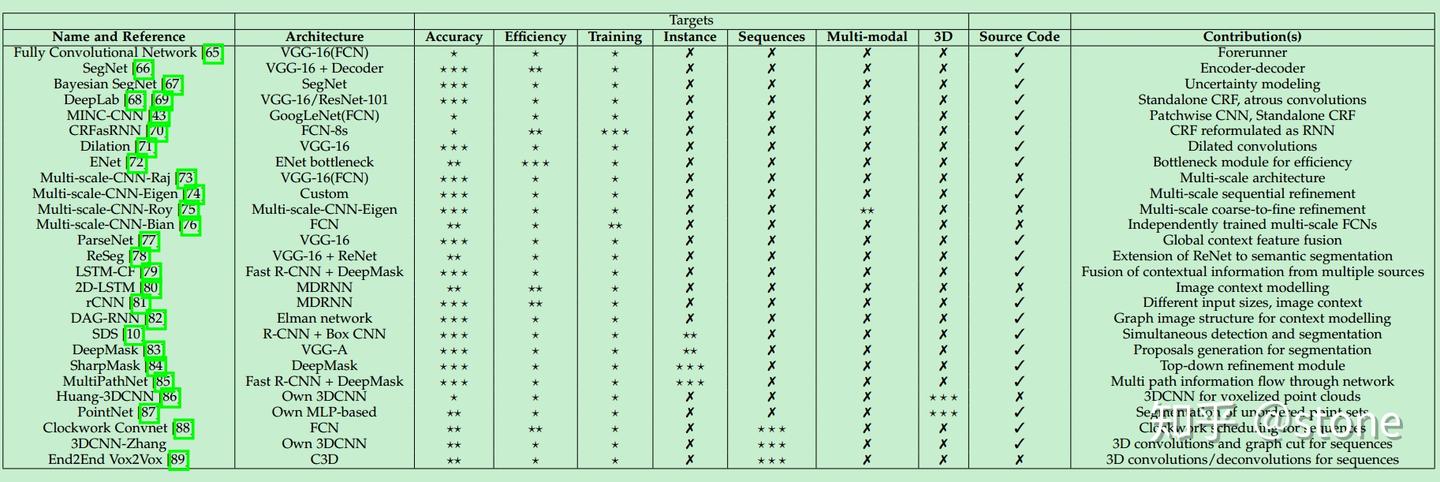
下面简单总结一些从FCN进行改进的几种架构,关于每种架构的详细解读请看专栏中其他文章。
论文信息
Fully Convolutional Networks for Semantic Segmentation
Submitted on 14 Nov 2014
Arxiv Link 主要贡献
概要
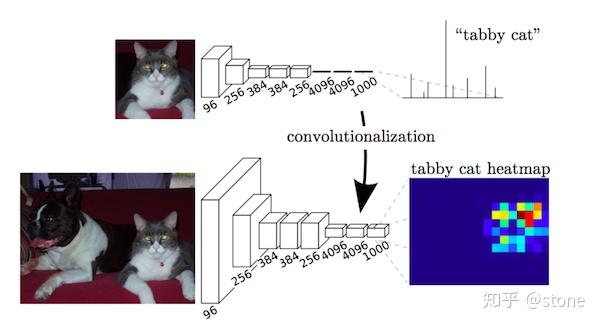 Benchmarks (VOC2012)
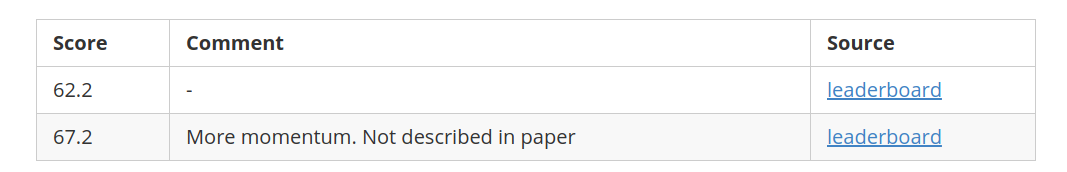 评论:
FCN是基于深度学习的语义分割的开山之作,尽管现在很多方法都超越了FCN,但它的思想仍然有很重要的意义。
论文信息
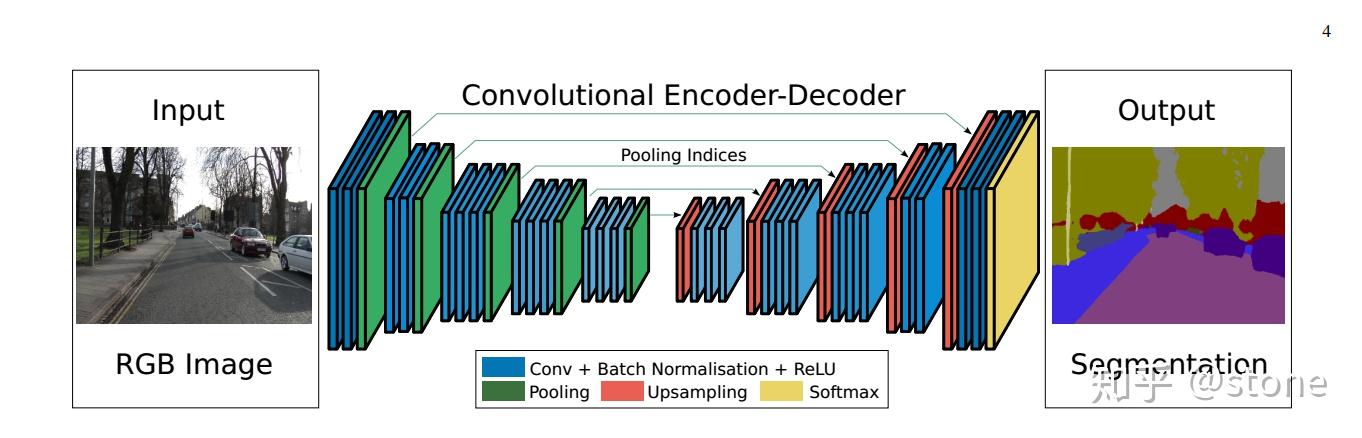
SegNet: A Deep Convolutional Encoder-Decoder Architecture for Image Segmentation
Submitted on 2 Nov 2015
Arxiv Link 主要贡献
简要概述
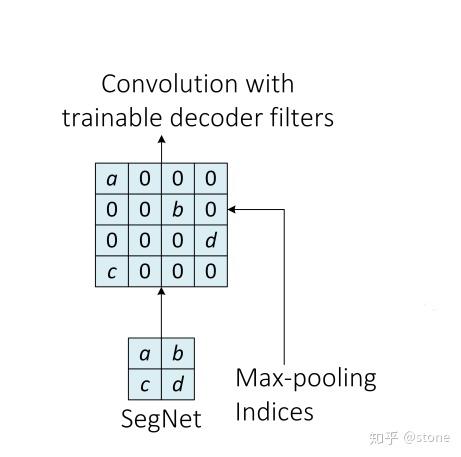
FCN的upconvolution层+shortcut connections产生的分割图比较粗糙,因此SegNet增加了更多的shortcut connections。不过,SegNet并不是直接将encoder的特征进行直接复制,而是对maxpooling中的indices进行复制,这使得SegNet的效率更高。
 maxpooling 的indices复制原理如下:
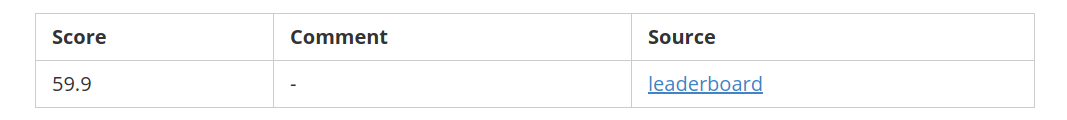
Benchmarks (VOC2012)
 评论
论文信息
Multi-Scale Context Aggregation by Dilated Convolutions
Submitted on 23 Nov 2015
Arxiv Link 创新点
简要解释
pooling操作可以增大感受野,对于图像分类任务来说这有很大好处,但由于pooling操作降低了分辨率,这对语义分割来说很不利。因此作者提出一种叫做dilated convolution的操作来解决这个问题。dilated卷积(在deeplab中称为atrous卷积)。可以很好地提升感受野的同时可以保持空间分辨率。
网络架构有两种,一种是前端网络,另外一种是前端网络+上下文模块,分别介绍如下:
Benchmarks (VOC2012)
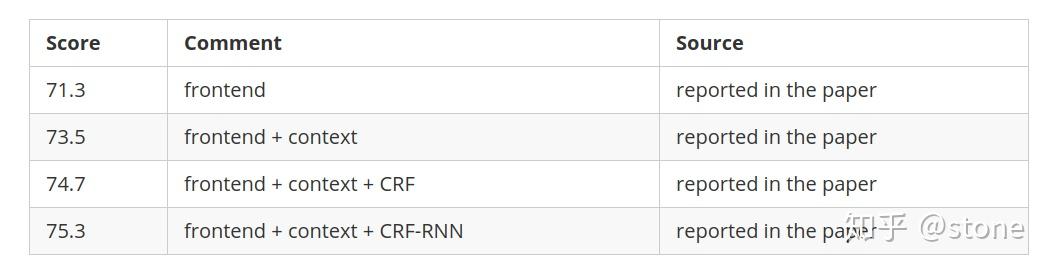 评论
需要特别注意的是,网络输出的分割图并不是和原始图像大小一样的,而是其1/8,需要对输出的分割图进行线性插值才能得到最终的分割结果。这种做法也是很多其他的方法都使用的。
论文信息
v1 : Semantic Image Segmentation with Deep Convolutional Nets and Fully Connected CRFs
Submitted on 22 Dec 2014
Arxiv Link
v2 : DeepLab: Semantic Image Segmentation with Deep Convolutional Nets, Atrous Convolution, and Fully Connected CRFs
Submitted on 2 Jun 2016
Arxiv Link 主要贡献
简要概述
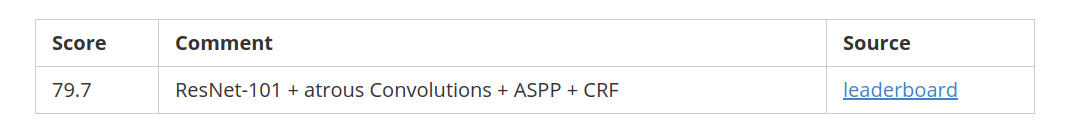
Benchmarks (VOC2012)
论文信息
RefineNet: Multi-Path Refinement Networks for High-Resolution Semantic Segmentation
Submitted on 20 Nov 2016
Arxiv Link 主要贡献
简要概述 作者提出空洞卷积方法应用于语义分割也是有缺点的,包括:
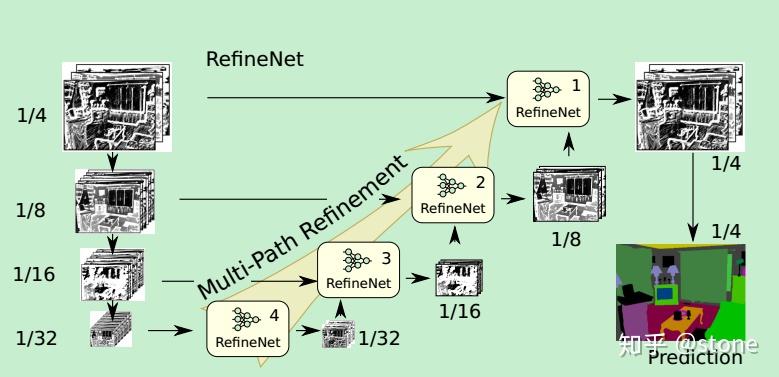
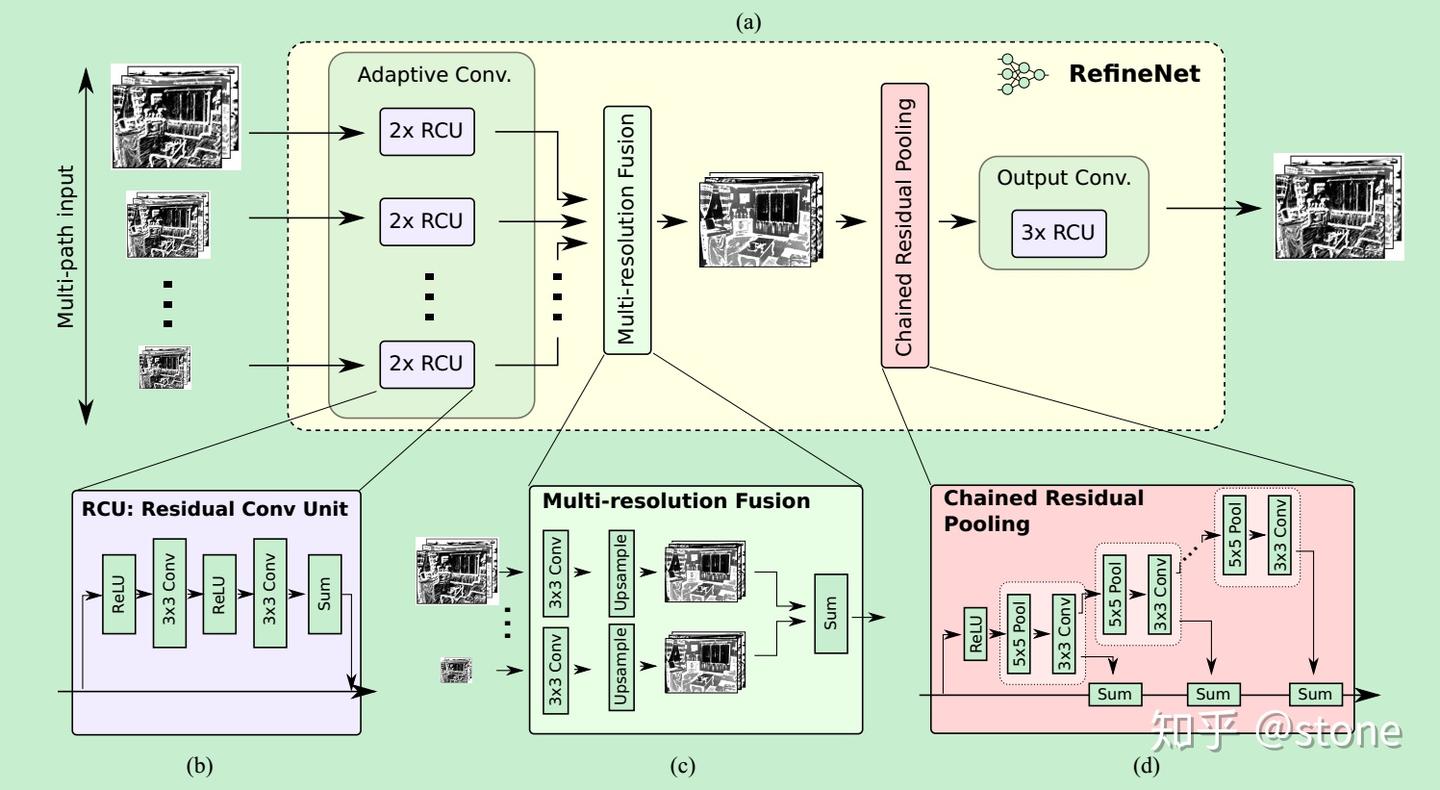
本文提出使用encoder-decoder架构。encoder部分是RESNET-101。decoder具有RefineNet blocks,它将此前的RefineNet blocks的低分辨率特征和encoder部分高分辨率特征进行concatenate/fuse。
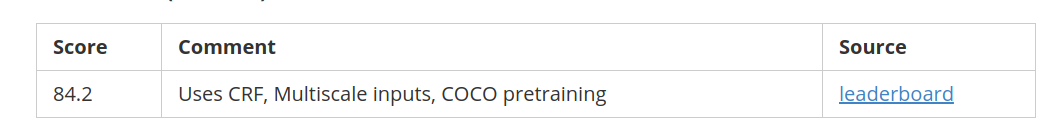
 Benchmarks (VOC2012)
论文信息
Pyramid Scene Parsing Network
Submitted on 4 Dec 2016
Arxiv Link 主要贡献
概要
骨架网络使用Resnet,并在此基础上加上pyramid pooling module。该模块用到了很多kernel大小不一的pooling 。将pooling的结果再上采样,经过concatenate进行融合。
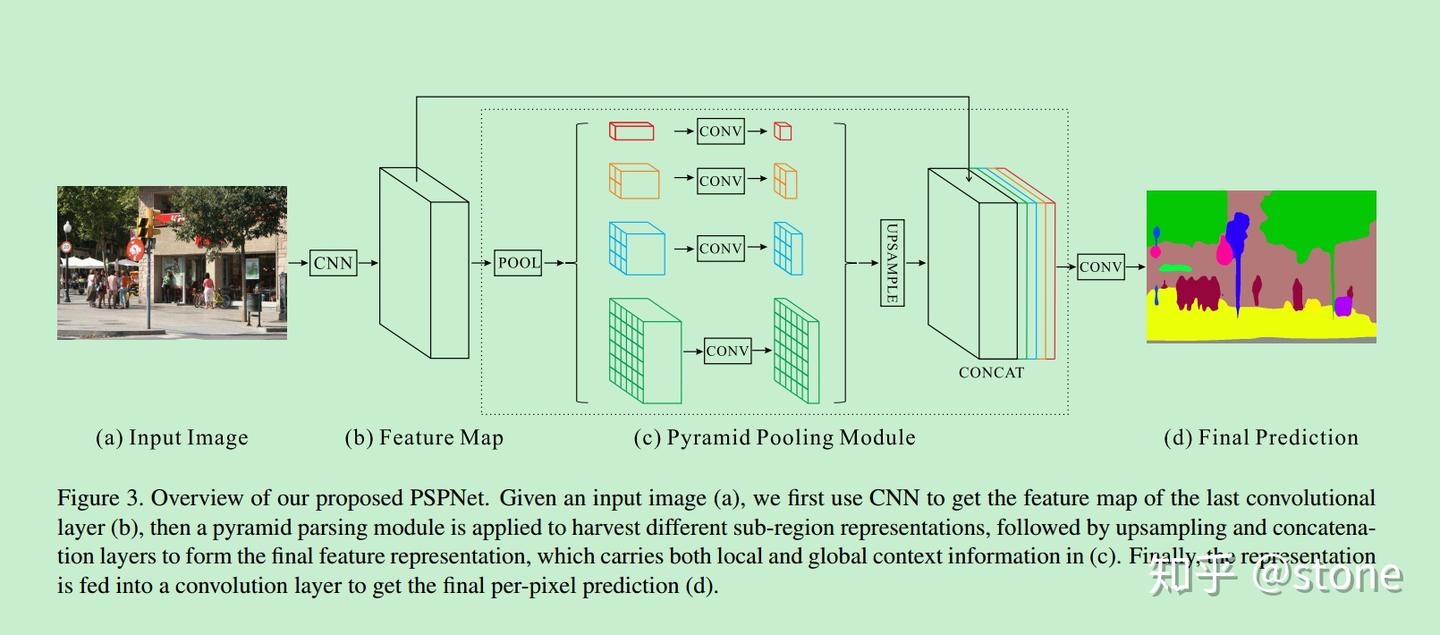 在RESNET的第四阶段(即输入到金字塔池模块)之后,应用auxiliary loss。这种方法在别的地方也被称为intermediate supervision。
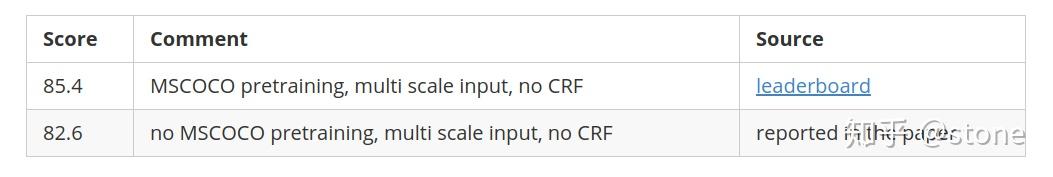
Benchmarks (VOC2012)
pass
pass
参考 这篇文章主要是参考以下两篇文章的一个总结,加入了一些自己的理解,想看原文的直接打开:
编辑于 2018-06-10 00:30
深度学习(Deep Learning)
机器学习
计算机视觉
赞同 66619 条评论1183 74
分享
申请转载
 未登录用户
19 条评论
默认
最新
 dadream
没有unet?
2018-09-20
回复3
展开其他 1 条回复
 tan知yi
想知道传统的随机森林是如何做语义分割的

 2020-12-28
回复1
 寒青
想问下,分割图不同类别不同颜色是如何实现的
2020-07-04
回复1
展开其他 1 条回复
 wong或许对了
大佬不讲讲OCRnet吗
2023-10-13
回复喜欢
 大山
很棒的综述,非常谢谢!
2022-10-18
回复喜欢
 知乎用户dwCPx8
1
2022-09-22
回复喜欢
 Eric
 2021-06-02
回复喜欢
 月色血风暴
感谢~写得很棒
2020-02-21
回复喜欢
 storm
感谢!可以更新吗
2019-11-02
回复喜欢
 李文鑫
但是上次看论文 没看懂的 看了这篇之后 会更懂 谢谢作者了
2019-09-25
回复喜欢
点击查看全部评论
未登录用户
关于作者
stone
收藏之前点个赞呗
回答 30 文章 15 关注者 10,013
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 图片语义分割深度学习算法要点回顾 AI研习社
 图像语义分割(20) 通过图像合成方法检测训练中未出现的类别未知的物体 赵磊发表于计算机科学...
 【图解AI】什么是语义分割、实例分割、全景分割 Jack Wang
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码