 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
大模型LLM-微调经验分享&总结
首发于AIGC
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
大模型LLM-微调经验分享&总结
首发于AIGC
切换模式
 刘聪NLP
 新知答主
收录于 · 人工智能研究
1731 人赞同了该文章
大型语言模型横行,之前非常焦虑,现在全面拥抱。目前也有很多开源项目进行大模型微调等,笔者也做了一阵子大模型了,特此来介绍一下ChatGLM-6B模型微调经验,并汇总了一下目前开源项目&数据。笔者与很多人微调结论不同,本人在采用单指令上进行模型微调,发现模型微调之后,「并没有出现灾难性遗忘现象」。
模型越大对显卡的要求越高,目前主流对大模型进行微调方法有三种:Freeze方法、P-Tuning方法和Lora方法。笔者也通过这三种方法,在信息抽取任务上,对ChatGLM-6B大模型进行模型微调。为了防止大模型的数据泄露,采用一个领域比赛数据集-汽车工业故障模式关系抽取,随机抽取50条作为测试集。
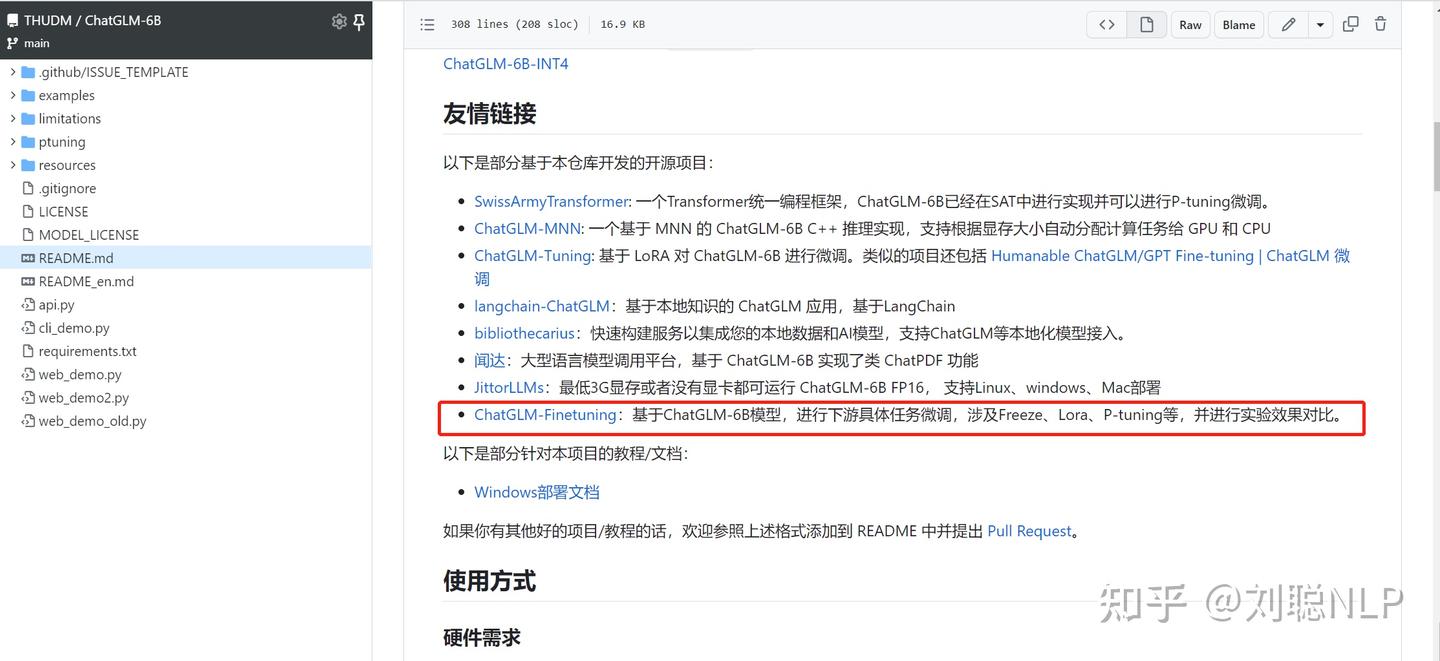
详细代码见上面的GitHub链接,并且也被ChatGLM官方收录。
Freeze方法,即参数冻结,对原始模型部分参数进行冻结操作,仅训练部分参数,以达到在单卡或不进行TP或PP操作,就可以对大模型进行训练。 微调代码,见finetuning_freeze.py,核心部分如下:
for name, param in model.named_parameters():
    if not any(nd in name for nd in ["layers.27", "layers.26", "layers.25", "layers.24", "layers.23"]):
        param.requires_grad = False
针对模型不同层进行修改,可以自行修改。训练代码均采用DeepSpeed进行训练,可设置参数包含train_path、model_dir、num_train_epochs、train_batch_size、gradient_accumulation_steps、output_dir、prompt_text等,可根据自己的任务配置。
CUDA_VISIBLE_DEVICES=0 deepspeed finetuning_freeze.py --num_train_epochs 5 --train_batch_size 2
三元组抽取的推理代码,见predict_freeze.py,其他任务可以根据自己的评价标准进行推理预测。
PT方法,即P-Tuning方法,参考ChatGLM官方代码 ,是一种针对于大模型的soft-prompt方法。
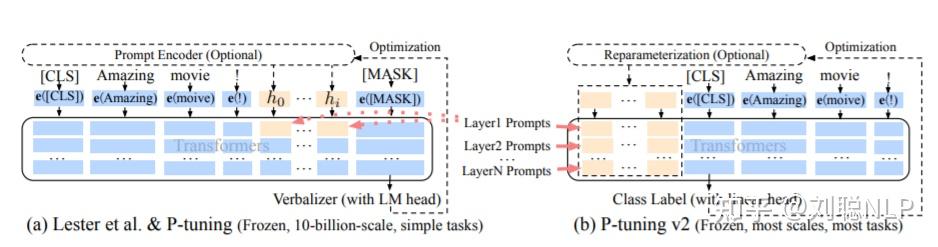
微调代码,见finetuning_pt.py,核心部分如下:
config = ChatGLMConfig.from_pretrained(args.model_dir)
config.pre_seq_len = args.pre_seq_len
config.prefix_projection = args.prefix_projection

model = ChatGLMForConditionalGeneration.from_pretrained(args.model_dir, config=config)

for name, param in model.named_parameters[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=2&q=named_parameters&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiJuYW1lZF9wYXJhbWV0ZXJzIiwiemhpZGFfc291cmNlIjoiZW50aXR5IiwiY29udGVudF9pZCI6MjI2MTA1ODczLCJjb250ZW50X3R5cGUiOiJBcnRpY2xlIiwibWF0Y2hfb3JkZXIiOjIsInpkX3Rva2VuIjpudWxsfQ.Ug45pcpNHAVxfI15ktBqqmAxHpZ3hxB3Y8RA3r5d5iE&zhida_source=entity)():
    if not any(nd in name for nd in ["prefix_encoder"]):
        param.requires_grad = False
当prefix_projection为True时,为P-Tuning-V2方法,在大模型的Embedding和每一层前都加上新的参数;为False时,为P-Tuning方法,仅在大模型的Embedding上新的参数。 可设置参数包含train_path、model_dir、num_train_epochs、train_batch_size、gradient_accumulation_steps、output_dir、prompt_text、pre_seq_len、prompt_text等, 可根据自己的任务配置。
CUDA_VISIBLE_DEVICES=0 deepspeed finetuning_pt.py --num_train_epochs 5 --train_batch_size 2 --pre_seq_len 16
三元组抽取的推理代码,见predict_pt.py,其他任务可以根据自己的评价标准进行推理预测。
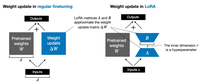
Lora方法,即在大型语言模型上对指定参数增加额外的低秩矩阵,并在模型训练过程中,仅训练而外增加的参数。当“秩值”远小于原始参数维度时,新增的低秩矩阵参数量很小,达到仅训练很小的参数,就能获取较好的结果。
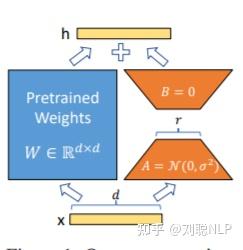
微调代码,见finetuning_lora.py,核心部分如下:
model = ChatGLMForConditionalGeneration.from_pretrained(args.model_dir)
config = LoraConfig(r=args.lora_r,
                    lora_alpha[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=lora_alpha&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiJsb3JhX2FscGhhIiwiemhpZGFfc291cmNlIjoiZW50aXR5IiwiY29udGVudF9pZCI6MjI2MTA1ODczLCJjb250ZW50X3R5cGUiOiJBcnRpY2xlIiwibWF0Y2hfb3JkZXIiOjEsInpkX3Rva2VuIjpudWxsfQ.Ns3tttuwY6f77vbrhvwUQJub2T9-eqliRyXxYb0P3Gw&zhida_source=entity)=32,
                    target_modules=["query_key_value"],
                    lora_dropout=0.1,
                    bias="none",
                    task_type="CAUSAL_LM",
                    inference_mode=False,
                    )

model = get_peft_model[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=peft_model&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiJwZWZ0X21vZGVsIiwiemhpZGFfc291cmNlIjoiZW50aXR5IiwiY29udGVudF9pZCI6MjI2MTA1ODczLCJjb250ZW50X3R5cGUiOiJBcnRpY2xlIiwibWF0Y2hfb3JkZXIiOjEsInpkX3Rva2VuIjpudWxsfQ.usI5RIgeF7S8wLJomUWgRCifrtAbNpdBOTWeuYBRaKk&zhida_source=entity)(model, config)
可设置参数包含train_path、model_dir、num_train_epochs、train_batch_size、gradient_accumulation_steps、output_dir、prompt_text、lora_r等,可根据自己的任务配置。
CUDA_VISIBLE_DEVICES=0 deepspeed finetuning_lora.py --num_train_epochs 5 --train_batch_size 2 --lora_r 8
三元组抽取的推理代码,见predict_lora.py,其他任务可以根据自己的评价标准进行推理预测。 注意:对于结果需要保持一致的任务(即关掉dropout,解码关掉do_sample),需要保存模型的adapter_config.json文件中,inference_mode参数修改成false,并将模型执行model.eval()操作。 主要原因是chatglm模型代码中,没有采用Conv1D函数。
prompt_text:你现在是一个信息抽取模型,请你帮我抽取出关系内容为\"性能故障\", \"部件故障\", \"组成\"和 \"检测工具\"的相关三元组,三元组内部用\"_\"连接,三元组之间用\\n分割。文本:
输入:故障现象:发动机水温高,风扇始终是低速转动,高速档不工作,开空调尤其如此。
输出:发动机_部件故障_水温高\n风扇_部件故障_低速转动
时间换空间,可用很好的解决显卡的资源问题,简单玩玩还可以,如果想要模型达到最优效果或可用快速看到效果,还不如租张A100卡,快速实验,推理阶段再用自己的小破卡。
下面实验结果均是在租的80G-A100上进行的实验,与Github里用的A40的实验结果会有些差异,主要在训练时长(纯训练速度,剔除模型保存的时间)。说实话,真的要训练一个大模型,多个A100是必不可少的,可以减少很多模型并行的操作,效果上也更好把控一些。
| 微调方法 | PT-Only-Embedding | PT | Freeze | Lora |
| --- | --- | --- | --- | --- |
| 显卡占用 | 37G | 56G | 24G | 39G |
| 总参数 | 6.259B | 7.211B | 6.255B | 6.259B |
| 可训练参数占比 | 0.0586% | 13.26% | 16.10% | 0.0586% |
| 训练耗时 | 20min | 52min | 46min | 25min |
| 测试结果F1 | 0.0 | 0.6283 | 0.5675 | 0.5359 |
结果分析:
很多同学在微调后出现了灾难性遗忘现象,但我这边并没有出现,对“翻译任务”、“代码任务”、“问答任务”进行测试,采用freeze模型,可以用test_forgetting.py进行测试,具体测试效果如下:
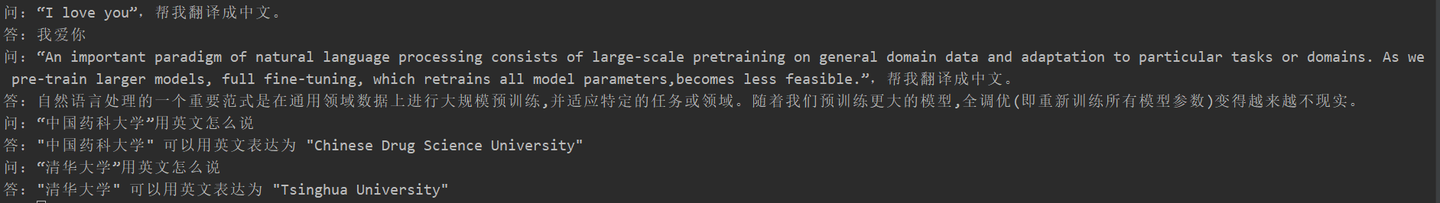
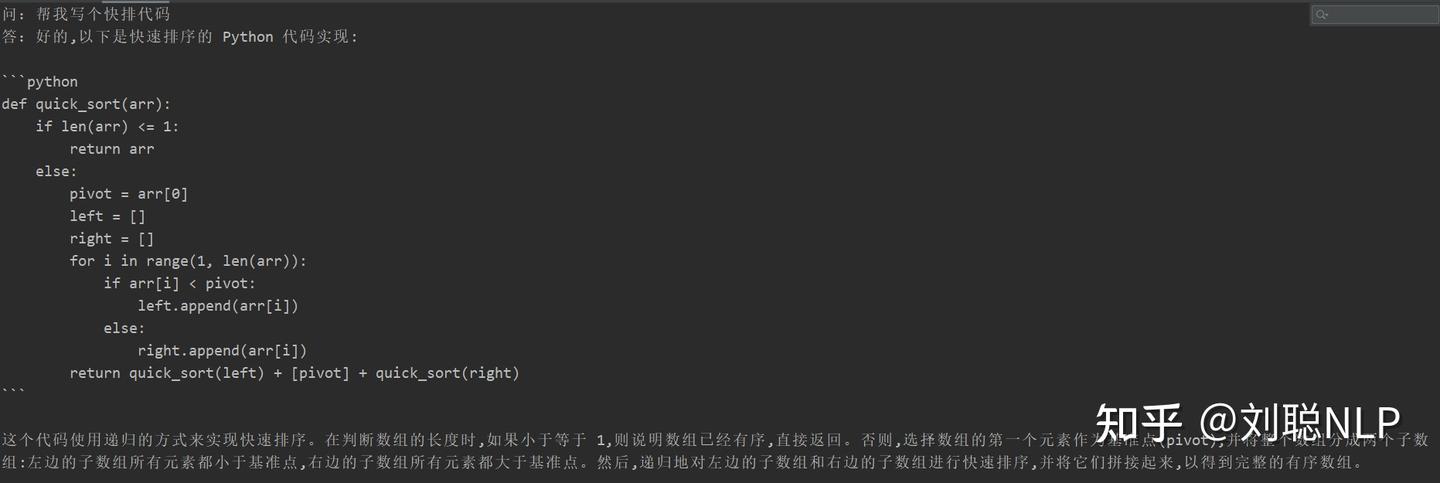
 后面会把生成任务、分类任务做完,请持续关注Github,会定期更新。(太忙了,会抓紧时间更新,并且官方代码也在持续更新,如遇到代码代码调不通的情况,请及时联系我,我在github也给出了我的代码版本和模型版本)
prompt_text:你现在是一个问题生成模型,请根据下面文档生成一个问题,文档:
输入:紫色红薯是近年从日本[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=%E6%97%A5%E6%9C%AC&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiLml6XmnKwiLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMjYxMDU4NzMsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.-32xvuaLamIVhtZxcDg4pWwnBjqrFSTn-_x3IXcorik&zhida_source=entity)引进的新品种红薯,中国农业大学农学与生物技术学院副院长刘庆昌[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=%E5%88%98%E5%BA%86%E6%98%8C&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiLliJjluobmmIwiLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMjYxMDU4NzMsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.ydJi2gCYBnZesDRrNQ_RZgHtG03KbZi7rhBvP-jgtss&zhida_source=entity)指出,紫薯中的花青素[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=%E8%8A%B1%E9%9D%92%E7%B4%A0&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiLoirHpnZLntKAiLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMjYxMDU4NzMsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.A9NiU9LOrtSRTRk9QU9KuEKxeXgFk-zPEMaBGceWJxk&zhida_source=entity)具有显著的抗生物[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=%E6%8A%97%E7%94%9F%E7%89%A9&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiLmipfnlJ_niakiLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMjYxMDU4NzMsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.4qoI7eNOv9Hcu9s09Bthm3fExl2e3FoTa2sVnp8xpmA&zhida_source=entity)氧化作用,在延缓人体衰老方面具有非常好的效果。紫薯中所含赖氨酸[](https://zhida.zhihu.com/search?content_id=226105873&content_type=Article&match_order=1&q=%E8%B5%96%E6%B0%A8%E9%85%B8&zd_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJpc3MiOiJ6aGlkYV9zZXJ2ZXIiLCJleHAiOjE3OTExMzkxNDEsInEiOiLotZbmsKjphbgiLCJ6aGlkYV9zb3VyY2UiOiJlbnRpdHkiLCJjb250ZW50X2lkIjoyMjYxMDU4NzMsImNvbnRlbnRfdHlwZSI6IkFydGljbGUiLCJtYXRjaF9vcmRlciI6MSwiemRfdG9rZW4iOm51bGx9.tJA7ZRuA34EHtSoYnrKL_oeuz00EmmE2wFVqrS4B3Ak&zhida_source=entity)、铜、锰、钾、锌的含量高于一般红薯5-8倍,尤其是抗癌物质碘、硒的含量比其他红薯高出20倍以上,占食物中的第一位。
输出:紫薯和红薯吃哪个好?
模型训练,以freeze方法为例:
CUDA_VISIBLE_DEVICES=0 nohup deepspeed --master_port 5555 finetuning_freeze.py --train_path "data/d2q_0.json" --output_dir "output_dir_freeze/" --prompt_text "你现在是一个问题生成模型,请根据下面文档生成一个问题,文档:" > log_fz.log 2>&1 &
由于生成模型的内容不能想信息抽取任务一样评价,用现有的BLUE或者Rouge来评价也是不合适,因此制定了评分规则。 通过多样性和准确性两个角度判断D2Q模型好坏,每个样本总计5分,共20个样本。
测试数据见d2q_result_data/,测试代码见predict_d2q.py
| 微调方法 | 原始模型 | PT-Only-Embedding | PT | Freeze | Lora |
| --- | --- | --- | --- | --- | --- |
| 分数 | 51.75 | 73.75 | 87.75 | 79.25 | 86.75 |
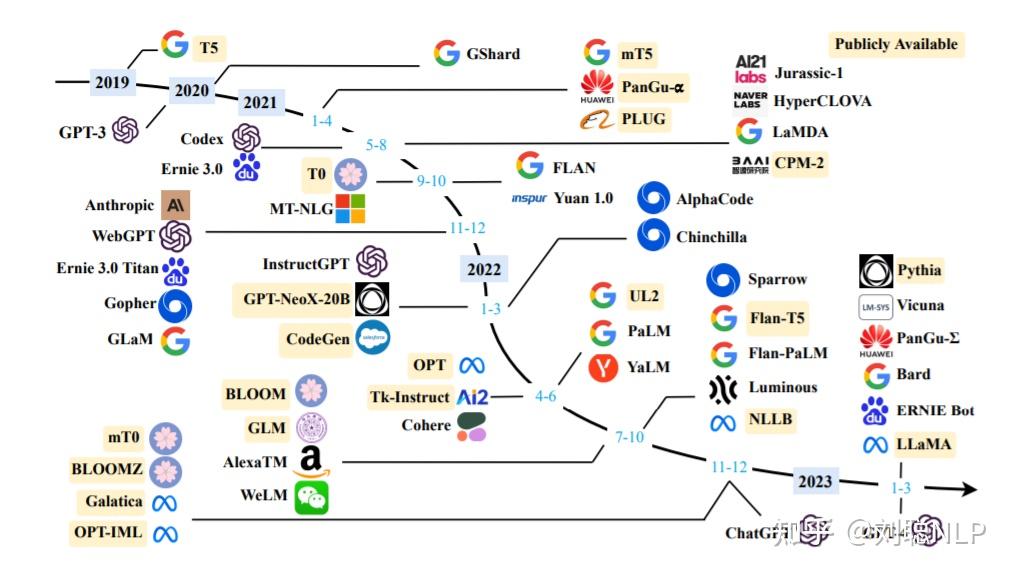
虽然出来很多大模型,但Open的&中文可直接使用的并不多,下面对中文开源大模型、数据集和项目进行一下汇总。
直接可微调,无需指令增量训练:
原始模型多语言or英文,需要中文指令数据集增量训练:
下面中文指令集,大多数从Alpaca翻译而来,请看下面项目中data目录。目前通过ChatGPT或者GPT4作为廉价标注工为自己的数据进行数据标注一个不错的思路。
总结下面较火的开源项目:
目前各大厂的大模型陆陆续续放出,堪称百家争鸣!个人玩家也是全面拥抱,想尽一切办法来训练微调大模型。只愿大家以后可以实现“大模型”自由。愿再无“model-as-a-service”。
欢迎多多转发,点赞,关注,有问题的朋友也欢迎加我微信 「logCong」私聊,交个朋友吧,一起学习,一起进步。 我们的口号是“生命不止,学习不停”。
刘聪NLP:ChatGPT-所见、所闻、所感
刘聪NLP:AAAI2023 | 基于统一语义匹配的通用信息抽取框架-USM
刘聪NLP:CC-Riddle:汉字谜语问答数据集
刘聪NLP:中文NER数据集整理
刘聪NLP:ACL2022 | DCSR:一种面向开放域段落检索的句子感知的对比学习方法
刘聪NLP:ACL2022 | NoisyTune:微调前加入少量噪音可能会有意想不到的效果
刘聪NLP:ACL2022|DictBERT:通过低频词典增强预训练模型表征方法
刘聪NLP:ACL2022论文分类汇总-Prompt、句子表征、检索排序&摘要
刘聪NLP:总结|Prompt在NER场景的应用
刘聪NLP:PolyLoss:一种将分类损失函数加入泰勒展开式的损失函数
刘聪NLP:PERT:一种基于乱序语言模型的预训练模型
刘聪NLP:DiffCSE:结合句子间差异的无监督句子嵌入对比学习方法
刘聪NLP:SIGIR2022论文筛选
刘聪NLP:PairSCL:句子对级别的有监督对比学习方法
刘聪NLP:COLD:中文冒犯性语言检测数据集
刘聪NLP:SNCSE:一种基于软负例的无监督句向量对比学习方法
刘聪NLP:CPT模型:一种中文兼顾NLU和NLG的非平衡预训练语言模型
刘聪NLP:SimCSE论文精读
刘聪NLP:常用预训练语言模型(PTMs)总结
刘聪NLP:ACL2021论文之ChineseBERT:融合字形与拼音信息的中文预训练模型
刘聪NLP:Sentence-Bert论文笔记
刘聪NLP:MacBERT:MLM as correction BERT
刘聪NLP:智能扩充机器人的“标准问”库之Query生成
刘聪NLP:短文本相似度算法研究
编辑于 2023-06-30 12:44・江苏
LLM(大型语言模型)
自然语言处理
人工智能
赞同 1731167 条评论4044 318
分享
申请转载
 未登录用户
167 条评论
默认
最新
 刘聪NLP
作者
更新了文本生成的实验
 2023-04-18 · 江苏 · 作者置顶
回复8
 徐晓龙
你这个里面没看到没微调前的模型效果,有这块的数据嘛
2023-04-14 · 安徽
回复8
 Szymon
这里有条挺重要的,专项训练过后是否影响原先的各种性能。
2023-04-20 · 四川
回复5
展开其他 4 条回复
 半糖
大佬能做下文本分类的微调吗~最近在做感觉效果很差,不知道哪里出问题了55
2023-05-17 · 福建
回复5
展开其他 5 条回复
 揽睿星舟
妈妈!我上电视了!
 2023-04-11 · 上海
回复4
 刘聪NLP
作者
 2023-04-11 · 江苏
回复喜欢
展开其他 1 条回复
NyChatAI
为什么指令微调的输入是input+label:输出是input的长度*100;能采用input,输出直接是label吗?
2023-07-24 · 广东
回复2
 Lemon
楼主好,想请教一下,关系抽取任务没有影响模型原来的自然语言理解能力,那生成任务有影响嘛?感觉关系抽取任务可能在之前预训练的时候,用到了类似的数据或者指令,所以没有对原始模型产生太大的影响。如果是一个完全特定领域的生成任务,会有影响嘛?
2023-05-19 · 北京
回复2
 wyl
当prefix_projection为True时,为P-Tuning-V2方法,在大模型的Embedding和每一层前都加上新的参数;为False时,为P-Tuning方法,仅在大模型的Embedding上新的参数。这个有错误吧?True代表的是使用了重参数吧?
2023-05-18 · 北京
回复2
展开其他 4 条回复
 王二叔
感谢分享
2023-04-12 · 北京
回复1
刘聪NLP
作者
2023-04-12 · 江苏
回复喜欢
点击查看全部评论
未登录用户
关于作者
刘聪NLP
LLM is all you need!
云问科技 算法工程师
回答 505 文章 205 关注者 35,939
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定706 万热
中国男足 0-5 巴勒斯坦564 万热
原央视主持人阿丘回应被通报422 万热
华为与赛力斯达成新五年合作411 万热
迪拜航空确认航班发生事故400 万热
东航回应网传空姐跪地道歉327 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻258 万
 模型应用-LLM微调 Dev-Z...发表于模型方法
 LLM微调实践和总结 yuwei1991
 大模型学习笔记(四) 更好的LLM:微调、提示词工程与对齐 水滴油穿
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码