 关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
按需视觉识别:愿景和初步方案
首发于计算机视觉论文速递
切换模式
保留正文与补采附件。源页面当前未重新核验;具体限制见交付清单。
[](javascript:void(0))
关注推荐热榜专栏圈子AI WorksBeta 故事
直答
切换模式
登录/注册
按需视觉识别:愿景和初步方案
首发于计算机视觉论文速递
切换模式
 谢凌曦
 新知答主
收录于 · 计算机视觉论文速递
331 人赞同了该文章
目录
本次写文章,是希望宣传我们最近放在arXiv上,并且开源的文章《按需视觉识别》。这是我个人比较看重的一个工作,因为它讨论了视觉识别中的评价指标问题;而我越来越坚定地认为,在计算机视觉进入瓶颈期的当下,定义合理的评价指标,比刷新现有评价指标上的SOTA,要更重要一些。
当然,限于水平原因,文章只揭示了很肤浅的问题,并且提供了非常初步的解决方案。我们希望能够以此为契机,抛砖引玉,引发大家对这些重要问题的思考,进而促进更优方案的诞生。
文章的第一作者是唐楚峰
@chufengt
同学,文章的合作者也包括我的同事张晓鹏博士、清华大学胡晓林教授以及我的导师田奇教授。除此以外,我还要特别感谢我的同事魏龙辉和彭君然博士,他们都给文章提出了非常宝贵的建议。
 按需视觉识别
文章链接:Visual Recognition by Request
代码链接:https://github.com/chufengt/Visual-Recognition-by-Request
这个工作的动机,来源于我对于视觉识别局限性的思考。我先简单地做一些铺垫。这些铺垫和这个工作没有直接联系,读者可以跳过直接看正文。 众所周知,当前基于深度学习的计算机视觉算法,与人类的学习方式具有本质不同。其根本性原因在于:人类是在一个真实的三维世界中,以任务为驱动,进行交互式学习,而计算机只能通过标注数据来学习各种分散的任务。为什么会有这样大的区别?其实早在上个世纪70年代,计算机视觉的先驱之一David Marr(Marr奖的纪念对象)就表达过他的观点:**计算机视觉算法的根本目的,是建立环境的三维模型,并且在交互过程中进行学习。**然而,将近半个世纪过去,人们还是没有实现这个愿景。这里的主要原因,是三维模型难以构建,例如下面的两套方案:
由于无法对世界**建模** ,人们就只能退而求其次,对世界采样 ,并且从样本中学习。这就是为什么人们要构建、标注越来越大的图像数据集:数据集的规模越大,采样的精度就越高,就越能反映真实世界的规律。然而,这种方式是极其低效的。一方面,随着数据集的规模不断增大,上述方案产生了明显的边际效应,使得学习方法的性价比不断降低;另一方面,随着视觉概念的不断增加和细化,视觉标签的歧义性不断上升,使得评价指标的不确定性显著增加。这里所谓视觉标签的歧义性 是说,随着标签种类数的增加,一个物体究竟属于什么类,哪些部分属于这个类,就会变得不确定起来——前者可以参照ImageNet,不少物体细粒度标签存在歧义性;后者参照各种part-based数据集,一只狗的头部和躯干的边界究竟在什么地方,其实是很难定义的,遑论更加细粒度的part了。
更重要的是,人类并不需要基于分类来认知世界。举一个直观的例子。在ImageNet中,存在着“家具”和“电器”两个大类;显然“椅子”属于“家具”,而“电视机”属于“家电”,但是“按摩椅”属于“家具”还是“家电”,就很难说了。然而,人类并不纠结于这件事:一个人到商场里买东西,不管商场把“按摩椅”放在“家具”区还是“家电”区,人类都可以通过简单的指引,快速找到“按摩椅”所在的区域。
综上所述,随着视觉识别的不断细化,基于分类的识别任务终将遇到不可逾越的瓶颈。这里基于分类的识别任务,包括分类、检测、分割等一切需要给目标打上明确标签的任务,因为基于分类的标注无法满足视觉信号具有的近乎无限细粒度 的特性。换句话说,只要人类愿意 ,就可以从一张图像中识别出越来越细粒度的语义信息(如图1所示);而这些信息,很难通过有限而规范的标注,形成语义上完整的数据集,供算法学习。我在去年年中写了一篇opinion paper,整理了这些观点(见下)。经过一年的思考,我们终于在opinion paper的基础上迈出了一小步。
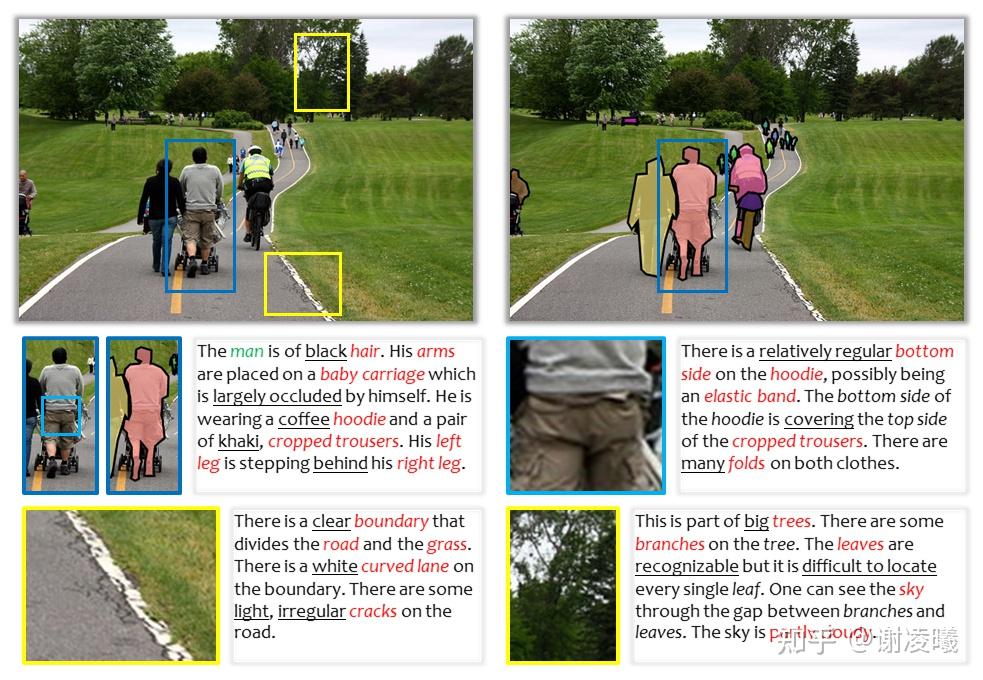 图1 现有数据集(如MS-COCO)距离完整地识别所有语义信息,还相差甚远。其中下划线和红色字体标出的部分,都是未在数据集中呈现,而人类能够轻易识别或描述的语义内容。
基于上述分析,当前基于**封闭域** (closed-domain)的视觉识别算法无法满足无限细粒度的要求,业界亟需基于开放域 (open-domain)的视觉识别算法。当前,在视觉识别中引入文本指引(text-guided),是一种很有前景的,实现开放域的做法。与其他相关工作不同,我们的工作希望探讨识别的完整性 ,也就是在愿意的情况下能够无限细粒度地 识别图像中的语义概念。然而,如果要达到无限细粒度的目标,当前方法存在两大负担。
显然,只有解决了上述问题,我们才可能构建具有无限细粒度的识别数据集。此时,虽然数据集中包含的视觉概念非常丰富,但这并不意味着我们需要在每张图像上都标注出所有的物体或者概念。这样说也许不够直观,那么重新考虑以上两个例子:
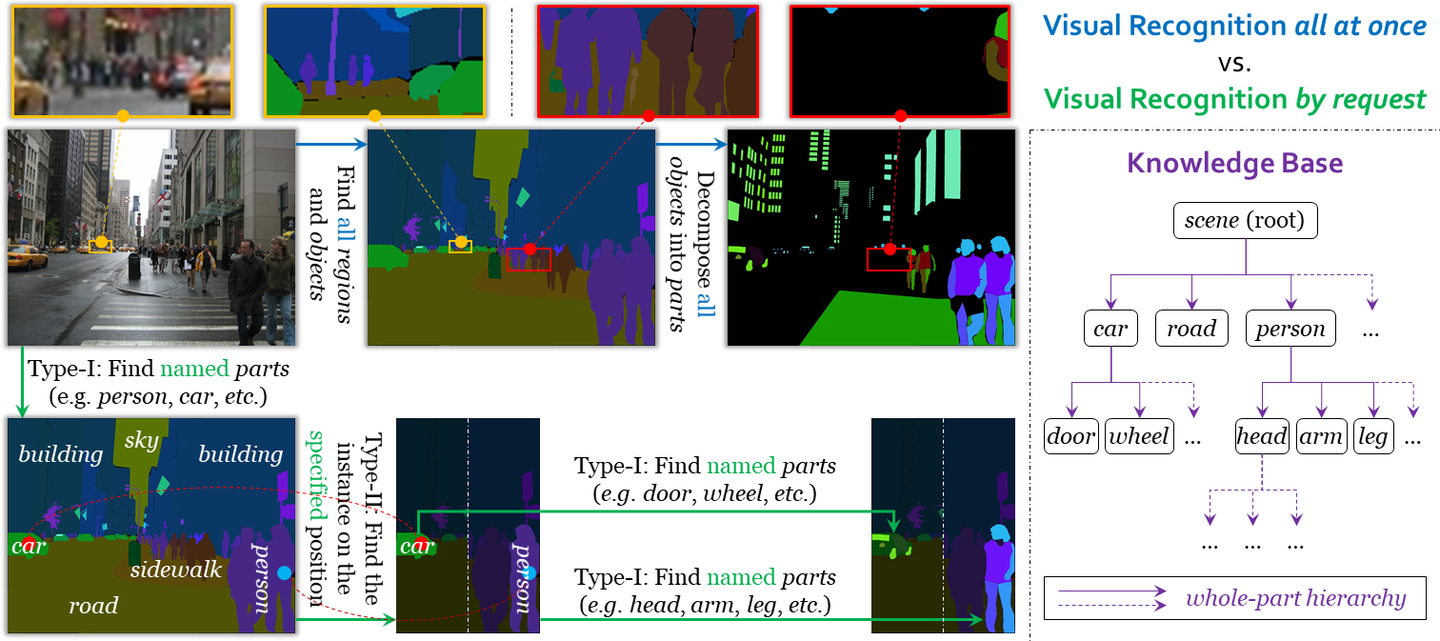
为了达成上述目标,我们需要引入按需视觉识别 (visual recognition by request)的概念,即识别算法根据交互式需求,不断地从图像中识别出越来越精细的语义概念。相对地,我们将传统意义上识别任务定义为统一视觉识别 (visual recognition all at once),即识别算法事先获取了一个固定的语义概念列表(字典),从而能够从图像中一次性地识别出所有预先定义好的语义概念。
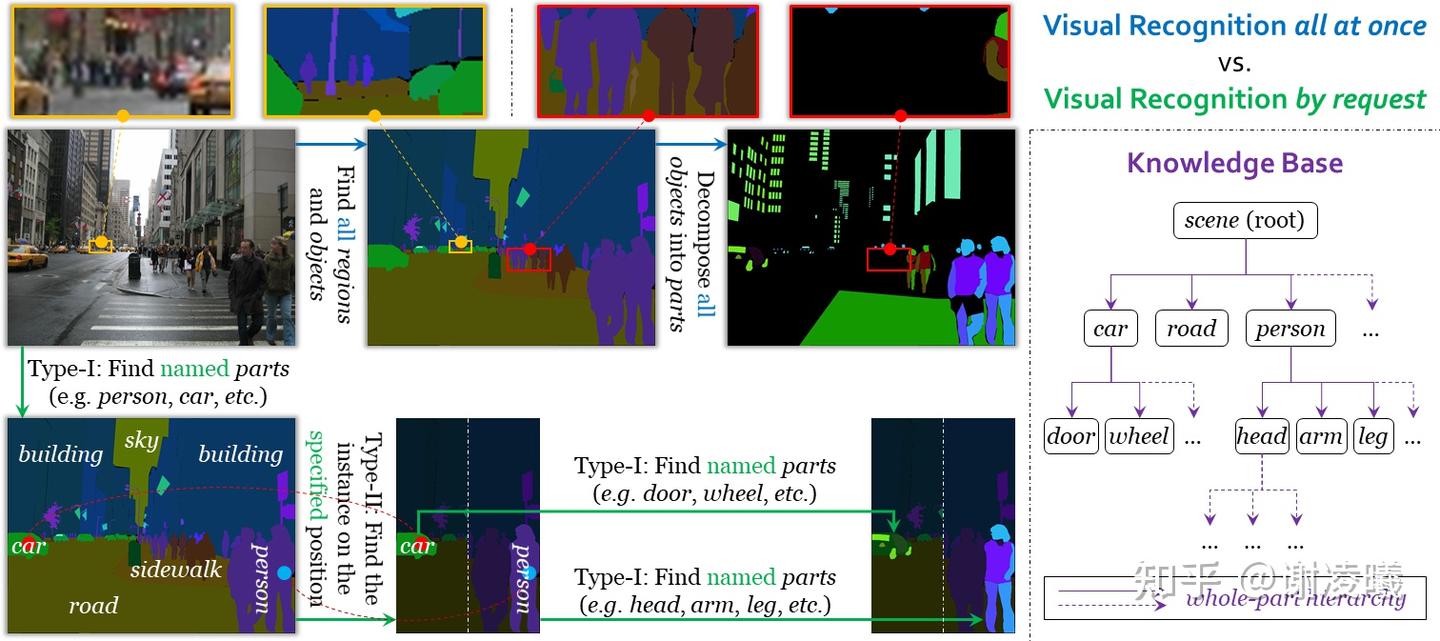 图2 统一视觉识别和按需视觉识别的概念性介绍。
图2直观地对比了两种识别方式。在图中展示的复杂街景图像中,统一视觉识别定义了“人”、“车”等物体以及它们的部件,但是由于图像中某些物体尺寸太小,无法对这些物体以及它们的部件进行标注,这就产生了标注的不一致性。与之相比,按需识别并不假定图中所有物体都需要被标注出来,而是将标注任务表示为若干需求(request),标注者/算法只需要处理这些request。具体地说,request被分为两类:
显然,上述两种request,通过递归调用的形式,可以达成无限细粒度 的识别任务。例如,在“人”的基础上,可以识别它的部件“头”,进而识别“头”的部件“眼睛”,进而识别“眼睛”的部件“眼珠”,进而识别“眼珠”的部件“瞳孔”,等等。注意,为了完成第1类request,我们需要定义一个知识库(knowledge base,如图1右部所示),显式地定义每个视觉概念的部件列表。从严格定义上说,知识库是一个具有拓扑结构的图,具体定义可以参见论文。知识库可以在任何时候被更新(如加入某个物体或者在某个物体上增加部件),而由于按需视觉识别的性质,加入新概念并不需要刷新整个数据集,只需要额外加入若干包含新概念的图片,将其中的新概念标注出来即可。 为了实现按需视觉识别,神经网络的输入也略有不同。在传统的统一视觉识别中,网络的输入是图像和固定字典,输出分割结果;而在按需视觉识别中,网络的输入不仅包括图像 、知识库 (可变字典),还包括当前识别结果 和当前request 。神经网络需要进行调整,以适应新的输入。 总而言之,按需视觉识别 希望定义一种新的评价体系,使得人们可以实现视觉识别的无限细粒度 特性,从而接近视觉识别的开放性 和完整性 目标。本文的核心思想至此已经介绍完毕。 以下,我们详细叙述按需视觉识别的标注、识别、评价方法,并且给出一种基于query的解决方案。注意:如果只想了解文章的主要思想,读者并不需要仔细阅读以下的部分,因为它们都很直观,而且可以被视为某种意义上的“实现细节”。 因此,下面的部分我会写得比较简略,对细节感兴趣的读者,请参看我们的论文。
既然追求无限细粒度,我们就只考虑分割 这种较为彻底的识别任务。如上所述,在知识库(数学定义见论文)的基础上,一张图像的无限细粒度分割,可以表示为一系列request任务的集合(数学定义见论文),而这些request可以分为两大类:不断调用这两类request,就可以实现任意粒度的识别。
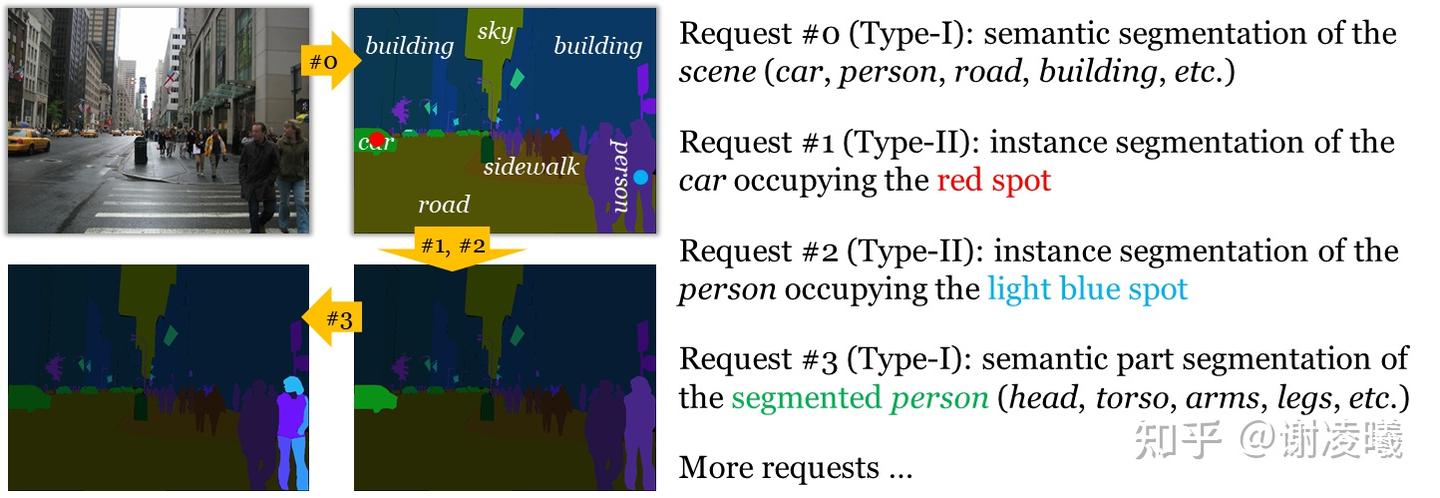 图3 按需视觉识别对应的交互式标注。
按需视觉识别,提供了一种新的交互式标注体系。如图3所示,一张图像的标注过程(同时也是识别过程)可以表达为若干个request的列表(其中某些request有严格的先后关系)。其中,第一个request永远是全局的语义分割,而后续的request,则通常是实例分割和语义分割交替的形式。
为了评判分割结果的好坏,我们在全景分割精度指标PQ的基础上,定义了一种专门用于按需视觉识别的评价指标,即Hierarchical PQ(HPQ)。HPQ将每个语义单元视为一个节点,递归地计算每个节点上的PQ,并且最终将PQ值汇总至根节点,得到全图的PQ。具体计算方式,请参看论文。
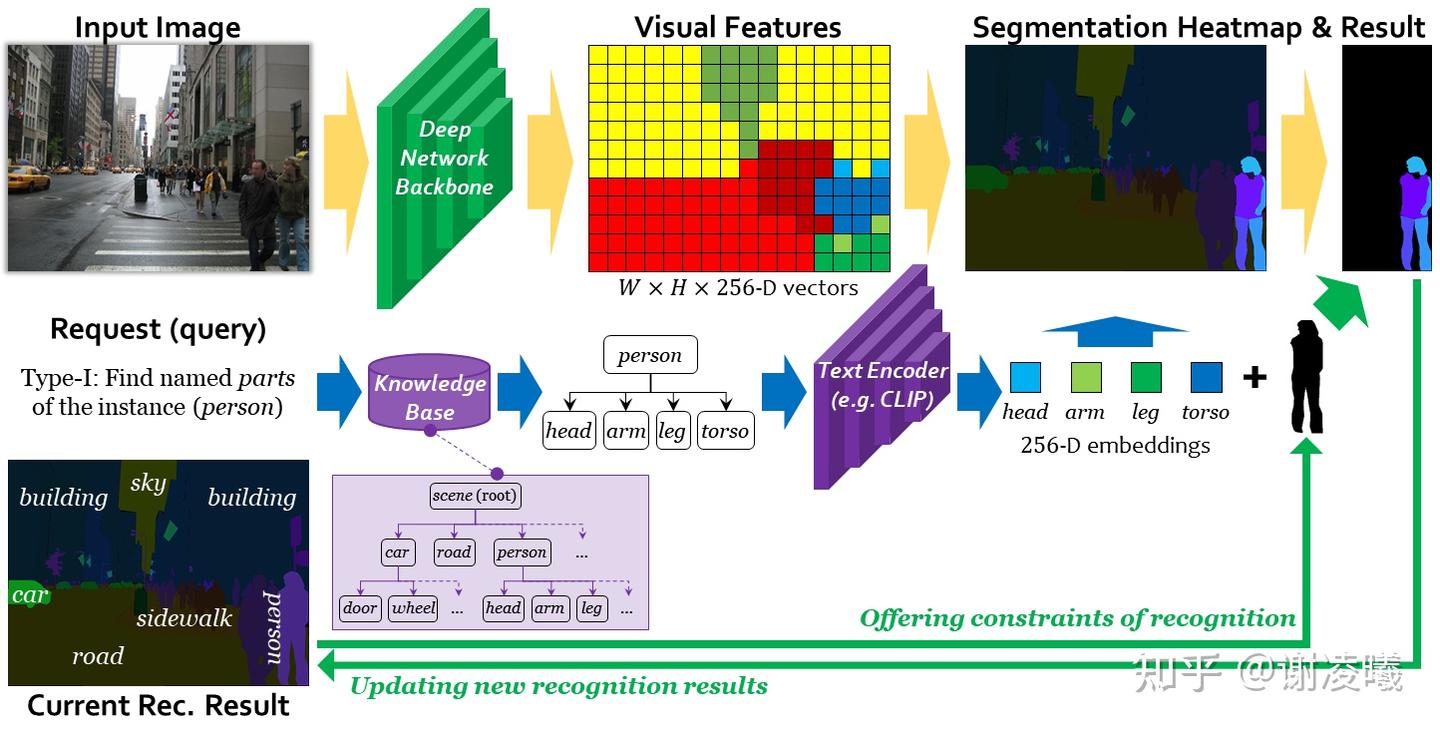 图4 处理第1类request的识别框架。
识别算法其实很简单。我们分开处理了两类request,其中第1类request的处理借鉴了LSeg[1](其中借用了CLIP[2]预训练模型的text encoder,以处理文本类别输入),而第2类request的处理借鉴了CondInst[3]。具体实现,可以参看论文。图4是简单的示意图。
实现细节方面,为了加速训练,我们采用了并行化处理的方式,使得每次迭代中,每张图像只需要被送入LSeg和CondInst各一次。推理时,如果request固定,我们也可以如此做,但是系统显然也可以进行交互式推理。
我们测试了两个数据集,即Cityscapes Panoptic Parts(CPP)[4]和ADE20K[5]。CPP数据集包含19类物体,其中5类物体有共计9种部件(有重复),物体和部件的标注都较为完整。ADE20K数据集包含超过3000类物体和超过600种部件,我们选取了常用的150类物体和83种部件,物体和部件的标注有较多缺失 。我们使用CPP数据集进行诊断实验,而在ADE20K数据集上验证按需视觉识别方法的通用性。 具体实验结果请参看论文。我们无意与SOTA方法对标精度(我们的精度在给定backbone下是reasonable的),只是希望说明几个点:
图5展示了在CPP数据集上和ADE20K数据集上的若干可视化结果。显然,ADE20K上的结果更差,这一方面是因为ADE20K上标注的视觉概念更多,一方面也是因为ADE20K上的标注更不完整。
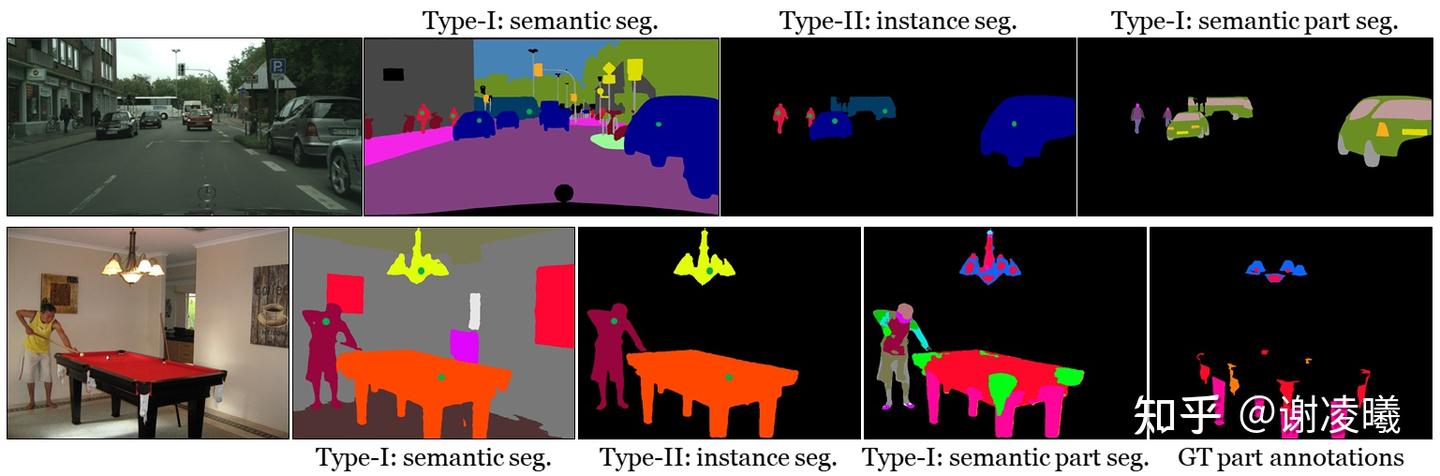 图5 若干可视化分割结果,注意分割结果如何随着request,渐进地变得更精细。
在这个工作中,我们探索了一种走向完整的 、无限细粒度的 视觉识别的方法,即按需视觉识别方法。它的核心思想在于,不追求一次性地识别图像中的所有物体,而是在基本语义分割的基础上,(按照需求)交互式地处理request,并且不断细化识别结果。这样做的最大好处,是增加了标注和识别的一致性和可扩展性,从而揭示了完整的 、无限细粒度的 视觉识别的可能性。 在此,我也希望澄清几个可能的误解。
最后,我简单展望未来的几个重要的研究方向。
最后的最后,我还是要强调我的观点:对于当前的视觉识别研究来说,定义更合适的评价指标,远比在现有数据集上刷SOTA更重要! 这个工作只是很小的一步,希望能够为这个community带来些许启发。我们也非常欢迎大家的讨论。
编辑于 2022-07-29 04:11
计算机视觉
深度学习(Deep Learning)
人工智能
赞同 33112 条评论350 32
分享
申请转载
 未登录用户
12 条评论
默认
最新
 邝鹏飞
任务的粒度能有多细,个人认为仍然由图片的分辨率来决定的,不是定义了request,那些由于分辨率的因素从而小到看不到的人或车就能看到了。request也不能避免一些物体的“多义性”(我不认为那是歧义)。至于“头”在什么地方结束、“身体”从什么地方开始,“西红柿”是水果还是蔬菜,这属于问题是否是“良定义的”范畴,不是良定义的问题,request也解决不了。或者说,有些问题就存在一定的“模糊性”,相应的模型就应该有一定的宽容度。研究如何提高模型的宽容度,倒是一个比较不错的问题,值得研究。这其实也牵涉了评价标准。比如,在人体姿态估计中,COCO给出的OKS标准,就是一个考虑对于不同目标给予不同宽容度的标准。比如眼睛,那个判定定位是否准确的宽容度,就小于判定胯部的宽容度。
2022-09-07 · 江苏
回复3
 liuruoze
 没有仔细看文章,但看开头的介绍,立意就很不错。最优秀的人总是走在最正确的方向上的,希望再多多打磨优化,加油!
2022-07-29 · 江苏
回复3
展开其他 1 条回复
 Null_Null
具身学习的问题:
三维感知理解,碳基生物感知理解三维花了多少时间?以亿年为单位,
肯定不能一上来就搞具身学习,这个相当于照着鸟造飞机。
2022-12-30 · 美国
回复2
 朴珞
人类是靠分类来认知(简化)世界的,只是这个分类是很简略的刻板偏见,这些偏见需要辅助上下文和先验知识才能稳定的输出“智能”,通过文本交互不断的补充这些场外信息是个不错的思路;
2022-08-01 · 浙江
回复1
展开其他 1 条回复
 aluea
CV中确实少了扫视这个功能,attention只能说稍微沾点边。
2022-07-29 · 山东
回复1
 Kiwi
读罢有些小理解,但不确定对不对,望指正:
 2022-08-02 · 广东
回复1
邝鹏飞
我一直在想一个问题,我们做的是“人工智能”是没错,但机器一定要按类似于人一样的方式来解决问题,才算是“人工智能”么?机器学习以前就叫“数据挖掘”。我觉得仿生只是一个方向,但不能是唯一的方向。套个“人工智能”的名字,就一切解决方法都去找“人是怎么做的”,是不是把路走窄了?ImageNet上的图像分类,机器已经超过人了;AlphaGo,下棋也超过人了,而且它们统统走的不是人解决问题的路子,那就都不算人工智能了?
2022-09-07 · 江苏
回复1
展开其他 1 条回复
 追梦搬砖工
是否可以尝试用gpt bert类的语言模型通过学习文本去建模这个knowledge base呢,也就是判断概念/标签之间的从属关系和概率
2022-09-01 · 广东
回复1
 CCCC
很棒的
未登录用户
关于作者
谢凌曦
探索未知,传承已知
清华大学 工学博士
回答 113 文章 18 关注者 43,963
关注他发私信
大家都在搜
换一换
江歌妈妈发长文尘埃终将落定704 万热
中国男足 0-5 巴勒斯坦562 万热
原央视主持人阿丘回应被通报419 万热
华为与赛力斯达成新五年合作409 万热
迪拜航空确认航班发生事故398 万热
东航回应网传空姐跪地道歉326 万
王楚钦:不知道为什么就是感觉累320 万热
江苏高考作文《衬衫的价格为 9 磅 15 便士》爆火268 万
女装网店开始用防拆带了265 万
孕妇骑车别车被司机踹翻257 万
 超越扩散!视觉自回归建模来了!VAR:新一代视觉生成范式 CVer发表于计算机视觉... # Attention算法调研(视觉应用概况) 在前面两章节 Attention算法调研(一) —— 机器翻译中的Attention和Attention算法调研(二) —— 机器翻译中的Self Attention中,我们整理了Attention机制在机器翻译中的应用方法,主要总结… Robert Yang
想来知乎工作?请发送邮件到 jobs@zhihu.com
打开知乎App
在「我的页」右上角打开扫一扫
 其他扫码方式:微信
下载知乎App
无障碍模式
验证码登录
密码登录
开通机构号
中国 +86
获取短信验证码
忘记密码
登录/注册
其他方式登录
未注册手机验证后自动登录,注册即代表同意《知乎协议》《隐私保护指引》
扫码下载知乎 App
关闭二维码